

Hej, Habr!
Tycker du om att flyga med flygplan? Jag älskar det, men under självisolering har jag även fått en förkärlek för att analysera data om flygbiljetter från en känd ressida — Aviasales.
Idag kommer vi att gå igenom hur Amazon Kinesis fungerar, bygga ett streamingsystem med realtidsanalys, sätta upp en NoSQL-databas, Amazon DynamoDB, som huvudlagringssystem och konfigurera SMS-notifieringar för intressanta biljetter.
Alla detaljer under bilden! Låt oss köra!
Introduktion
Som exempel behöver vi tillgång till . Tillgång till detta erbjuds gratis och utan begränsningar; det krävs bara att man registrerar sig i avsnittet 'Utvecklare' för att få sin API-token för att få tillgång till data.
Huvudsyftet med denna artikel är att ge en allmän förståelse för användningen av informationsströmning i AWS; vi lämnar därhän att de data som returneras av det använda API:et inte är strikt aktuella och överförs från en cache som genereras baserat på sökningar av användare på Aviasales.ru och Jetradar.com under de senaste 48 timmarna.
Data om flygbiljetter som erhållits via API:t kommer Kinesis-agenten, installerad på producentmaskinen, automatiskt att parsa och skicka till rätt ström via Kinesis Data Analytics. Den råa versionen av denna ström kommer att skrivas direkt till lagret. Det reda lagret i DynamoDB av 'rådata' kommer att möjliggöra djupare analys av biljetter via BI-verktyg, till exempel AWS Quick Sight.
Vi kommer att titta på två alternativ för att distribuera hela infrastrukturen:
- Manuell — via AWS Management Console;
- Infrastruktur av Terraform-kod — för lata automatiserare;
Arkitekturen för det utvecklade systemet
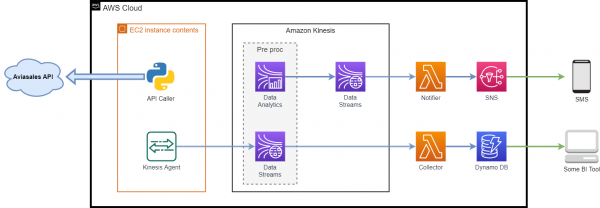
Använda komponenter:
- — data som returneras av detta API kommer att användas för allt vidare arbete;
- — en vanlig virtuell maskin i molnet där ingångsdatastreamen kommer att genereras:
- — detta är en Java-applikation som installeras lokalt på maskinen och möjliggör en enkel metod för insamling och sändning av data till Kinesis (Kinesis Data Streams eller Kinesis Firehose). Agenten övervakar kontinuerligt en uppsättning filer i angivna kataloger och skickar nya data till Kinesis;
- — ett Python-skript som gör förfrågningar till API:t och lagrar svaret i en mapp som Kinesis Agent övervakar;
- — en tjänst för realtidsdataöverföring med omfattande skalningsmöjligheter;
- — en serverlös tjänst som förenklar analys av realtidsströmdata. Amazon Kinesis Data Analytics anpassar resurser för att köra applikationer och skalar automatiskt för att hantera vilka volymer av inkommande data som helst;
- — en tjänst som låter dig köra kod utan att provisionera och konfigurera servrar. All beräkningskraft skalar automatiskt upp eller ner vid varje anrop;
- — en nyckel-värde- och dokumentdatabas, som ger en latens på mindre än 10 millisekunder vid vilken som helst skala. Med DynamoDB krävs ingen distribution av servrar, installation av uppdateringar eller hantering av dem. DynamoDB skalas automatiskt upp eller ner för att justera tillgången till resurser och upprätthålla hög prestanda. Inga systemadministrationsåtgärder krävs;
- — en helt hanterad meddelandetjänst i pub/sub-modell som gör det möjligt att isolera mikrotjänster, distribuerade system och serverlösa applikationer. SNS kan användas för att skicka information till slutanvändare via mobilpush-meddelanden, SMS och e-post.
Inledande förberedelse
För att emulera en datastream valde jag att använda information om flygbiljetter som returneras av Aviasales API. I en ganska omfattande lista över olika metoder, låt oss ta en av dem — "Priskalender för en månad", som returnerar priser för varje dag i månaden grupperade efter antal byten. Om ingen månad skickas med i begäran, returneras information för månaden efter den aktuella.
Låt oss registrera oss och få vår token.
Exempel på begäran nedan:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIDen ovan beskrivna metoden för att hämta data från API med token i begäran kommer att fungera, men jag föredrar att skicka åtkomsttoken genom headern, så i skriptet api_caller.py använder vi just den metoden.
Exempel på svar:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
I exemplet på API-svaret ovan visas en biljett från Sankt Petersburg till Phuket… Suck, vad drömmer jag…
Eftersom jag är från Kazan och Phuket just nu "bara är en dröm", låt oss leta efter biljetter från Sankt Petersburg till Kazan.
Det förutsätts att du redan har ett konto på AWS. Jag vill genast påpeka att Kinesis och att skicka meddelanden via SMS inte ingår i det årliga . Men trots detta, om man har i åtanke ett par dollar, är det helt möjligt att bygga det föreslagna systemet och leka med det. Och glöm inte att ta bort alla resurser efter att de inte längre behövs.
Som tur är kommer DynamoDB och Lambda-funktioner att vara i stort sett gratis för oss om vi håller oss inom de månatliga gratisgränserna. Till exempel för DynamoDB: 25 GB lagring, 25 WCU/RCU och 100 miljoner förfrågningar. Och en miljon Lambda-funktionsanrop per månad.
Manuell distribueringssystem
Inställning av Kinesis Data Streams
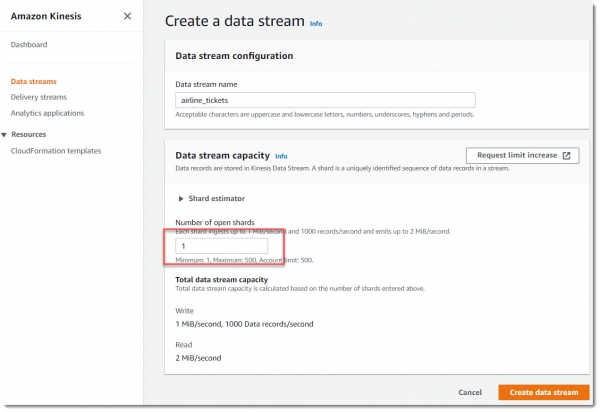
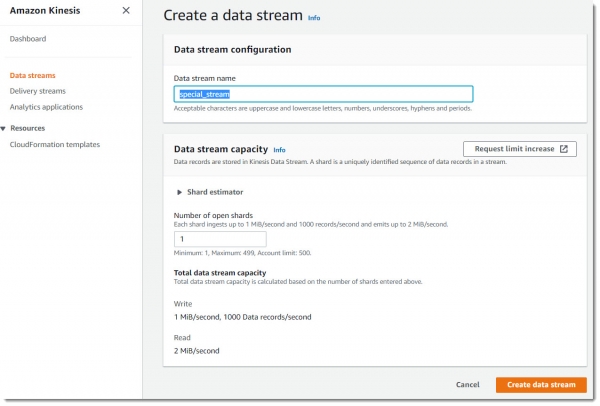
Låt oss gå till tjänsten Kinesis Data Streams och skapa två nya flöden, en shard för varje.
Vad är en shard?
En shard är den grundläggande enheten för datatransfer i Amazon Kinesis-streamar. En shard möjliggör överföring av indata med en hastighet av 1 MB/s och utdata med en hastighet av 2 MB/s. En shard stöder upp till 1000 PUT-poster per sekund. När man skapar ett datastream krävs det att ange det nödvändiga antalet shards. Till exempel kan man skapa ett datastream med två shards. Denna datastream möjliggör överföring av indata med en hastighet av 2 MB/s och utdata med en hastighet av 4 MB/s med stöd för upp till 2000 PUT-poster per sekund.
Ju fler shards i ditt flöde, desto större kapacitet får det. I princip skalas flöden genom att lägga till shards. Men ju fler shards du har, desto högre blir kostnaden. Varje shard kostar 1,5 cent per timme och ytterligare 1,4 cent per varje miljon operationer av att lägga till till flödet (PUT payload units).
Låt oss skapa ett nytt flöde med namnet airline_tickets, det räcker med 1 shard:
Nu skapar vi ytterligare ett flöde med namnet special_stream:
Inställning av producenten
Som dataprocessor för att hantera uppgiften räcker det att använda en vanlig EC2-instans. Det behöver inte vara en kraftfull dyr virtuell maskin, en spot-t2.micro fungerar utmärkt.
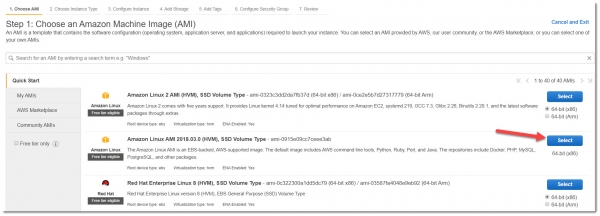
Viktigt meddelande: som exempel bör image — Amazon Linux AMI 2018.03.0 användas, med den krävs färre inställningar för att snabbt starta Kinesis Agent.
Vi går till EC2-tjänsten, skapar en ny virtuell maskin, väljer rätt AMI med typen t2.micro, som ingår i Free Tier:
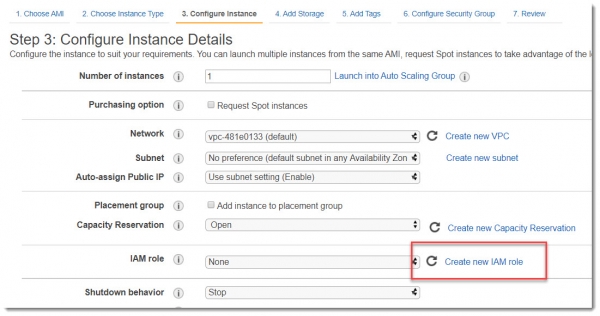
För att den ny skapade virtuella maskinen ska kunna interagera med Kinesis-tjänsten, måste vi ge den rättigheter att göra det. Det bästa sättet att göra detta är att tilldela en IAM Roll. Så på skärmen Steg 3: Konfigurera instansdetaljer bör vi välja Skapa ny IAM Roll:
Skapa IAM-roll för EC2
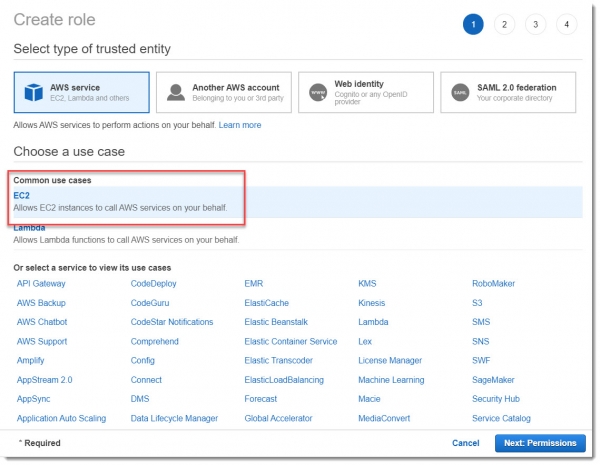
I det öppna fönstret väljer vi att skapa den nya rollen för EC2 och går till avsnittet Behörigheter:
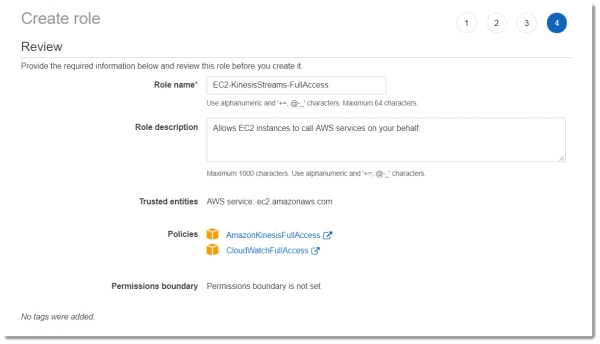
I detta utbildningsexempel behöver vi inte gå in på alla detaljer kring granulerad inställning av resurser, så vi väljer Amazons förinställda policyer: AmazonKinesisFullAccess och CloudWatchFullAccess.
Ge denna roll ett meningsfullt namn, till exempel: EC2-KinesisStreams-FullAccess. Resultatet bör bli detsamma som visas på bilden nedan:
Efter att ha skapat denna nya roll, glöm inte att koppla den till den skapade virtuella maskinen:
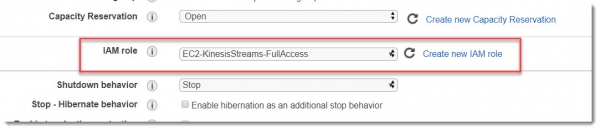
Vi ändrar ingenting mer på den här skärmen och går vidare till nästa fönster.
Inställningarna för hårddisken kan lämnas som standard, och taggarna också (även om det är god praxis att använda taggar, åtminstone ge ett namn till instansen och ange miljö).
Nu är vi på fliken Steg 6: Konfigurera säkerhetsgrupp, där vi måste skapa en ny eller ange en befintlig säkerhetsgrupp som tillåter anslutning via ssh (port 22) till instansen. Välj där Källan —> Min IP och du kan starta instansen.
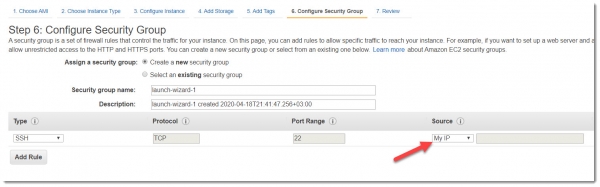
Så snart den går in i statusen körs, kan du försöka ansluta till den via ssh.
För att få möjlighet att arbeta med Kinesis Agent, efter en framgångsrik anslutning till maskinen, måste följande kommandon anges i terminalen:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Skapa en mapp för att spara API-svaren:
sudo mkdir /var/log/airline_ticketsInnan agenten startas måste dess konfigurationsfil ställas in:
sudo vim /etc/aws-kinesis/agent.jsonInnehållet i filen agent.json bör ha följande format:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "\/var\/log\/airline_tickets\/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
Som framgår av konfigurationsfilen kommer agenten att övervaka filer med filändelsen .log i katalogen \/var\/log\/airline_tickets\/, parsa dessa och överföra dem till strömmen airline_tickets.
Vi startar om tjänsten och säkerställer att den har startat och fungerar:
sudo service aws-kinesis-agent restartNu laddar vi ner Python-skriptet som kommer att begära data från API:et:
REPO_PATH=https:\/\/raw.githubusercontent.com\/igorgorbenko\/aviasales_kinesis\/master\/producer

wget $REPO_PATH\/api_caller.py -P \/home\/ec2-user\/
wget $REPO_PATH\/requirements.txt -P \/home\/ec2-user\/
sudo chmod a+x \/home\/ec2-user\/api_caller.py
sudo \/usr\/local\/bin\/pip3 install -r \/home\/ec2-user\/requirements.txt
Skriptet api_caller.py begär data från Aviasales och sparar det mottagna svaret i katalogen som Kinesis-agenten skannar. Implementeringen av detta skript är ganska standard, det finns en klass TicketsApi som gör det möjligt att asynkront anropa API:et. I denna klass skickar vi en header med en token och begärningsparametrar:
class TicketsApi:
    """Api-anroparens klass."""

    def __init__(self, headers):
        """Init-metod."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Hämta data från API-frågan."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Svar status %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('Oj! HTTP-fel inträffade: %s', str(http_err))
            except Exception as err:
                LOGGER.error('Oj! Ett fel inträffade: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Återvänd headers och fråga för API-förfrågan."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Kör koden."""
    if len(sys.argv) != 2:
        print('Användning: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('API har returnerat %s objekt', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s rader har sparats i %s',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('Oj! Förfrågningsresultat kunde inte sparas till fil. %s',
                         str(e))
    else:
        LOGGER.error('Oj! API-förfrågningen var inte framgångsrik %s!', response)
För att testa inställningarnas korrekthet och agentens funktionalitet kör vi ett test av skriptet api_caller.py:
sudo ./api_caller.py TOKEN 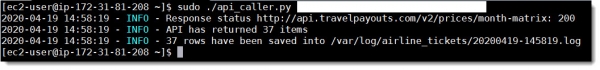
Och vi ser resultatet i Agent-loggarna och på fliken Monitoring i datastreamen airline_tickets:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 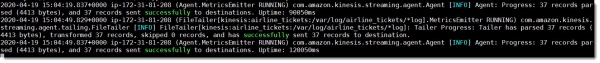
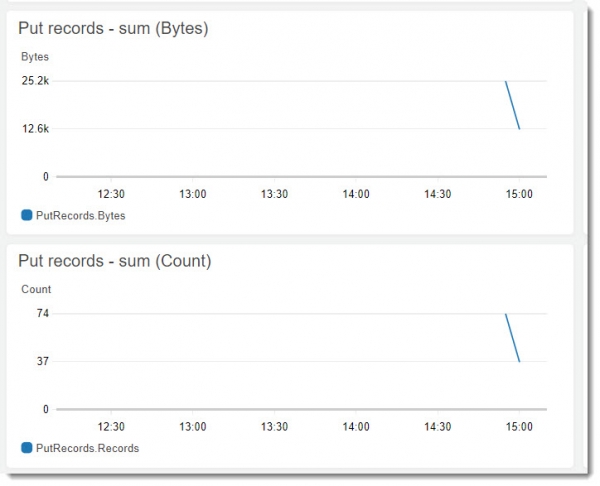
Som vi ser fungerar allt och Kinesis Agent skickar framgångsrikt data till strömmen. Nu konfigurerar vi konsumenten.
Konfigurering av Kinesis Data Analytics
Låt oss gå vidare till det centrala komponenten i hela systemet — vi skapar en ny applikation i Kinesis Data Analytics med namnet kinesis_analytics_airlines_app:
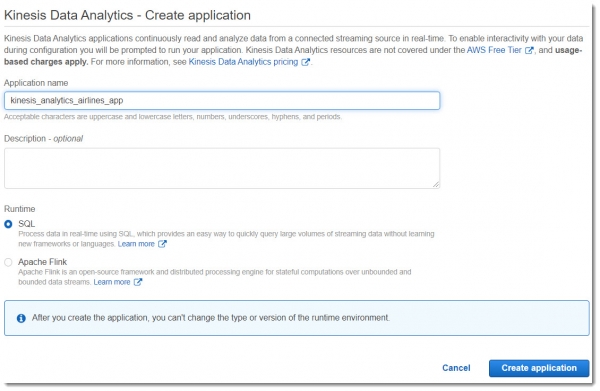
Kinesis Data Analytics gör det möjligt att utföra dataanalys i realtid från Kinesis Streams med hjälp av SQL-språket. Detta är en helt självskalanläggande tjänst (till skillnad från Kinesis Streams), som:
- möjliggör att skapa nya strömmar (Output Stream) baserat på förfrågningar till ursprungsdata;
- tillhandahåller en felström som uppstår under körning av applikationer (Error Stream);
- kan automatiskt bestämma schemat för ingångsdata (det kan manuellt åsidosättas vid behov).
Det är en kostsam tjänst - 0,11 USD per arbetstimme, så du bör använda den försiktigt och ta bort den när du är klar.
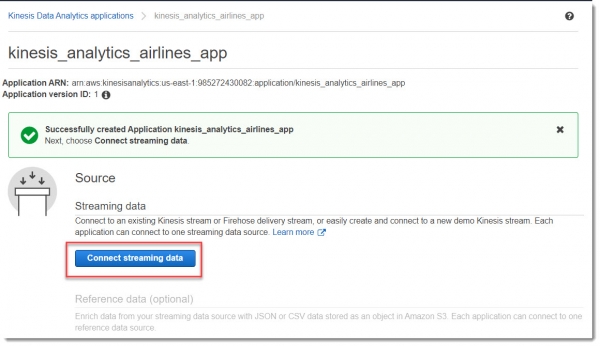
Vi kopplar applikationen till datakällan:
Välj strömmen som vi ska ansluta till (airline_tickets):
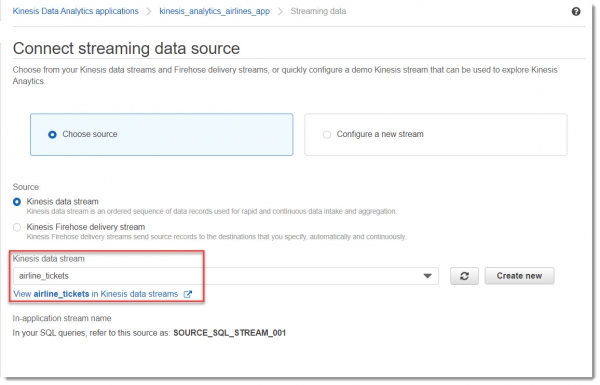
Därefter måste du bifoga en ny IAM-roll så att applikationen kan läsa från strömmen och skriva till strömmen. För detta behöver du inte ändra något i blocket Åtkomstbehörigheter:
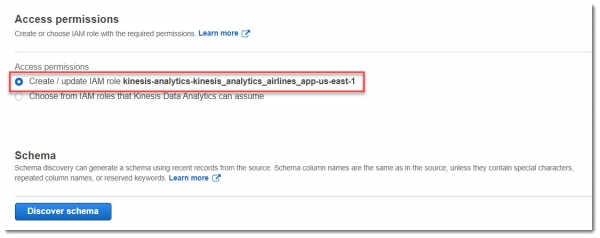
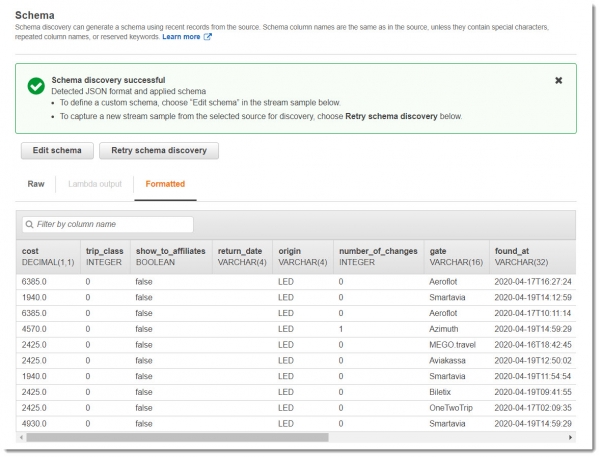
Nu begär vi dataskeman i strömmen, för detta klickar vi på knappen "Upptäck schema". Resultatet blir att en ny IAM-roll kommer att skapas och upptäckten av schemat kommer att starta med de data som redan kommit till strömmen:
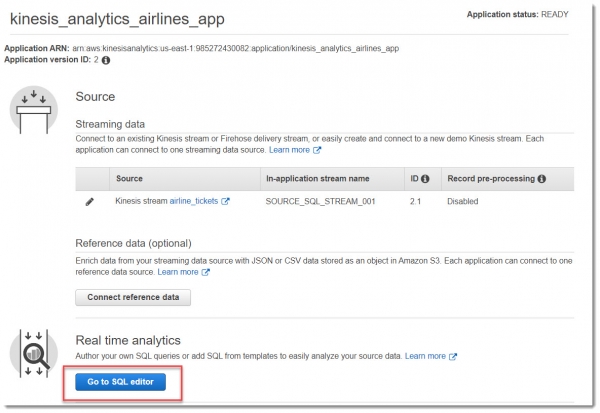
Nu är det dags att gå till SQL-redigeraren. När du trycker på den här knappen kommer ett fönster att dyka upp med en fråga om att starta applikationen - välj vad du vill starta:
I SQL-redigerarens fönster klistrar vi in en så enkel fråga och klickar på Spara och Kör SQL:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
I relationsdatabaser arbetar du med tabeller, där du använder INSERT-operatörer för att lägga till poster och SELECT-operatörer för att hämta data. I Amazon Kinesis Data Analytics arbetar du med strömmar (STREAM) och "pumpar" (PUMP) - kontinuerliga insättningsfrågor som lägger in data från en ström i applikationen till en annan ström.
I den SQL-fråga som presenteras ovan utförs en sökning efter Aeroflot-biljetter med ett pris under fem tusen rubel. Alla poster som uppfyller dessa villkor kommer att placeras i strömmen DESTINATION_SQL_STREAM.
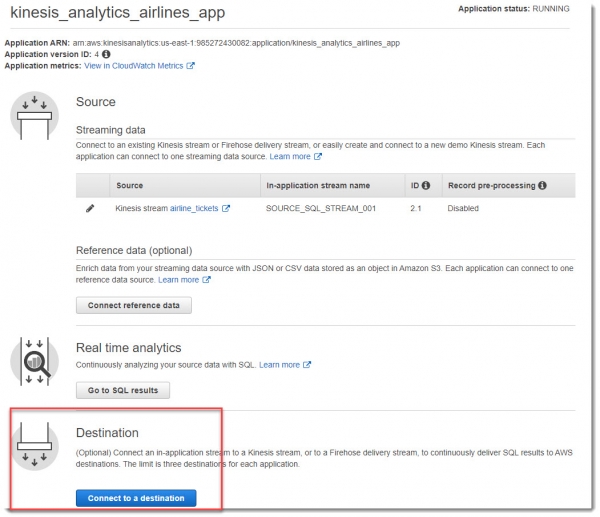
I blocket Destination väljer vi strömmen special_stream, och i rullgardinsmenyn In-application stream name DESTINATION_SQL_STREAM:
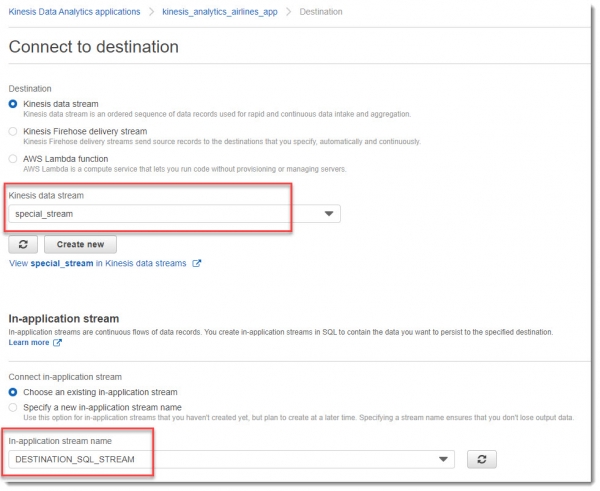
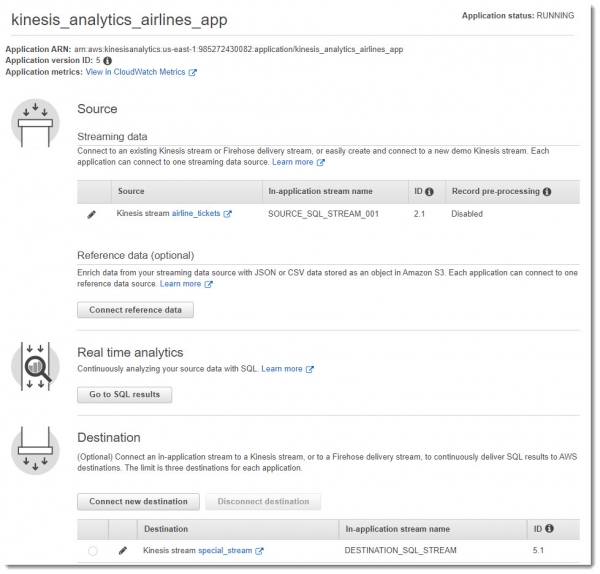
Resultatet av alla manipulationer bör bli något som på bilden nedan:
Skapande och prenumeration på SNS-ämnet
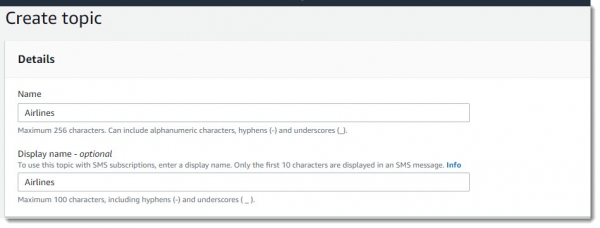
Gå till tjänsten Simple Notification Service och skapa ett nytt ämne med namnet Airlines:
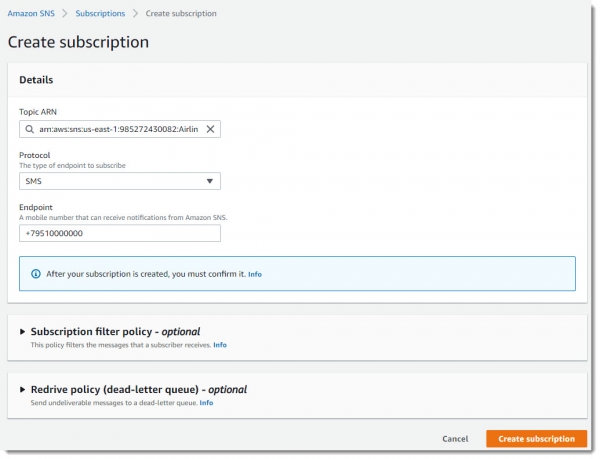
Skapa en prenumeration på detta ämne där vi anger mobiltelefonnumret som SMS-notifikationerna ska skickas till:
Skapande av en tabell i DynamoDB
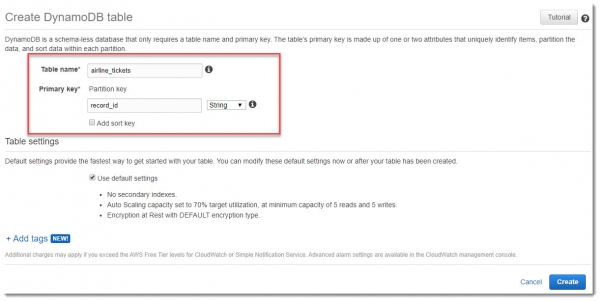
För att lagra de råa data från strömmen airline_tickets skapar vi en tabell i DynamoDB med samma namn. Vi kommer att använda record_id som primärnyckel:
Skapande av lambda-funktionen collector
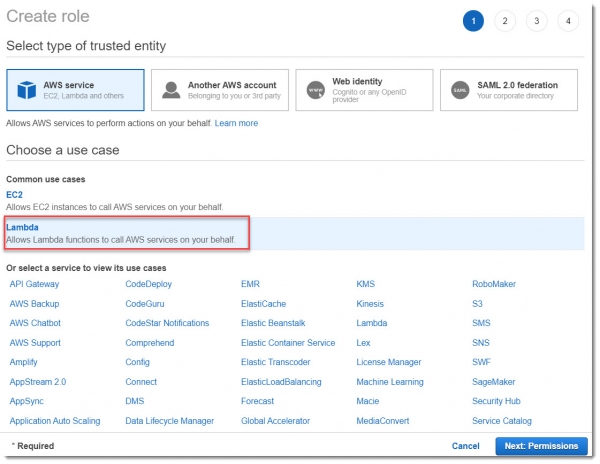
Vi skapar en lambda-funktion kallad Collector, vars uppgift är att pollera strömmen airline_tickets och, i händelse av att nya poster upptäckts där, införa dessa poster i DynamoDB-tabellen. Det är uppenbart att förutom standardrättigheterna bör denna lambda ha tillgång till att läsa Kinesis-datastreamen och skriva till DynamoDB.
Skapa en IAM-roll för lambda-funktionen collector
Först skapar vi en ny IAM-roll för lambda med namnet Lambda-TicketsProcessingRole:
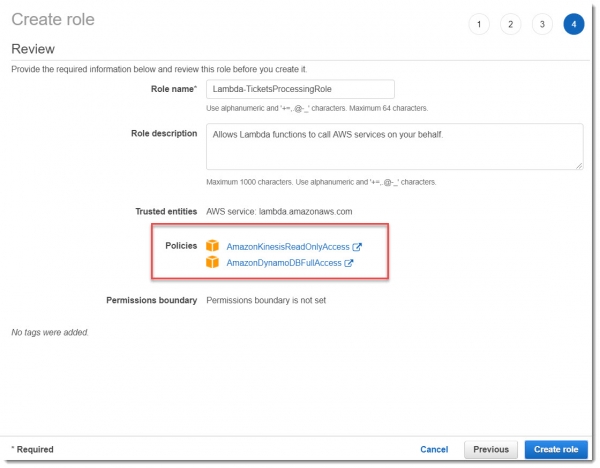
För ett testexempel fungerar de förinställda policyn AmazonKinesisReadOnlyAccess och AmazonDynamoDBFullAccess bra, som visas på bilden nedan:
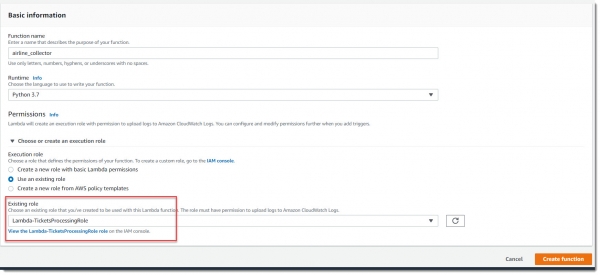
Denna lambda ska aktiveras av en trigger från Kinesis när nya poster läggs till i strömmen airline_stream, därför behöver vi lägga till en ny trigger:
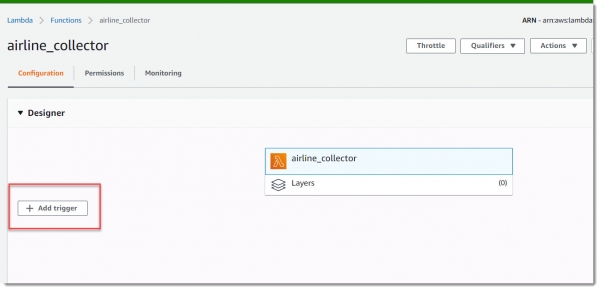
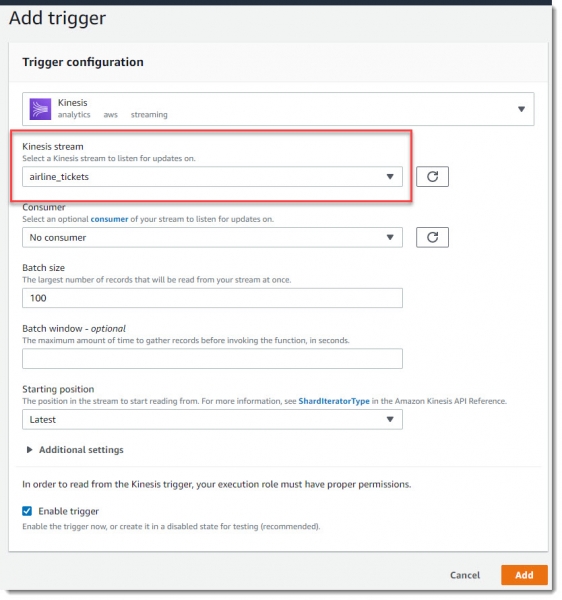
Koden återstår att införa och spara lambda-funktionen.
"""Parsing the stream and inserting into the DynamoDB table."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Parsing info from the Stream."""

    def __init__(self, table_name, records):
        """Init method."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Return deserialized data from the stream."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """Pre-process the json data."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Batch insert into the table."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Has been added ', len(self.json_data), 'items')

def lambda_handler(event, context):
    """Parse the stream and insert into the DynamoDB table."""
    print('Got event:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Skapa lambda-funktionen notifier
Den andra Lambda-funktionen, som kommer att övervaka den andra strömmen (special_stream) och skicka ett meddelande till SNS, skapas på liknande sätt. Därför måste denna Lambda ha läsbehörighet från Kinesis och kunna skicka meddelanden till den angivna SNS-topiken, som sedan kommer att skickas av SNS-tjänsten till alla prenumeranter av denna topik (e-post, SMS, etc.).
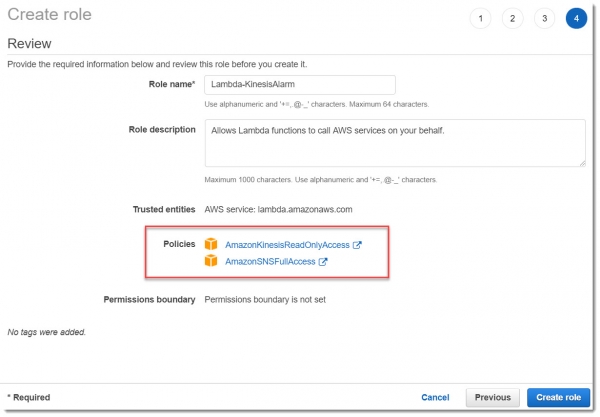
Skapa IAM-roll
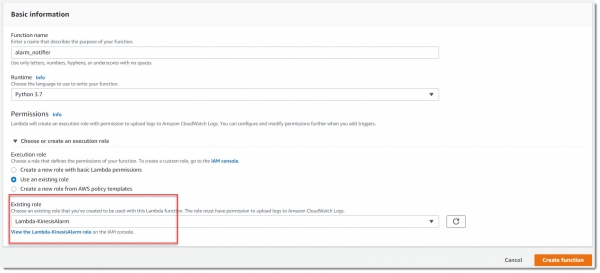
Först skapar vi IAM-rollen Lambda-KinesisAlarm för denna Lambda, och sedan tilldelar vi denna roll till den skapade Lambda alarm_notifier:
Denna Lambda måste fungera med en trigger för att få nya poster i strömmen special_stream, så det är nödvändigt att konfigurera triggern på samma sätt som vi gjorde för Lambda Collector.
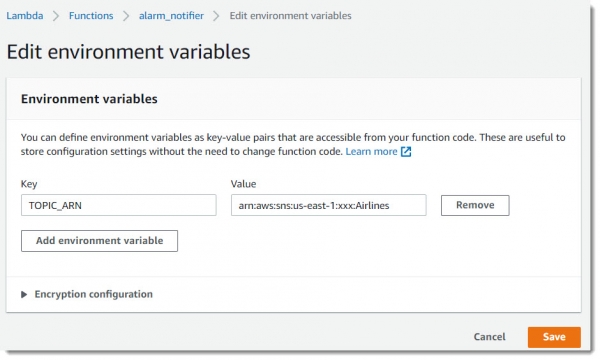
För att underlätta konfigurationen av denna Lambda introducerar vi en ny miljövariabel — TOPIC_ARN, där vi placerar ANR (Amazon Resource Names) för Airlines-topiken:
Och vi infogar Lambda-koden, den är inte så komplicerad:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
                           Message='Hej! Jag har hittat något intressant!',
                           Subject='Alarm för flygbiljetter')
        print('Alarmmeddelandet har levererats framgångsrikt')
    except Exception as err:
        print('Leveransfel', str(err))
Det verkar som att den manuella konfigurationen av systemet är avslutad. Det återstår bara att testa och se till att vi har konfigurerat allt korrekt.
Distribuering från Terraform-kod
Nödvändig förberedelse
— ett mycket bekvämt open-source verktyg för att distribuera infrastruktur från kod. Det har sin egen syntax som är lätt att förstå och många exempel på hur och vad man kan distribuera. I redaktören Atom eller Visual Studio Code finns det många praktiska tillägg som gör arbetet med Terraform enklare.
Distributören kan laddas ner . En detaljerad genomgång av alla möjligheter med Terraform ligger utanför ramen för denna artikel, så vi begränsar oss till de grundläggande aspekterna.
Hur man startar
Den fullständiga koden för projektet finns . Klona förrådet till dig. Innan du startar måste du vara säker på att du har installerat och konfigurerat AWS CLI, eftersom Terraform kommer att leta efter autentiseringsuppgifter i filen ~/.aws/credentials.
En bra praxis är att köra kommandot plan innan man distribuerar hela infrastrukturen, för att se vad Terraform just nu kommer att skapa i molnet:
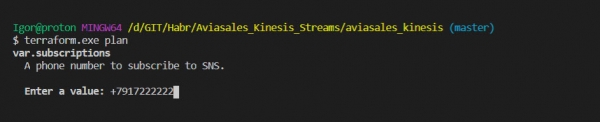
terraform.exe planDet kommer att föreslås att du anger ett telefonnummer för att få meddelanden skickade dit. Vid detta steg är det inte obligatoriskt att ange det.
Genom att analysera programmets arbetsplan kan vi påbörja skapandet av resurser:
terraform.exe applyEfter att ha skickat detta kommando kommer en fråga att dyka upp igen om du vill ange ditt telefonnummer, skriv "yes" när frågan om verklig åtgärd visas. Detta gör att hela infrastrukturen kan byggas upp, nödvändiga inställningar för EC2 kan göras, lambda-funktioner kan distribueras osv.
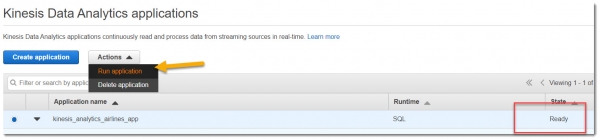
När alla resurser har skapats framgångsrikt via Terraform-koden, måste du gå in i detaljerna för Kinesis Analytics-appen (tyvärr kunde jag inte lista ut hur man gör det direkt från koden).
Starta appen:
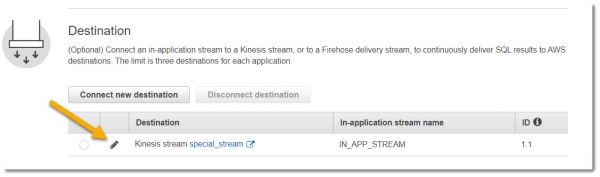
Därefter måste du tydligt ange streamnamn i appen genom att välja från rullgardinsmenyn:
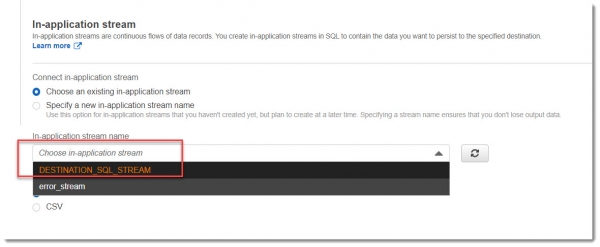
Nu är allt klart för arbete.
Testa appens funktionalitet
Oavsett hur du distribuerade systemet, manuellt eller via Terraform-koden, kommer det att fungera likadant.
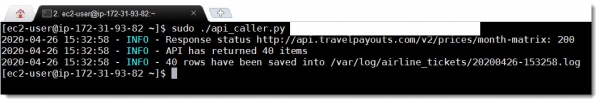
Logga in via SSH på EC2-virtuella maskinen där Kinesis Agent är installerad och starta skriptet api_caller.py
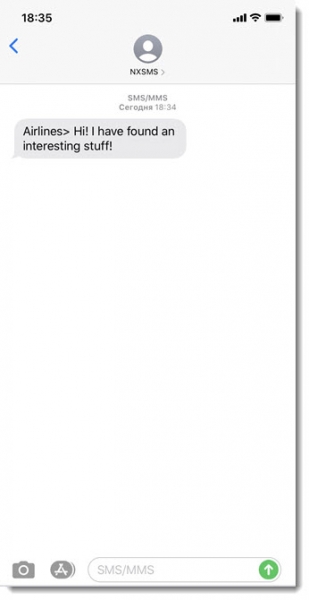
sudo ./api_caller.py TOKENDet är bara att vänta på SMS till ditt nummer:
SMS — meddelandet kommer till telefonen nästan inom 1 minut:
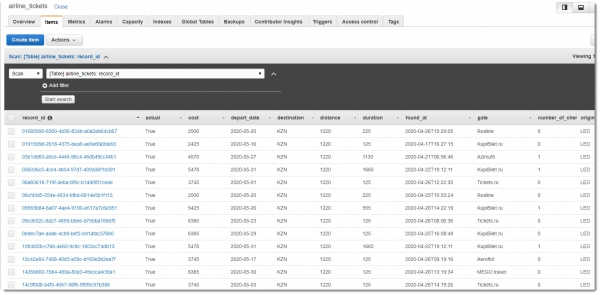
Vi måste kolla om poster har sparats i DynamoDB-databasen för framtida, mer detaljerad analys. Tabell airline_tickets innehåller ungefär sådana data:
Slutsats
Den genomförda arbetet har byggt ett system för online databehandling baserat på Amazon Kinesis. Användningsalternativen för Kinesis Agent i kombination med Kinesis Data Streams och realtidsanalys av Kinesis Analytics med hjälp av SQL-kommandon har granskats, liksom interaktionen mellan Amazon Kinesis och andra AWS-tjänster.
Det ovan beskrivna systemet har implementerats på två sätt: antingen långsamt manuellt eller snabbt via Terraform-kod.
All källkod för projektet är tillgänglig , jag föreslår att du kollar in det.
Jag ser fram emot att diskutera artikeln och väntar på dina kommentarer. Hoppas på konstruktiv kritik.
Jag önskar dig framgång!
Källa: habr.com
