

Författare: Sergey Lukyanchikov, konsultingenjör på InterSystems
Utmaningar med AI/ML-beräkningar i realtid
Låt oss börja med exempel från Data Science-erfarenheten hos InterSystems:
- Den 'överbelastade' kundportalen är ansluten till ett online rekommendationssystem. Omstrukturering av kampanjer över detaljhandelsnätet är nödvändig (låt säga att istället för en 'platt' kampanjlinje kommer en 'segment-taktik'-matris att tillämpas). Vad händer med de rekommendationsmekanismer? Vad händer med inskick och uppdatering av data till rekommendationssystemet (ingångsdata har ökat 25 000 gånger)? Vad händer med genereringen av rekommendationer (ett behov av att tusenfaldigt sänka filtreringströskeln för rekommendationsregler på grund av en tusenfaldig ökning av deras antal och 'sortiment')?
- Det finns ett system för övervakning av sannolikheten för defekter i utrustningens noder. Det övervakningssystemet har fått anslutning till ett automatisk kontrollsystem (ACS) som skickar tusentals parametrar från den tekniska processen varje sekund. Vad händer med övervakningssystemet, som tidigare arbetade med 'manuella urval' (kan det säkerställa övervakning av sannolikheten varje sekund)? Vad kommer att hända om det i ingångsdata dyker upp en ny block med ett par hundra kolumner från nya sensordata, nyligen implementerade i ACS (kommer det att behöva stängas av och hur länge för att inkludera nya sensorer i dataanalysen)?
- Ett komplex av AI/ML-mekanismer (rekommendations-, övervaknings- och prognossystem) har skapats, som använder varandras resultat. Hur många mänskliga timmar krävs varje månad för att anpassa detta komplex till förändringar i ingångsdata? Vad är det totala 'fördröjningen' i det stödjande beslutsfattande systemet (frekvensen av ny stödinformation i förhållande till frekvensen av nya ingångsdata)?
Sammanfattande av dessa och många andra exempel har vi kommit fram till formuleringen av de utmaningar som uppstår vid övergången till att använda system för maskininlärning och artificiell intelligens i realtid:
- Är vi nöjda med snabbheten i skapandet och anpassningen (till den föränderliga situationen) av AI/ML-utvecklingar i vårt företag?
- Hur stödjer våra AI/ML-lösningar affärsledning i realtid?
- Kan våra AI/ML-lösningar själva (utan utvecklare) anpassa sig till förändringar i data och affärsledning?
Vår artikel är en grundlig översikt av plattformen InterSystems IRIS:s möjligheter när det gäller universellt stöd för implementering av AI/ML-mekanismer, integration av AI/ML-lösningar och träning av AI/ML-lösningar på intensiva dataloggar. Vi kommer att titta på marknadsundersökningar, praktiska exempel på AI/ML-lösningar och konceptuella aspekter av det vi kallar AI/ML-plattformar i realtid i denna artikel.
Vad visar enkäterna: realtidsapplikationer
Resultat , genomförda bland omkring 800 IT-professionella år 2019 av Lightbend, talar för sig själva:
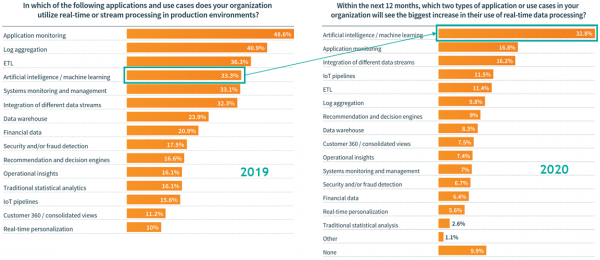
Figur 1 Ledande användare av realtidsdata
Låt oss citera viktiga delar av rapporten om resultaten från denna undersökning i vår översättning:
«… Trenderna kring populariteten av dataintegrationsverktyg och samtidigt stöd för beräkningar i containrar ger ett synergistiskt svar på marknadens krav på mer snabba, rationella och dynamiska erbjudanden av effektiva lösningar. Datastreamar möjliggör snabbare informationsöverföring än traditionella batchdata. Därtill kommer möjligheten att snabbt tillämpa beräkningsmetoder som, exempelvis, AI/ML-baserade rekommendationer, vilket skapar konkurrensfördelar genom ökad kundnöjdhet. Kappseglan om snabbhet påverkar också alla roller inom DevOps-paradigm — och ökar effektiviteten i utveckling och implementering av applikationer. … Åttahundrafyra IT-specialister gav information om användningen av datastreamar i sina organisationer. Respondenterna fanns huvudsakligen i västerländska länder (41% i Europa och 37% i Nordamerika) och var i stort sett jämnt fördelade mellan små, medelstora och stora företag. …
Artificiell intelligens är inget hype. Femtiotvå procent av dem som redan tillämpar datastream-behandling i produktiva AI/ML-applikationer bekräftar att deras användning inom AI/ML kommer att se den största tillväxten nästa år (jämfört med andra applikationer).
- Enligt de flesta tillfrågade kommer användningen av datastreams i AI/ML-scenarier att få den största tillväxten nästa år.
- Användningen inom AI/ML kommer att öka inte bara på grund av relativt nya typer av scenarier, utan även genom traditionella scenarier där realtidsdata används allt mer intensivt.
- Utöver AI/ML är entusiasmen bland användare av IoT-datastreams imponerande — 48% av dem som redan har integrerat IoT-data hävdar att implementeringen av scenarier på dessa data kommer att få en betydande ökning inom en snar framtid.
Denna ganska intressanta undersökning visar att uppfattningen om maskininlärnings- och artificiell intelligens-scenarier som ledare inom datastream-konsumtion redan "är på väg". Men en minst lika viktig observation blir uppfattningen av AI/ML i realtid ur DevOps-optik: här kan man redan börja prata om en transformation av den fono fortfarande rådande kulturen "engångs-AI/ML med helt tillgänglig dataset".
Konceptet för en AI/ML-plattform i realtid
Ett typiskt tillämpningsområde för AI/ML i realtid är styrning av teknologiska processer inom tillverkning. Med hänsyn till tidigare reflektioner kan vi formulera konceptet för en AI/ML-plattform i realtid.
Användningen av artificiell intelligens och maskininlärning inom styrning av teknologiska processer har flera särdrag:
- Data om tillståndet i den teknologiska processen kommer in intensivt: med hög frekvens och över ett brett spektrum av parametrar (upp till tiotusentals parameteravläsningar som överförs per sekund från processautomationssystems).
- Data om upptäckta defekter, för att inte tala om data om deras utveckling, är å sin sida knapphändiga och oregelbundna, kännetecknas av otillräcklig typisering av defekter och deras lokalisering över tid (ofta representerade med anteckningar på papper).
- Ur praktisk synvinkel är endast "relevansfönstret" för de ursprungliga data tillgängligt för träning och tillämpning av modeller, vilket speglar dynamiken i den teknologiska processen under ett rimligt rörligt intervall, avslutande med de senaste lästa värdena av processparametrarna.
Dessa egenskaper tvingar oss, förutom att ta emot och grundbehandla den intensiva "bredbandingångssignalen" från den teknologiska processen i realtid, att även utföra (parallellt) tillämpning, träning och kvalitetskontroll av resultaten från AI/ML-modellerna – också i realtid. Det "bildruta" som våra modeller "ser" i det rörliga relevansfönstret förändras ständigt – och tillsammans med det förändras även kvaliteten på resultaten från AI/ML-modellerna, tränade på en av "bilderna" i det förflutna. Vid försämring av kvaliteten på resultaten från AI/ML-modellerna (till exempel: klassifikationsfelet "alarmerad-norm" går utanför de gränser vi definierat) måste en automatisk omträning av modellerna på en mer aktuell "bild" startas — och tidpunkten för att starta omträningen av modellerna måste ta hänsyn till både längden på själva träningen samt dynamiken i försämringen av kvaliteten på den aktuella versionen av modellerna (eftersom de aktuella versionerna av modellerna fortsätter att tillämpas medan modellerna tränas, och tills deras "nytränade" versioner har bildats).
InterSystems IRIS har nyckelfunktionalitet för att möjliggöra drift av AI/ML-lösningar vid styrning av teknologiska processer i realtid. Dessa funktioner kan delas in i tre huvudgrupper:
- Kontinuerlig utrullning (Continuous Deployment/Delivery, CD) av nya eller anpassade befintliga AI/ML-mekanismer till en produktionslösning som fungerar i realtid på InterSystems IRIS-plattformen.
- Kontinuerlig integration (Continuous Integration, CI) av de inkommande datavströmmarna från den teknologiska processen, dataköer för tillämpning/träning/kontroll av kvaliteten på AI/ML-mekanismerna och databyten/kod/styrande åtgärder med miljöer för matematisk modellering, vars orkestrering sker i realtid av InterSystems IRIS-plattformen.
- Kontinuerlig (själv-)lärande (Continuous Training, CT) AI/ML-mekanismer, som utförs i matematiska simuleringsmiljöer med hjälp av data, kod och styråtgärder ("fattade beslut"), överförda av plattformen InterSystems IRIS
Klassificeringen av plattformens kapabiliteter relaterad till maskininlärning och artificiell intelligens är avsiktlig just i sådana grupper. Låt oss citera den metodologiska metoden från Google, där den konceptuella grunden för denna klassificering läggs i vår översättning:
„… Den idag populära konceptet DevOps omfattar utvecklingen och driften av storskaliga informationssystem. Fördelarna med att införa detta koncept inkluderar kortare utvecklingscykler, snabbare distribution av utveckling, och flexibilitet i planeringen av releaser. För att uppnå dessa fördelar förutsätter DevOps införandet av åtminstone två praktiker:
- Continuous Integration (CI)
- Continuous Delivery (CD)
Dessa praktiker gäller även för AI/ML-plattformar – för att säkerställa en pålitlig och produktiv byggnation av effektiva AI/ML-lösningar.
AI/ML-plattformar skiljer sig från andra informationssystem på följande sätt:
- Teamets kompetenser: När man skapar en AI/ML-lösning inkluderar teamet vanligtvis data scientists eller akademiska experter inom datavetenskap, som genomför dataanalys, utveckling och testning av modeller. Dessa teammedlemmar behöver kanske inte vara professionella utvecklare av produktiv programkod.
- Utveckling: AI/ML-mekanismer är experimentella av sin natur. För att lösa ett problem på det mest effektiva sättet krävs det att man prövar olika kombinationer av ingångsvariabler, algoritmer, modelleringsmetoder och modelparametrar. Svårigheten med denna prövning ligger i att spåra "vad som fungerade / inte fungerade", säkerställa reproducerbarhet av episoder och generalisera utvecklingen för upprepade implementeringar.
- Testning: Testningen av AI/ML-mekanismer kräver ett bredare spektrum av tester än de flesta andra utvecklingar. Utöver typiska enhets- och integrationstester testas validiteten av data, kvaliteten på resultaten av modellens tillämpning på tränings- och kontrollgrupper.
- Distribution: Distribution of AI/ML solutions is not limited to predictive services using a once-trained model. AI/ML solutions are built around multi-stage pipelines that perform automated training and application of models. Deploying such pipelines involves automating non-trivial tasks traditionally performed manually by data scientists, in order to enable the training and testing of models.
- Productivity: AI/ML mechanisms can lack performance not only due to inefficient programming but also because of the constantly changing nature of input data. In other words, the performance of AI/ML mechanisms can degrade for a wider range of reasons than the performance of conventional developments. This leads to the necessity of monitoring (in 'real-time') the performance of our AI/ML mechanisms, as well as sending alerts or discarding results if performance metrics do not meet expectations.
AI/ML platforms are similar to other information systems in that both require continuous code integration with version control, modular testing, integration testing, and continuous deployment of developments. However, in the case of AI/ML, there are several important differences:
- CI (Continuous Integration) is no longer limited to testing and validating the code of deployed components – it also includes testing and validating data and AI/ML models.
- CD (Continuous Delivery/Deployment) is not limited to writing and releasing packages or services, but implies a platform for composing, training, and applying AI/ML solutions.
- CT (Continuous Training) – a new element [author's note: a new element in relation to the traditional DevOps concept, where CT is generally Continuous Testing], inherent to AI/ML platforms, responsible for autonomous management of the training and application mechanisms of AI/ML models. …
Vi kan konstatera att maskininlärning och artificiell intelligens, som arbetar med realtidsdata, kräver en bredare uppsättning verktyg och kompetenser (från kodutveckling till orkestrering av miljöer för matematisk modellering), närmare integration mellan alla funktionella och ämnesmässiga områden samt en mer effektiv organisation av mänskliga och maskinella resurser.
Realtidsscenario: igenkänning av defektutveckling i nutritionspumpar
För att fortsätta med ett exempel inom området för processtyrning, låt oss betrakta en specifik uppgift (som redan nämnts i början): att övervaka utvecklingen av defekter i pumpar i realtid baserat på flödet av värden för processteknikparametrar och rapporter från underhållspersonal om upptäckta defekter.
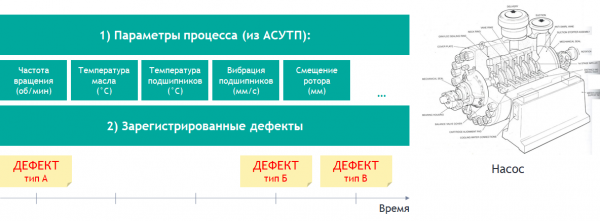
Bild 2 Formulering av uppgiften för övervakning av defektutveckling
En egenskap hos de flesta av dessa uppgifter i praktiken är att regelbundenheten och snabbheten i datainflödet (processkontrollsystem) måste ses mot bakgrund av sporadiken och oregelbundenheten i uppkomsten (och registreringen) av olika typer av defekter. Med andra ord: data från processkontrollsystemet kommer i sekunder som är korrekta och exakta, medan defekter registreras med en kemisk penna med datum i en gemensam anteckningsbok i verkstaden (till exempel: "12.01 – läckage vid 3:e lagerhållare").
Därmed kan vi komplettera formuleringen av uppgiften med ett viktigt begränsande villkor: "etiketten" för en specifik typ av defekt är endast en (det vill säga ett exempel på defekten av en specifik typ presenteras med data från processtyrningssystemet på ett specifikt datum – och vi har inga fler exempel på just denna typ av defekt). Denna begränsning för oss omedelbart utanför ramverket för klassisk maskininlärning (övervakad inlärning), där det måste finnas många "etiketter".
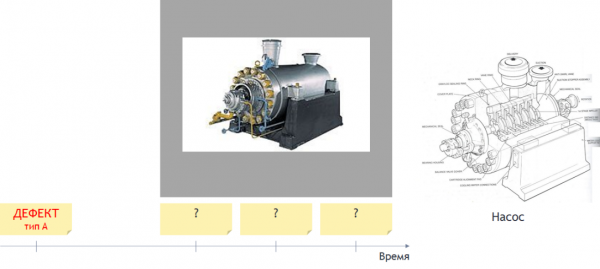
Bild 3 Förtydligande av uppgiften för övervakning av defektutveckling
Kan vi på något sätt "duplikera" den enda "etikett" vi har tillgång till? Ja, det kan vi. Det nuvarande tillståndet för pumpen karakteriseras av likhetsgraden med registrerade defekter. Även utan att använda kvantitativa metoder kan man, på nivå av visuell uppfattning, lära sig mycket genom att observera dynamiken i värdena från det automatiserade styrsystemet (ASUTP).
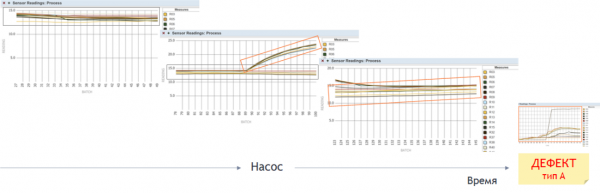
Figur 4 Pumpens tillståndsdynamik mot "etiketten" för den angivna typen av defekt
Men visuell uppfattning (åtminstone för tillfället) är inte den mest lämpliga generatorn för "etiketter" i vårt snabbt föränderliga scenario. Vi kommer att bedöma likheten mellan pumpens aktuella tillstånd och registrerade defekter med hjälp av ett statistiskt test.
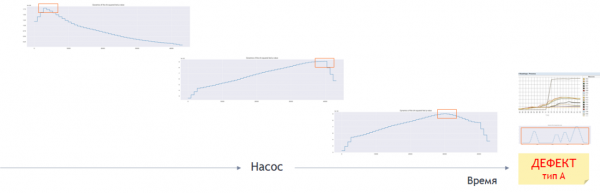
Figur 5 Tillämpning av statistiskt test på inkommande data mot "etiketten" för defekten
Det statistiska testet bestämmer sannolikheten att poster med värden av processparametrar i det 'flödespaket' som erhållits från ASUTP liknar poster med "etiketten" för en viss typ av defekt. Det beräknade sannolikhetsvärdet (statistiklikhetsindexet) transformerar till ett värde mellan 0 och 1, vilket blir en "etikett" för maskininlärning i varje specifik post i det undersökta paketet. Det vill säga, efter att ha bearbetat det nya paketet med poster om pumpens status med det statistiska testet har vi möjlighet att (a) lägga till detta paket i träningsuppsättningen för att träna AI/ML-modellen och (b) utföra kvalitetskontroll av den aktuella modelversionen när den tillämpas på detta paket.
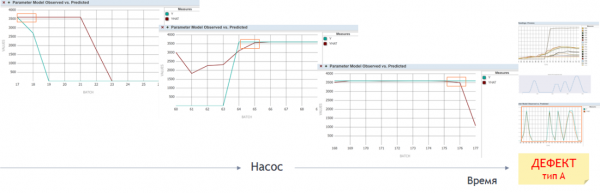
Figur 6 Tillämpning av maskininlärningsmodellen på inkommande data mot "etiketten" för defekten
I ett av våra tidigare Vi visar och förklarar hur plattformen InterSystems IRIS möjliggör implementering av vilken AI/ML-mekanism som helst som kontinuerligt körs i affärsprocesser, som kontrollerar noggrannheten hos simuleringsresultaten och anpassar modellparametrarna. När vi realiserar prototypen av vårt scenario med pumpar använder vi hela den funktionalitet som presenterades under webbinariet från InterSystems IRIS - genom att implementera en analysprocess i vår lösning inte med klassisk övervakad inlärning, utan snarare med förstärkningsinlärning som automatiskt styr urvalet för modellernas träning. I urvalet för träning placeras poster som uppnår "konsensusdetektion" efter tillämpning av både den statistiska testen och den aktuella modellversionen - det vill säga att både den statistiska testen (efter transformation av likhetsindexet till 0 eller 1) och modellen ger resultatet 1 på sådana poster. Vid ny träning av modellen, under dess validering (den återtränade modellen tillämpas på sin egen träningsuppsättning, med föregående tillämpning av den statistiska testen), tas poster som "inte behöll" resultatet 1 efter behandling med den statistiska testen (på grund av den ständiga närvaron av poster från den ursprungliga "märket" av defekten i träningsuppsättningen) bort från träningsuppsättningen, och den nya versionen av modellen tränas på "märket" av defekten plus de poster som "behölls" från strömmen.
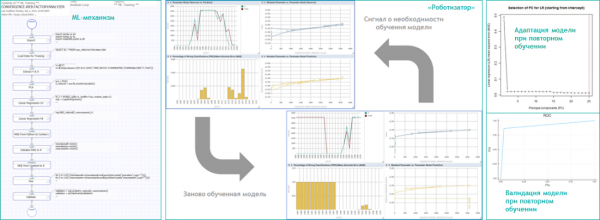
Bild 7 Robotisering av AI/ML-beräkningar i InterSystems IRIS
Om behovet av en slags "andra åsikt" uppstår angående kvaliteten på detektionen som erhålls vid lokala beräkningar i InterSystems IRIS, skapas en processrådgivare för att genomföra träning-tillämpning av modeller på en kontroll datamängd med hjälp av molntjänster (t.ex. Microsoft Azure, Amazon Web Services, Google Cloud Platform osv.):
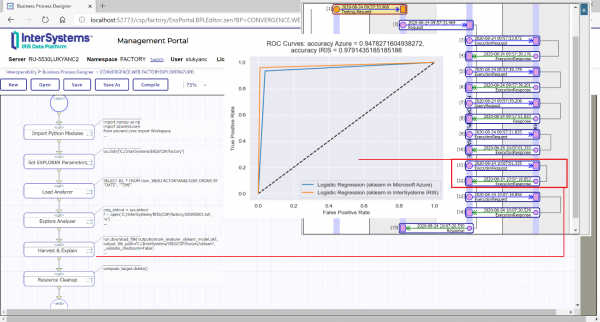
Bild 8 "Andra åsikt" från Microsoft Azure under orkestrering av InterSystems IRIS
Prototypen av vårt scenario i InterSystems IRIS är utformad som ett agentbaserat system av analytiska processer som interagerar med objektet av utrustning (pumpen), miljöer för matematisk modellering (Python, R och Julia), och som möjliggör självlärande av alla involverade AI/ML-mekanismer - på dataflöden i realtid.
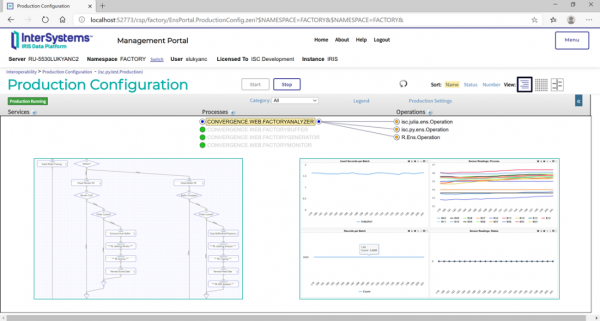
Bild 9 Huvudfunktionalitet för AI/ML-lösningen i realtid i InterSystems IRIS
Det praktiska resultatet av vårt prototyparbete:
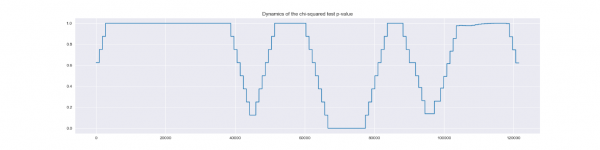
- Den modell som identifierats som ett defektmönster (12 januari):
- Den modell som identifierat en utvecklande defekt, som inte ingick i mönstret (11 september, defekten konstaterades av reparationsgruppen först efter två dagar – 13 september):
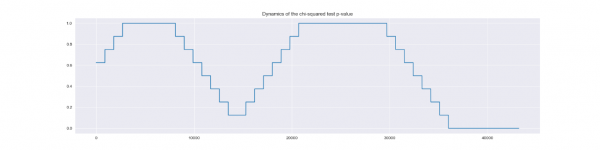
Simuleringen på verkliga data, som innehöll flera episoder av samma defekt, visade att vår lösning, implementerad på InterSystems IRIS-plattformen, gör det möjligt att upptäcka utvecklingen av denna typ av defekter flera dagar innan de upptäcks av reparationsgruppen.
InterSystems IRIS – en universell plattform för AI/ML-beräkningar i realtid
InterSystems IRIS-plattformen förenklar utvecklingen, distributionen och driften av lösningar med verkliga data. InterSystems IRIS kan samtidigt utföra transaktions- och analytisk databehandling; stödja synkroniserade datavyer enligt flera modeller (inklusive relations-, hierarkiska, objekt- och dokumentmodeller); fungera som en integrationsplattform för ett brett spektrum av datakällor och individuella applikationer; samt erbjuda avancerad realtidsanalys på strukturerade och ostrukturerade data. InterSystems IRIS tillhandahåller också verktyg för att använda extern analytisk programvara och möjliggör en flexibel kombination av moln- och lokala serverlösningar.
Applikationer byggda på InterSystems IRIS-plattformen har implementerats inom olika branscher, vilket hjälper företag att uppnå betydande ekonomiska fördelar ur både strategisk och operativ synvinkel, öka beslutsfattande insyn och eliminera "gap" mellan händelse, analys och åtgärd.
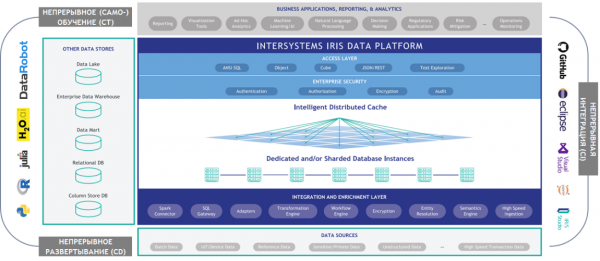
Figur 10 InterSystems IRIS-arkitektur i sammanhanget av AI/ML i realtid
Precis som föregående diagram kombinerar nedanstående diagram det nya "koordinatsystemet" (CD/CI/CT) med informationsflödes schemat mellan plattformens arbetskomponenter. Visualiseringen börjar med makromekanismerna CD och fortsätter med makromekanismerna CI och CT.
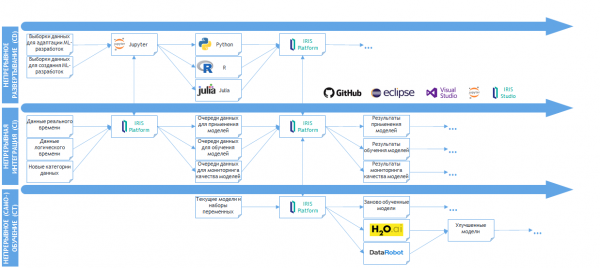
Figur 11 Informationsflödes schema mellan AI/ML-komponenterna på InterSystems IRIS-plattformen
Kärnan i CD-mekanismen i InterSystems IRIS: användarna av plattformen (utvecklare av AI/ML-lösningar) anpassar redan existerande och/eller skapar nya AI/ML-applikationer med hjälp av en specialiserad kodredigerare för AI/ML-mekanismer: Jupyter (fullständigt namn: Jupyter Notebook; ibland kallas även de dokument som skapats i denna redigerare för korthet). I Jupyter har utvecklaren möjligheten att skriva, debugga och verifiera funktionaliteten (inklusive med grafik) av en specifik AI/ML-utveckling innan den distribueras i InterSystems IRIS. Det är förståeligt att den nya utvecklingen som skapas på detta sätt endast får grundläggande felsökning (eftersom Jupyter bland annat inte arbetar med realtidsdatastreams) – detta är som det ska vara, eftersom huvudresultatet av utvecklingen i Jupyter blir att bekräfta den principiella funktionaliteten hos enskilda AI/ML-mekanismer ("visar förväntat resultat på datamängden"). På liknande sätt kan en redan distribuerad mekanism (se följande makromekanism) innan felsökning i Jupyter kräva en "återgång" till "doplatforms"-läget (läsning av data från filer, arbete med data via xDBC istället för tabeller, direkt interaktion med globala variabler – multidimensionella datamatriser i InterSystems IRIS – etc.).
En viktig aspekt av CD-implementeringen just i InterSystems IRIS: mellan plattformen och Jupyter finns en tvåvägsintegration som möjliggör överföring av innehåll på språken Python, R och Julia (alla tre är programmeringsspråk i relevanta ledande open-source miljöer för matematisk modellering) till plattformen (och, i framtiden, bearbetning inom plattformen). Således har utvecklare av AI/ML-innehåll möjlighet att genomföra "kontinuerlig distribution" av detta innehåll i plattformen, arbetandes i sin vanliga redigerare Jupyter, med bekanta bibliotek som är tillgängliga i Python, R, Julia och genomföra grundläggande felsökning (vid behov) utanför plattformen.
Vi går vidare till makromekanismen CI i InterSystems IRIS. Diagrammet visar makroprocessen för "real-tidsroboten" (ett komplex av datatyper, affärsprocesser och de kodfragment som orkestreras av dessa på språk som matematikmiljöer och ObjectScript - det inhemska utvecklingsspråket för InterSystems IRIS). Syftet med denna makroprocess är att upprätthålla de nödvändiga dataköerna för AI/ML-mekanismer (baserat på datastreams som överförs till plattformen i realtid), fatta beslut om sekvenserna av tillämpning och "utbudet" av AI/ML-mekanismer (de som kallas "matematiska algoritmer", "modeller" osv. – kan benämnas olika beroende på konkret implementation och terminologiska preferenser), samt att hålla datatyperna aktuella för analys av resultaten från AI/ML-mekanismerna (kub, tabeller, multidimensionella datamängder osv. – för rapporter, dashboards osv.).
En viktig aspekt av implementeringen av CI just i InterSystems IRIS: mellan plattformen och de matematiska modelleringsmiljöerna har en tvåvägsintegration realiserats, vilket gör det möjligt att exekvera innehållet på plattformen skrivet i Python, R och Julia i sina respektive miljöer och få resultaten tillbaka. Denna integration genomförs både i "terminal-läge" (d.v.s. AI/ML-innehållet formuleras som kod i ObjectScript som gör anrop till matematikmiljöerna), samt i "affärsprocess-läge" (d.v.s. AI/ML-innehållet formuleras som en affärsprocess med hjälp av en grafisk redigerare, eller ibland med Jupyter, eller med IDE – IRIS Studio, Eclipse, Visual Studio Code). Tillgängligheten av affärsprocesser för redigering i Jupyter återspeglas genom kopplingen mellan IRIS på CI-nivå och Jupyter på CD-nivå. En mer detaljerad översikt av integrationen med matematiska modelleringsmiljöer ges senare. Vid detta stadium anser vi att det finns alla skäl att fastslå att plattformen har alla nödvändiga verktyg för att genomföra "kontinuerlig integration" av AI/ML-utvecklingar (som kommer från "kontinuerlig distribution") till AI/ML-lösningar i realtid.
Och den viktigaste makromekanismen: CT. Utan den blir det ingen AI/ML-plattform (även om "real-time" kommer att implementeras via CD/CI). Kärnan i CT är plattformens arbete med "artefakter" från maskininlärning och artificiell intelligens direkt i arbetssessioner av matematiska modelleringsmiljöer: modeller, distributionsmatriser, vektorer-matrisar, lager av neurala nätverk, etc. Detta "arbete" består i de flesta fall av att skapa de nämnda artefakterna i miljöerna (för modeller, till exempel, innebär "skapandet" att specificera modellens specifikation och därefter välja värden för dess parametrar - den så kallade "träningsprocessen" av modellen), deras tillämpning (för modeller: beräkning av "modell"-värden för de målvariabler - prognoser, tillhörighet till kategorier, sannolikhet för händelser, etc.) och förbättring av redan skapade och tillämpade artefakter (till exempel omdefiniera satsen av ingångsvariabler för modellen baserat på resultat av tillämpning - för att öka precisionen i prognoserna, som ett alternativ). En nyckelpunkt för att förstå rollen av CT är dess "abstrakthet" från realiteterna i CD och CI: CT kommer att implementera alla artefakter med hänsyn till den beräknings- och matematiska specifikationen för AI/ML-lösningen inom ramen för de möjligheter som tillhandahålls av specifika miljöer. Ansvarigheten för "att förse med input-data" och "att leverera resultat" kommer att ligga på CD och CI.
En viktig aspekt av implementeringen av CT i InterSystems IRIS: genom att använda den tidigare nämnda integrationen med matematiska modelleringsmiljöer har plattformen möjlighet att extrahera artefakter från arbets sessioner som körs under dess hantering i matematiska miljöer och (det mest viktiga) omvandla dem till databasobjekt på plattformen. Till exempel kan en distributions tabell som just har skapats i en arbets session i Python överföras till plattformen i form av en global (en flerdimensionell datamängd i InterSystems IRIS) - utan att stoppa sessionen i Python - och användas för beräkningar i en annan AI/ML-mekanism (genomförd i ett annat språk - till exempel R) - eller en virtuell tabell. Ett annat exempel: parallellt med den
Låt oss titta närmare på AI/ML-funktionaliteten på plattformen InterSystems IRIS, med hjälp av ett verkligt prototypexempel.
I den nedan angivna diagrammet, på vänster sida av bilden – en del av affärsprocessen som implementerar körningen av skript i Python och R. I mitten – visuella loggar för verkställandet av några av dessa skript, respektive, i Python och R. Direkt efter dem – exempel på innehåll på båda språken som överförts för körning i de respektive miljöerna. Längst till höger – visualiseringar baserade på resultaten av skriptens körning. Visualiseringarna ovan – gjordes i IRIS Analytics (data hämtades från Python till InterSystems IRIS dataplattform och visades i en dashboard med plattformens verktyg), nedan – gjordes direkt i arbets-sessionen R och exporterades därifrån till grafiska filer. En viktig aspekt: den presenterade delen i prototypen ansvarar för modellens träning (klassificering av utrustningens tillstånd) baserat på data som kommer i realtid från en simuleringsprocess av utrustningen, på kommando från processen för kvalitetsövervakning av klassificeringen, som observeras under användningen av modellen. Om implementeringen av AI/ML-lösningen som en uppsättning interagerande processer ("agenter") kommer att diskuteras senare.
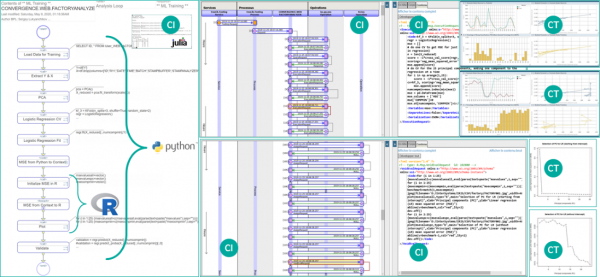
Figur 12 Interaktion med Python, R och Julia i InterSystems IRIS
Plattformsprocesser (även kallade "affärsprocesser", "analysprocesser", "pipelines" etc. – beroende på kontexten) är främst redigerbara i den grafiska redigeraren för affärsprocesser i plattformen, på så sätt att både dess flödesschema och motsvarande AI/ML-mekanism (programkod) skapas samtidigt. När vi säger att "det skapas en AI/ML-mekanism" syftar vi från början på hybriditet (inom en och samma process): innehållet på matematiska modelleringsspråk samexisterar med innehållet på SQL (inklusive tillägg från ), i InterSystems ObjectScript, med andra stödda språk. Dessutom ger plattformens process mycket stora möjligheter för "ritning" i form av hierarkiskt inbäddade fragment (som visas i exemplet på diagrammet nedan), vilket gör det möjligt att effektivt organisera även mycket komplexa innehåll, utan att "falla ut" ur det grafiska formatet (i "icke-grafiska" metoder/klasser/procedurer etc.). Det vill säga, vid behov (och detta förväntas i de flesta projekt) kan hela AI/ML-lösningen implementeras i ett grafiskt självkommenterande format. Vi uppmärksammar att i den centrala delen av diagrammet nedan, där en högre "nivå av inbäddning" presenteras, syns att förutom det faktiska arbetet med att träna modellen (med hjälp av Python och R), läggs även analysen av den så kallade ROC-kurvan för den tränade modellen till, vilket gör det möjligt att visuellt (och också beräkningsmässigt) utvärdera kvaliteten på träningen - och denna analys är genomförd på språket Julia (körs, av således i Matlab-miljö Julia).
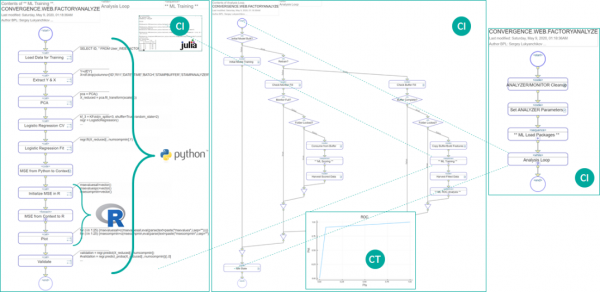
Figur 13 Visuell miljö för komposition av AI/ML-lösningar i InterSystems IRIS
Som nämnts tidigare kommer den initiala utvecklingen och (i vissa fall) anpassningen av redan implementerade AI/ML-mekanismer på plattformen att kunna utföras utanför plattformen i Jupyter-redigeraren. I diagrammet nedan ser vi ett exempel på anpassning av den existerande plattformsprocessen (den samma som på diagrammet ovan) - så här ser den delen ut i Jupyter som ansvarar för att träna modellen. Innehållet på Python-språket är tillgängligt för redigering, felsökning och visning av grafik direkt i Jupyter. Ändringar (vid behov) kan göras med omedelbar synkronisering med plattformens process, inklusive dess produktionsversion. På liknande sätt kan nytt innehåll överföras till plattformen (ny plattformsprocess skapas automatiskt).
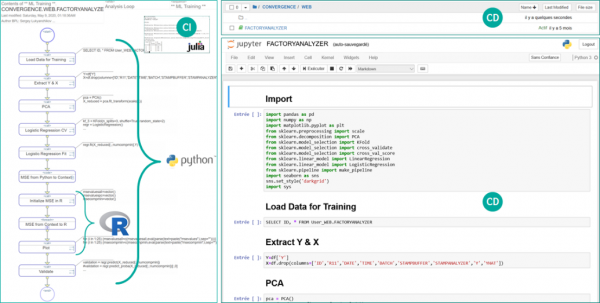
Figur 14 Användning av Jupyter Notebook för redigering av AI/ML-mekanismen i plattformen InterSystems IRIS
Anpassningen av plattformsprocessen kan utföras inte bara i grafisk eller bärbar format – utan också i ett "totalt" IDE-format (Integrated Development Environment). Sådana IDE är IRIS Studio (den inbyggda studio IRIS), Visual Studio Code (tillägget InterSystems IRIS för VSCode) och Eclipse (plugin Atelier). I vissa fall kan hela utvecklingsteamet använda alla tre IDE:er samtidigt. Diagrammet nedan visar ett exempel på redigering av samma process i IRIS-studion, Visual Studio Code och Eclipse. Allt innehåll är tillgängligt för redigering: både Python/R/Julia/SQL, ObjectScript och affärsprocesser.
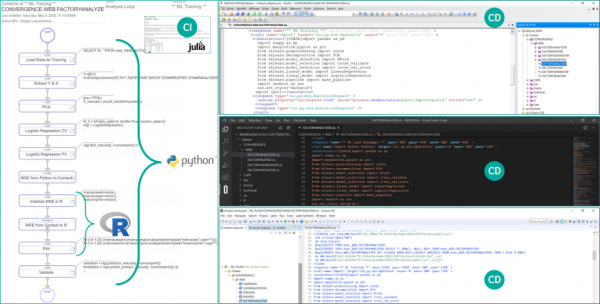
Figur 15 Utveckling av affärsprocessen InterSystems IRIS i olika IDE:er
Det är värt att nämna verktygen för beskrivning och genomförande av affärsprocesser i InterSystems IRIS med hjälp av Business Process Language (BPL). BPL gör det möjligt att använda "färdiga integrationskomponenter" (activities) i affärsprocesser – vilket i sin tur ger fulla skäl att påstå att "kontinuerlig integration" är implementerad i InterSystems IRIS. Färdiga komponenter av affärsprocessen (aktiviteter och kopplingar mellan dem) är en kraftfull accelerator för byggandet av AI/ML-lösningar. Och inte bara byggandet: tack vare aktiviteterna och kopplingarna mellan dem uppstår ett "autonomt ledningslager" över åtskilda AI/ML-utvecklingar och mekanismer, vilket möjliggör beslutstagande i realtid beroende på situationen.
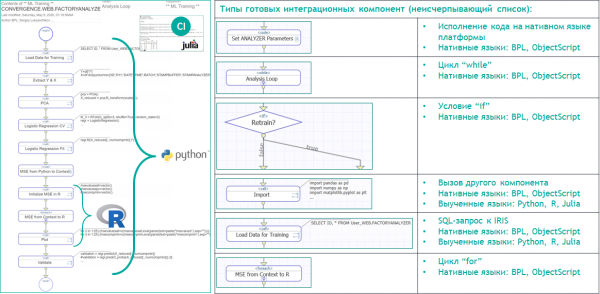
Figur 16 Färdiga komponenter av affärsprocesser för kontinuerlig integration (CI) på InterSystems IRIS-plattformen
Konceptet agentbaserade system (även kallade "multi-agent system") har en stark ställning inom robotisering, och plattformen InterSystems IRIS stöder det organiskt genom konstruktet "produkt-process". Förutom de obegränsade möjligheterna att utrusta varje process med nödvändig funktionalitet för den övergripande lösningen, gör det att tilldela plattformsprocesserna egenskapen "agentlighet" att skapa effektiva lösningar för extremt instabila modellerade fenomen (beteende hos sociala/biosystem, delvis observerade teknologiska processer osv.).
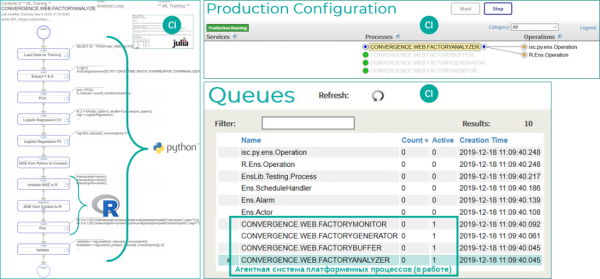
Figur 16 Arbetet av AI/ML-lösningen i form av ett agentbaserat system för affärsprocesser i InterSystems IRIS
Vi fortsätter vår översikt av InterSystems IRIS med en berättelse om tillämpningen av plattformen för att lösa hela klasser av realtidsuppgifter (en ganska detaljerad introduktion till några av de bästa metoderna för plattforms-AI/ML på InterSystems IRIS finner du i en av våra tidigare artiklar. ).
Som en uppföljning av den föregående diagrammet följer här ett mer detaljerat diagram över agent-systemet. Diagrammet visar samma prototyp, med alla fyra agentprocesser skisserade och relationerna mellan dem: GENERATOR – hanterar datautvinning från utrustningens sensorer, BUFFER – hanterar dataköer, ANALYZER – utför själva maskininlärningen, MONITOR – övervakar kvaliteten på maskininlärningen och signalerar behovet av att återträna modellen.
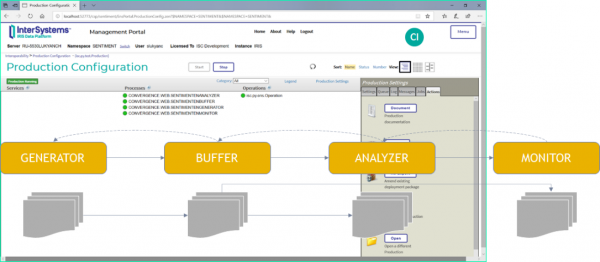
Figur 17 Kompositionen av AI/ML-lösningen som en agentbaserad affärsprocess i InterSystems IRIS.
I diagrammet nedan illustreras det autonoma arbetet hos en annan robotprototyp (igenkänning av känslomässig ton i texter) under en viss tid. I den övre delen – utvecklingen av kvaliteten på modellens inlärning (kvaliteten ökar), i den nedre delen – dynamiken av kvaliteten på modellens tillämpning och fakta om återträning (de röda staplarna). Som kan ses har lösningen effektivt och autonomt självlärt sig och fungerar på ett angivet kvalitetsnivå (kvalitetsvärdena sjunker inte under 80%).
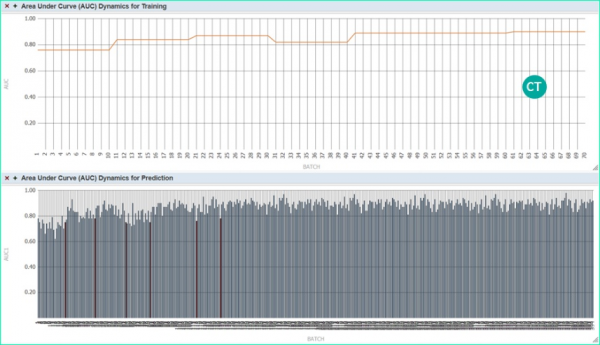
Figur 18 Kontinuerlig (själv-)inlärning (CT) på plattformen InterSystems IRIS.
Vi har också nämnt "auto-ML" tidigare, men i diagrammet nedan visas tillämpningen av denna funktionalitet i detalj med ett annat prototyp-exempel. I det grafiska schemat för affärsprocessens fragment visas aktiviteten som utlöser modellberäkningen i H2O-stacken, resultaten av denna modellberäkning visas (uppenbar dominans av den erhållna modellen över "manuellt skapade" modeller, enligt den jämförande diagrammet av ROC-kurvorna, samt automatiserad identifiering av "de mest inflytelserika variablerna" från de tillgängliga i datauppsättningen). En viktig punkt här är den tids- och expertresursbesparing som uppnås genom "auto-ML": vad vår plattform gör på en halvmiljön (att hitta och träna den optimala modellen) kan ta en expert mellan en vecka och en månad.
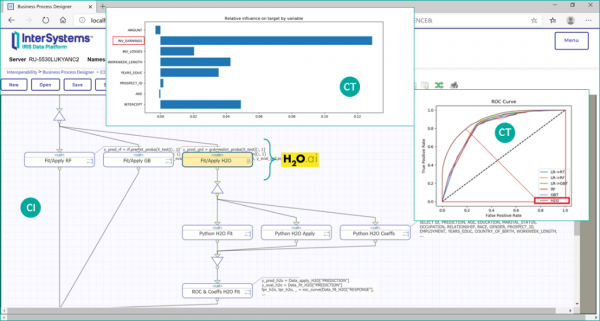
Figur 19 Integrering av "auto-ML" i AI/ML-lösningen på InterSystems IRIS-plattformen
Diagrammet nedan "tar bort spänningen", men det är ett bra sätt att avsluta berättelsen om de klasser av problem som löses i realtid: vi påminner om att trots alla möjligheter med InterSystems IRIS-plattformen, är modellträning specifikt under dess styrning inte obligatorisk. Plattformen kan ta emot en så kallad PMML-specifikation för en modell, tränad i ett verktyg som inte är under plattformens kontroll - och tillämpa denna modell i realtid från och med importen av den. . Det är också viktigt att beakta att långt ifrån alla AI/ML-artiklar kan reduceras till en PMML-specifikation, även om de flesta av de vanligaste artiklarna gör det möjligt att göra så. Således har InterSystems IRIS-plattformen en "öppen kontur" och innebär inte "plattformsslaveri" för användarna.
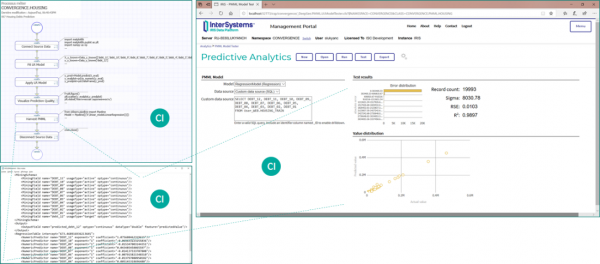
Figur 20 Integrering av "auto-ML" i AI/ML-lösningen på InterSystems IRIS-plattformen
Låt oss lista ytterligare plattformsfördelar med InterSystems IRIS (för tydlighetens skull, tillämpat på hantering av teknologiska processer), som är av stor betydelse vid automatisering av artificiell intelligens och maskininlärning i realtid:
- Utvecklade integrationsverktyg med alla datakällor och mottagare (Automatiserade system för kontroll och datainsamling/SCADA, utrustning, underhåll, ERP etc.)
- Inbyggd för högpresterande hybrid transaktions-analytisk bearbetning (Hybrid Transaction/Analytical Processing, HTAP) av alla datavolymer inom teknologiska processer
- Utvecklingsverktyg för kontinuerlig implementering av AI/ML-mekanismer för realtidslösningar baserade på Python, R, Julia
- Adaptiva affärsprocesser för kontinuerlig integration och (själv)inlärning av AI/ML-lösningar i realtid
- Inbyggda verktyg för Business Intelligence för visualisering av data från teknologiska processer och resultat från AI/ML-lösningar
- för att leverera resultat från AI/ML-lösningar till styrsystem/SCADA, informationsanalysystem, aviseringar med mera
AI/ML-lösningar på InterSystems IRIS-plattformen integreras enkelt i existerande IT-infrastruktur. InterSystems IRIS-plattformen ger hög tillförlitlighet för AI/ML-lösningar genom att stödja redundanta och katastrofresistenta konfigurationer samt flexibel implementering i virtuella miljöer, på fysiska servrar, i privata och offentliga moln och Docker-containrar.
Därmed är InterSystems IRIS en universell plattform för AI/ML-beräkningar i realtid. Plattformens mångsidighet bekräftas praktiskt genom avsaknaden av de facto-gränser för komplexiteten av implementerade beräkningar, och InterSystems IRIS har förmågan att kombinera (i realtid) bearbetning av scenarier från olika branscher samt en exceptionell anpassningsförmåga för alla funktioner och mekanismer i plattformen efter specifika användarbehov.
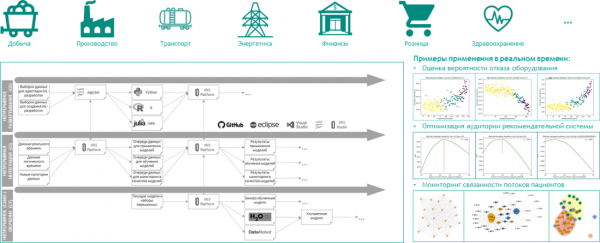
Bild 21 InterSystems IRIS — en universell plattform för AI/ML-beräkningar i realtid
För en mer specifik interaktion med dem av våra läsare som är intresserade av materialet som presenteras här, rekommenderar vi att inte bara begränsa sig till att läsa det utan att fortsätta dialogen "live". Vi är redo att erbjuda stöd för formuleringen av realtids AI/ML-scenarier anpassade till din företags specifika behov, genomföra gemensam prototyptillverkning på InterSystems IRIS-plattformen, samt formulera och praktiskt genomföra en vägkarta för implementering av artificiell intelligens och maskininlärning i dina produktions- och ledningsprocesser. E-postadressen till vår expertgrupp för AI/ML är .
Källa: habr.com
