

Industriell utveckling av mjukvarusystem kräver stor uppmärksamhet på slutproduktens driftssäkerhet, liksom snabb respons på fel och avbrott om de skulle inträffa. Övervakning hjälper naturligtvis till att reagera på fel och avbrott mer effektivt och snabbt, men det är inte tillräckligt. För det första är det mycket svårt att hålla koll på ett stort antal servrar – det krävs en stor mängd människor. För det andra måste man ha en god förståelse för hur applikationen är strukturerad för att kunna förutsäga dess tillstånd. Följaktligen behövs många personer som har god kunskap om de system vi utvecklar, deras parametrar och egenskaper. Anta att vi skulle kunna hitta tillräckligt många personer som vill arbeta med detta, så krävs det ändå mycket tid för att utbilda dem.
Vad ska man göra? Här kommer artificiell intelligens till vår hjälp. Artikeln handlar om (predictive maintenance). Denna metod blir alltmer populär. Det har skrivits ett stort antal artiklar, inklusive på Habré. Stora företag använder den här metoden för att upprätthålla sina servrars funktionalitet. Efter att ha studerat många artiklar beslutade vi att försöka tillämpa denna metod. Vad blev resultatet?
Introduktion
Det utvecklade mjukvarusystemet sätts förr eller senare i drift. Det är viktigt för användaren att systemet fungerar utan avbrott. Om en oförutsedd situation trots allt inträffar, bör den lösas med minsta möjliga förseningar.
För att underlätta den tekniska supporten av mjukvarusystemet, särskilt om det finns många servrar, brukar man använda övervakningsprogram som samlar in mätvärden från det fungerande mjukvarusystemet, ger möjlighet att diagnostisera dess tillstånd och hjälper till att fastställa vad som orsakade felet. Denna process kallas övervakning av mjukvarusystemet.
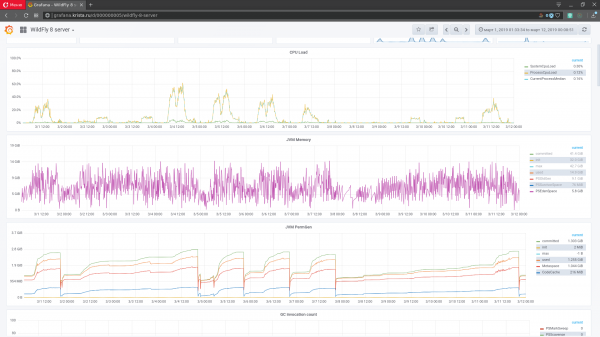
Figur 1. Gränssnitt för övervakning grafana
Metriker är olika indikatorer från det programvarusystem, den körmiljö eller den fysiska beräkningsmaskin där systemet körs, med en tidsstämpel för den tidpunkt då mätningarna erhölls. I statisk analys kallas mätdata för tidsserier. För att övervaka tillståndet hos programvarusystemet visas mätvärden i form av grafer: tid på X-axeln och värden på Y-axeln (figur 1). Ett fungerande programvarusystem kan generera flera tusen mätvärden (från varje nod). Dessa bildar ett mätutrymme (flerdimensionella tidsserier).
Eftersom komplexa programvarusystem samlar stora mängder mätvärden blir manuell övervakning en utmanande uppgift. För att minska mängden data som administratören måste analysera innehåller övervakningsverktyg funktioner för automatisk identifiering av potentiella problem. Till exempel kan en trigger ställas in för att aktiveras när det fria diskutrymmet minskar under en angiven gräns. Serverstopp eller kritisk försämring av servicenivå kan också automatiskt diagnostiseras. I praktiken hanterar övervakningsverktyg relativt bra att upptäcka redan inträffade fel eller identifiera enkla symptom på framtida fel, men övergripande förblir förutsägelsen av möjliga haverier en svår nöt att knäcka. Förutsägelse genom manuell analys av mätningar kräver kvalificerade specialister och är oftast ineffektiv. Många potentiella haverier kan förbli oupptäckta.
På senare tid har prediktivt underhåll av programvarusystem blivit alltmer populärt bland stora IT-företag som utvecklar mjukvara. Kärnan i denna metod är att identifiera problem som leder till systemdegradering i ett tidigt skede, före haveriet, med hjälp av artificiell intelligens. Denna metod utesluter inte helt manuell övervakning av systemet. Den är ett komplement till övervakningsprocessen i sin helhet.
Huvudverktyget för att genomföra prediktivt underhåll är uppgiften att hitta avvikelser i tidsserier, eftersom vid uppkomsten av en avvikelse i datan är sannolikheten stor att om en tid ett fel eller avbrott kommer att inträffa. En avvikelse är en viss avvikelse i programvarusystemets indikatorer, såsom upptäckten av en nedgång i hastigheten för ett visst typ av förfrågan eller en minskning av det genomsnittliga antalet hanterade förfrågningar vid en konstant nivå av kundsessioner.
Uppgiften att upptäcka avvikelser i programvarusystem har sin egen specifik. I teorin krävs det att varje programvarusystem utvecklar eller förbättrar sina metoder, eftersom upptäckten av avvikelser är starkt beroende av de data i vilka det utförs, och dessa data varierar mycket beroende på vilka verktyg som används för att implementera systemet, ända ner till vilken typ av beräkningsmaskin det körs på.
Metoder för att upptäcka avvikelser vid prognostisering av fel i programvarusystem
Först och främst bör det nämnas att idéen om prognostisering av fel inspirerades av artikeln . För att kontrollera effektiviteten av metoden för automatisk upptäckte avvikelser valdes programvarusystemet «Web-Konsolidering», vilket är ett av projekten hos NPO «Krista». För detta system genomfördes tidigare manuell övervakning av de erhållna metrikarna. Eftersom systemet är ganska komplext samlas det in ett stort antal metrikar: JVM-indikatorer (belastning av skräpmängd), indikatorer för det operativsystem som kör koden (virtuellt minne, % CPU-belastning), nätverksindikatorer (nätverksbelastning), servrarna (CPU-belastning, minnesbelastning), wildfly-metrik och egna metrikar för applikationen på alla kritiska delsystem.
Alla metrikar samlas in från systemet med hjälp av graphite. Inledningsvis användes databasen whisper som en standardlösning för grafana, men med tillväxten av kundbasen kunde graphite inte längre hantera detta, vilket utmattade diskens kapacitet i datacentret. Efter detta fattades beslutet att söka en mer effektiv lösning. Valet föll på , vilket gjorde det möjligt att kraftigt minska belastningen på diskens subsystem och minska det upptagna diskutrymmet fem till sex gånger. Nedan visas schemat för mekanismen för att samla in metrikar med hjälp av graphite+clickhouse (figur 2).
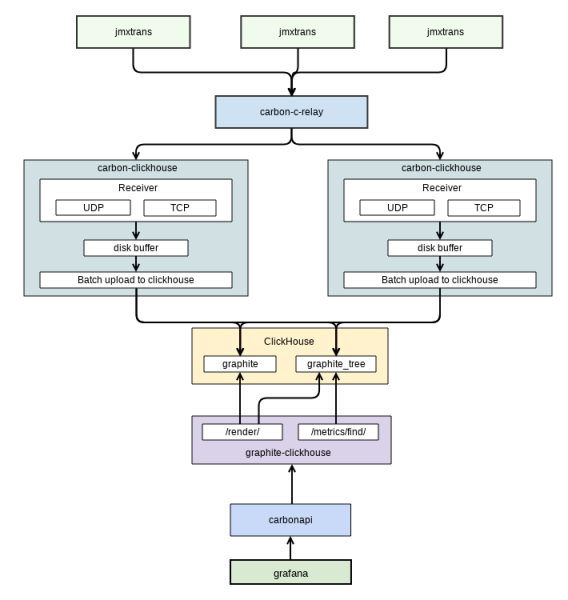
Figur 2. Schema för insamling av metrikar
Diagrammet är hämtat från intern dokumentation. Den visar datakommunikationen mellan grafana (användargränssnittet för övervakning som vi använder) och graphite. Mätningarna från applikationen görs av en separat programvara – . Den lagrar dem i graphite.
Systemet "Web-Konsolidering" har ett antal särdrag som skapar problem för felprognoser:
- trender förändras ofta. För detta mjukvarusystem kommer olika versioner ut. Varje version medför förändringar i systemets programdel. Därmed påverkar utvecklarna direkt mätningarna i systemet och kan orsaka trendförändringar;
- implementeringsspecifika särdrag samt användningsmål för detta system skapar ofta anomalier utan föregående nedgradering;
- andelen anomalier i förhållande till hela datamängden är låg (< 5%);
- det kan uppstå avbrott i mottagningen av indikatorer från systemet. Under korta tidsperioder kan övervakningssystemet misslyckas med att få mätningar, till exempel om servern är överbelastad. För att träna neuronnätet är detta kritiskt. Det finns ett behov av att fylla luckorna syntetiskt;
- Anomalifall är ofta relevanta endast för ett specifikt nummer/månad/tid (säsongsbetonat). Detta system har tydliga riktlinjer för hur användarna ska använda det. Därför är mätningarna endast aktuella för en specifik tid. Systemet kan användas intermittens, endast under vissa månader, beroende på året. Det uppstår situationer där samma beteende hos mätningarna i ett fall kan leda till ett fel i mjukvarusystemet, medan det i ett annat inte gör det.
Först analyserades metoder för att upptäcka anomalier i övervakningsdata från programvarusystem. I artiklar om detta ämne föreslås ofta att använda neuronnät vid låga procentandelar av anomalier i förhållande till den övriga datamängden.
Den grundläggande logiken för att hitta anomalier med hjälp av neuronnät presenteras i figur 3:
Figur 3. Sökning av anomalier med hjälp av neuronnät
I resultatet av prognosen eller återställningen av det aktuella flödet av mätvärden beräknas avvikelsen från det erhållna från det fungerande programvarusystemet. Vid stor skillnad mellan de erhållna mätvärdena från programvarusystemet och neurala nätverket kan ett uttalande göras om anomaliteten hos det aktuella datasegmentet. Följande problem uppstår för användningen av neurala nätverk:
- för korrekt funktion i strömmande läge måste data för att träna modeller för neurala nätverk bara innehålla "normala" data;
- det är nödvändigt att ha en aktuell modell för korrekt detektion. Förändring av trender och säsongsbetonade faktorer i mätningar kan orsaka ett stort antal falska positiva resultat för modellen. För att uppdatera den måste man tydligt definiera tidpunkten när modellen är föråldrad. Om modellen uppdateras för sent eller för tidigt är det troligt att många falska positiva resultat följer.
Man får inte glömma att söka och förhindra frekventa falska positiva resultat. Det antas att de oftast uppstår i icke-standardiserade situationer. Men de kan också vara en följd av ett neuralt nätverks fel på grund av otillräcklig träning. Det är nödvändigt att minimera antalet falska positiva resultat från modellen. Annars kommer falska prognoser att ta mycket tid från administratören som är avsedd för systemövervakning. Så småningom kommer det att leda till att administratören helt enkelt slutar reagera på det "paranoida" övervakningssystemet.
Rekurrent neurala nätverk
För att upptäcka anomalier i tidsserier kan man använda med LSTM-minne. Problemet är endast att det kan tillämpas endast på förutsägbara tidsserier. I vårt fall är inte alla mätningar förutsägbara. Försöket att tillämpa RNN LSTM på en tidsserie presenteras i bild 4.
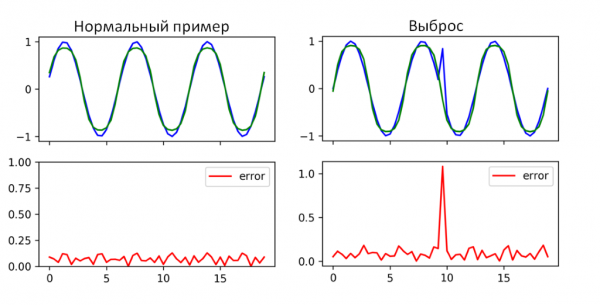
Bild 4. Exempel på hur ett rekurrent neuralt nätverk med LSTM-minnesceller fungerar
Som det framgår av figur 4 lyckades RNN LSTM hantera anomalidetektering under denna tidsperiod. Där resultatet har en hög prognosfel (mean error) inträffade faktiskt en avvikelse i mätvärdena. Endast att använda en RNN LSTM kommer tydligt att vara otillräckligt eftersom den är tillämpbar på ett begränsat antal mätvärden. Den kan användas som en hjälpmekanism för att hitta avvikelser.
Autokodare för felprognoser
– är i grunden ett artificiellt neuronnät. Inmatningslagret är encoder, utmatningslagret är decoder. Nackdelen med alla neuronnät av denna typ är att de dåligt lokaliserar avvikelser. En arkitektur för synkront autokodare valdes.
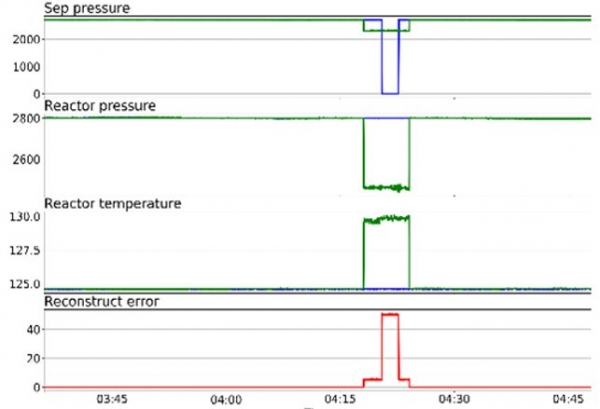
Figur 5. Exempel på autokodare i arbete
Autokodarna tränas på normala data och hittar sedan något avvikande i den data som matas in i modellen. Precis vad som behövs för denna uppgift. Det återstår bara att välja vilken av autokodarna som är lämplig för denna uppgift. Den mest arkitektoniskt enkla formen av autokodare är ett direkt, icke-cyklist neuronnät som liknar (multilayer perceptron, MLP), med ett inmatningslager, ett utmatningslager och ett eller flera dolda lager som förbinder dem.
Men skillnaderna mellan autokodare och MLP ligger i att utgångsnivån i autokodaren har samma antal noder som ingången, och att istället för att träna för att förutsäga ett målvärde Y, som ges av ingången X, tränar autokodaren för att rekonstruera sina egna X. Därför är autokodare oövervakade inlärningsmodeller.
Autokodarens uppgift är att hitta tidsindex r0 … rn som motsvarar avvikande element i ingångsvektorn X. Denna effekt uppnås genom att söka efter kvadratisk fel.
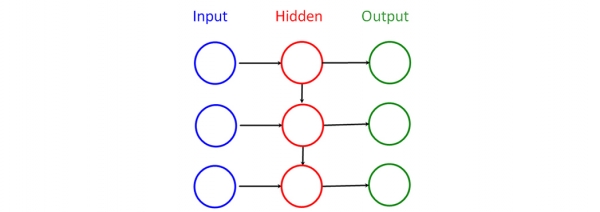
Figur 6. Synkront autokodare
För autokodaren valdes en . Dess fördelar: möjligheten att använda strömmande bearbetning och ett relativt mindre antal parametrar i neuronnätet jämfört med andra arkitekturer.
Mekanismen för att minimera falska larm
Eftersom olika oregelbundna situationer kan uppstå och det också kan finnas en brist på utbildning av neuralnätverket, har det beslutats att utveckla en mekanism för att minimera falska larm för den utvecklade modellen för anomalidetektion. Denna mekanism baseras på en mall databas som klassificeras av administratören.
(DTW-algoritm, från engelska dynamic time warping) gör det möjligt att hitta den optimala överenskommelsen mellan tidsserier. Det tillämpades först inom taligenkänning: använts för att bestämma hur två talade signaler representerar samma ursprungliga uttalade fras. Senare har det hittat tillämpningar även inom andra områden.
Huvudprincipen för att minimera falska larm är insamlingen av en databas av referenser genom en operatör som klassificerar misstänkta fall upptäckta av neurala nätverk. Därefter jämförs den klassificerade referensen med det fall som systemet upptäckte, och det dras slutsatser om fallet tillhör falskt larm eller en verklig störning. Algoritmen DTW används specifikt för att jämföra två tidsserier. Huvudverktyget för minimisering är dock fortfarande klassifikationen. Det antas att efter att ha samlat in ett stort antal referensfall kommer systemet att fråga operatören mindre på grund av likheten hos de flesta fall och uppkomsten av liknande händelser.
Som ett resultat av de ovan beskrivna metoderna för neurala nätverk har ett experimentellt program skapats för att förutsäga systemfel i "Web-Konsolidering". Syftet med detta program var att använda det existerande arkivet av övervakningsdata och information om redan inträffade fel för att utvärdera kompetensen hos denna metod för våra programvarusystem. Programschema visas nedan, i figur 7.
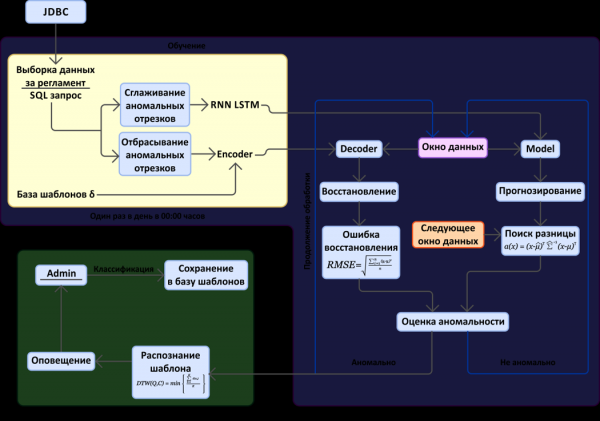
Figur 7. Schema för förutsägelse av fel baserat på analys av metrikrymden
I schemat kan två huvudsakliga block identifieras: sökandet efter anomala tidssegment i övervakningsdata (metrik) och mekanismen för att minimera falska larm. Obs: För experimentella syften erhålls data via JDBC-anslutning från databasen där de lagras graphite.
Nedan visas gränssnittet för det system för övervakning som utvecklades (figur 8).
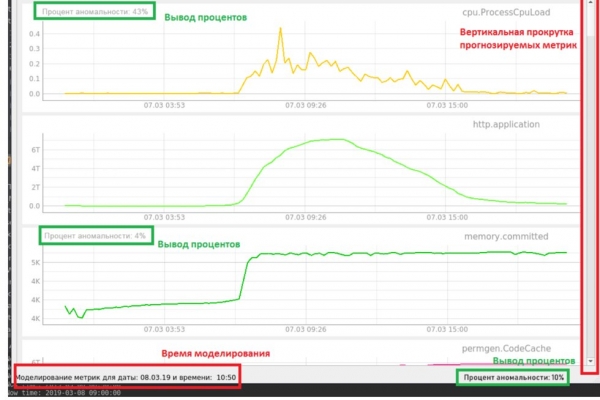
Figur 8. Gränssnitt för det experimentella övervakningssystemet
På gränssnittet visas procentandelen av anomaliteter för de mottagna mätvärdena. I vårt fall simulerar vi mottagningen. Vi har redan all data från flera veckor och laddar dem gradvis för att kontrollera fallet med en anomali som leder till ett fel. I den nedre statusfältet visas den totala procentandelen av anomaliteter vid denna tidpunkt, vilket bestäms av en autoencoder. För de förutsagda mätvärdena visas också en separat procentandel, som beräknas av en RNN LSTM.
Exempel på anomaliupptäckning baserat på CPU-prestanda med hjälp av RNN LSTM-nätverket (figur 9).
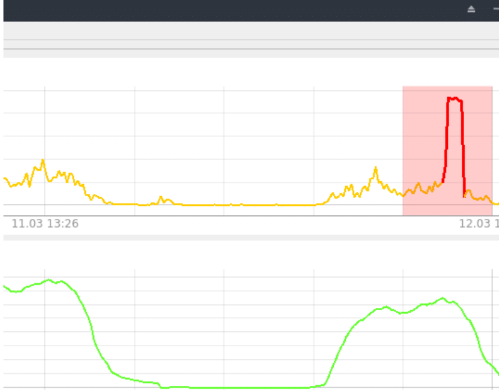
Figur 9. Upptäckning med RNN LSTM
Ett ganska enkelt fall, i själva verket en vanlig avvikelse, som dock ledde till ett systemfel, har framgångsrikt beräknats med hjälp av RNN LSTM. Anomalinivån under denna tidsperiod är 85 - 95 %, allt över 80 % (tröskelvärdet definierat experimentellt) anses vara en anomali.
Exempel på anomaliupptäckning när systemet inte kunde starta efter en uppdatering. Denna situation detekteras av autoencodern (figur 10).
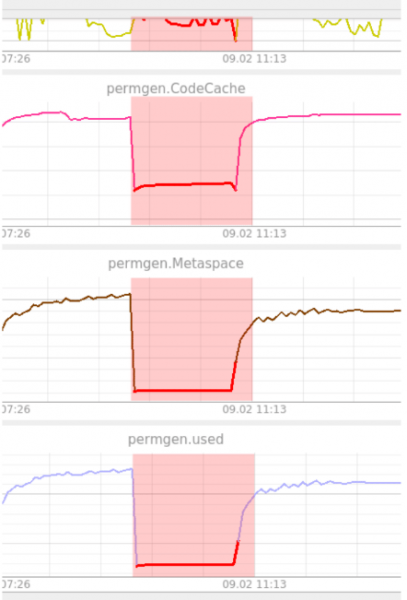
Figur 10. Exempel på upptäckning med autoencodern
Som syns i bilden har PermGen fastnat på en nivå. Autoencodern ansåg detta vara märkligt, eftersom den tidigare inte hade sett något liknande. Här hålls anomalitetsnivån på 100 % tills systemet återgår till ett fungerande tillstånd. Anomaliteter visas över alla mätvärden. Som nämnts tidigare kan autoencodern inte lokalisera anomalier. Operatören är avsedd att utföra denna funktion i sådana situationer.
Slutsats
PC "Web-Konsolidering" har utvecklats under flera år. Systemet är relativt stabilt och antalet registrerade incidenter är lågt. Trots detta har det varit möjligt att upptäcka anomalier som leder till ett fel 5 - 10 minuter innan felet inträffar. I vissa fall skulle tidig varning om fel ha hjälpt till att spara den planerade tid som avsatts för "reparationsarbete".
Utifrån de experiment som har utförts är det fortfarande för tidigt att dra definitiva slutsatser. För närvarande är resultaten motstridiga. Å ena sidan är det tydligt att algoritmer baserade på neurala nätverk kan hitta "användbara" anomalier. Å andra sidan finns det en stor andel falska positiva och inte alla anomalier som en kvalificerad specialist identifierar kan upptäckas av neuronnätet. En nackdel är också att neuronnätet för närvarande kräver lärande med en lärare för att fungera normalt.
För att vidareutveckla systemet för att förutsäga fel och få det till ett tillfredsställande tillstånd kan flera vägar övervägas. En väg är att göra en mer detaljerad analys av fallen med anomalier som leder till fel, genom att komplettera listan över viktiga mätvärden som påverkar systemets tillstånd och filtrera bort de som inte gör det. Om man går i denna riktning kan man även försöka specialisera algoritmerna för våra specifika fall med anomalier som leder till fel. Det finns också en annan väg. Det handlar om att förbättra arkitekturerna för neurala nätverk och därigenom öka detekteringsnoggrannheten samtidigt som träningstiden minskar.
Jag vill uttrycka min tacksamhet till kollegorna som hjälpt mig med att skriva och hålla denna artikel aktuell: och Sergey Finogenov.
Källa: habr.com
