

Datastyrda algoritmer, såsom neurala nätverk, har tagit världen med storm. Deras utveckling har drivits av flera faktorer, inklusive billig och kraftfull hårdvara och enorma datamängder. Neurala nätverk är nu i framkant av allt som rör "kognitiva" uppgifter, såsom bildigenkänning, förståelse av naturligt språk, osv. Men de borde inte begränsas till sådana uppgifter. Denna artikel handlar om hur man kan komprimera bilder med hjälp av neurala nätverk, genom residualutbildning. Den föreslagna metoden fungerar snabbare och bättre än standardcodecs. Scheman, ekvationer och självklart en tabell med tester finns under avsnittet.
Denna artikel är baserad på arbetet. Det förutsätts att du är bekant med neurala nätverk och deras begrepp konvolution och förlustfunktion.
Vad är bildkomprimering och hur fungerar det?
Bildkomprimering är en process där en bild omvandlas så att den tar mindre plats. Att bara lagra bilder skulle ta upp mycket utrymme, därför finns det codecs, såsom JPEG och PNG, som syftar till att minska storleken på den ursprungliga bilden.
Som bekant finns det två typer av bildkomprimering: utan förluster och med förlust. Som namnen antyder kan man vid komprimering utan förlust återfå data från den ursprungliga bilden, medan vid komprimering med förlust förloras vissa data under komprimeringen. Till exempel är JPG algoritmer med förlust [anm. övers. – vi ska heller inte glömma JPEG utan förlust], medan PNG är en algoritm utan förlust.
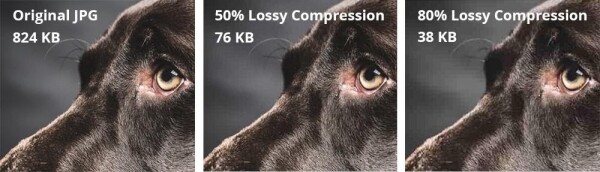
Jämförelse mellan komprimering utan förlust och med förlust
Observera att det finns många blockartefakter i bilden till höger. Detta är förlorad information. Grannpixlar med liknande färger komprimeras som ett område för att spara utrymme, vilket resulterar i förlust av information om de faktiska pixlarna. Självklart är de algoritmer som används i JPEG, PNG och så vidare mycket mer komplexa, men detta är ett bra intuitivt exempel på kompression med förlust. Kompression utan förlust är bra, men filer som är komprimerade utan förlust tar mycket plats på disken. Det finns mer effektiva sätt att komprimera bilder utan att tappa mycket information, men de är ganska långsamma, och många använder iterativa tillvägagångssätt. Detta innebär att de inte kan köras parallellt på flera kärnor i en central- eller grafisk processor. Sådana begränsningar gör dem helt opraktiska för vardagsbruk.
Inmatning av konvolutionellt neuralt nätverk
Om något behöver beräknas och beräkningarna kan vara ungefärliga, lägg till . Författarna använde ett ganska standard konvolutionellt neuralt nätverk för att förbättra bildkompressionen. Den presenterade metoden fungerar inte bara på samma nivå som de bästa lösningarna (om inte bättre), den kan också använda parallella beräkningar, vilket leder till en markant ökning av hastigheten. Anledningen är att konvolutionella neurala nätverk (CNN) är mycket bra på att extrahera rumslig information från bilder, som sedan representeras kompaktare (till exempel sparas endast de "viktiga" bitarna av bilden). Författarna ville utnyttja denna kapabilitet hos CNN för att bättre representera bilder.
Arkitektur
Författarna föreslog ett dubbelt nätverk. Det första nätverket tar en bild som indata och genererar en kompakt representation (ComCNN). Utdata från detta nätverk bearbetas sedan av en standardkodare (till exempel JPEG). Efter att ha bearbetats av kodaren överförs bilden till det andra nätverket, som "återställer" bilden från kodaren i ett försök att återfå den ursprungliga bilden. Författarna kallade detta nätverk för den rekonstruerande CNN (RecCNN). Liknande GAN tränas båda nätverken iterativt.
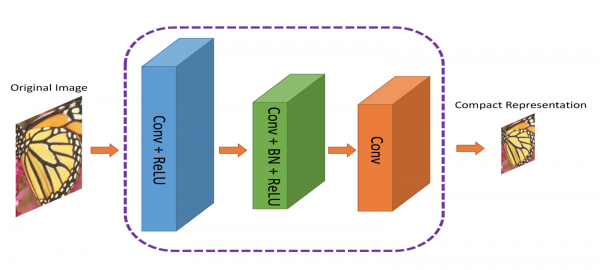
ComCNN Den kompakta representationen överförs till standardkodaren
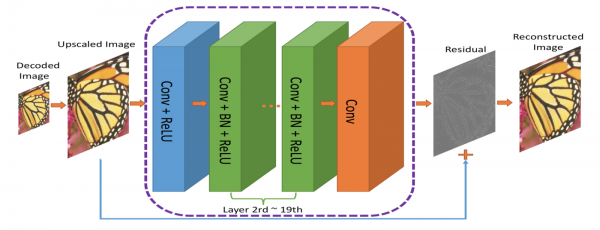
RecCNN. Utdata från ComCNN skalas upp och överförs till RecCNN, som kommer att försöka lära sig resten.
Kodens utdata skal skalera upp och sedan skickas till RecCNN. RecCNN kommer att försöka återge en bild som liknar originalet så mycket som möjligt.
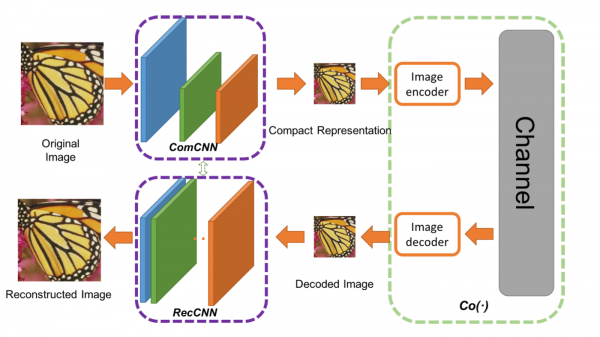
Genomgående bildkomprimeringsram. Co(.) är en algoritm för komprimering av bilder. Författarna har tillämpat JPEG, JPEG2000 och BPG.
Vad är residual?
Residualen kan ses som ett steg i efterbearbetningen för att 'förbättra' den bild som decodas av codec. Med en stor mängd 'information' om världen kan det neuronala nätverket fatta kognitiva beslut om vad som ska åtgärdas. Denna idé bygger på , läs mer om det .
Förlustfunktioner
Två förlustfunktioner används eftersom vi har två neurala nätverk. Det första, ComCNN, är märkt som L1 och definieras så här:
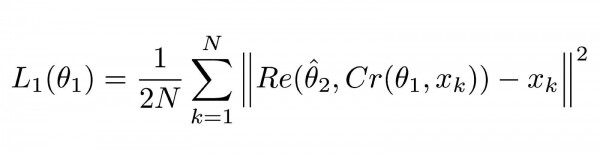
Förlustfunktionen för ComCNN
Förklaring
Denna ekvation kan verka komplicerad, men det är faktiskt en standard (medel kvadratfel). MSE. ||² innebär normen av vektorn de involverar.
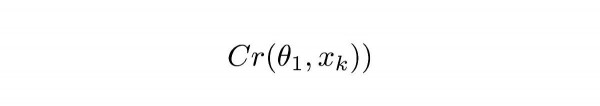
Ekvation 1.1
Cr står för utdata från ComCNN. θ står för lärande parametrar för ComCNN, XK är den inmatade bilden.
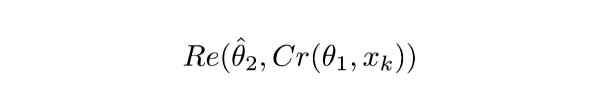
Ekvation 1.2
Re() betyder RecCNN. Denna ekvation överför helt enkelt värdet från ekvation 1.1 till RecCNN. θ står för lärande parametrar för RecCNN (hatt över betyder att parametrarna är fasta).
Intuitiv definition
Ekvation 1.0 får ComCNN att justera sina vikter så att den sista bilden som återskapas med RecCNN ser så lik ingångsbilden som möjligt. Den andra förlustfunktionen för RecCNN definieras så här:
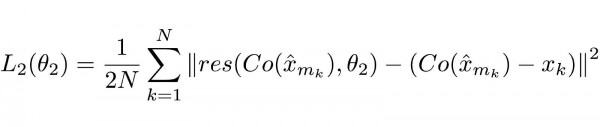
Ekvation 2.0
Förklaring
Återigen kan funktionen verka komplicerad, men det är för det mesta en standardförlustfunktion för neurala nätverk (MSE).
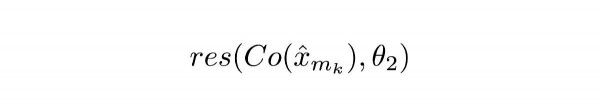
Ekvation 2.1
Co() betyder codecens utdata, x med en hatt över betyder utdata från ComCNN. θ2 är de lärande parametrarna för RecCNN. res() representerar helt enkelt residualutdata från RecCNN. Det är värt att notera att RecCNN tränas på skillnaden mellan Co() och den inmatade bilden, men inte på den inmatade bilden.
Intuitiv definition
Ekvation 2.0 får RecCNN att justera sina vikter så att utdata ser så lik ingångsbilden som möjligt.
Lärande schema
Modeller tränas iterativt, liknande Vikterna för den första modellen fastställs medan vikterna för den andra modellen uppdateras, sedan fastställs vikterna för den andra modellen medan den första modellen tränas.
Tester
Författarna jämförde sin metod med befintliga metoder, inklusive enkla codec. Deras metod fungerar bättre än andra, samtidigt som den upprätthåller hög hastighet på lämplig hårdvara. Dessutom försökte författarna använda endast ett av de två nätverken och noterade en prestandaförlust.
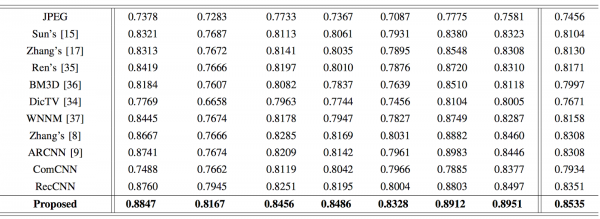
Jämförelse av strukturell likhetsindex (SSIM). Höga värden indikerar bättre likhet med originalet. Resultatet från författarna är markerat med fetstil.
Slutsats
Vi undersökte ett nytt sätt att använda djupinlärning för bildkomprimering och diskuterade möjligheten att använda neurala nätverk för uppgifter utöver de "allmänna", såsom bildklassificering och språkbearbetning. Denna metod underpriserar inte moderna krav och möjliggör betydligt snabbare bildbearbetning.
Det har blivit enklare att studera neurala nätverk, för vi har skapat en kampanjkod speciellt för Habr-anhängare. HABR, som ger ytterligare 10% rabatt på den rabatt som anges på bannern.
Fler kurser
Rekommenderade artiklar
Källa: habr.com
