

Från Google Blogs redaktör: Har du någonsin undrat över hur ingenjörerna på Google Cloud Technical Solutions (TSE) hanterar dina supportärenden? Ingenjörerna inom TSE:s tekniska support har som ansvar att identifiera och lösa de problem som användarna rapporterar. Vissa av dessa problem är ganska enkla, men ibland dyker det upp ärenden som kräver uppmärksamhet från flera ingenjörer. I denna artikel kommer en TSE-anställd att berätta om ett mycket knepigt problem från sin senaste praktik - . Under denna berättelse kommer vi att se hur ingenjörerna lyckades lösa situationen och vad de lärde sig under felsökningen. Vi hoppas att denna historia inte bara ger dig insikter om ett djupt rotat fel, utan också ger förståelse för processerna som pågår när man lämnar in ett ärende till Google Clouds support.
Felsökning är både en vetenskap och en konst. Allt börjar med att ställa hypoteser om orsaken till systemets avvikande beteende, som sedan prövas noggrant. Men innan vi formulerar en hypotes, måste vi tydligt definiera och formulera problemet. Om frågan är för otydlig, måste du analysera allt noggrant; det är här "konsten" i felsökning kommer in.
Inom Google Cloud kompliceras sådana processer avsevärt, eftersom Google Cloud gör sitt yttersta för att garantera sina användares integritet. Därför har ingenjörerna på TSE varken tillgång till att redigera dina system eller möjlighet att granska konfigurationer så brett som användarna. Därför kan vi (ingenjörerna) inte snabbt modifiera systemet för att testa någon av våra hypoteser.
Vissa användare tror att vi kommer att åtgärda allt som mekaniker på en bilverkstad, och skickar helt enkelt id:n för den virtuella maskinen, medan processen i verkligheten går till så här: insamling av information, formulering och bekräftelse (eller avfärdande) av hypoteser, och slutligen byggs lösningen på kommunikationen med kunden.
Det aktuella problemet
Idag har vi en historia med ett lyckligt slut framför oss. En av orsakerna till den framgångsrika lösningen av det föreslagna fallet är en mycket detaljerad och exakt beskrivning av problemet. Nedan kan du se en kopia av det första biljetten (redigerad för att dölja konfidentiell information):
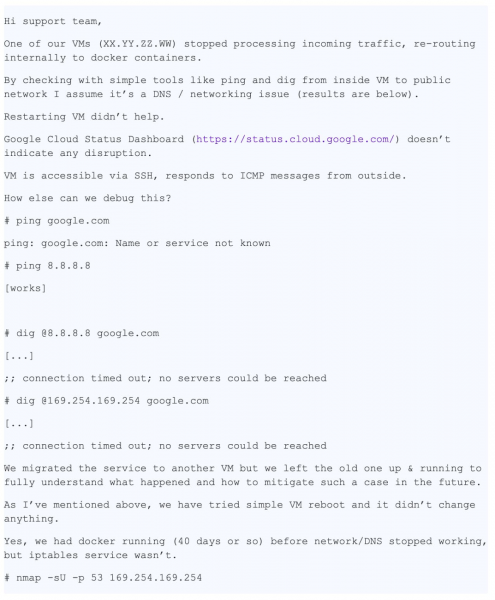
I detta meddelande finns det mycket nyttig information för oss:
- En specifik VM anges
- Problemet anges - DNS fungerar inte
- Det anges var problemet visar sig - VM och container
- Stegen som användaren tog för att identifiera problemet anges
Ärendet registrerades som "P1: Kritisk påverkan - Tjänsten är obrukbar i produktion", vilket innebär konstant övervakning av situationen 24/7 enligt" Follow the Sun "-schemat (du kan läsa mer om ), med överföring från ett supportteam till ett annat vid varje tidszonsförändring. I praktiken, när problemet nådde vårt team i Zürich, hade det redan cirkulerat jorden runt. Vid den tiden hade användaren vidtagit åtgärder för att minska konsekvenserna, men var oroad över att situationen skulle upprepas i produktion, eftersom den huvudsakliga orsaken fortfarande inte hade upptäckts.
Vid tidpunkten då biljetten nådde Zürich hade vi redan följande information:
- Innehåll
/etc/hosts - Innehåll
/etc/resolv.conf - Utdata
iptables-save - Samlat av teamet
ngreppcap-fil
Med dessa data var vi redo att påbörja nästa steg "utredning" och felsökning.
Våra första steg
Först kontrollerade vi loggarna och status för metadata-servern och försäkrade oss om att den fungerade korrekt. Metadata-servern svarar på IP-adressen 169.254.169.254 och ansvarar dessutom för kontroll av domännamn. Vi dubbelkontrollerade också att brandväggen fungerar korrekt med VM och inte blockerar paket.
Det var ett märkligt problem: kontrollen med nmap motbevisade vår huvudhypotes om förlust av UDP-paket, så vi kom på några fler alternativ och sätt att kontrollera dem:
- Försvinner paketen selektivt? => Kontrollera iptables-regler
- Är inte MTU för liten? ? => Проверить вывод
Berör problemet endast UDP-paket eller även TCP? => Kör - dig +tcp
Kommer de genererade dig-paketen tillbaka? => Kör - tcpdump
Fungerar libdns korrekt? => Kör - strace
för att kontrollera paketöverföringen åt båda hållHär beslutade vi att ringa användaren för att felsöka live.
Här bestämmer vi oss för att ringa användaren för att lösa problem i realtid.
Under samtalet lyckas vi kontrollera flera saker:
- Efter flera kontroller utesluter vi iptables-regler från listan över orsaker
- Vi kontrollerar nätverksgränssnitten och routingtabelled och verifierar MTU-korrektheten
- Vi upptäcker att
dig +tcp google.com(TCP) fungerar som det ska, mendig google.com(UDP) fungerar inte - Genom att köra
Fungerar libdns korrekt? => Körfungerar det hittillsdig, upptäcker vi att UDP-paketen returneras - Vi kör
strace dig google.comoch ser hur dig korrekt anroparsendmsg()ochrecvms(), men det andra avbryts på grund av tidsgräns
Tyvärr, skiftet avslutas och vi måste överlämna problemet till nästa tidszon. Ändå väckte ärendet intresse i vårt team, och en kollega föreslår att skapa en DNS-paket med Python-modulen scrapy.
from scapy.all import *

answer = sr1(IP(dst="169.254.169.254")/UDP(dport=53)/DNS(rd=1,qd=DNSQR(qname="google.com")),verbose=0)
print ("169.254.169.254", answer[DNS].summary())
Detta fragment skapar ett DNS-paket och skickar en förfrågan till metadata-servern.
Användaren kör koden, DNS-svaret returneras, och applikationen får det, vilket bekräftar att det inte finns något problem på nätverksnivå.
Efter ännu en "världsomsegling" kommer ärendet tillbaka till vårt team, och jag tar helt över det, eftersom jag anser att det blir smidigare för användaren om ärendet inte fortsätter hoppa hit och dit.
Under tiden samtycker användaren vänligt till att tillhandahålla en bild av systemavbilden. Det är mycket goda nyheter: möjligheten att testa systemet själv påskyndar felsökningen avsevärt, eftersom jag inte längre behöver be användaren att köra kommandon, skicka mig resultaten och analysera dem, jag kan göra allt själv!
Mina kollegor börjar bli lite avundsjuka. Under lunchen diskuterar vi ärendet, men ingen har några idéer om vad som pågår. Lyckligtvis har själva användaren redan vidtagit åtgärder för att mildra konsekvenserna och har ingen brådska, så vi har tid att dissekera problemet. Och eftersom vi har en avbildning kan vi göra vilka tester vi vill. Utmärkt!
Backar ett steg tillbaka
En av de mest populära frågorna vid intervjuer för systemingenjörspositioner låter så här: "Vad händer när du pingar ?» Вопрос шикарный, так как кандидату необходимо описать пусть от оболочки до пользовательского пространства, до ядра системы и далее к сети. Я улыбаюсь: иногда вопросы с интервью оказываются полезны и в реальной жизни…
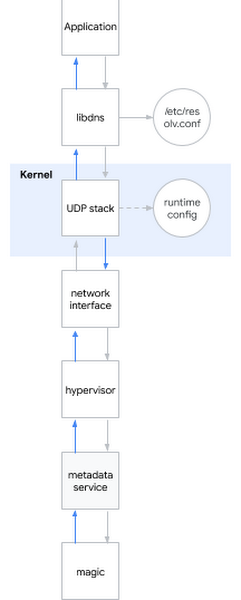
Jag beslutade att använda denna HR-fråga för att lösa det aktuella problemet. Grovt sagt, när du försöker bestämma DNS-namnet, sker följande:
- Applikationen anropar systembiblioteket, till exempel libdns
- libdns kontrollerar systemets konfiguration för vilken DNS-server den ska kontakta (i diagrammet är det 169.254.169.254, metadata-servern)
- libdns använder systemanrop för att skapa en UDP-socket (SOCK_DGRAM) och överföra UDP-paket med DNS-förfrågningar åt båda håll
- Genom sysctl-gränssnittet kan UDP-stacken konfigureras på kärnnivå
- Kärnan interagerar med hårdvaran för att överföra paket över nätverket via nätverksgränssnittet
- Hypervisorn fångar och överför paketet till metadata-servern vid kontakt med den
- Metadata-servern bestämmer DNS-namnet med sin magi och returnerar svaret på samma sätt
Jag påminner om vilka hypoteser vi redan har diskuterat:
Hypotes: Biblioteken är trasiga
- Test 1: kör strace i systemet för att kontrollera att dig anropar korrekta systemanrop
- Resultat: korrekta systemanrop anropas
- Test 2: genom srapy kontrollera om vi kan identifiera namn utan att gå via systembiblioteken
- Resultat: vi kan
- Test 3: kör rpm –V på paketet libdns och md5sum för biblioteksfilerna
- Resultat: bibliotekskoden är helt identisk med koden i det fungerande operativsystemet
- Test 4: montera bilden av användarens rotfilsystem på VM utan detta beteende, kör chroot och kontrollera om DNS fungerar
- Resultat: DNS fungerar korrekt
Slutsats baserat på testerna: problemet ligger inte i biblioteken
Hypotes: Det finns ett fel i DNS-inställningarna
- Test 1: kontrollera tcpdump och observera om DNS-paketen sänds och tas emot korrekt efter att dig startats
- Resultat: paketen överförs korrekt
- Test 2: dubbelkolla på servern
/etc/nsswitch.confoch/etc/resolv.conf - Resultat: allt är korrekt
Slutsats baserat på testerna: problemet ligger inte i DNS-konfigurationen
Hypotes: kärnan är skadad
- Test: installera en ny kärna, kontrollera signaturen, starta om
- Resultat: samma beteende
Slutsats baserat på testerna: kärnan är inte skadad
Hypotes: felaktigt beteende i användarnätverket (eller hypervisorns nätverksgränssnitt)
- Test 1: kontrollera brandväggens inställningar
- Resultat: brandväggen släpper igenom DNS-paket både på värden och på GCP
- Test 2: fånga trafiken och spåra korrektheten i överföring och mottagning av DNS-förfrågningar
- Resultat: tcpdump bekräftar mottagandet av svarspaket av värden
Slutsats baserat på testerna: problemet ligger inte i nätverket
Hypotes: metadata-servern fungerar inte
- Test 1: kontrollera metadata-serverns loggar för anomalier
- Resultat: inga anomalier i loggarna
- Test 2: omgå metadata-servern via
dig @8.8.8.8 - Resultat: upplösningen misslyckas även utan att använda metadata-servern
Slutsats baserat på testerna: problemet ligger inte hos metadata-servern
Slutsats: vi testade alla delsystem utom inställningarna för körmiljön!
När jag dyker ner i inställningarna för körmiljön
För att konfigurera inställningarna för kärnan kan du använda kommandoradsalternativ (grub) eller sysctl-gränssnittet. Jag tittade i /etc/sysctl.conf och tro det eller ej, jag hittade flera anpassade inställningar. Med känslan av att jag hade snubblat över något, avfärdade jag alla icke-nätverksrelaterade eller icke-tcp-inställningar, kvar med en handfull inställningar net.core. Sedan gick jag dit där VM har värdarnas behörigheter och började tillämpa inställningarna från den trasiga VM-en, en efter en, tills jag kom till brottslingen:
net.core.rmem_default = 2147483647Där är den, DNS-konfigurationen som bryter mot reglerna! Jag hittade brottsverktyget. Men varför händer det här? Jag behövde fortfarande ett motiv.
Inställningen för grundstorleken på DNS-paketens buffert hanteras via net.core.rmem_default. Det typiska värdet varierar kring 200KiB, men om din server tar emot många DNS-paket kan du öka buffertens storlek. Om bufferten är full vid tidpunkten för mottagandet av ett nytt paket, till exempel för att applikationen inte bearbetar det tillräckligt snabbt, kommer du att börja förlora paket. Vår kund ökade korrekt buffertens storlek eftersom de var oroliga för dataförlust, då de använde en applikation för insamling av mätdata via DNS-paket. Det värde de ställde in var det maximalt möjliga: 231-1 (om du sätter 231 kommer kärnan att returnera "OGILTIGT ARGUMENT").
Plötsligt insåg jag varför nmap och scapy fungerade korrekt: de använde råa sockets! Råa sockets skiljer sig från vanliga: de omgår iptables och de buffras inte!
Men varför orsakar "för stor buffert" problem? Den fungerar tydligen inte som avsett.
Vid det här laget kunde jag reproducera problemet på flera kärnor och många distributioner. Problemet hade redan visat sig på kärna 3.x och visade sig nu också på kärna 5.x.
Verkligen, när jag körde
sysctl -w net.core.rmem_default=$((2**31-1))slutade DNS att fungera.
Jag började leta efter fungerande värden med en enkel binär sökalgoritm och upptäckte att systemet fungerade med 2147481343, men det var meningslöst för mig. Jag föreslog för klienten att prova det numret, och han svarade att systemet fungerade med google.com, men gav fortfarande fel med andra domäner, så jag fortsatte min undersökning.
Jag installerade , ett verktyg jag borde ha använt tidigare: det visar exakt vart i kärnan paketet hamnar. Den skyldiga var funktionen udp_queue_rcv_skb. Jag laddade ner källkoden för kärnan och la till några för att spåra vart paketet landar. Jag upptäckte snabbt det nödvändiga villkoret if, och stirrade bara på det ett tag, eftersom det var då allt äntligen föll på plats: 231-1, ett meningslöst nummer, en icke fungerande domän… Det handlade om en kodsnutt i __udp_enqueue_schedule_skb:
if (rmem > (size + sk->sk_rcvbuf))
		goto uncharge_drop;
Observera:
rmemär av typen intsizeär av typen u16 (unsigned 16-bit int) och lagrar paketets storleksk->sk_rcybufär av typen int och lagrar storleken på bufferten som per definition är lika med värdet inet.core.rmem_default
När sk_rcvbuf når 231, kan summan av paketstorleken leda till . Och eftersom det är int blir värdet negativt, vilket gör att villkoret blir sant när det borde vara falskt (mer om detta kan läsas i ).
Felet åtgärdas på ett trivialt sätt: genom att konvertera till unsigned int. Jag tillämpade fixen och startade om systemet, varefter DNS återigen fungerade.
Segern smakade
Jag skickade mina fynd till klienten och skickade kernelpatchen. Jag är nöjd: varje bit av pusslet föll på plats, jag kan exakt förklara varför vi observerade det vi gjorde, och viktigast av allt, vi lyckades hitta en lösning på problemet tack vare gemensamt arbete!
Det är värt att erkänna att fallet var sällsynt, och lyckligtvis får vi sällan så komplexa förfrågningar från användare.
Källa: habr.com
