

Med ökad erfarenhet inom IT börjar man märka att system har sin egen karaktär. De kan vara samarbetsvilliga, tystlåtna, impulsiva eller stränga. De kan attrahera eller avskräcka. Oavsett vilket måste man "förhandla" med dem, manövrera mellan "skärvorna" och bygga upp kedjor av deras interaktion.
Så vi fick chansen att bygga en molnplattform, och för detta behövdes det "övertala" ett par delsystem att samarbeta med oss. Som tur är har vi "API-språket", händiga händer och massor av entusiasm.
I denna artikel blir det ingen teknisk hardcore, men en beskrivning av de problem vi stött på vid byggandet av molnet. Jag beslutade mig för att beskriva vår väg som en lätt teknisk fantasi om hur vi sökte en gemensam grund med systemen och vad som kom ut av det.
Välkommen under kat.
Framstegens början
För ett tag sedan ställdes vår grupp inför uppgiften att lansera en molnplattform för våra kunder. Vi hade stöd från ledningen, resurser, hårdvarustack och frihet att välja teknologier för implementeringen av programvarudelen av tjänsten.
Det fanns också ett antal krav:
- tjänsten behöver en användarvänlig personlig portal;
- plattformen måste integreras med det befintliga faktureringssystemet;
- program- och hårdvarudelen: OpenStack + Tungsten Fabric (Open Contrail), som våra ingenjörer har lärt sig att "laga" ganska bra.
Om hur teamet samlades, hur gränssnittet för den personliga portalen utvecklades och hur designbeslut fattades, kommer vi att berätta en annan gång, om Habr-gemenskapen visar intresse.
Verktygen vi valde att använda:
- Python + Flask + Swagger + SQLAlchemy — en helt standard Python-sats;
- Vue.js för frontend;
- interaktionen mellan komponenterna och tjänsterna beslutade vi att göra med hjälp av Celery ovanpå AMQP.
Innan jag besvarar frågor om valet av Python, vill jag förklara. Språket har tagit sin plats inom vårt företag och kring det har en liten, men ändå en kultur formats. Därför beslutades det att börja bygga tjänsten just på det. Dessutom är hastigheten för utvecklingen oftast avgörande i sådana uppgifter.
Så, låt oss börja vår bekantskap.
Tysta Bill — fakturering
Vi har känt den här killen länge. Han satt alltid bredvid och räknade tyst något. Ibland vidarebefordrade han användarförfrågningar till oss, ställde upp kundfakturor och hanterade tjänster. En vanlig arbetsam kille. Dock fanns det svårigheter. Han är tystlåten, ibland eftertänksam och ofta — för sig själv.
Faktureringssystemet var den första system vi försökte vänja oss vid. Och den första svårigheten vi stötte på var vid hantering av tjänster.
Till exempel, vid skapande eller radering hamnar uppgiften i faktureringssystemets interna kö. Så här realiserades systemet för asynkron hantering av tjänster. För att hantera våra typer av tjänster behövde vi "lägga" våra uppgifter i denna kö. Här stötte vi på problemet: brist på dokumentation.
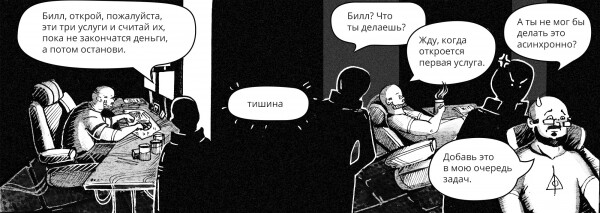
Enligt beskrivningen av det programmässiga API:t går det att lösa denna uppgift, men vi hade ingen tid för reverse engineering, så vi tog ut logiken och organiserade en uppgiftskö ovanpå RabbitMQ. En operation över en tjänst initieras av kunden från sin användarpanel, omsluts i en "uppgift" av Celery på backend-sidan och utförs på fakturerings- och OpenStack-sidan. Celery gör det ganska enkelt att hantera uppgifter, organisera omprioriteringar och övervaka statusen. För mer om "selleri" kan man läsa till exempel, .
Faktureringen stoppade inte projektet när pengarna tog slut. I samtal med utvecklarna insåg vi att vid beräkning efter statistiken (och vi behöver faktiskt implementera just denna logik) finns det en komplicerad ömsesidig relation av stoppregler. Men dessa modeller passar dåligt för vår verklighet. Vi implementerade även detta genom uppgifter på Celery, där vi tog logiken för att hantera tjänster till backend-sidan.
Båda ovanstående problemen ledde till att koden blev något överdimensionerad och vi kommer i framtiden behöva refaktorisera för att separera logiken för uppgiftshantering till en separat tjänst. Vi behöver också lagra viss information om användarna och deras tjänster i våra tabeller för att stödja denna logik.
Ett annat problem är tystnaden.
För vissa förfrågningar till API:et svarar Billy tyst "Okej". Så var till exempel fallet när vi gjorde insättningar av lovade betalningar under testperioden (om detta senare). Förfrågningarna utfördes korrekt och vi såg inga fel.
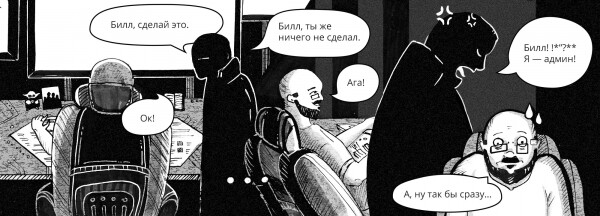
Jag var tvungen att studera loggarna när jag arbetade med systemet genom UI. Det visade sig att själva faktureringen gör sådana förfrågningar genom att ändra scope till en specifik användare, till exempel admin, och överföra den som parameter su.
Sammanfattningsvis, trots luckor i dokumentationen och några mindre fel i API:et, så gick allt relativt bra. Loggarna går att läsa även vid hög belastning, om man förstår hur de är uppbyggda och vad man ska leta efter. Databasens struktur är invecklad, men helt rimlig och till och med attraktiv på vissa sätt.
Så, för att sammanfatta, de huvudsakliga problem vi stötte på under samarbetet var relaterade till de specifika implementeringarna av systemet:
- underdokumenterade "funktioner" som på ett eller annat sätt påverkade oss;
- stängda källor (faktureringen är skriven i C++), vilket innebär att vi inte kunde lösa problem 1 på något annat sätt än "metoden av försök och misstag".
Lyckligtvis har produkten ett tillräckligt omfattande API och vi integrerade följande delsystem i vår användarpanel:
- teknisk supportmodul — förfrågningar från användarpanelen "proxeras" i faktureringen transparant för tjänstekunder;
- finansmodul — gör det möjligt att utfärda fakturor till nuvarande kunder, genomföra debiteringar och generera betalningsdokument;
- tjänstehanteringsmodul — för den var vi tvungna att implementera vår egen hanterare. Systemets utbyggbarhet spelade oss i händerna och vi "tränade" Billing på en ny typ av tjänster.
Det var lite arbete, men oavsett, jag tror att vi kommer att få till det med Billing.
Promenader genom tungstenfält — Tungsten Fabric
Tungstenfält, täckta av hundratals kablar som leder tusentals bitar information genom sig. Informationen samlas i "paket", bryts ner, och bygger komplexa rutter, som genom magi.
Detta är domänen för det andra systemet som vi var tvungna att få att fungera — Tungsten Fabric (TF), tidigare OpenContrail. Dess uppgift är att hantera nätverksutrustningen och tillhandahålla programvaruabstraktion för oss som användare. TF — SDN, inkapslar komplex logik för arbete med nätverksutrustning. Det finns en ganska bra artikel om teknologin, till exempel, .
Systemet är integrerat med OpenStack (om det kommer vi att prata om nedan) via Neutron-plugin.
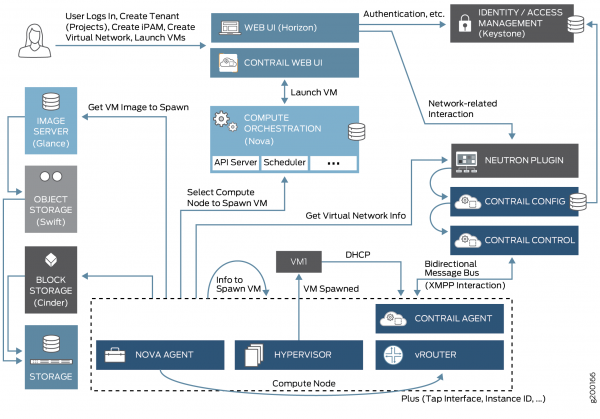
Interaktion mellan OpenStack-tjänster.
Vi blev bekanta med detta system genom grabbarna i driften. Vi använder systemets API för att hantera nätverksstacken av våra tjänster. Det har hittills inte orsakat några allvarliga problem eller besvär (jag vågar inte uttala mig för grabbarna i drift), men det har också funnits några komiska interaktioner.
Det första såg ut så här: kommandon som krävde att en stor mängd data skulle skrivas ut på instansens konsol vid anslutning via SSH helt enkelt "hängde" anslutningen, medan allt fungerade korrekt via VNC.
För dem som inte är bekanta med problemet ser det ganska lustigt ut: ls /root fungerar korrekt, medan till exempel top "hängde" helt. Lyckligtvis har vi redan stött på liknande problem. Det löstes genom att justera MTU på vägen från compute-noderna till routrarna. För att nämna det, är detta faktiskt inget problem för TF.
Nästa problem väntade runt hörnet. I ett "underbart" ögonblick försvann routningens magi, bara så där. TF slutade hantera routningen på utrustningen.
Vi arbetade med OpenStack på admin-nivå och gick sedan över till den nödvändiga användarnivån. SDN verkar "övertar" den användarscope som används för att utföra åtgärder. Problemet är att detta admin-konto också används för att kommunicera mellan TF och OpenStack. Vid steget att växla till en användare försvann "magin". Det löstes genom att skapa ett separat konto för att arbeta med systemet. Detta gjorde att vi kunde arbeta utan att bryta integrationsfunktionaliteten.
Silicon Life Forms — OpenStack
Det silikonliknande väsendet av märklig form bor nära wolframfälten. Det liknar mest ett övervuxet barn som med ett svep kan krossa oss, men det utstrålar ingen uppenbar aggression. Det väcker inte rädsla, men dess storlek inger försiktighet. Precis som komplexiteten av vad som händer runt omkring.
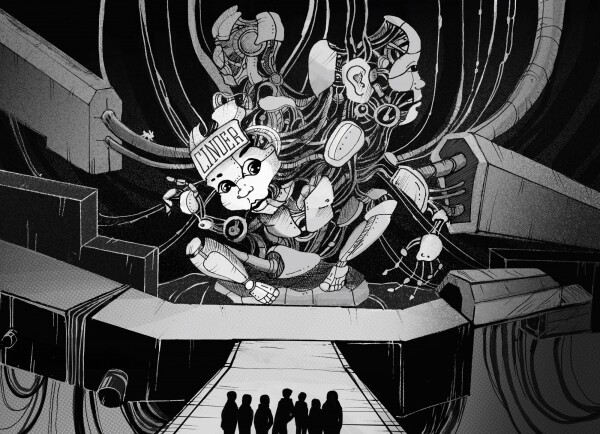
OpenStack är kärnan i vår plattform.
OpenStack har flera delsystem, av vilka vi hittills mest aktivt använder Nova, Glance och Cinder. Var och en av dem har sitt eget API. Nova ansvarar för compute-resurser och skapande av instanser, Cinder - hantering av volymer och deras snapshots, Glance - bildtjänst som hanterar OS-mallar och metadata om dem.
Varje tjänst körs i en container, och budbäraren är "vita kaninen" — RabbitMQ.
Detta system har orsakat oss flest oväntade problem.
Och det första problemet lät inte vänta på sig när vi försökte ansluta en extra volym till servern. Cinder API vägrade kategoriskt att utföra denna uppgift. Mer specifikt, om man ska tro själva OpenStack, så etableras anslutningen, men inom den virtuella servern saknas disk enheten.
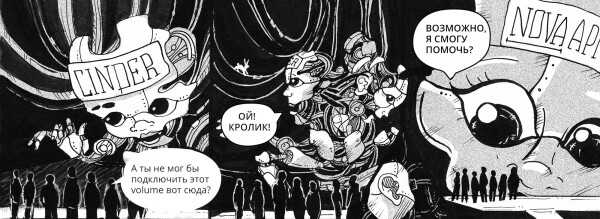
Vi beslutade oss för att "gå runt" och begärde samma åtgärd via Nova API. Resultatet — enheten kopplades korrekt och var tillgänglig inuti servern. Det verkar som att problemet uppstår när block-lagringen inte svarar Cinder.
En ytterligare svårighet väntade oss när vi arbetade med diskar. Den systemvolym som behövdes kunde inte kopplas bort från servern.
Återigen, själva OpenStack "lovar" att den har avbrutit anslutningen och att man nu kan arbeta korrekt med volymen separat. Men API:n vill kategoriskt inte utföra operationer på disken.
Här beslutade vi att inte kriga för mycket, utan att ändra vår syn på hur tjänsten fungerar. Eftersom det finns en instans, borde det också finnas en systemvolym. Därför kan användaren för närvarande inte ta bort eller koppla bort den systemiska "disken" utan att först ta bort "servern".
OpenStack är ett ganska komplext system med sin egen logik och invecklad API. Vi åtnjuter ganska detaljerad dokumentation och naturligtvis metoden av prövningar och misstag (vad vore vi utan det).
Testkörning
Vi genomförde testkörningen i december förra året. Huvudsyftet var att kontrollera vårt projekts tekniska sida och UX i skarpt läge. Publiken invitas selektivt och testningen var stängd. Vi lät dock även möjlighet att begära tillgång till testningen via vår webbplats.
Själva tesen, naturligtvis, gick inte utan komiska moment, eftersom våra äventyr bara börjar här.
För det första uppskattade vi intresset för projektet något felaktigt och vi var tvungna att snabbt lägga till compute-noder under testet. Ett vanligt fall för en kluster, men det fanns även här nyanser. I dokumentationen för en specifik TF-version anges en specifik version av kärnan, som testades för att arbeta med vRouter. Vi valde att starta noder med nyare kärnor. Resultatet — TF fick inte rutter från noder. Vi var tvungna att akut rulla tillbaka kärnorna.
En annan komisk incident är kopplad till funktionaliteten hos knappen "ändra lösenord" i användarkontot.
Vi har beslutat att använda JWT för att organisera åtkomst till användarportalen, så att vi inte behöver arbeta med sessioner. Eftersom systemen är mångsidiga och spridda, hanterar vi vår egen token, där vi "knyter" sessioner från faktureringen och token från OpenStack. Vid byte av lösenord, så "upphör" token, eftersom användardata inte längre är giltiga och den måste förnyas.
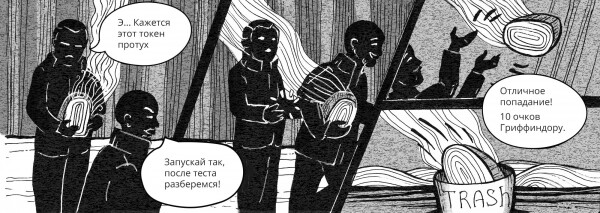
Vi missade detta ögonblick, och vi hade helt enkelt inte resurserna för att snabbt skriva klart denna del. Vi var tvungna att ta bort funktionalitet precis före testlanseringen.
För närvarande loggar vi ut användaren om lösenordet har ändrats.
Trots dessa nyanser har testningen gått bra. Under ett par veckor hade vi omkring 300 besökare. Vi lyckades se på produkten genom användarnas ögon, testa den i realtid och samla in kvalitativ feedback.
Fortsättning följer
För många av oss är detta det första projektet av denna storlek. Vi har lärt oss en hel del värdefulla läxor om hur man arbetar i team, fattar arkitektoniska och designbeslut. Hur man med små resurser integrerar komplexa system och rullar ut dem i produktion.
Självklart finns det mycket att arbeta med både när det gäller koden och i integrationspunkterna mellan systemen. Projektet är fortfarande ganska ungt, men vi är fulla av ambitioner att utveckla det till en pålitlig och användarvänlig tjänst.
Vi har redan kunnat övertyga systemen. Bill arbetar lydigt med beräkningar, fakturering och användarförfrågningar från sin vrå. "Magin" från volframfälten ger oss stabil kommunikation. Och endast OpenStack beter sig ibland lite krävande, och ropar något i stil med "’WSREP har ännu inte förberett noden för användning i applikationen", men det är en helt annan historia...
Nyss lanserade vi tjänsten.
Alla detaljer kan du få på vår .
CLO utvecklingsteam
Nyttiga länkar
OpenStack
Tungsten Fabric
Källa: habr.com
