

Hej alla. I den här artikeln kommer jag att berätta varför vi på Avito valde Kafka för nio månader sedan och vad det egentligen innebär. Jag kommer också att dela med mig av ett av våra användningsfall — meddelandebrokers. Till sist kommer vi att diskutera vilka fördelar vi fått av att använda Kafka as a Service.
Problemet
Först lite kontext. För en tid sedan började vi överge den monolitiska arkitekturen, och nu finns det flera hundra olika tjänster på Avito. Dessa har sina egna lagringslösningar, sin egen teknologiska stack och ansvarar för sin del av affärslogiken.
Ett av problemen med ett stort antal tjänster är kommunikationen. Tjänst A vill ofta få information från tjänst B. I det här fallet kontaktar tjänst A tjänst B via ett synkront API. Tjänst C vill veta vad som händer hos tjänsterna G och D, och dessa å sin sida är intresserade av tjänsterna A och B. När det finns många sådana "nyfikna" tjänster blir kopplingarna mellan dem en snårig knut.
Samtidigt kan tjänst A när som helst bli otillgänglig. Vad ska tjänst B och alla andra tjänster som är beroende av den göra i det här fallet? Och om det för en affärshandling krävs en kedja av sekventiella synkront samtal, ökar risken för att hela operationen misslyckas ytterligare (och ju längre kedjan är, desto högre är risken).
Val av teknik
Okej, problemen är förståeliga. De kan åtgärdas genom att skapa ett centralt meddelandesystem mellan tjänsterna. Nu behöver varje tjänst bara känna till detta meddelandesystem. Dessutom bör själva systemet vara felresilient och horisontellt skalbart, och i händelse av incidenter bör det spara meddelanden för senare behandling.
Låt oss nu välja en teknik för att genomföra meddelandetransporten. För detta bör vi först förstå vad vi förväntar oss av den:
- meddelanden mellan tjänster får inte gå förlorade;
- meddelanden kan dupliceras;
- meddelanden kan lagras och läsas i flera dagar (persistenta buffertar);
- tjänster kan prenumerera på data som de är intresserade av;
- flera tjänster kan läsa samma data;
- meddelanden kan innehålla detaljerad, stor payload (event-carried state transfer);
- ibland behövs garantier för meddelandens ordning.
Det var också avgörande för oss att välja ett så skalbart och pålitligt system som möjligt med hög kapacitet (minst 100 000 meddelanden på flera kilobyte per sekund).
Vid det här skedet sa vi farväl till RabbitMQ (svårt att hålla stabil på hög rps), PGQ från SkyTools (inte tillräckligt snabb och dåligt skalbar) och NSQ (inte persistenta). Alla dessa teknologier används i vårt företag, men de passade inte för det problem som skulle lösas.
Därefter började vi titta på nya teknologier för oss - Apache Kafka, Apache Pulsar och NATS Streaming.
Först avfärdade vi Pulsar. Vi ansåg att Kafka och Pulsar är ganska likartade lösningar. Och trots att Pulsar är bekräftad av stora företag, är nyare och erbjuder lägre latens (i teorin), bestämde vi oss för att behålla Kafka av dessa två som de facto-standard för sådana uppgifter. Vi kommer troligen att återvända till Apache Pulsar i framtiden.
Och nu återstår två kandidater: NATS Streaming och Apache Kafka. Vi studerade båda lösningarna noggrant och båda passade för uppgiften. Men till slut var vi oroade över den relativa ungdomligheten hos NATS Streaming (och att en av huvudutvecklarna, Tyler Treat, beslutade att lämna projektet och starta sitt eget - Liftbridge). Samtidigt gav clustering-läget i NATS Streaming ingen möjlighet till stark horisontell skalning (det är troligtvis inte längre ett problem efter att partitionering-läget lades till 2017).
Ändå är NATS Streaming en fantastisk teknologi, skriven i Go och stödd av Cloud Native Computing Foundation. Till skillnad från Apache Kafka, kräver den inte Zookeeper för att fungera (möjligen, ), eftersom den implementerar RAFT internt. NATS Streaming är enklare att administrera. Vi utesluter inte att vi i framtiden kan återvända till denna teknologi.
Och ändå blev vår vinnare idag Apache Kafka. I våra tester visade den sig vara tillräckligt snabb (över en miljon meddelanden per sekund både för läsning och skrivning med meddelandevolym på 1 kilobyte), tillräckligt pålitlig, väl skalbar och beprövad i produktion av stora företag. Dessutom stöder Kafka minst flera stora kommersiella företag (vi använder till exempel Confluent-versionen), och Kafka har ett utvecklat ekosystem.
Översikt över Kafka
Innan vi börjar, rekommenderar jag genast en utmärkt bok - «Kafka: The Definitive Guide» (finns även på ryska, men termerna kan vara förvirrande). I den kan man hitta information som är nödvändig för en grundläggande förståelse av Kafka och även lite mer. Själv dokumentationen från Apache och bloggen från Confluent är också välskrivna och lätta att läsa.
Så låt oss ta en titt på hur Kafka fungerar från fågelperspektiv. Den grundläggande topologin av Kafka består av producent, konsument, broker och zookeeper.
Broker
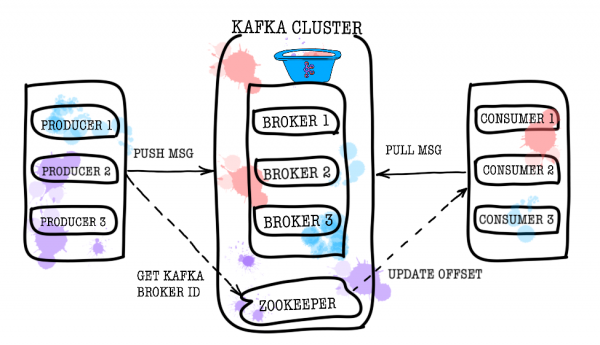
Broker (broker) ansvarar för lagring av dina data. All data lagras i binär form, och brokern vet lite om vad de representerar och vad deras struktur är.
Varje logisk typ av händelser finns vanligtvis i sin egen separata topic (topic). Till exempel kan en händelse om skapandet av en annons hamna i topicen item.created, medan en händelse om ändringen av den hamnar i item.changed. Topics kan ses som klassificerare av händelser. På topicsnivå kan konfigurationsparametrar ställas in, såsom:
- volymen av lagrade data och/eller deras ålder (retention.bytes, retention.ms);
- faktor för dataduplicering (replication factor);
- maximalt meddelande storlek (max.message.bytes);
- minsta antal synkrona repliker där data kan skrivas till topicen (min.insync.replicas);
- möjlighet att genomföra failover till en osynkron försenad replik med potentiell dataförlust (unclean.leader.election.enable);
- och många fler ().
I sin tur delas varje topic upp i en eller flera partitioner (partition). Det är i partitionerna som händelserna slutligen går. Om det finns mer än en broker i klustret kommer partitionerna att fördelas jämnt mellan alla brokers (så långt det är möjligt), vilket möjliggör att skala belastningen för skrivning och läsning i en topic över flera brokers.
På disken lagras data för varje partition i form av segmentfiler, som som standard är ett gigabyte långa (detta kontrolleras via log.segment.bytes). En viktig egenskap är att borttagning av data från partitioner (när retention utlöses) sker just i segment (det går inte att ta bort enskilda händelser från en partition, man kan bara ta bort hela segment, och endast inaktiva sådana).
Zookeeper
Zookeeper fungerar som en lagring för metadata och koordinator. Det är den som kan säga om brokerna är aktiva (att titta på detta ur zookeepers ögon kan göras genom zookeeper-shell med kommandot ls /brokers/ids), vilken av brokerna som är kontrolleraren (get /controller), är partitionerna i synk med sina repliker (get /brokers/topics/topic_name/partitions/partition_number/state). Det är också till zookeeper som producenter och konsumenter först går för att ta reda på vilka topic och partitioner som lagras på vilken broker. I fall där topic har en replication factor större än 1 kommer zookeeper att ange vilka partitioner som är ledare (där skrivning kommer att ske och från vilka läsning kommer att ske). Vid krasch av en broker kommer information om nya ledarpartitioner att registreras i zookeeper (från version 1.1.0 asynkront, ).
I äldre versioner av Kafka ansvarade zookeeper också för lagring av offsets, men nu lagras de i en speciell topic __consumer_offsets på brokern (även om du fortfarande kan använda zookeeper för detta ändamål).
Det enklaste sättet att förvandla dina data till pumpa är just förlust av information med zookeeper. I ett sådant scenario kommer det vara mycket svårt att förstå vad och varifrån man behöver läsa.
Producer
Producer är oftast en tjänst som direkt skriver data till Apache Kafka. Producer väljer topic där det kommer att lagra sina ämnesmeddelanden och börjar skriva information i den. Till exempel kan en producer vara en annonseringstjänst. I så fall kommer den att skicka händelser till ämnestopics såsom "annons skapad", "annons uppdaterad", "annons borttagen" osv. Varje händelse representerar här ett nyckel-värde-par.
Som standard fördelas alla händelser över partitionerna i topic via round-robin, om ingen nyckel anges (vilket förlorar ordningen), och via MurmurHash (nyckel) om en nyckel finns (ordningen inom en partition).
Här bör det omedelbart noteras att Kafka garanterar händelseordningen endast inom en partition. Men i praktiken är detta sällan ett problem. Till exempel kan man garanterat lägga till alla ändringar av samma annons i en partition (och därigenom bevara ordningen av dessa ändringar inom annonsen). Man kan också överföra ett sekvensnummer i ett av fälten i händelsen.
Consumer
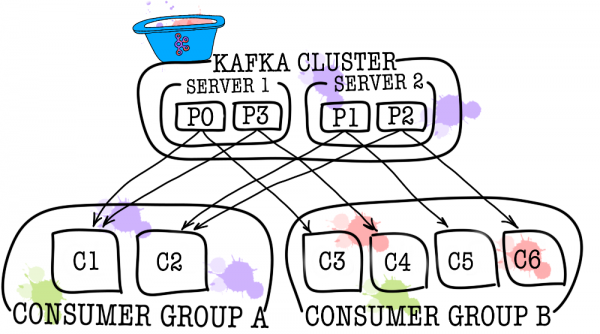
Consumer ansvarar för att hämta data från Apache Kafka. Om vi återgår till exemplet ovan kan consumer vara en modereringstjänst. Denna tjänst kommer att prenumerera på ämnet för annonsservicen och när en ny annons dyker upp kommer den att ta emot den och analysera den för att se om den uppfyller vissa angivna policyer.
Apache Kafka kommer ihåg vilka de senaste händelserna som consumer mottagit (detta görs med hjälp av en systemämne __consumer__offsets), vilket garanterar att consumer inte får samma meddelande två gånger vid en framgångsrik läsning. Om man däremot använder alternativet enable.auto.commit = true och helt överlåter ansvaret för att följa consumerns position i ämnet till Kafka, kan man . I produktionskod kontrolleras oftast consumerns position manuellt (utvecklaren hanterar tidpunkten när en commit av den lästa händelsen bör ske).
I de fall där en enda consumer inte räcker (till exempel om flödet av nya händelser är mycket stort), kan man lägga till ytterligare några consumers, koppla dem tillsammans i en consumer-grupp. Consumer-gruppen representerar logiskt samma consumer, men med datafördelning mellan gruppens medlemmar. Detta gör det möjligt för varje medlem att ta sin andel av meddelandena, vilket därmed ökar läshastigheten.
Testresultat
Här kommer jag inte att skriva mycket förklarande text, utan bara dela med mig av de erhållna resultaten. Testningen utfördes på 3 fysiska maskiner (12 CPU, 384GB RAM, 15k SAS DISK, 10GBit/s nätverk), med brokers och zookeeper distribuerade i lxc.
Prestandatestning
Under testningen erhölls följande resultat.
- Skrivhastighet för meddelanden på 1KB med 9 producenter samtidigt — 1300000 händelser per sekund.
- Läshastighet för meddelanden på 1KB med 9 consumers samtidigt — 1500000 händelser per sekund.
Testning av motståndskraft
Under testningen erhölls följande resultat (3 brokers, 3 zookeeper).
- Ett oväntat avslut på en av brokers leder inte till stopp eller otillgänglighet för klustret. Arbetet fortsätter som vanligt, men de återstående brokers får en större belastning.
- Ett oväntat avslut av två mäklare i en kluster med tre mäklare och min.isr = 2 leder till att klustret blir otillgängligt för skrivning, men fortsatt tillgängligt för läsning. Om min.isr = 1 är klustret fortsatt tillgängligt både för läsning och skrivning. Detta läge strider dock mot kraven för hög dataskydd.
- Ett oväntat avslut av en av Zookeeper-servrarna leder inte till att klustret stoppas eller blir otillgängligt. Arbetet fortsätter som vanligt.
- Ett oväntat avslut av två Zookeeper-servrar leder till att klustret blir otillgängligt tills minst en av Zookeeper-servrarna återfår funktion. Detta påstående stämmer för ett Zookeeper-kluster med 3 servrar. Som ett resultat av forskningen beslutades det att öka Zookeeper-klustret till 5 servrar för att öka driftsäkerheten.
Kafka som en tjänst
Vi har övertygats om att Kafka är en utmärkt teknik som löser våra problem (implementering av en meddelandemäklare). Ändå beslutade vi att förbjuda tjänster att direkt interagera med Kafka och stängde den bakom en data-buss. Varför gjorde vi detta? Det finns egentligen flera anledningar.
Data-bus tog på sig alla uppgifter relaterade till integrationen med Kafka (implementering och konfiguration av konsumenter och producenter, övervakning, larm, loggning, skalning osv.). Således sker integrationen med meddelandemäklaren på ett så enkelt sätt som möjligt.
Data-bus gjorde det möjligt att abstrahera från specifikt språk eller bibliotek för att arbeta med Kafka.
Data-bus gjorde det möjligt för andra tjänster att abstrahera från lagringsskiktet. Kanske, vid något tillfälle byter vi ut Kafka mot Pulsar, och då kommer ingen att märka det (alla tjänster vet bara om API:et för data-bus).
Data-bus har tagit ansvar för att validera händelseskeman.
Med hjälp av data-bus har autentisering genomförts.
Under data-bus kan vi utan nedtid, osynligt uppdatera versionerna av Kafka, centralt hantera konfigurationerna av producenter, konsumenter, mäklare osv.
Data-bus möjliggjorde att vi kunde lägga till nödvändiga funktioner som inte finns i Kafka (som ämnesrevision, övervakning av avvikelser i klustret, skapande av DLQ osv.).
Data-bus möjliggör en centraliserad failover för alla tjänster.
För att börja skicka händelser till meddelandebrokern räcker det för tillfället att koppla in ett litet bibliotek i koden för din tjänst. Det är allt. Du får möjligheten att skriva, läsa och skala med en rad kod. All implementering är dold för dig, bara några handtag av typ batchstorlek syns utåt. Under huven lyfter tjänsten data-bus upp det nödvändiga antalet instanser av producenter och konsumenter i Kubernetes och tillhandahåller dem med rätt konfiguration, men allt detta är transparent för din tjänst.
Självklart finns det ingen silverskjutning, och den här metoden har sina begränsningar.
- Data-bus måste stödjas av egna resurser, till skillnad från externa bibliotek.
- Data-bus ökar antalet interaktioner mellan tjänster och meddelandebrokern, vilket leder till en minskning av prestandan jämfört med ren Kafka.
- Inte allt går att dölja för tjänster, vi vill inte duplicera funktionalitet från KSQL eller Kafka Streams i data-bus, därför får tjänster ibland gå direkt.
I vårt fall väger fördelarna tyngre än nackdelarna, och beslutet att dölja meddelandebrokern som en separat tjänst har visat sig vara klokt. Under ett års drift har vi inte haft några allvarliga olyckor eller problem.
P.S. Tack till min flickvän, Ekaterina Obalyayeva, för de fantastiska bilderna i denna artikel. Om du gillade dem, finns det ännu fler illustrationer.
Källa: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish