

Välkomna, Habr!
Vi var de första som introducerade temat och fortsätter att följa dess utveckling. I synnerhet tyckte vi att temat om interaktion mellan Kafka och . En översiktlig (och ganska försiktig) artikel om detta publicerades på Confluents blogg redan i oktober förra året av Gwen Shapiro. Idag vill vi rikta er uppmärksamhet mot en mer aktuell artikel från april av Johann Gyger, som, även om han inte skippade frågetecknet i titeln, behandlar ämnet mer konkret och kompletterar texten med intressanta länkar. Ber om ursäkt för den fria översättningen "chaos monkey" om ni kan!
Introduktion
Kubernetes är avsett att hantera tillståndslös belastning. Vanligtvis är sådana arbetsbelastningar representerade i form av mikrotjänstarkitektur, de är lätta, lätt att horisontellt skala, följer principerna för 12-faktorapplikationer, och tillåter arbete med automatiska brytare (circuit breakers) och kaosapor (chaos monkeys).
Kafka, som ligger på andra sidan, är i grunden en distribuerad databas. Därför måste ni hantera tillstånd, vilket är mycket tyngre än en mikrotjänst. Kubernetes stöder tillståndsdålig belastning, men som Kelsey Hightower påpekar i två av sina tweets, bör man vara försiktig med dem:
Några tror att om Kubernetes körs på en tillståndslös belastning, blir det en helt hanterad databas som kan konkurrera med RDS. Så är det inte. Kanske om man gör tillräckligt med arbete, lägger till ytterligare komponenter och involverar ett SRE-team, så kan man bygga RDS ovanpå Kubernetes.
Jag rekommenderar alltid att man utövar extrem försiktighet när man kör tillståndsbevarande belastningar på Kubernetes. De flesta som undrar "kan jag köra tillståndsbevarande belastningar på Kubernetes" har inte tillräcklig erfarenhet av att arbeta med Kubernetes, och ofta inte ens med den belastning de frågar om.
Så, bör man köra Kafka på Kubernetes? En annan fråga: skulle Kafka fungera bättre utan Kubernetes? Därför vill jag betona i denna artikel hur Kafka och Kubernetes kompletterar varandra, och vilka fallgropar som kan uppstå när man kombinerar dem.
Körningstid
Låt oss prata om en grundläggande sak – körningsmiljön i sig
Process
Kafka-brokers är bra att arbeta med CPU. TLS kan innebära vissa kostnader. Samtidigt kan Kafka-klienter belasta CPU mer om de använder kryptering, men detta påverkar inte brokerns prestanda.
Minne
Kafka-brokers kräver mycket minne. JVM-högen bör vanligtvis begränsas till 4–5 GB, men du kommer också att behöva mycket systemminne eftersom Kafka använder sidcache intensivt. I Kubernetes ska du ställa in resursgränser och -begärningar för containern på lämpligt sätt.
Datacenter
Datacenter i containrar är flyktiga – data går förlorade vid omstart. För Kafka-data kan en volym användas emptyDir, och effekten blir liknande: dina brokers data kommer att gå förlorade efter avslutande. Dina meddelanden kan ändå bevaras på andra brokers som repliker. Så efter en omstart måste den misslyckade brokern först replikera all data, och denna process kan ta tid.
Det är därför man bör använda permanent datalagring. Låt det vara någon form av icke-lokal permanent lagring med ett filsystem som XFS eller, mer exakt, ext4. Använd inte NFS. Jag varnar dig. NFS-versioner v3 eller v4 fungerar inte. Kort sagt, Kafka-brokern kommer att krascha om den inte kan ta bort katalogen med data på grund av problem med "dumma omdirigeringar" som är aktuella i NFS. Om jag fortfarande inte har övertygat dig, läs noggrant . Datacenter måste vara icke-lokal för att Kubernetes ska kunna välja en ny nod mer flexibelt efter omstart eller omflyttning.
Nätverk
Precis som i de flesta distribuerade system beror Kafka:s prestanda starkt på att nätverksfördröjningar är minimala och bandbredden maximal. Försök inte att placera alla mäklare på samma nod, eftersom det skulle minska tillgängligheten. Om en Kubernetes-nod går ner, går hela Kafka-klustret ner. Dela inte heller upp Kafka-klustret över hela datacenter. Detsamma gäller Kubernetes-klustret. En bra kompromiss här är att välja olika tillgänglighetszoner.
Konfiguration
Vanliga manifest
På Kubernetes-webbplatsen finns om hur man konfigurerar ZooKeeper med hjälp av manifest. Eftersom ZooKeeper ingår i Kafka är det ett bra ställe att börja lära sig om vilka Kubernetes-koncept som är tillämpliga här. När du har förstått detta kan du tillämpa samma koncept på Kafka-klustret.
- Pod: en pod är den minimiutvecklade enheten i Kubernetes. I en pod finns din arbetsbelastning, och podden motsvarar en process i ditt kluster. I en pod finns en eller flera containrar. Varje ZooKeeper-server i ensemblet och varje mäklare i Kafka-klustret kommer att köras i en separat pod.
- StatefulSet: en StatefulSet är ett Kubernetes-objekt som arbetar med flera arbetsbelastningar som bevarar tillstånd, och sådana belastningar kräver samordning. StatefulSets ger garantier för ordningen för pods och deras unika identifiering.
- Headless-tjänster: Tjänster gör det möjligt att koppla pods från klienter med hjälp av ett logiskt namn. Kubernetes ansvarar i det fallet för lastbalanseringen. Men vid operationer med tillståndshållande arbetsbelastningar, som med ZooKeeper och Kafka, behöver klienterna utbyta information med en specifik instans. Här kommer headless-tjänster till nytta: i det fallet har klienten fortfarande ett logiskt namn, men kan inte behöva adressera podden direkt.
- Volym för långvarig lagring: sådana volymer behövs för att konfigurera icke-lokal blocklagring som nämndes tidigare.
På tillhandahåller en heltäckande uppsättning manifest som gör det lätt att komma igång med Kafka på Kubernetes.
Helm-diagram
Helm är en paketchef för Kubernetes som kan jämföras med paketchefer för operativsystem, såsom yum, apt, Homebrew eller Chocolatey. Med hjälp av den kan man enkelt installera fördefinierade programvarupaket som beskrivs i Helm-diagram. Ett väl utformat Helm-diagram förenklar den komplexa uppgiften: hur man korrekt konfigurerar alla parametrar för att använda Kafka på Kubernetes. Det finns flera Kafka-diagram: den officiella finns , det finns en från , en annan – från .
Operatörer
Eftersom Helm har vissa begränsningar, får ett annat verktyg, Kubernetes-operatörer, stor popularitet. En operatör paketerar inte bara programvara för Kubernetes, utan möjliggör även distribution och hantering av den programvaran.
I listan över nämns två operatörer för Kafka. En av dem är . Med Strimzi är det enkelt att sätta upp en Kafka-kluster på några minuter. Nästan ingen konfiguration behövs, och operatören erbjuder dessutom några trevliga funktioner, till exempel punkt-till-punkt TLS-kryptering inom klustret. Confluent erbjuder också .
Performance
Det är mycket viktigt att testa prestandan genom att förse din installerade Kafka-instans med kontrollpunkter. Sådana tester kan hjälpa dig att identifiera potentiella flaskhalsar innan problem uppstår. Lyckligtvis tillhandahåller Kafka redan två verktyg för prestandatestning: kafka-producer-perf-test.sh och kafka-consumer-perf-test.sh. Använd dem aktivt. För referens kan du konsultera resultaten som beskrivs av Jay Kreps, eller förlita dig på Amazon MSK av Stéphane Maarek.
Operationer
Övervakning
Transparens i systemet är mycket viktigt – annars förstår du inte vad som händer. Idag finns det ett gediget verktyg som erbjuder övervakning baserad på metrics i stil med cloud native. Två populära verktyg för detta ändamål är Prometheus och Grafana. Prometheus kan samla in metrics från alla Java-processer (Kafka, Zookeeper, Kafka Connect) med hjälp av JMX-exportören – på det enklaste sättet. Om du lägger till cAdvisor-metrics kan du få en mer heltäckande bild av hur resurser används i Kubernetes.
Strimzi har ett mycket användarvänligt exempel på en Grafana-instrumentpanel för Kafka. Den visualiserar nyckelmetrik, som till exempel omapade partitioner eller de som är offline. Allt är mycket tydligt. Dessa mätningar kompletteras med information om resursanvändning och prestanda, samt stabilitetsindikatorer. På så sätt får du en grundläggande övervakning av Kafka-klustret kostnadsfritt!
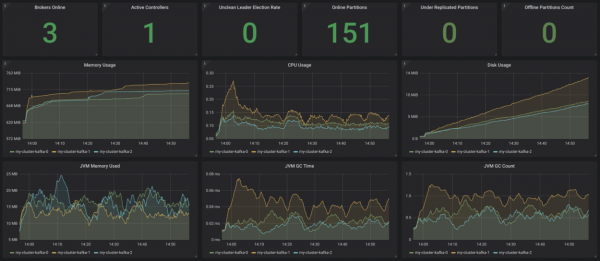
Källa:
Allt detta skulle vara bra att komplettera med klientövervakning (metrik för konsumenter och producenter), samt övervakning av latens (för detta finns ) och övergripande övervakning – för detta använder du .
Loggning
Loggning är en annan viktig uppgift. Se till att alla containrar i din Kafka-installation loggas till stdout och stderr, och se också till att ditt Kubernetes-kluster aggregerar alla loggar i en central logginfrastruktur, till exempel i .
Kontroll av tillgänglighet
Kubernetes använder liveness- och readiness-prober för att kontrollera om dina pods fungerar som de ska. Om liveness-proben misslyckas kommer Kubernetes att stoppa denna container och sedan automatiskt starta om den, om omstartspolicyn är korrekt inställd. Om readiness-proben misslyckas kommer Kubernetes att isolera denna pod från att ta emot förfrågningar. På så sätt behövs det ingen manuell ingripande i sådana fall, vilket är en stor fördel.
Utrullning av uppdateringar
StatefulSets stöder automatiska uppdateringar: när du väljer strategin RollingUpdate kommer varje Kafka-pod att uppdateras i tur och ordning. På så sätt kan du minimera stilleståndstiden till noll.
Skalning
Att skala Kafka-klustret är en utmaning. Men i Kubernetes är det mycket enkelt att skala pods till ett visst antal replika, vilket betyder att du kan deklarativt definiera så många Kafka-brokers som du vill. Det svåraste i detta fall är att omfördela partitioner efter att ha skalat upp eller innan du skalar ner. Återigen kommer Kubernetes att hjälpa dig med denna uppgift.
Administration
Uppgifter relaterade till administration av din Kafka-kluster, särskilt skapande av ämnen och omfördelning av partitioner, kan utföras med hjälp av de befintliga shell-skripten genom att öppna kommandoradsgränssnittet i dina pods. Men detta är inte en särskilt elegant lösning. Strimzi stödjer hantering av ämnen med hjälp av en annan operator. Här finns det mer att utveckla.
Säkerhetskopiering och återställning
Nu kommer tillgängligheten av Kafka att bero på tillgängligheten av Kubernetes. Om din Kubernetes-kluster går ner, kommer i värsta fall även Kafka-klustret att krascha. Enligt Murphys lag kommer detta garanterat att hända, och du kommer att förlora data. För att minska risken för sådana situationer, är det viktigt att noggrant utarbeta en säkerhetskopieringsstrategi. Du kan använda MirrorMaker, ett annat alternativ är att utnyttja S3 för detta, som beskrivs i detta från Zalando.
Slutsats
När man arbetar med små eller medelstora Kafka-kluster är det definitivt förnuftigt att använda Kubernetes, eftersom det ger ytterligare flexibilitet och förenklar arbetet med operatörer. Om du har mycket strikta icke-funktionella krav relaterade till latens och/eller kapacitetsanvändning, kan det vara bättre att överväga ett annat distributionsalternativ.
Källa: habr.com
