

Hej, Habr! Just nu är anmälan till den nya omgången av kursen på OTUS öppen. . I förberedelserna inför start av kursen har vi traditionellt förberett en översättning av ett intressant material för er.
Mer än hundra miljoner människor besöker Twitter varje dag för att ta reda på vad som händer i världen och diskutera det. Varje tweet och varje annan användaråtgärd genererar en händelse som är tillgänglig för intern dataanalys på Twitter. Hundratals anställda analyserar och visualiserar dessa data, och att förbättra deras upplevelse är högsta prioritet för Twitter Data Platform-teamet.
Vi anser att användare med en bredd av tekniska färdigheter ska kunna hitta data och få tillgång till välinarbetade verktyg för analys och visualisering baserat på SQL. Detta skulle möjliggöra för en helt ny grupp användare med mindre teknisk bakgrund, inklusive dataanalytiker och produktledare, att extrahera insikter från data, vilket hjälper dem att bättre förstå och utnyttja möjligheterna på Twitter. Så demokratiserar vi dataanalys på Twitter.
Medan våra verktyg och möjligheter för intern dataanalys har förbättrats har vi sett en förbättring av Twitter-tjänsten. Ändå finns det fortfarande utrymme för tillväxt. Nuvarande verktyg, såsom Scalding, kräver programmeringskunskaper. SQL-baserade analysverktyg, såsom Presto och Vertica, har prestandaproblem i stor skala. Vi har också problem med att sprida data över flera system utan konstant tillgång till dem.
Förra året tillkännagav vi , där vi flyttar delar av vår till Google Cloud Platform (GCP). Vi har kommit fram till att Googles verktyg kan hjälpa oss i våra initiativ för att demokratisera analys, visualisering och maskininlärning på Twitter:
- : företagsdatabas med en SQL-motor baserad på , som är känd för sin hastighet, enkelhet och hanterar .
- ett verktyg för visualisering av big data med samarbetsfunktioner som i Google Docs.
I denna artikel får du veta om våra erfarenheter med dessa verktyg: vad vi har gjort, vad vi har lärt oss och vad vi ska göra härnäst. Just nu fokuserar vi på batch- och interaktiv analys. Realtidsanalys kommer vi att diskutera i nästa artikel.
Historien om datalager på Twitter
Innan vi dyker djupare in i BigQuery är det värt att kort sammanfatta historien om datalager på Twitter. År 2011 utfördes dataanalys på Twitter med Vertica och Hadoop. För att skapa Hadoop's MapReduce jobb använde vi Pig. År 2012 bytte vi ut Pig mot Scalding, som hade ett Scala API med fördelar som möjligheten att skapa komplexa flöden och enkel testning. Men för många dataanalytiker och produktchefer som kände sig mer bekväma med SQL var detta en ganska brant inlärningskurva. Ungefär 2016 började vi använda Presto som SQL-gränssnitt för Hadoop-data. Spark erbjöd ett Python-gränssnitt vilket gör det till ett bra val för ad hoc dataanalyser och maskininlärning.
Från och med 2018 har vi använt följande verktyg för dataanalys och visualisering:
- Scalding för produktionsflöden
- Scalding och Spark för ad hoc dataanalys och maskininlärning
- Vertica och Presto för ad hoc och interaktiv SQL-analys
- Druid för liten interaktiv, utforskande och låglatens åtkomst till tidsseriemetrik
- Tableau, Zeppelin och Pivot för datavisualisering
Vi upptäckte att även om dessa verktyg erbjuder mycket kraftfulla funktioner, hade vi svårigheter med att göra dessa funktioner tillgängliga för en bredare publik på Twitter. När vi utvidgar vår plattform med Google Cloud, fokuserar vi på att förenkla våra analysverktyg för hela Twitter.
BigQuery datalager från Google
Flera team på Twitter har redan inkluderat BigQuery i vissa av sina produktionsflöden. Genom att använda deras erfarenhet började vi utvärdera BigQuery:s kapabiliteter för alla användningsscenarier på Twitter. Vårt mål var att erbjuda BigQuery till hela företaget samt att standardisera och underhålla det inom ramen för verktygen på Data Platform. Detta var besvärligt av många skäl. Vi behövde utveckla en infrastruktur för tillförlitlig mottagning av stora datavolymer, stöd för datastyrning på företagsnivå, säkerställande av korrekt åtkomstkontroll och skydd av kunders integritet. Vi var också tvungna att skapa system för resursfördelning, övervakning och betalningsåtervinning så att teamen effektivt kunde använda BigQuery.
I november 2018 släppte vi alpha-versionen av BigQuery och Data Studio för hela företaget. Vi erbjöd Twitter-anställda några av våra mest använda tabeller med rengjorda personuppgifter. Mer än 250 användare från olika team, inklusive teknik, finans och marknadsföring, använde BigQuery. Nyligen genomförde de omkring 8 000 förfrågningar, vilket hanterade cirka 100 PB per månad, utan att räkna med schemalagda förfrågningar. Efter att ha fått mycket positiv feedback beslutade vi oss för att gå vidare och erbjuda BigQuery som en primär resurs för datainteraktion på Twitter.
Här är en hög nivå av arkitekturdiagrammet för vårt datalager Google BigQuery.
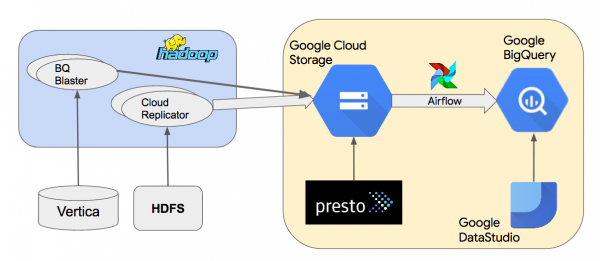
Vi kopierar data från lokala Hadoop-kluster till Google Cloud Storage (GCS) med hjälp av vårt interna verktyg Cloud Replicator. Därefter använder vi Apache Airflow för att skapa rörledningar som använder "" för att ladda data från GCS till BigQuery. Vi använder Presto för att fråga dataset Parquet eller Thrift-LZO i GCS. BQ Blaster är ett internt verktyg i Scalding för att ladda dataset HDFS Vertica och Thrift-LZO till BigQuery.
I de följande avsnitten kommer vi att diskutera vårt tillvägagångssätt och våra kunskaper om användarvänlighet, prestanda, datastyrning, systemens driftsäkerhet och kostnad.
Användarvänlighet
Vi har upptäckt att det var lätt för användarna att börja med BigQuery, eftersom det inte krävde programvaruinstallation och användarna kunde få åtkomst via en intuitiv webbgränssnitt. Ändå behövde användarna bekanta sig med vissa GCP-funktioner och dess koncept, inklusive resurser som projekt, dataset och tabeller. Vi har utvecklat utbildningsmaterial och handledningar för att hjälpa användare att komma igång. När de fick en grundläggande förståelse blev det enkelt för användarna att navigera i dataset, granska scheman och data i tabeller, utföra enkla förfrågningar och visualisera resultat i Data Studio.
Vårt mål för datainmatningen i BigQuery var att säkerställa en smidig inladdning av dataset HDFS eller GCS med ett klick. Vi övervägde (styrt Airflow), men vi kunne ikke bruke det på grunn av vår sikkerhetsmodell «Domain Restricted Sharing» (les mer om dette i avsnittet «Datastyring» nedenfor). Vi eksperimenterte med å bruke Google Data Transfer Service (DTS) for å organisere lastoppgaver i BigQuery. Mens DTS ble satt opp raskt, var det ikke fleksibelt for å bygge pipelines med avhengigheter. For vår alfa-versjon opprettet vi vårt eget Apache Airflow-miljø i GCE og forbereder det til produksjon og muligheten til å støtte flere datakilder, som Vertica.
For å transformere data til BigQuery oppretter brukere enkle SQL-datapipelines ved hjelp av planlagte forespørseler. For komplekse flerstegs-pipelines med avhengigheter planlegger vi å bruke enten vår egen Airflow-infrastruktur eller Cloud Composer sammen med .
Performance
BigQuery er laget for generelle SQL-forespørseler som behandler store datamengder. Den er ikke designet for forespørseler med lav ventetid og høy gjennomstrømning, som kreves for transaksjonsdatabaser, eller for lav-latens analyse av tidsserier, implementert av . For interaktive analytiske forespørseler forventer brukerne våre en responstid på under ett minutt. Vi måtte designe bruken av BigQuery slik at den oppfylte disse forventningene. For å sikre forutsigbar ytelse for våre brukere, brukte vi BigQuery-funksjonaliteten tilgjengelig for kunder med fast pris, som lar prosjektseierne reservere minimale slots for sine forespørseler. BigQuery er en enhet for beregningskraft som kreves for å utføre SQL-forespørseler.
Vi har analyserat mer än 800 förfrågningar som hanterar ungefär 1 TB data vardera och upptäckte att den genomsnittliga exekveringstiden var 30 sekunder. Vi lärde oss också att prestandan är starkt beroende av hur vår slot används i olika projekt och uppgifter. Vi var tvungna att tydligt separera våra produktions- och ad hoc slot-reserver för att upprätthålla prestanda för produktionsanvändningssituationer och interaktiv analys. Detta påverkade i hög grad vår design för slot-reservering och projekt hierarki.
Om datastyrning, funktionalitet och kostnad för system kommer vi att prata mer om i de kommande dagarna i den andra delen av översättningen, men just nu inbjuder vi alla intresserade till , där man kan få veta mer om kursen och även ställa frågor till vår expert — Yegor Mateshchuk (Senior Data Engineer, MaximaTelecom).
Läs mer:
Källa: habr.com
