

Hej, Habr!
Idag vill jag berätta om vår erfarenhet av att automatisera säkerhetskopiering av stora datalager i Nextcloud i olika konfigurationer. Jag arbetar som CTO på "Molniya AK", där vi sysslar med konfigurationshantering av IT-system, där Nextcloud används för datalagring. Detta inkluderar distribuerade strukturer med redundans.
Problemen som uppstår från installationsspecifika egenskaper är att det finns mycket data. Versionshantering som Nextcloud erbjuder, säkerhetskopiering, subjektiva orsaker och annat skapar många dubbletter.
Bakgrund
Vid administration av Nextcloud uppstår snabbt problemet med att organisera en effektiv backup som absolut måste krypteras, eftersom data är värdefulla.
Vi erbjuder alternativ för backup-lagring antingen hos oss eller hos kunden på separata maskiner från Nextcloud, vilket kräver ett flexibelt automatiserat tillvägagångssätt för administration.
Det finns många kunder, alla med olika konfigurationer, och alla på sina egna plattformar och med sina egna egenskaper. Här passar den standardmetodik där hela plattformen tillhör dig och backuper görs via cron dåligt.
Vi börjar med att titta på förutsättningarna. Vi behöver:
- Skalbarhet avseende en nod eller flera. För stora installationer använder vi minio som lagringslösning.
- Att registrera problem med säkerhetskopieringen.
- Backup måste lagras hos kunder och/eller hos oss.
- Att snabbt och enkelt kunna lösa problem.
- Kunder och installationer skiljer sig kraftigt åt — det går inte att åstadkomma enhetlighet.
- Återställningshastigheten måste vara minimal i två scenarier: full återställning (katastrof), en mapp — raderad av misstag.
- Funktionen för deduplering är obligatorisk.
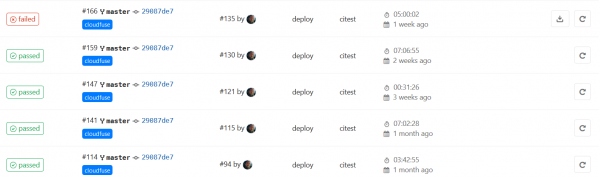
För att lösa problemet med backup-hantering kopplade vi in GitLab. Mer info i avsnittet nedan.
Naturligtvis är vi inte de första som löser ett sådant problem, men vi tycker att vår praktiska, erfarna erfarenhet kan vara intressant och vi är redo att dela med oss av den.
Eftersom vårt företag har en open source-policy, letade vi efter en lösning med öppen källkod. Å sin sida delar vi våra utvecklingar och publicerar dem. Till exempel finns vår , som vi installerar hos kunder, som stärkt dataskydd i händelse av oavsiktlig eller avsiktlig radering.
Backup-verktyg
Vi började söka efter lösningar genom att välja ett verktyg för att skapa säkerhetskopior.
Vanlig tar + gzip fungerar dåligt - data dupliceras. Inkremental innehåller ofta väldigt få förändringar i praktiken och största delen av datan inom en fil upprepas.
Det finns ytterligare ett problem - redundans i det distribuerade datalagringssystemet. Vi använder minio och dess data är i princip redundanta. Antingen behövde säkerhetskopiering göras genom minio självt - vilket belastar det och använder alla mellanliggande lager mellan filsystemet, och inte minst finns det en risk att glömma bort vissa bucketer och metainformation. Alternativt använda deduplicering.
Det finns dedupliceringsverktyg i öppen källkod (detta ämne har diskuterats på Habré ) och vi valde och . Om vår jämförelse av de två applikationerna nedan, men först ska vi berätta hur vi organiserade hela schemat.
Hantera skapandet av säkerhetskopior
Borg och Restic är bra, men ingen av produkterna har en centraliserad hanteringsmekanism. För hantering och kontroll valde vi ett verktyg som redan är implementerat hos oss, utan vilket vi inte kan tänka oss vårt arbete, inklusive automatisering - det kända CI/CD - GitLab.
Idén är följande: På varje nod som lagrar data för Nextcloud installeras gitlab-runner. Runnern kör ett skript enligt schema som övervakar säkerhetskopieringsprocessen, och det initierar Borg eller Restic.
Vad fick vi? Feedback från utförandet, bekväm övervakning av förändringar och detaljer vid fel.
Här är vi har lagt upp exempel på skript för olika uppgifter, och vi kopplade det i slutändan till säkerhetskopieringen av inte bara Nextcloud utan också många andra tjänster. Där finns också schemaläggaren, om man inte vill ställa in det manuellt (och vi vill inte) och .gitlab-ci.yml
Det finns fortfarande ingen möjlighet att ändra timeout för CI/CD i GitLab API, och den är ganska kort. Den måste ökas, låt oss säga till 1d.
Lyckligtvis kan GitLab köras inte bara vid commit utan också enligt schema, vilket är precis vad vi behöver.
Nu om inlindande skript.
Vi satte upp följande krav för detta skript:
- Skriptet ska kunna köras både av runnern och manuellt från konsolen med samma funktionalitet.
- Det måste finnas felhanterare:
- returkod.
- söka efter strängar i loggen. Till exempel kan ett fel för oss vara ett meddelande som programmet inte ser som fatalt.
- Hantera timeout. Utförandetiden bör vara rimlig.
- Vi behöver en detaljerad logg. Men bara i händelse av ett fel.
- Också en rad tester utförs innan starten.
- Små bekvämligheter som vi har funnit användbara under supportprocessen:
- Start och slut registreras i systemloggen på den lokala maskinen. Detta hjälper oss att koppla samman systemfel och backupens arbete.
- Delar av felloggen, när de finns, visas i stdout, hela loggen skrivs till en separat fil. Det är praktiskt att snabbt kolla i CI och bedöma felet om det är trivialt.
- Lägen för debugging.
Den fullständiga loggen sparas som en artifact i GitLab, om det inte finns några fel, tas loggen bort. Skriptet skrivs i bash.
Vi ser gärna eventuella förslag och kommentarer om öppen källkod — välkommen.
Hur det fungerar
På den noder som ska säkerhetskopieras startas en runner med bash-exekverare. I schemaläggaren startas ett job CI/CD i ett speciellt repo. Runnern kör ett skript, en universell wrapper för sådana uppgifter, i vilket validering av backuprepo, monteringspunkter och allt vi vill kontrolleras, följt av backup och rensning av gammal data. Den färdiga backupen skickas till S3.
Vi arbetar enligt detta schema — en extern leverantör av AWS eller en rysk motsvarighet (detta är snabbare och data lämnar inte Ryssland). Alternativt installerar vi en separat minio-kluster hos kunden för dessa ändamål. Vi brukar göra så av säkerhetsskäl när kunden verkligen inte vill att data ska lämna deras kontur.
Vi har valt att inte använda funktionen för att skicka backup via ssh. Det ger ingen extra säkerhet, och nätverksmöjligheterna hos S3-leverantören är mycket högre än med en enda ssh-maskin.
För att skydda mot hackers på den lokala maskinen — eftersom de kan radera data på S3, bör versionering definitivt aktiveras.
Bakup-programmet krypterar alltid backupen.
Borg har ett läge utan kryptering none, men vi rekommenderar starkt att inte aktivera det. I detta läge kommer det inte bara att saknas kryptering, utan även kontrollsumman för det som skrivs kommer inte att beräknas, vilket innebär att integriteten endast kan kontrolleras indirekt genom index.
En separat schemaläggare utför kontroll av backupens integritet för index och innehåll. Kontrollen sker långsamt och tar tid, så vi kör den separat en gång i månaden. Den kan pågå i flera dagar.
README på ryska
Huvudfunktioner
convergeförberedelsetestkollakontroll av beredskaphuvudkommandogrundläggande kommandotvångsbakgrunden funktion som körs i slutet eller vid fel. Används för att avmontera partitionen.
Tjänstefunktioner
— borttagning av instansen.vi registrerar fel eller raderar loggfilen.checklogvi parsar loggen för att hitta strängen med felet.retexit-hanterare.checktimeouttimeoutkontroll.
Environment
VERBOSE=1vi skriver ut fel direkt på skärmen (stdout).SAVELOGSONSUCCES=1vi sparar loggen vid framgång.INIT_REPO_IF_NOT_EXIST=1Vi skapar ett repository om det inte fanns. Som standard avstängt.TIMEOUTmaximal tid för grundläggande operation. Du kan ange 'm', 'h' eller 'd' i slutet.
Lagringsläge för äldre kopior. Som standard:
KEEP_DAILY=7KEEP_WEEKLY=4KEEP_MONTHLY=6
Variabler inom skriptet
ERROR_STRING— sträng för att kontrollera loggen för fel.EXTRACT_ERROR_STRING— uttryck för att visa sträng om det finns ett fel.KILL_TIMEOUT_SIGNAL— signal för att döda om timeout.TAIL— hur många strängar med fel som visas på skärmen.COLORMSG— färg på meddelandet (standard gul).
Det skript som kallas wordpress har som funktion att också ta säkerhetskopior av mysql-databasen. Det kan alltså användas för engångsinstallationer av Nexcloud, där databasen också kan backas upp. Bekvämligheten ligger inte bara i att allt är på ett ställe, utan att innehållet i databasen är nära relaterat till innehållet i filerna, eftersom tidsskillnaden är minimal.
Restic vs Borg
Jämförelser mellan Borg och Restic finns bland annat , och vårt mål var inte bara att skapa ytterligare en, utan vår egen. Vi ville förstå hur det skulle se ut på våra data, med vår specifikation. Vi tar med dem.
Våra urvalskriterier, förutom de tidigare nämnda (deduplicering, snabb återställning osv.):
- Motståndskraft mot ofullständig drift. Kontroll för kill -9.
- Storlek på disken.
- Krav på resurser (CPU, minne).
- Storlek på de lagrade blobbarna.
- Arbete med S3.
- Integritetskontroll.
För testning tog vi en klient med verkliga data och en total storlek på 1,6TB.
Villkor.
Borg kan inte direkt arbeta med S3, och vi monterade det som en fuse-disk genom . Restic skickade data till S3 själv.
Goofys fungerar mycket snabbt och bra, och det finns , vilket ytterligare accelererar arbetet. Den är i beta-stadiet, och vi måste erkänna att vi förlorade data under tester (andra). Men fördelen är att själva backupproceduren inte kräver mycket läsning, utan mest skrivning, så vi använder cachen endast under integritetskontrollen.
För att minska nätverksinflytandet använde vi en lokal leverantör — Yandex Cloud.
Resultat från testningen av jämförelsen.
- Kill -9 med efterföljande omstart gick båda igenom framgångsrikt.
- Storlek på disken. Borg kan komprimera, så resultaten är förväntade.
Backuper
Dimensions
Borg
562Gb
Restic
628Gb
- Enligt CPU
Borg själv förbrukar lite med standardkomprimering, men man måste bedöma det tillsammans med goofys-processen. Tillsammans är de jämförbara och använder cirka 1,2 kärnor på samma testvirtuella maskin. - Minne. Restic cirka 0,5Gb, Borg cirka 200Mb. Men detta är ganska obetydligt jämfört med systemets filcache. Så det är önskvärt att allokera mer minne.
- Skillnaden i storlek på blobbar var slående.
Backuper
Dimensions
Borg
cirka 500Mb
Restic
cirka 5Mb
- Arbetet med S3 från Restic är utmärkt. Borgs arbete genom goofys verkar ok, men det har noterats att det är bättre att utföra umount efter backupen för att helt rensa cachen. En egenskap hos S3 är att ofullständiga chunkar aldrig skickas till bucket, vilket innebär att inte helt uppladdade data leder till stora skador.
- Integritetskontrollen fungerar bra i båda fallen, men hastigheten skiljer sig markant.
Restic – 3,5 timmar.
Borg, med en filcache på 100Gb SSD – 5 timmar. Ungefär samma resultat i hastighet om datan ligger på lokal disk.
Borg läser direkt från S3 utan cache 33 timmar. Fruktansvärt lång tid.
I det stora hela kan Borg komprimera och har större blobbar - vilket gör lagringen och GET/PUT-operationer i S3 billigare. Men det får man betala för med en mer komplex och långsammare kontroll. När det gäller återställningshastigheten märkte vi ingen skillnad. Efterföljande backuper (efter den första) gör restic några minuter längre, men inte avsevärt.
Size community stod inte på sista plats i valet.
Och vi valde borg.
Ett par ord om komprimering
Borg har ett utmärkt nytt komprimeringsalgoritm i sin arsenal - zstd. Komprimeringskvaliteten är inte sämre än gzip, men betydligt snabbare. Och jämförbar i hastighet med den standardmässiga lz4.
Till exempel komprimeras en MySQL-dump ungefär två gånger bättre än lz4 med samma hastighet. Men erfarenheten på verkliga data visar att det är mycket liten skillnad i komprimeringseffektivitet för Nextcloud-noden.
Borg har ett ganska bonusläge för komprimering - om filen har hög entropi tillämpas ingen komprimering alls, vilket ökar hastigheten. Det aktiveras med en parameter vid skapandet
-C auto,zstd
för zstd-algoritmen
Så med denna parameter i jämförelse med standardkomprimeringen uppnådde vi
560 Gb och 562 Gb respektive. Data från exemplet ovan, utan komprimering, ger 628 Gb. Resultatet med en skillnad på 2 Gb överraskade oss något, men vi kom fram till att vi väljer ändå auto,zstd.
Metod för att verifiera backup
Genom schemaläggaren startas virtuella maskiner direkt hos leverantören eller hos kunden, vilket kraftigt minskar nätverksbelastningen. Åtminstone är det billigare än att köra det på plats hos oss och skicka trafik.
goofys --cache "--free:5%:/mnt/cache" -o allow_other --endpoint https://storage.yandexcloud.net --file-mode=0666 --dir-mode=0777 xxxxxxx.com /mnt/goofys
export BORG_PASSCOMMAND="cat /home/borg/.borg-passphrase"
borg list /mnt/goofys/borg1/
borg check --debug -p --verify-data /mnt/goofys/borg1/
Vi kontrollerar filer med antivirus på samma sätt (efterhand). Användare laddar upp olika saker till Nextcloud och alla har inte antivirus. Att göra en kontroll vid uppladdning tar för mycket tid och stör verksamheten.
Skalbarhet uppnås genom att köra runners på olika noder med olika taggar.
I vår övervakning samlas statusar för backuper via GitLab API i ett fönster, vilket gör att problem lätt kan identifieras och lokaliseras.
Slutsats
Som ett resultat vet vi med säkerhet att vi gör våra backuper, att våra backuper är giltiga, och att de problem som uppstår med dem tar lite tid och löses av den jourhavande administratören. Backuper tar faktiskt väldigt lite plats i jämförelse med tar.gz eller Bacula.
Källa: habr.com
