

I den här artikeln berättar vi om hur och varför vi utvecklade – en mekanism som överför information mellan klientapplikationer och 1C: Enterprise servrar – från att ställa upp uppgiften till att tänka på arkitekturen och detaljerna i genomförandet.
Interaktionssystemet (nedan – IS) – är ett distribuerat, felresistent meddelandebytesystem med garanterad leverans. IS är utformat som en högbelastad tjänst med hög skalbarhet, tillgänglig både som en online-tjänst (tillhandahålls av företaget 1C) och som en licensierad produkt som kan implementeras på egna servrar.
IS använder ett distribuerat lagringssystem och söksystemet . Det kommer också att handla om Java och hur vi horisontellt skalade PostgreSQL.
Uppgiftsställande
För att förstå varför vi gjorde Interaktionssystemet, ska jag berätta lite om hur utvecklingen av affärsapplikationer i 1C är organiserad.
Först – lite om oss för dem som inte känner till vad vi gör :) Vi bygger en teknologisk plattform "1C: Enterprise". Plattformen innehåller ett utvecklingsverktyg för affärsapplikationer, samt en runtime som gör att affärsapplikationer kan köras i en plattformsoberoende miljö.
Klient-server-paradigmen för utveckling
Affärsapplikationer skapade med "1C: Enterprise" fungerar i ett tre-lags arkitektur "DBMS – applikationsserver – klient". Applikationskoden som skrivits i , kan köras på applikationsservern eller på klienten. Allt arbete med applikationsobjekt (register, dokument etc.), samt läsning och skrivning till databasen, utförs endast på servern. Funktionaliteten för formulär och kommandogränssnitt är också implementerad på servern. På klienten utförs hämtning, öppning och visning av formulär, "kommunikation" med användaren (varningar, frågor...), små beräkningar i formulär som kräver snabb respons (t.ex. multiplikation av pris med antal), arbete med lokala filer, arbete med hårdvara.
I den praktiska koden för procedurer och funktioner måste man tydligt ange var koden kommer att köras - med hjälp av direktiven &НаКлиенте / &НаСервере (&AtClient / &AtServer i den engelska versionen av språket). Utvecklare inom 1C kommer nu att rätta mig genom att säga att direktiven egentligen , men för oss är det för närvarande inte av betydelse.
Från klientkoden kan man anropa serverkoden, men från serverkoden kan man inte anropa klientkoden. Detta är en grundläggande begränsning som vi har infört av flera skäl. Bland annat för att serverkoden måste skrivas så att den fungerar på samma sätt oavsett varifrån den anropas - från klienten eller servern. Vid ett anrop av serverkoden från en annan serverkod finns ingen klient. Dessutom kan klienten som gjorde anropet ha stängts ner eller lämnat applikationen under exekveringen av serverkoden, och servern har ingen att anropa.

Koden som hanterar knapptryckning: anrop av serverprocedur från klienten kommer att fungera, anrop av klientprocedur från servern - nej.
Detta innebär att om vi från servern vill överföra ett meddelande till klientapplikationen, exempelvis att skapandet av en "långvarig" rapport är klart och rapporten kan visas - finns det inget sätt att göra det. Vi tvingas att vidta åtgärder, som att regelbundet fråga servern från klientkoden. Men detta tillvägagångssätt belastar systemet med onödiga anrop och ser överlag inte särskilt stiligt ut.
Det finns dessutom behov av att vid ett inkommande telefonsamtal -informera den klientapplikationen om detta, så den kan hitta den ringande personen i databas och visa informationen om den ringande kontakten för användaren. Eller, till exempel, vid ankomst av en beställning till lagret informera beställarens klientapplikation om detta. Det finns många scenarier där en sådan mekanism skulle vara användbar.
Faktiskt sätta upp
Skapa en mekanism för meddelandeutbyte. Snabb, pålitlig, med garanterad leverans, med möjlighet till flexibel sökning av meddelanden. Baserat på mekanismen implementera en meddelandetjänst (meddelanden, videosamtal) som fungerar inom 1C-applikationer.
Designa system för horisontell skalning. Ökande belastning ska hanteras genom att öka antalet noder.
Implementering
Vi har beslutat att inte integrera serverdelen av SV direkt i 1C:Enterprise-plattformen, utan istället implementera den som en separat produkt vars API kan anropas från koden i applikationslösningarna för 1C. Detta gjordes av flera skäl, där det främsta är att vi ville möjliggöra meddelandeutbyte mellan olika 1C-applikationer (till exempel mellan Handelshantering och Bokföring). Olika 1C-applikationer kan köras på olika versioner av 1C:Enterprise-plattformen, vara placerade på olika servrar, etc. Under sådana omständigheter är implementeringen av SV som en separat produkt, placerad "vid sidan om" 1C-installationerna, den optimala lösningen.
Så vi har beslutet att göra SV som en separat produkt. För små företag rekommenderar vi att använda SV-servern som vi har installerat i vår molntjänst (wss://1cdialog.com) för att undvika kostnader relaterade till lokal installation och konfiguration av servern. Större kunder kan dock tycka att det är rimligt att installera sin egen SV-server på sina egna resurser. En liknande strategi har vi använt i vår molntjänst SaaS-produkt. – det släpps som en serieprodukt för installation hos kunder, och är också distribuerat i vårt moln. .
Applikation
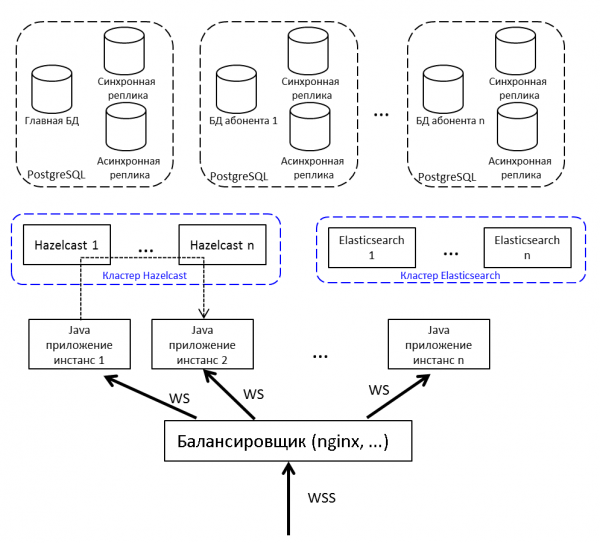
För att fördela belastningen och säkerställa driftsäkerhet kommer vi att distribuera flera Java-applikationer istället för en, och sätta en belastningsutjämnare framför dem. Om ett meddelande behöver överföras från nod till nod – använder vi publish/subscribe i Hazelcast.
Kommunikationen mellan klienten och servern sker via websocket. Det passar bra för realtidsystem.
Distribuerad cache
Vi valde mellan Redis, Hazelcast och Ehcache. Året är 2015. Redis har just släppt en ny klusterlösning (för ny, känns osäkert), det finns Sentinel med många begränsningar. Ehcache kan inte sättas ihop i ett kluster (denna funktionalitet kom senare). Vi bestämde oss för att prova med Hazelcast 3.4.
Hazelcast kan sättas samman i ett kluster "out-of-the-box". I en envägsnod är det inte så nyttigt och kan bara användas som cache – den kan inte spara data till disk, och om vi förlorar den enda noden, förlorar vi data. Vi distribuerar flera Hazelcast-instanser, mellan vilka vi säkerhetskopierar kritiska data. Cachen säkerhetskopieras inte – vi är inte rädda om den.
För oss är Hazelcast:
- Ett lager för användarsessioner. Att varje gång hämta sessionen från databasen tar för lång tid, så vi placerar alla sessioner i Hazelcast.
- Cache. Letar du efter en användarprofil - kolla i cachen. Skrev du ett nytt meddelande - spara i cachen.
- Ämnen för kommunikation mellan applikationsinstanser. Noden genererar ett händelse och placerar den i Hazelcast-ämnet. Andra noder i applikationen som prenumererar på detta ämne får och bearbetar händelsen.
- Klustersperrningar. Till exempel skapar vi en diskussion med en unik nyckel (singleton-diskussion inom 1C-databasen):
conversationKeyChecker.check("BENSINSTATION");

      doInClusterLock("BENSINSTATION", () -> {

          conversationKeyChecker.check("BENSINSTATION");

          createChannel("BENSINSTATION");
      });
Vi kontrollerade att kanalen inte finns. Tog en lås, kontrollerade igen, skapade. Om vi inte kontrollerar efter att vi har tagit låsen finns det en risk att en annan tråd också kontrollerade och nu försöker skapa samma diskussion - och den finns redan. Det går inte att låsa med synchronized eller vanliga java Lock. Genom databasen - långsamt, och det är synd om databasen, genom Hazelcast - precis vad vi behöver.
Väljer databashanterare
Vi har stor och framgångsrik erfarenhet av att arbeta med PostgreSQL och samarbeta med utvecklarna av denna databas.
Att arbeta med kluster i PostgreSQL är inte enkelt - det finns , , , men i allmänhet är detta inte noSQL, som skalar ur lådan. Vi övervägde inte NoSQL som huvudsaklig lagring, vi har redan beslutat att använda Hazelcast, som vi inte arbetat med tidigare.
Eftersom vi behöver skala den relationella databasen - innebär det . Som ni vet delar vi upp databasen i separata delar så att varje del kan flyttas till en separat server.
Det första alternativet för vår sharding förutsatte att vi skulle kunna sprida varje tabell i vår applikation över olika servrar i olika proportioner. Mycket information på server A - låt oss flytta en del av denna tabell till server B. Denna lösning skrek verkligen av för tidig optimering, så vi beslutade att hålla oss till en multi-tenant-ansats.
För att läsa om multi-tenant kan man till exempel besöka webbplatsen .
I SV finns begreppen applikation och abonnent. En applikation är en specifik installation av ett affärsprogram, till exempel ERP eller Redovisning, med sina användare och affärsdata. En abonnent är en organisation eller en fysisk person som registrerar applikationen på SV-servern. En abonnent kan ha flera registrerade applikationer, och dessa applikationer kan utbyta meddelanden med varandra. Abonnenten har blivit en hyresgäst (tenant) i vårt system. Meddelanden från flera abonnenter kan finnas i en och samma fysiska databas; om vi ser att en abonnent genererar mycket trafik flyttar vi denne till en separat fysisk databas (eller till och med en separat databasserver).
Vi har en huvuddatabas som lagrar en routingtabell med information om platsen för alla abonnentdatabaser.
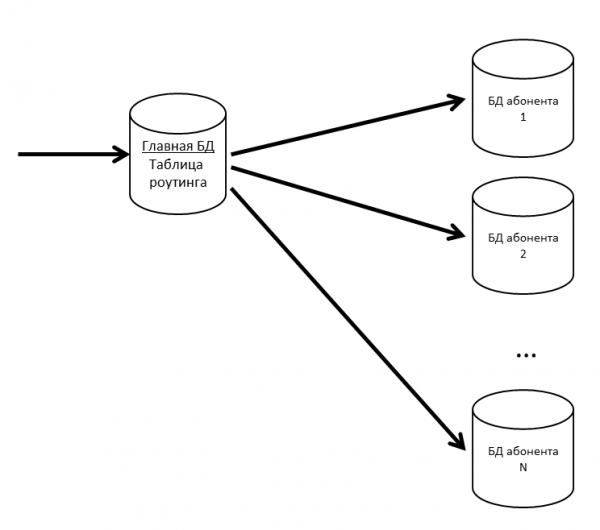
För att huvuddatabasen inte ska bli en flaskhals håller vi routingtabellen (och andra ofta efterfrågade data) i cache.
Om abonnentens databas börjar gå långsamt kommer vi att dela upp den i partitioner. För partitionering av stora tabeller i andra projekt använder vi .
Eftersom det är oacceptabelt att förlora användarmeddelanden, upprätthåller vi våra databaser med repliker. Kombinationen av synkrona och asynkrona repliker gör att vi kan skydda oss mot förlust av huvuddatabasen. Förlust av meddelanden inträffar endast vid samtidig fel på huvuddatabasen och dess synkrona replik.
Om den synkrona repliken förloras blir den asynkrona repliken synkron.
Om huvuddatabasen förloras blir den synkrona repliken huvuddatabas, och den asynkrona repliken blir synkron replik.
Elasticsearch för sökning
Eftersom SV, förutom andra saker, också är en meddelandeplattform, behövs en snabb, användarvänlig och flexibel sökning som tar hänsyn till morfologi och ofullständiga matchningar. Vi beslutade oss för att inte uppfinna hjulet på nytt utan använde det fria söksystemet Elasticsearch, baserat på biblioteket . Vi distribuerar även Elasticsearch i en klusterkonfiguration (master – data – data) för att utesluta problem om applikationsnoder går ner.
På github hittade vi för Elasticsearch och använder det. I Elasticsearch-indexet lagrar vi rotord (som definieras av pluginet) och N-gram. När användaren skriver in text för sökning letar vi efter den skrivna texten bland N-gram. När vi sparar ordet "texter" bryts det ner i följande N-gram:
[de, tek, teks, text, texter, ek, eks, ekst, ekst-, k, kst, ksty, st, sty, ty],
Och även roten av ordet "text" kommer att sparas. Denna metod gör det möjligt att söka från början, mitt i och i slutet av ord.
Övergripande bild
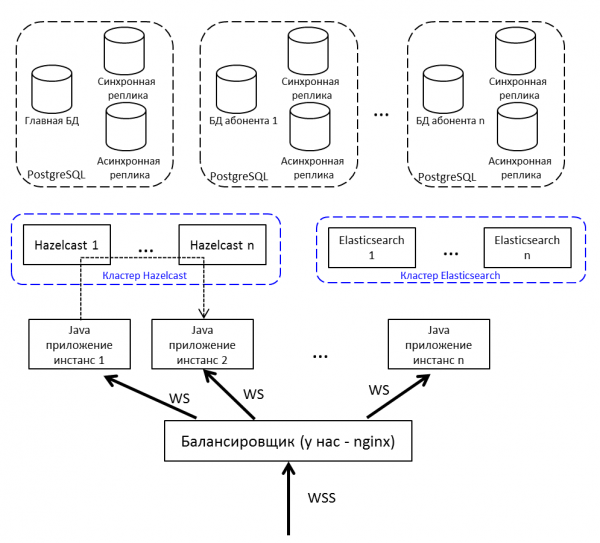
Upprepning av bilden från början av artikeln, men med förklaringar:
- Lastbalanseraren, som är ställd i internet; hos oss – nginx, kan vara vilken som helst.
- Instanser av Java-applikationen kommunicerar med varandra via Hazelcast.
- För arbete med webbsocket använder vi .
- Java-applikationen är skriven i Java 8, består av paket . Planen är att migrera till Java 10 och gå över till moduler.
Utveckling och testning
Under utvecklings- och testprocessen av DB stötte vi på flera intressanta funktioner av produkterna som vi använde.
Belastningstestning och minnesläckor
Utgivning av varje version av DB inkluderar belastningstestning. Det har genomförts framgångsrikt när:
- Testet kördes i flera dagar utan serviceavbrott
- Svars-tiden för nyckeloperationer översteg inte den bekväma gränsen
- Prestandaförsämringen i förhållande till föregående version är högst 10%
Vi fyller testbasen med data – för detta får vi från produktionsservern information om den mest aktiva abonnenten, multiplicerar deras siffror med 5 (antal meddelanden, diskussioner, användare) och testar så.
Belastningstestning av interaktionssystemet utför vi i tre konfigurationer:
- Stress-test
- Endast anslutningar
- Registrering av abonnenter
Vid stress-testet startar vi flera hundra trådar som utan avbrott belastar systemet: skriver meddelanden, skapar diskussioner, får listan över meddelanden. Vi simulerar agerandet av vanliga användare (få min olästa meddelandelista, skriva till någon) och programlösningar (överföra ett paket med en annan konfiguration, behandla en avisering).
Till exempel ser en del av stress-testet ut så här:
- En användare loggar in i systemet
- Begär sina olästa diskussioner
- Med 50% sannolikhet läser meddelanden
- Med 50% sannolikhet skriver meddelanden
- Därefter användaren:
- Skapar en ny diskussion med 20% sannolikhet
- Väljer slumpmässigt ett av sina diskussioner
- Går in
- Begär meddelanden, användarprofiler
- Skapar fem meddelanden riktade till slumpmässiga användare i denna diskussion
- Lämnar diskussionen
- Upprepar 20 gånger
- Loggar ut och återvänder till början av scenariot
- En chattbot loggar in i systemet (emulerar meddelandeutbyte från applikationslösningens kod)
- Skapar en ny kanal för datakommunikation med 50% sannolikhet (specialdiskussion)
- Skriver ett meddelande i vilken som helst av de befintliga kanalerna med 50% sannolikhet
Scenariot "Bara anslutningar" dök inte upp av en slump. Det finns situationer: användare har anslutit systemet, men har inte kommit igång. Varje användare sätter på sin dator klockan 09:00 på morgonen, ansluter till servern och är tyst. Dessa personer är farliga, de är många – i paketen finns bara PING/PONG, men de håller anslutningen till servern (de kan inte släppa den – vad händer om det kommer ett nytt meddelande). Testet reproducerar en situation där ett stort antal sådana användare försöker logga in i systemet inom en halvtimme. Det liknar ett stresstest, men fokuset ligger på just det första inloggningen – för att unvika avvisningar (personen använder inte systemet, men det släpper redan – svårt att tänka på något värre).
Scenariot för registrering av abonnenter börjar med den första starten. Vi genomförde ett stresstest och var säkra på att systemet inte hängde i kommunikationen. Men användarna kom och registreringen började falla på grund av timeout. Vid registreringen använde vi , vilket är kopplat till systemets entropi. Servern hann inte samla tillräckligt med entropi och när den begärde en ny SecureRandom stannade den i flera sekunder. Det finns många sätt att lösa detta problem, till exempel: gå över till den mindre säkra /dev/urandom, installera ett särskilt kort som genererar entropi, generera slumpmässiga nummer i förväg och lagra i poolen. Vi stängde tillfälligt problemet med en pool, men har sedan dess kört ett separat test för registrering av nya abonnenter.
Som belastningsgenerator använder vi . Det kan inte arbeta med WebSocket, en plugin behövs. Första sökresultatet på "jmeter websocket" är , där de rekommenderar .
Det var där vi bestämde oss för att börja.
Nästan direkt efter att vi började med seriös testning upptäckte vi att det började förekomma minnesläckor i JMeter.
Pluginet är en stor historia i sig, med 176 stjärnor har det 132 fork på github. Själv författaren har inte committat i det sedan 2015 (vi tog det år 2015, då väckte det ingen misstanke), några github-ärenden angående minnesläckor, 7 öppna pull requests.
Om ni beslutar er för att köra belastningstestning med detta plugin, var uppmärksamma på följande diskussioner:
- I en flertrådad miljö användes en vanlig LinkedList, vilket resulterade i i runtime. Detta löses antingen genom att byta till ConcurrentLinkedDeque eller med synchronized-block. Vi valde den första varianten ().
- Minnesläcka, vid frånkoppling raderas inte information om anslutningen ().
- I streamingläge (när websocket inte stängs i slutet av provet utan används vidare i planen) fungerar inte Response-mönster ().
Detta är från de som finns på github. Vad vi gjorde:
- Vi tog (@elyrank) – den har fixat problem 1 och 3
- Vi löste problem 2
- Uppdaterade jetty från 9.2.14 till 9.3.12
- Vi omsvepte SimpleDateFormat i ThreadLocal; SimpleDateFormat är inte trådsäker, vilket ledde till NPE i runtime.
- Vi åtgärdade ytterligare en minnesläcka (anslutningen stängdes inte korrekt vid frånkoppling)
Och ändå läcker den!
Minnet tog slut inte på en dag utan på två. Det fanns inte tid kvar, så vi beslutade att köra färre trådar, men på fyra agenter. Det borde ha räckt, åtminstone, en vecka.
Två dagar har gått...
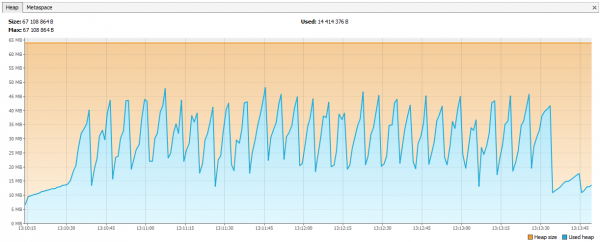
Nu började minnet ta slut hos Hazelcast. I loggarna syntes det att efter ett par dagars testning började Hazelcast klaga på brist på minne, och en stund senare kollapsade klustret, och noder fortsatte att dö en och en. Vi kopplade JVisualVM till hazelcast och såg en "uppåtgående såg" – den kallade regelbundet GC men kunde inte frigöra minnet.
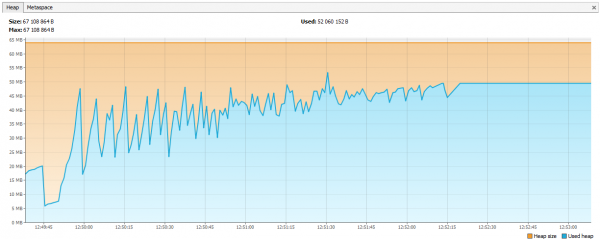
Det visade sig att i hazelcast 3.4 frigörs inte minnet helt vid borttagning av map / multiMap (map.destroy()):
Nu är felet åtgärdat i 3.5, men då var det ett problem. Vi skapade nya multiMap med dynamiska namn och tog bort dem enligt vår logik. Koden såg ungefär ut så här:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Anrop:
service.join(auth1, "NÄRMARE_MEDDELANDEN_I_DISKUSSION_UUID1");
service.join(auth2, "NÄRMARE_MEDDELANDEN_I_DISKUSSION_UUID1");
multiMap skapades för varje prenumeration och togs bort när den inte längre behövdes. Vi beslutade att skapa en Map, där nyckeln skulle vara prenumerationens namn, och som värden identifieringarna av sessionerna (som man senare kan få användaridentifieringar för, om det behövs).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
Diagrammen har jämnats ut.
Vad mer har vi lärt oss om belastningstestning
- JSR223 bör skrivas i groovy och ha inkluderad kompileringscache – det är mycket snabbare. .
- Jmeter-Plugins-diagram är enklare att förstå än standarddiagram. .
Om vår erfarenhet med Hazelcast
Hazelcast var en ny produkt för oss, vi började arbeta med den från version 3.4.1, nu kör vi version 3.9.2 på vår produktionsserver (vid tidpunkten för skrivandet var den senaste versionen av Hazelcast – 3.10).
ID-generering
Vi började med heltal som identifierare. Låt oss föreställa oss att vi behöver ytterligare en Long för en ny entitet. En sekvens i databasen är inte lämplig, tabellerna deltar i sharding – det skulle innebära att det finns ett meddelande ID=1 i DB1 och ett meddelande ID=1 i DB2; i Elasticsearch kan man inte placera det baserat på ett sådant ID, inte heller i Hazelcast, men det värsta av allt är om du vill kombinera data från två databaser till en (till exempel bestämmer att en databas är tillräcklig för dessa abonnenter). Man kan ha flera AtomicLong i Hazelcast och hålla räkningen där, då blir prestandan för att hämta ett nytt ID – incrementAndGet plus tiden för anropet till Hazelcast. Men det finns något mer optimalt i Hazelcast – FlakeIdGenerator. Vid varje klientanrop tilldelas ett ID-intervall, till exempel det första – från 1 till 10 000, den andra – från 10 001 till 20 000 och så vidare. Nu kan klienten själv tilldela nya identifierare, så länge intervallet som tilldelats honom inte tar slut. Det fungerar snabbt, men vid omstart av applikationen (och Hazelcast-klienten) börjar den en ny sekvens – vilket resulterar i hopp och sådant. Dessutom är det inte helt klart för utvecklarna varför identifierarna är heltal men sprids så mycket. Vi har vägt fördelarna och övergått till UUID:er.
Förresten, för dem som vill vara som Twitter, finns det ett bibliotek som heter Snowcast – det är en implementation av Snowflake ovanpå Hazelcast. Du kan kolla på det här:
Men vi har inte haft tid att ta oss an det än.
TransactionalMap.replace
En annan överraskning: TransactionalMap.replace fungerar inte. Här är ett test:
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Förväntat: newValue
Aktuellt: oldValue
Vi var tvungna att skriva vår egen replace, använda getForUpdate:
protected  boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Ersätter värde i en transaktionell karta");
        TransactionalMap map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Ersätter värde i en icke-transaktionell karta");
    IMap map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Testa inte bara vanliga datatyper, utan också deras transaktionella versioner. Ibland fungerar IMap, men TransactionalMap gör det inte.
Lägg till en ny JAR utan driftstopp
Först beslutade vi att spara våra klassobjekt i Hazelcast. Till exempel har vi en klass Application, vi vill spara och läsa den. Vi sparar:
IMap map = hazelcastInstance.getMap("application");
map.set(id, application);
Vi läser:
IMap map = hazelcastInstance.getMap("application");
return map.get(id);
Allt fungerar. Sedan beslutade vi att bygga ett index i Hazelcast för att söka efter det:
map.addIndex("subscriberId", false);Och när vi skrev en ny enhet började vi få ClassNotFoundException. Hazelcast försökte uppdatera indexet, men visste ingenting om vår klass och ville att vi skulle lägga till en JAR med den klassen. Så vi gjorde det, allt fungerade, men ett nytt problem uppstod: hur uppdaterar man JAR-filen utan att helt stoppa klustret? Hazelcast fångar inte den nya JAR-filen vid uppdatering av noden. Vid det här laget beslutade vi att vi kan klara oss utan sökning via index. Om man använder Hazelcast som en lagring av nyckel-värde-typ, borde allt fungera, eller hur? Inte riktigt. Här är beteendet olika för IMap och TransactionalMap. Där där IMap är likgiltig, kastar TransactionalMap ett fel.
IMap. Vi registrerar 5000 objekt och läser dem. Allt fungerar som förväntat.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
Men i transaktionen fungerar det inte, vi får ClassNotFoundException:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
I version 3.8 introducerades mekanismen User Class Deployment. Du kan utse en huvudnod och uppdatera JAR-filen på den.
Just nu har vi helt bytt tillvägagångssätt: vi serialiserar själva till JSON och sparar i Hazelcast. Hazelcast behöver inte veta strukturen på våra klasser, och vi kan uppdatera utan nedtid. Versionshanteringen av domänobjekten hanteras av applikationen. Olika versioner av applikationen kan köras samtidigt och det är möjligt att den nya applikationen skriver objekt med nya fält, medan den gamla fortfarande inte känner till dessa fält. Samtidigt läser den nya applikationen objekt skrivna av den gamla applikationen, där de nya fälten saknas. Sådana situationer hanteras internt av applikationen, men för enkelhetens skull ändrar och tar vi inte bort fält, utan utökar klasser genom att lägga till nya fält.
Hur vi säkerställer hög prestanda
Fyra anrop till Hazelcast – bra, två till DB – dåligt
Att hämta data från cachen är alltid bättre än från databasen, men det känns inte bra att lagra oanvända poster. Beslutet om vad vi ska cacha skjuter vi upp till den sista utvecklingsfasen. När den nya funktionen är kodad aktiverar vi loggning av alla förfrågningar i PostgreSQL (log_min_duration_statement på 0) och startar belastningstestning i cirka 20 minuter. Med de insamlade loggarna kan verktyg som pgFouine och pgBadger generera analytiska rapporter. I rapporterna letar vi främst efter långsamma och frekventa förfrågningar. För långsamma förfrågningar bygger vi en exekveringsplan (EXPLAIN) och bedömer om förfrågan kan snabba upp. Frekventa förfrågningar med samma ingångsdata passar bra i cachen. Vi försöker hålla förfrågningarna "platta", en tabell per förfrågan.
Drift
SV som en online-tjänst lanserades i drift våren 2017, och som en separat produkt släpptes SV i november 2017 (då i beta-version).
Under mer än ett års drift har det inte förekommit några allvarliga problem med online-tjänsten SV. Vi övervakar online-tjänsten genom , samlar in och distribuerar från .
Serverdistributionen av SV levereras i form av inbyggda paket: RPM, DEB, MSI. Dessutom erbjuder vi för Windows en enskild installerare i form av en EXE som installerar servern, Hazelcast och Elasticsearch på en och samma maskin. Vi kallade först denna installationsversion "demonstration", men nu har det visat sig att detta är det mest populära sättet att distribuera.
Källa: habr.com
