

Vi har utvecklat en design för datacenter-nätverk som möjliggör distribution av datorkluster med mer än 100 000 servrar och en maximal bisection bandwidth över en petabyte per sekund.
I Dmitrij Afanasjevs presentation lär du dig om de grundläggande principerna för den nya designen, skalning av topologier, problemen som uppstår, lösningsalternativ, samt om egenskaperna för routing och skalning av forwarding plane-funktioner i moderna nätverksenheter i tätt kopplade topologier med många ECMP-rutter. Dessutom berättade Dima kort om organisationen av extern konnektivitet, den fysiska nivån, kabelsystemet och sätt att ytterligare öka kapaciteten.
— Hej alla! Jag heter Dmitrij Afanasjev, jag är nätverksarkitekt på Yandex och arbetar främst med design av datacenter-nätverk.
Min presentation handlar om det uppdaterade datacenter-nätverket på Yandex. Det är i stor utsträckning en evolution av den design vi hade, men samtidigt finns det också några nya element. Detta är en översiktlig presentation, eftersom vi behövde komprimera mycket information på kort tid. Vi börjar med valet av logisk topologi. Sedan kommer vi att ge en översikt av control plane och problem med skalbarhet i data plane, valet av vad som kommer att hända på den fysiska nivån, och vi kommer att titta på några egenskaper hos enheterna. Vi berör också vad som händer i datacentret med MPLS, som vi talade om för en tid sedan.
Så vad är Yandex ur belastningar och tjänsters perspektiv? Yandex är en typisk hyperskalare. Sett ur användarnas perspektiv handlar det först och främst om behandling av användarförfrågningar. Det handlar också om olika streaming-tjänster och dataleveranser, eftersom vi också har lagringstjänster. Om vi ser närmare på backend så uppstår infrastrukturella belastningar och tjänster, såsom distribuerade objektlagringssystem, datareplikering och givetvis persistenta köer. En av de huvudsakliga typerna av belastningar är MapReduce och liknande system, strömmande bearbetning, maskininlärning, osv.
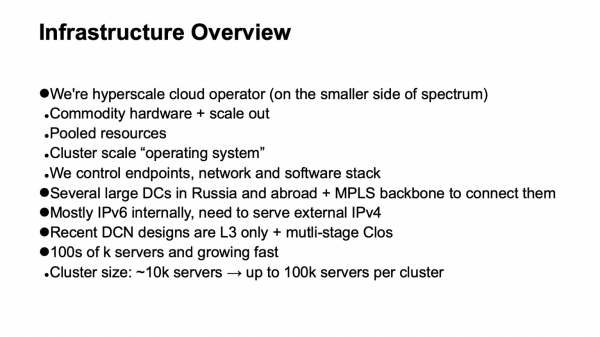
Hur är infrastrukturen uppbyggd där allt detta sker? Återigen, vi är en ganska typisk hyperscaler, även om vi kanske ligger lite närmare den sida av spektrumet där de mindre hyperscalerna finns. Men vi har alla attribut. Vi använder standardhårdvara och horisontell skalning överallt där det är möjligt. Vi har en fullt utvecklad resurspoolering: vi arbetar inte med separata maskiner eller rack, utan slår samman dem till en stor pool av utbytbara resurser med några ytterligare tjänster som hanterar planering och allokering, och arbetar med hela denna pool.
Så vi får nästa nivå – operativsystem på kluster-nivå. Det är mycket viktigt att vi helt kontrollerar teknikstacken som används. Vi kontrollerar ändpunkterna (värdarna), nätverket och programvarustacken.
Vi har flera stora datacenter i Ryssland och utomlands. Dessa förenas av en backbone som använder MPLS-teknologi. V vår interna infrastruktur är nästan helt uppbyggd på IPv6, men eftersom vi behöver hantera extern trafik som fortfarande huvudsakligen kommer in via IPv4, måste vi på något sätt leverera förfrågningar som kommer via IPv4 till frontend-servrar, och gå lite ut i den externa IPv4-internettet – till exempel för indexering.
De senaste iterationerna av datacenter-nätverksdesign använder flerlagers Clos-topologier, och endast L3 tillämpas. Vi övergick från L2 för en tid sedan och suckade av lättnad. Slutligen inkluderar vår infrastruktur hundratusentals beräkningsinstanser (servrar). Den maximala storleken på klustret var för en tid sedan cirka 10 000 servrar. Detta beror till stor del på hur dessa operativsystem på klusternivå kan fungera, schemaläggare, resursallokering osv. Eftersom det har skett framsteg på sidan av infrastrukturprogramvaran, är det nu målet att ha en storlek på cirka 100 000 servrar i ett beräkningskluster, och vi har fått i uppgift att kunna bygga nätverksfabriker som effektivt möjliggör resurspooling i ett sådant kluster.
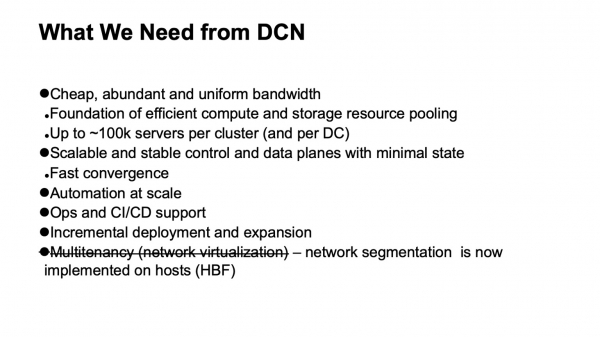
Vad vill vi egentligen ha från datacenterets nätverk? Först och främst — mycket billig och hyfsat jämt fördelad bandbredd. För nätverket är det grunden som gör att vi kan poola resurser. Den nya målstorleken är omkring 100 000 servrar i ett kluster.
Vi vill självklart ha en skalbar och stabil kontrollplan, eftersom det på en så stor infrastruktur uppstår mycket huvudbry även från bara slumpmässiga händelser, och vi vill inte ha ytterligare huvudbry från kontrollplanet. Samtidigt vill vi minimera tillståndet i det. Ju mindre tillstånd, desto bättre och stabilare fungerar allt och enklare att diagnostisera.
Självklart behöver vi automatisering, eftersom det är omöjligt att manuellt hantera en sådan infrastruktur, och det har varit omöjligt under en tid nu. Vi behöver så mycket som möjligt stöd för drift och CI/CD-support, i den mån det kan tillhandahållas.
Vid sådana storlekar på datacenter och kluster uppstår det ett skarpt behov av att stödja inkrementell distribution och utvidgning utan avbrott i tjänsten. Om man på kluster med tusen maskiner, kanske nära tiotusen maskiner, fortfarande kan rulla ut som en operation — det vill säga vi planerar att utöka infrastrukturen och några tusen maskiner läggs till som en operation — så uppstår inte klustret med hundratusen maskiner omedelbart, utan det byggs upp över tid. Det är önskvärt att under hela denna tid är den redan distribuerade infrastrukturen tillgänglig.
Och ett krav som vi hade och har avskaffat: det är stöd för multitenancy, det vill säga virtualisering eller segmentering av nätverket. Nu behöver vi inte göra detta på nivån av nätverksfabriken, eftersom segmenteringen har flyttat till värdarna, vilket har förenklat vår skalning. Tack vare IPv6 och det stora adressutrymmet behövde vi inte använda dubbletteradresser i den interna infrastrukturen, hela adresseringen var redan unik. Och eftersom vi har flyttat filtreringen och nätverkssegmenteringen till värdarna behöver vi inte skapa några virtuella nätverksentiteter i datacenterens nätverk.
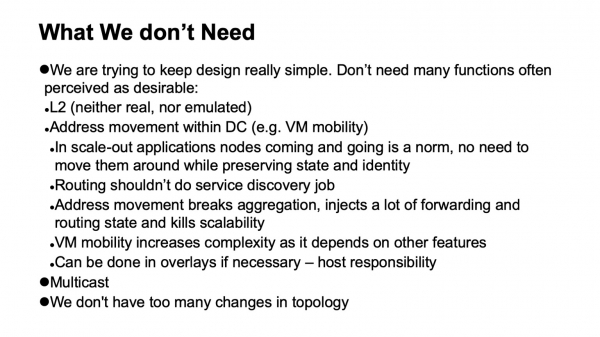
En mycket viktig sak är att det finns saker vi inte behöver. Om några funktioner kan tas bort från nätverket underlättar det livet avsevärt, och det utökar i allmänhet valet av tillgänglig utrustning och mjukvara, vilket förenklar diagnostik avsevärt.
Så vad är det vi inte behöver, vad har vi kunnat avstå från, inte alltid med glädje i stunden, men med stor lättnad när processen var över?
Först och främst avståendet från L2. Vi behöver varken verklig eller emulerad L2. Det används i betydande grad tack vare att vi kontrollerar applikationsstacken. Våra applikationer skalas horisontellt, de arbetar med L3-adressering och de oroar sig inte så mycket för att enskilda instanser går ner, utan bara släpper ut nya; de behöver inte distribueras på den gamla adressen eftersom det finns en separat nivå för serviceupptäckte och övervakning av maskiner i klustret. Vi lägger inte den uppgiften på nätverket. Nätverkets uppgift är att leverera paket från punkt A till punkt B.
Vi har inte heller situationer där adresser flyttas inom nätverket, och detta behöver spåras. I många designer är det vanligtvis nödvändigt för att stödja VM-mobilitet. Vi använder inte mobilitet för virtuella maskiner i den interna infrastrukturen av stora Yandex, och dessutom anser vi att även om det görs, så bör det inte ske med nätverksstöd. Om det verkligen är nödvändigt, måste det göras på värdnivå, och adresser som kan migrera bör sättas i overlays för att inte störa och göra för många dynamiska ändringar i routing-systemet för själva underlaget (transportnätet).
Ytterligare en teknik som vi inte använder är multicast. Jag kan gärna förklara varför. Det underlättar livet avsevärt eftersom om någon har arbetat med det och sett hur kontrollplanet för multicast ser ut - i alla installationer, förutom de enklaste, är det en stor huvudvärk. Dessutom är det svårt att hitta en väl fungerande öppen implementering, till exempel.
Och slutligen designar vi våra nätverk så att det inte sker för många förändringar. Vi kan förvänta oss att flödet av externa händelser i routing-systemet är lågt.
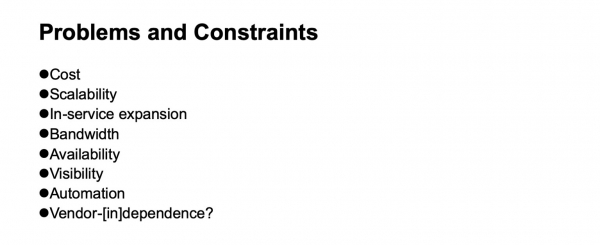
Vilka problem och begränsningar måste vi ta hänsyn till när vi utvecklar ett datacenter? Kostnaden, självklart. Skalbarheten, till vilken nivå vi vill växa. Behovet av att expandera utan att stoppa tjänsten. Bandbredd, tillgänglighet. Synlighet över vad som händer i nätverket, för övervakningssystem och driftteam. Stöd för automatisering — återigen, i den mån det är möjligt, eftersom olika uppgifter kan hanteras på olika nivåer, inklusive införande av ytterligare lager. Och oberoende från leverantörer — även om detta oberoende har varit lättare eller svårare att uppnå beroende på historiska perioder och vilket perspektiv man har. Om vi tar en skärning av chip i nätverksenheter, så kan man fram till nyligen ganska villkorligt tala om oberoende från leverantörer, om vi ville ha chip med hög bandbredd.
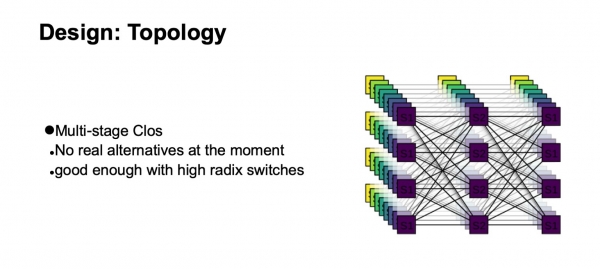
Vilken logisk topologi ska vi bygga vårt nätverk på? Det kommer att vara en flerlagers Clos. Faktum är att det för tillfället inte finns några verkliga alternativ. Och Clos-topologin är tillräckligt bra, även när man jämför den med olika avancerade topologier som för tillfället ligger mer inom akademiskt intresse, om vi har switchar med stora radix.
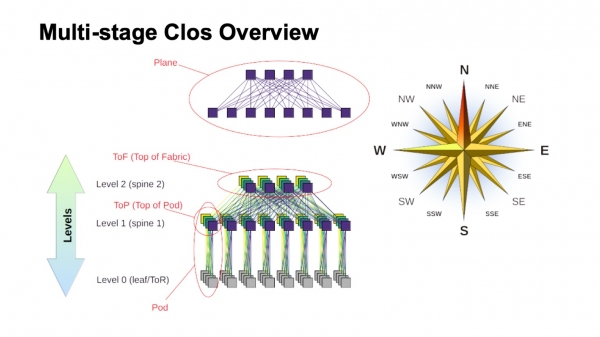
Hur fungerar en flerlagers Clos-nätverk ungefär, och hur kallas de olika elementen i det? Först och främst en vindros för att orientera sig, var norr är, var söder, öst och väst. Nätverk av den här typen byggs vanligtvis av dem som har en väldigt stor trafik öst-väst. När det gäller de andra elementen, så visas högst upp en virtuell switch, konstruerad av mindre switchar. Detta är huvudidén bakom den rekursiva konstruktionen av Clos-nätverk. Vi tar element med en viss radix och kopplar dem så att det vi får kan ses som en switch med en större radix. Om det behövs ännu mer kan processen upprepas.
I faller som med två nivåers Clos, när man tydligt kan särskilja komponenter som i min skiss är vertikala, kallas de plattor. Skulle vi bygga ett Clos med tre nivåer av spinnsvitchar (alla som inte är gränsvitchar och inte ToR-svitchar, och som endast används för transit), skulle plattorna se mer komplexa ut, de med två nivåer ser ut så här. Blocket med ToR- eller leaf-svitchar och de associerade första nivån spinnsvitchar kallade vi Pod. Spinnsvitcharna på spinn-1-nivå högst upp i Pod kallas top of Pod, toppen av Pod. Svitcharna som ligger högst upp i hela fabriken är det översta lagret av fabriken, Top of fabric.
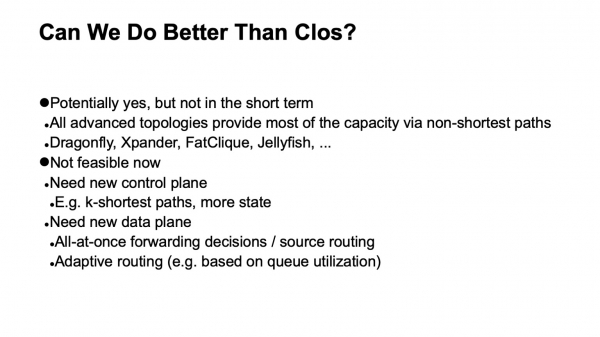
Självklart uppstår frågan: Clos-nät har byggts under en tid, själva idén kommer överhuvudtaget från klassisk telefoni, TDM-nät. Kan det ha kommit något bättre, kan det göras bättre? Ja och nej. Teoretiskt ja, på praktiken kommer det troligen inte att vara möjligt inom den närmaste tiden. Eftersom det finns ett antal intressanta topologier, varav vissa till och med används i produktion, till exempel används Dragonfly i HPC-applikationer; det finns också intressanta topologier som Xpander, FatClique, Jellyfish. Om man tittar på föreläsningar på konferenser som SIGCOMM eller NSDI på sistone kan man upptäcka ett ganska stort antal arbeten om alternativa topologier som har bättre egenskaper (av olika slag) än Clos.
Men alla dessa topologier har en intressant egenskap. Det förhindrar deras implementering i datacenter nätverk som vi försöker bygga på commodity-hårdvara och som kostar ganska rimliga pengar. I alla dessa alternativa topologier är tyvärr den största delen av bandbredden inte tillgänglig via de kortaste vägarna. Därför förlorar vi omedelbart möjligheten att använda traditionell kontrollplan.
Teoretiskt är lösningen på problemet känd. Det är exempelvis modifieringar av link state med användning av k-shortest path, men å andra sidan finns det inga sådana protokoll som har implementerats i produktion och som är allmänt tillgängliga på utrustning.
Dessutom, eftersom merparten av kapaciteten inte är tillgänglig genom de kortaste vägarna, behöver vi modifiera inte bara kontrollplanet för att välja alla dessa vägar (och, för att vara tydlig, det är en betydligt större belastning på kontrollplanet). Vi måste också modifiera vidarebefordringsplanet, och vanligtvis krävs minst två ytterligare funktioner. Detta inkluderar möjligheten att fatta alla beslut om vidarebefordran av paket på en gång, till exempel på hosten. Faktiskt är detta källrouting, som i litteraturen om sammankopplingsnät ibland kallas beslut om vidarebefordran all-at-once. Den andra funktionen är adaptiv routing — det är en funktion vi behöver på nätverkselementen, vilket innebär att vi väljer nästa hopp baserat på information om den lägsta köbelastningen. Det kan också finnas andra alternativ.
Således är riktningen intressant, men tyvärr kan vi inte tillämpa det just nu.
Okej, vi stannade vid den logiska Clos-topologin. Hur ska vi skala den? Låt oss titta på hur den är uppbyggd och vad vi kan göra.
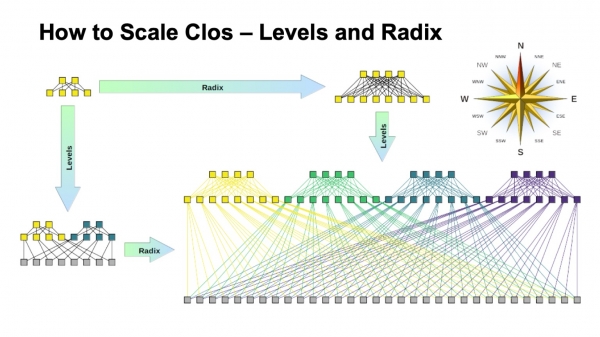
I Clos-nätverket finns det två huvudparametrar som vi kan variera och få olika resultat: radikalisering av elementen och antalet nivåer i nätverket. Jag har skissat hur båda påverkar storleken. Idealt kombinerar vi båda.
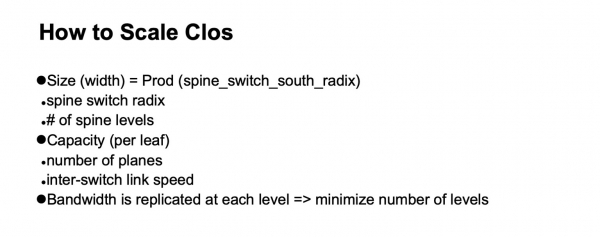
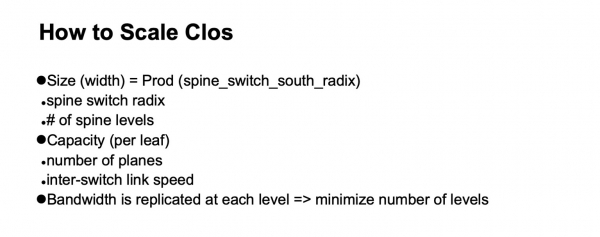
Det är tydligt att den slutliga bredden på Clos-nätverket är produkten av alla nivåer av spine-switchen i den södra radikalen, d.v.s. hur många länkar vi har neråt och hur det förgrenas. Så här skalar vi nätverksstorleken.
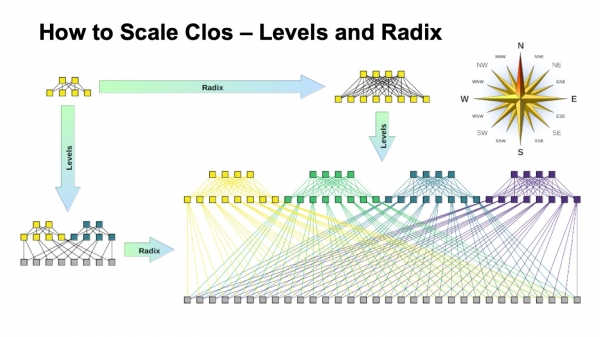
När det gäller kapaciteten, särskilt på ToR-switchar, finns det två skalningsalternativ. Antingen kan vi, utan att ändra den allmänna topologin, använda snabbare länkar, eller så kan vi lägga till fler plan.
Om vi ser på den utvidgade versionen av Clos-nätverket (i nedre högra hörnet) och går tillbaka till den här bilden av Clos-nätverket nedan...
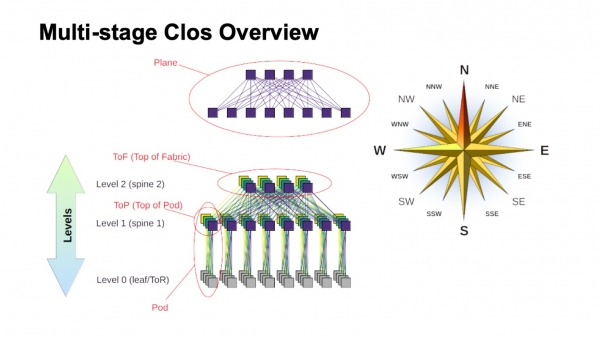
... så är det exakt samma topologi, men på denna bild har den komprimerats mer kompakt och fabrikplanen är staplade på varandra. Det är samma sak.
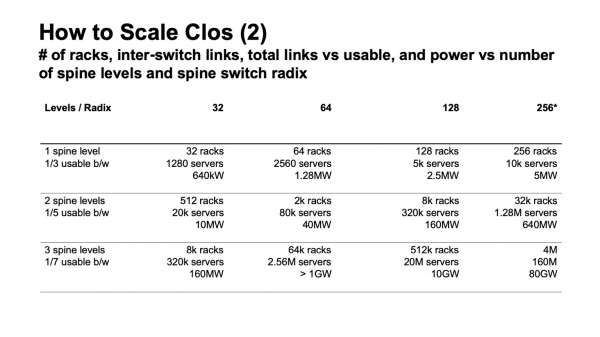
Hur ser skalningen av Clos-nätverket ut i siffror? Här ger jag data om vilken maximala bredd nätverket kan få, hur många rack, ToR-switchar eller leaf-switchar vi kan få beroende på vilket radikal av switchar som används för spine-nivåerna och hur många nivåer vi använder.
Här visas hur många rack vi kan ha, hur många servrar samt ungefär hur mycket de kan dra med beräkning av 20 kW per rack. Jag nämnde tidigare att vi siktar på en klusterstorlek av cirka 100 000 servrar.
Det är tydligt att det i hela denna konstruktion finns två och ett halvt intressanta alternativ. Det finns ett alternativ med två lager spine-switchar och 64-porters switchar, vilket är lite under det vi vill ha. Sedan finns det bra alternativ för 128-porters (med radix 128) spine-switchar med två nivåer, eller switchar med radix 32 med tre nivåer. I alla fall där vi har högre radix och fler nivåer kan vi skapa ett mycket stort nätverk, men om man ser på det förväntade konsumtionsbehovet handlar det vanligtvis om gigawatt. Vi kan lägga kablar, men så mycket elektricitet på en enskild plats kommer vi sällan att kunna få. Om man ser på statistiken, det offentliga datan om datacenter — det finns mycket få datacenter som har en beräknad kapacitet över 150 MW. Det som går över det — är vanligtvis datacenterkampus, flera större datacenter som ligger relativt nära varandra.
Det finns också en viktig parameter. Om ni tittar på den vänstra kolumnen, där anges användbar bandbredd. Det är inte svårt att se att en betydande del av portarna i en Clos-nätverksstruktur går till att koppla samman switcharna med varandra. Användbar bandbredd, det är den bandbredd som vi kan ge utåt, mot servrarna. Naturligtvis pratar jag om hypotetiska portar och just bandbredden. Vanligtvis är länkarna inom nätverket snabbare än länkarna mot servrarna, men per enhet av bandbredd, så mycket vi kan leverera utåt till vår serverutrustning, så finns det fortfarande ytterligare en del bandbredd inom själva nätverket. Ju fler nivåer vi gör, desto större blir de specifika kostnaderna för att tillhandahålla denna bandbredd utåt.
Dessutom är även denna extra bandbredd inte helt likadan. Så länge avstånden är korta kan vi använda något i stil med DAC (direct attach copper, det vill säga twinax-kablar) eller multimode-optik som fortfarande har rimliga priser. Så snart vi går över till längre sträckor — handlar det vanligtvis om single mode-optik, och kostnaden för denna extra bandbredd ökar avsevärt.
Och återigen, tillbaka till den föregående bilden, om vi skapar ett Clos-nät utan omteckning är det inte svårt att se diagrammet och hur nätverket byggs — genom att lägga till varje nivå av spine-switchar upprepar vi hela den bandbredd som fanns längst ner. Plus en nivå — plus hela den bandbredden, ytterligare lika mycket som fanns på den föregående nivån, portar på switcharna, ytterligare lika många transceivrar. Därför är det mycket önskvärt att minimera antalet nivåer av spine-switchar.
Utifrån denna bild är det tydligt att vi verkligen vill bygga på något som liknar switchar med radix 128.
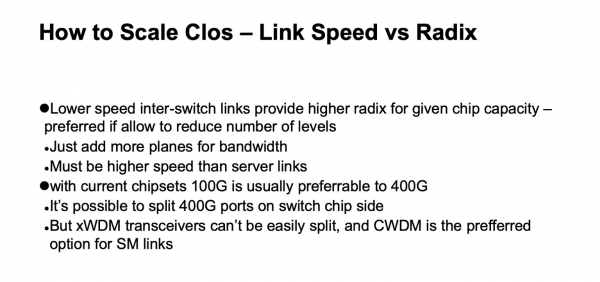
Här är i princip allt detsamma som jag just har berättat, detta bild är snarare för eftertänksamhet senare.
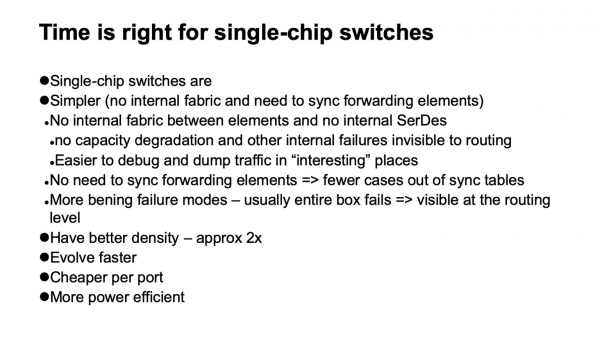
Vilka alternativ har vi för att välja sådana switchar? En mycket trevlig nyhet för oss är att sådana nät faktiskt nu kan byggas på enskaps-switchar. Och det är fantastiskt, de har en massa trevliga egenskaper. Till exempel har de nästan ingen inre struktur. Det betyder att de är enklare att bryta. De bryts, hurra för det, men bryts tyvärr helt och hållet. I modulära enheter finns en mängd fel (mycket otrevliga), när det från grannarna och kontrollplanet verkar fungera, men, till exempel, en del av fabriken har gått förlorad och det fungerar inte på full kapacitet. Och trafiken balanseras baserat på att den är helt funktionell, och vi kan få överbelastning.
Eller till exempel uppstår problem med backplane, eftersom det inom den modulära enheten också finns höghastighets SerDes — det är verkligen komplicerat inuti. Eller så synkroniseras eller synkroniseras inte tabellerna mellan forwarding-elementen. Generellt innehåller en vilket som helst produktivt modulärt enhet, som består av många element, inuti sig vanligtvis samma Clos-nät, men som är mycket svårt att diagnostisera. Ofta är det till och med svårt för leverantören att diagnostisera.
Och det finns många felscenarier där enheten degraderas men inte helt försvinner från topologin. Eftersom vi har ett stort nätverk, som aktivt använder lastbalansering mellan identiska enheter, är nätverket väldigt regelbundet, det vill säga en väg där allt fungerar inte skiljer sig på något sätt från en annan väg, är det mer fördelaktigt för oss att bara förlora en del av enheterna från topologin än att hamna i en situation där några av dem verkar fungera, men inte.
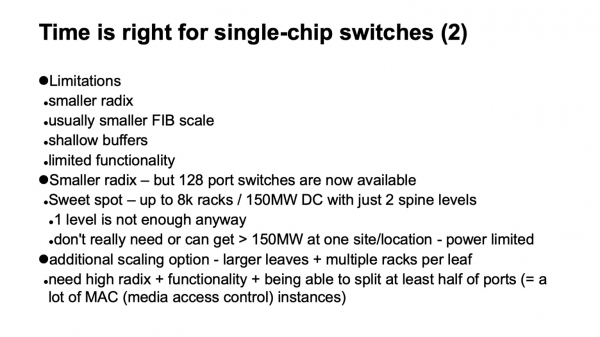
En annan trevlig funktion hos enchip-enheter är att de utvecklas bättre och snabbare. De har också vanligtvis bättre kapacitet. Om vi tar stora sammansatta konstruktioner som vi har, så blir kapaciteten per rack-enhet för portar med samma hastighet nästan dubbelt så bra som hos modulära enheter. Enheter som byggs runt en enda chip blir betydligt billigare än modulära och konsumerar mindre energi.
Men naturligtvis är det inte bara så enkelt, det finns nackdelar också. För det första har de nästan alltid en mindre radix än modulära enheter. Om vi kan få en enhet byggd runt ett chip med 128 portar, kan vi redan nu få modulära enheter med flera hundra portar utan några större problem.
Det är markant mindre storlek på forwarding-tabeller och som regel allt som rör skalbarhet i dataplans. Grunda buffertar. Och som regel ganska begränsad funktionalitet. Men det visar sig att om man känner till dessa begränsningar och ser till att kringgå dem eller helt enkelt tar hänsyn till dem i tid, så är det inte så farligt. Det faktum att radix är mindre, utgör inte längre ett problem med de nyligen framtagna enheterna med radix 128, vi kan bygga i två lager av spines. Och med mindre än två går det ändå inte att bygga något intressant i den storleken. Med ett lager får man alltid mycket små kluster. Även våra tidigare designer och krav översteg dem fortfarande.
I själva verket, om det finns någon tvekan om lösningen, finns det ett annat sätt att skala upp. Eftersom det sista (eller första), den lägsta nivå där servrar ansluts — ToR-switchar eller leaf-switchar, behöver vi inte ansluta en hel rack till dem. Därför, om lösningen faller kort med ungefär det dubbla, kan vi överväga att bara använda en switch med större radix på den lägsta nivån och ansluta, till exempel, två eller tre rack till en switch. Det är också ett alternativ, med sina egna kostnader, men det fungerar helt okej och kan visa sig vara en bra lösning när man behöver öka kapaciteten ungefär dubbelt.
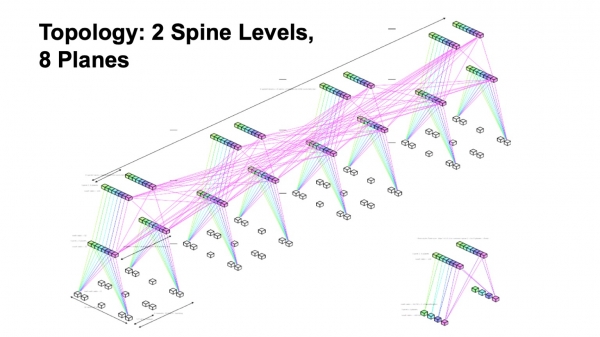
Sammanfattningsvis bygger vi med en topologi med två nivåer av spine-switchar och åtta lager av fabriker.
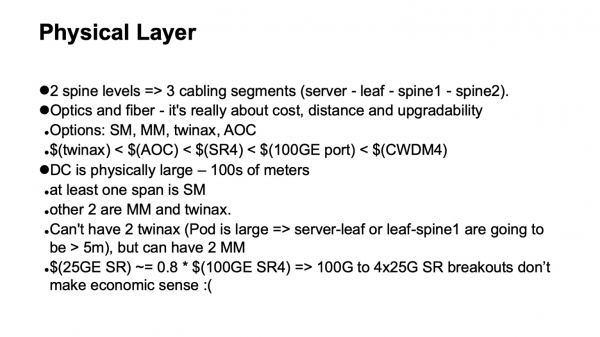
Vad händer då med fysiken? Mycket enkla beräkningar. Om vi har två nivåer av spine-switchar, innebär det att vi totalt har tre nivåer av switchar och vi förväntar oss att nätverket kommer att ha tre kabelsegment: från servrar till leaf-switchar, till spine 1, till spine 2. Alternativen vi kan använda är twinax, multimode, single mode. Här måste vi överväga vilken bandbredd som är tillgänglig, vad det kommer att kosta, vilka fysiska dimensioner, vilka spänningar vi kan gå igenom och hur vi kommer att uppgradera det.
När det gäller kostnader kan allt ordnas i en linje. Twinaxar är avsevärt billigare än aktiv optik, billigare än multimode-transceivrar, räknat per sträcka från slutet, något billigare än 100-gigabit switchportar. Och det, observera, kostar mindre än single mode optik, eftersom det i datahallar av olika skäl är meningsfullt att använda CWDM där single mode krävs, att arbeta med parallell single mode (PSM) är inte särskilt bekvämt, det blir mycket stora buntar av fiber, och om vi håller oss till dessa teknologier får vi ungefär en sådan prishierarki.
En ytterligare kommentar: tyvärr fungerar det inte så bra att använda uppdelade 100 till 4x25 multimode-portar. På grund av konstruktionsegenskaperna är SFP28 inte mycket billigare än QSFP28 för 100 Gbit. Och denna uppdelning fungerar inte särskilt bra för multimode.
En annan begränsning är att på grund av storleken på beräkningskluster, och antalet servrar, blir våra datacenter fysiskt stora. Det betyder att vi måste göra minst ett spänn med singlemode. Återigen, på grund av den fysiska storleken på Pods går det inte att använda två spänn med twinax (kopparkablar).
Således, om man optimerar utifrån kostnad och tar hänsyn till geometrin av denna konstruktion, får vi ett spänn med twinax, ett spänn med multimode och ett spänn med singlemode med användning av CWDM. Detta tar hänsyn till möjliga uppgraderingsvägar.
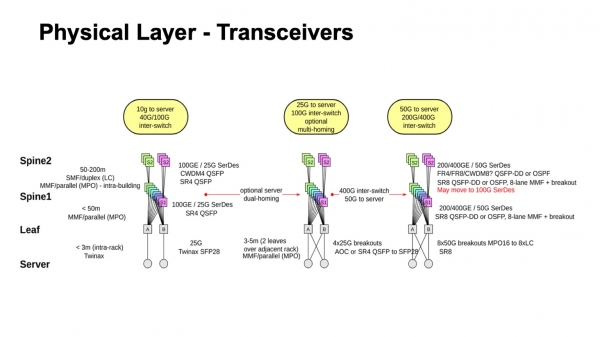
Det ser ungefär ut så här, vad som nyligen har varit, vart vi är på väg och vad som är möjligt. Det är klart, åtminstone hur vi ska gå mot 50-gigabitiga SerDes för både multimode och singlemode. Dessutom, om man ser på det som finns i singlemode-transceivrar nu och för framtiden för 400G, så kan det ibland hända att när 50G SerDes kommer in på den elektriska sidan, kan optiken redan hantera 100 Gbps per bana. Så det är mycket möjligt att istället för att gå till 50 kommer vi att gå till 100-gigabitiga SerDes och 100 Gbps per bana, eftersom många leverantörer förväntar sig att deras tillgänglighet ska komma ganska snart. Perioden när 50G SerDes var de snabbaste verkar inte bli särskilt lång, eftersom de första exemplaren av 100G SerDes nästan kommer nästa år. Och efter en tid efter detta kommer de förmodligen att kosta rimliga pengar.
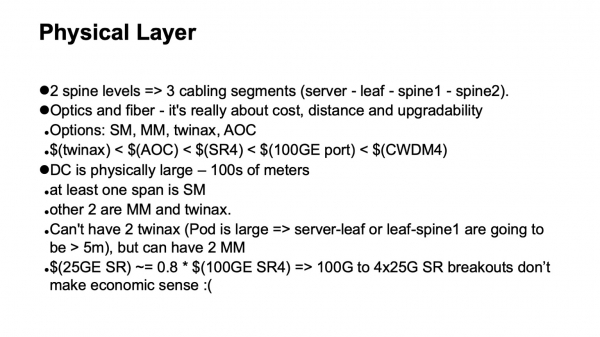
En annan aspekt när det gäller val av fysik. I princip kan vi redan nu använda 400- eller 200-gigabitiga portar med hjälp av 50G SerDes. Men det visar sig att det inte är särskilt meningsfullt, eftersom, som jag nämnt tidigare, vi vill ha en tillräckligt stor radix på switcharna, inom rimliga gränser, förstås. Vi vill ha 128. Om vi har begränsad kapacitet på chipet och ökar länkens hastighet, så minskar radix naturligtvis, det finns inga mirakel.
Och vi kan öka den totala kapaciteten genom att lägga till plan, och det finns inga särskilda kostnader, man kan öka antalet plan. Om vi förlorar radix måste vi införa en ytterligare nivå, så vid nuvarande beräkningar, med den maximala tillgängliga kapaciteten på ett chip, visar det sig att det är effektivare att använda 100-gigabitiga portar, eftersom de möjliggör en större radix.
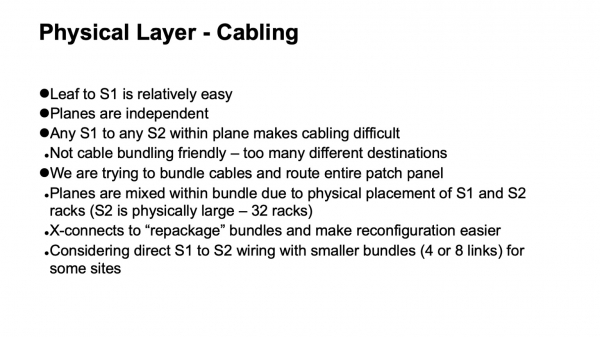
Nästa fråga handlar om hur fysiska strukturer är organiserade, men nu ur perspektivet av kabelinfrastruktur. Det visar sig att det är organiserat på ett ganska intressant sätt. Kabeldragning mellan leaf-switchar och spines för första nivån — där finns det inte så många länkar, det är ganska enkelt. Men om vi tar en plan, så vad som händer inuti — där måste alla spines för första nivån kopplas ihop med alla spines för andra nivån.
Dessutom finns det vanligtvis vissa önskemål om hur detta ska se ut inuti datacentret. Till exempel ville vi gärna samla kablar i buntar och dra dem på ett sådant sätt att en högdensitets patchpanel kopplades helt till en annan patchpanel, för att undvika en djungel av längder. Vi lyckades lösa denna uppgift. Om man ser på den logiska topologin från början, så kan man se att planen är oberoende, varje plan kan byggas för sig självt. Men när vi lägger till sådana buntningar och vill dra en hel patchpanel till en annan patchpanel, så måste vi blanda olika planer inom en och samma bunt och införa en mellanliggande struktur i form av optiska cross-connects, för att ompacka dem från hur de var monterade på ett segment, till hur de kommer att monteras på ett annat segment. Tack vare detta får vi en trevlig egenskap: all komplex switchning utanför racken. När vi behöver snurra något kraftigt, "vrida planerna" som det ibland kallas i Clos-nät, så koncentreras allt inom ett rack. Vi har ingen kraftigt splittrad switchning, även ner till individuella länkar, mellan racken.
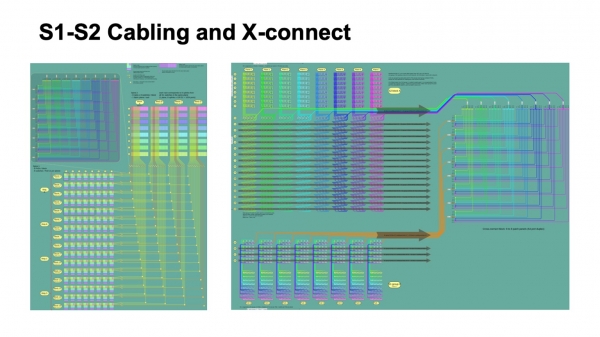
Så här ser det ut ur perspektivet av den logiska organisationen av kabelinfrastruktur. På bilden till vänster representerar de färgglada blocken block av spine-switchar för första nivån, åtta stycken, och fyra kabelfbundar som går från dem och korsar varandra med buntar som kommer från block av spine-2-switchar.
Små kvadrater indikerar korsningar. Överst till vänster ges en uppdelning av varje sådan korsning, det är faktiskt en modul för cross-connect med 512 på 512 portar, som paketerar kablar så att de kommer helt till en rack där endast en spine-2 yta finns. Och till höger är en något mer detaljerad uppdelning av denna bild relaterad till flera Pods på spine-1 nivå, och hur det packas i cross-connect, samt hur det kommer till spine-2 nivån.
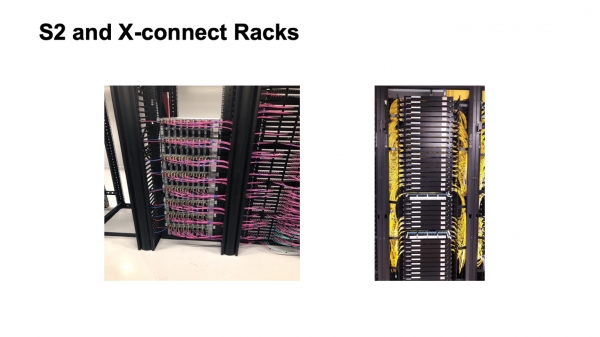
Så här ser det ut. En ännu inte helt sammansatt spine-2 rack (till vänster) och en cross-connect rack. Tyvärr syns det inte så mycket där. Hela denna konstruktion håller just nu på att sättas upp i ett av våra stora datacenter som expanderar. Detta är ett arbete under gång, det kommer att se bättre ut och vara mer fyllt.
En viktig fråga: vi valde en logisk topologi och byggde det fysiska. Vad händer med control plane? Det är ganska välkänt från driftserfarenhet att det finns ett antal yttranden om att link state protokoll är bra, de är bekväma att arbeta med, men tyvärr skalar de dåligt i en tätt kopplad topologi. Och det finns en huvudsaklig faktor som hindrar detta - hur flooding fungerar i link state protokoll. Om vi bara tar flooding-algoritmen och ser på hur vårt nätverk är uppbyggt, kan vi se att det kommer att bli en mycket stor fanout i varje steg, och det kommer helt enkelt att översvämma control plane med uppdateringar. Specifikt sådana topologier med den traditionella flooding-algoritmen i link state protokoll blandar sig mycket dåligt.
Valet - att använda BGP. Hur man korrekt preparerar det beskrivs i RFC 7938 om användning av BGP i stora datacentra. De grundläggande idéerna är enkla: minimalt antal prefix på en värd och överhuvudtaget minimalt antal prefix i nätverket, använda aggregation om möjligt, och dämpa path hunting. Vi vill ha en mycket försiktig, mycket kontrollerad spridning av uppdateringar, det som kallas valley free. Vi vill att uppdateringar, när de går genom nätverket, sprids exakt en gång. Om de härstammar från botten går de uppåt, de sprids inte mer än en gång. Det får inte finnas några zigzagg. Zigzaggar är mycket dåliga.
För att göra detta använder vi ett ganska enkelt schema för att använda grundläggande BGP-mekanismer. Det vill säga att vi har eBGP som fungerar på länk-lokal, och autonoma system tilldelas på följande sätt: autonomt system på ToR, autonomt system för hela blocket av spineswitchar i en Pod, och ett gemensamt autonomt system för hela Top of Fabric. Det är inte svårt att kolla och försäkra sig om att även normalt BGP-beteende ger oss den spridning av uppdateringar som vi önskar.
Självklart måste vi designa adresseringen och aggregeringen av adresser så att det är kompatibelt med hur routingen är uppbyggd, för att säkerställa stabilitet i kontrollplanet. L3-adressering i transporten är kopplad till topologin, eftersom utan detta går det inte att uppnå aggrering, utan individuella adresser kommer att tränga in i routingsystemet. Och en annan sak är att aggregeringen, tyvärr, blandas inte så bra med multi-path, för när vi har multi-path och aggregering är allt bra så länge hela nätverket fungerar, utan avbrott. Tyvärr, så fort det uppstår avbrott i nätverket och symmetrin i topologin går förlorad kan vi hamna i ett läge där den aggregerade vägen annonserades, men vi kan inte gå vidare dit vi behöver. Därför är det bäst att aggera där det inte finns något multi-path, i vårt fall är det ToR-switchar.
Faktum är att aggregering är möjlig, men med försiktighet. Om vi kan göra en kontrollerad disaggregering när det uppstår avbrott i nätet. Men det är en ganska komplicerad uppgift, vi har till och med funderat på om det är möjligt att skapa ytterligare automation, och ändliga automater som korrekt ska styra BGP för att uppnå önskat beteende. Tyvärr är hanteringen av hörnfall mycket otydlig och komplex, och genom att ansluta extern utrustning till BGP löser denna uppgift sig inte väl.
Mycket intressant arbete har gjorts i detta avseende inom ramen för RIFT-protokollet, som kommer att diskuteras i nästa föredrag.
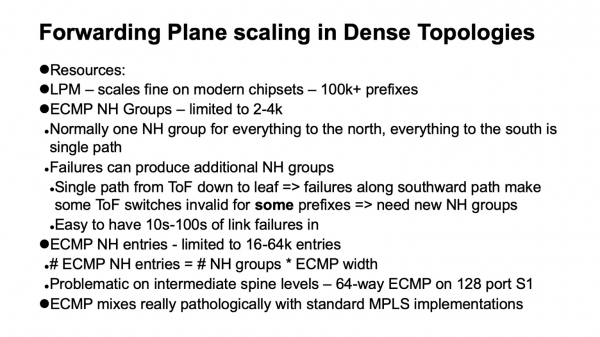
En annan viktig sak är hur dataplanerna skalas i täta topologier, där vi har ett stort antal alternativa vägar. Här används flera extra databasstrukturer: ECMP-grupper, som i sin tur beskriver grupper av Next Hop.
I en normalt fungerande nätverk, utan avbrott, när vi går upp genom Clos-topologin, räcker det att använda endast en grupp, eftersom allt som inte är lokalt beskrivs av default, och vi kan gå uppåt. När vi går neråt i söder, så är alla vägar inte ECMP, utan enkelvägs vägar. Allt ser bra ut. Problemet är att den klassiska Clos-topologin har den egenskapen att om vi tittar på toppen av fiber, så har varje element, upp till vilket som helst element nedanför, en väg. Om det sker avbrott längs den vägen, så blir just det elementet högst upp i fiber ogiltigt för de specifika prefix som ligger bakom den trasiga vägen. Men för de andra är det giltigt, och vi måste bryta ner ECMP-grupperna och införa ett nytt tillstånd.
Hur ser skalbarheten av data plane ut på moderna enheter? Om vi gör LPM (longest prefix match) fungerar allt ganska bra, över 100k prefix. När vi pratar om Next Hop-grupper, så är det betydligt sämre, 2-4 tusen. Om vi pratar om tabellen som innehåller beskrivningar av Next Hops (eller adjacencies), så ligger det någonstans mellan 16k och 64k. Det kan bli ett problem. Och här kommer vi till en intressant avstickare: vad hände med MPLS i datacentren? I princip ville vi göra det.
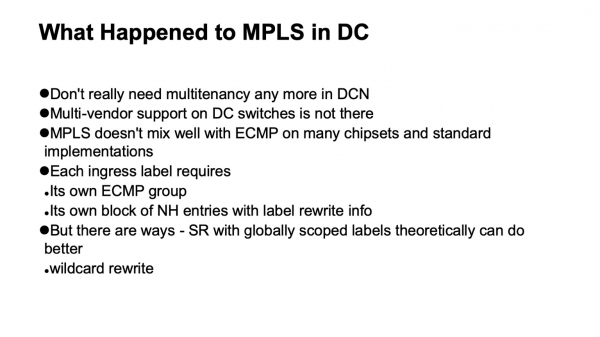
Två saker hände. Vi skapade mikrosementering på värdarna, så vi behövde inte göra det i nätverket. Stödet från olika leverantörer var inte så bra, särskilt inte med öppna implementationer på white boxes med MPLS. Dessutom fungerar MPLS, åtminstone dess traditionella implementationer, tyvärr mycket dåligt med ECMP. Och det är anledningen till detta.
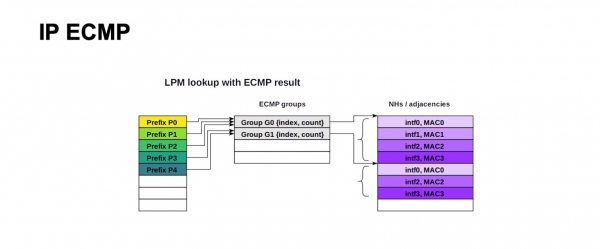
Så här ser strukturen för ECMP-forwarding för IP ut. Ett stort antal prefix kan använda samma grupp och samma block av Next Hops (eller adjacencies, i olika dokumentationer för olika enheter kan detta kallas olika). Poängen är att detta beskrivs som utgående port och vilket MAC-adress som ska skrivas om för att nå rätt Next Hop. För IP ser allt enkelt ut, det går att använda för ett mycket stort antal prefix i en och samma grupp, ett och samma block av Next Hops.
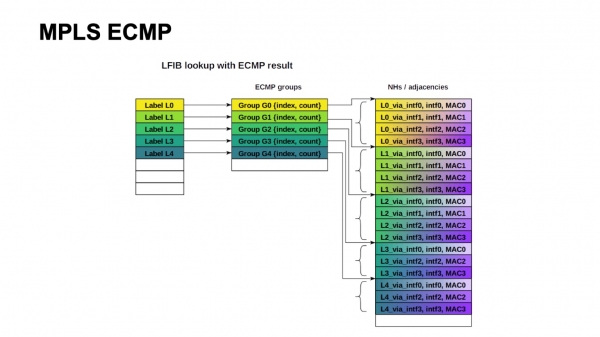
Den klassiska MPLS-arkitekturen innebär att beroende på utgående gränssnitt kan etiketten skrivas om till olika värden. Därför behöver vi ha en grupp och en block av Next Hops för varje ingående etikett. Och tyvärr, det skalar inte.
Det är inte svårt att se att vi i vår konstruktion behövde runt 4000 ToR-switchar, med en maximal bredd på 64 vägar ECMP, om vi går från spina-1 till spina-2. Vi får knappt plats, på gränsen, i en ECMP-gruppstabell, om endast en prefix med ToR går igenom, och vi får överhuvudtaget inte plats i tabellen Next Hops.
Allt är inte hopplöst, eftersom arkitekturer av typ Segment Routing innebär globala etiketter. Formellt sett kunde vi återigen sammanfoga alla dessa block av Next Hops. För detta behövs en operation av typ wildcard: ta en etikett och skriva över den med samma utan ett specifikt värde. Men tyvärr är det inte särskilt närvarande i de tillgängliga implementationerna.
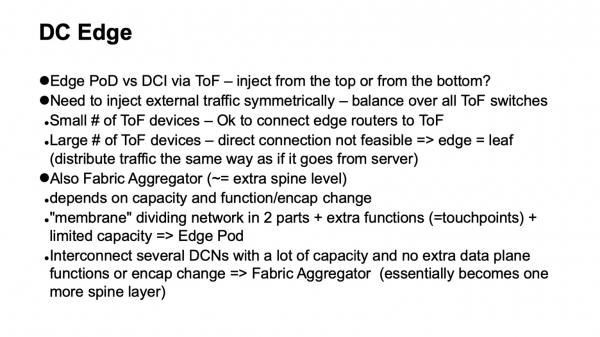
Och slutligen, vi behöver föra in extern trafik till datacentret. Hur gör vi det? Tidigare leddes trafiken in i Clos-nätet uppifrån. Det fanns gränsrouter som kopplades till alla enheter på Top of fabric. Denna lösning fungerar ganska bra i små och medelstora storlekar. Tyvärr, för att leda in trafik på detta sätt symmetriskt till hela nätverket, måste vi nå alla element på Top of fabric samtidigt, och när det blir mer än hundra visar det sig att vi behöver en stor radix även på gränsroutrarna. Överhuvudtaget kostar detta pengar, eftersom gränsroutrarna är mer funktionella, portarna på dem kommer att vara dyrare, och det blir en ganska otymplig konstruktion.
Ett annat alternativ är att leda in sådan trafik underifrån. Det är inte svårt att inse att Clos-topologin är byggd så att den trafik som kommer in underifrån, alltså från ToR, jämnt fördelas över nivåerna på hela Top of fabric under två iterationer, och därmed belastar hela nätverket. Därför introducerar vi en speciell typ av Pod, Edge Pod, som säkerställer extern anslutning.
Det finns ytterligare ett alternativ. Till exempel gör Facebook så här. Det kallas Fabric Aggregator eller HGRID. En extra spine-nivå införs för att koppla ihop flera datacenter. Denna konstruktion är möjlig om vi inte har extra funktioner eller byten av inkapsling i skarvarna. Om det finns sådana, blir det extra touch points, vilket gör det komplicerat. Generellt sett uppstår fler funktioner och någon slags membran som separerar olika delar av datacentret. Det är inte värt att göra detta membran stort, men om det är nödvändigt, kan det vara meningsfullt att överväga att flytta det, göra det så brett som möjligt och flytta det till värdarna. Så gör många molnoperatörer. De har overlays som börjar med värdarna.
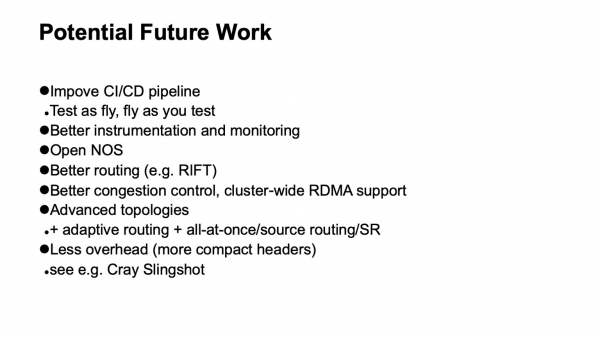
Vilka utvecklingsmöjligheter ser vi? Först och främst – förbättrad stöd för CI/CD-pipeline. Vi vill flyga som vi testar och testa som vi flyger. Det går inte så bra eftersom infrastrukturen är stor och det är omöjligt att duplicera den för tester. Vi måste förstå hur man inför testningsmoment i den operativa infrastrukturen utan att krascha den.
Bättre verktyg och bättre övervakning är nästan aldrig överflödiga. Frågan är balansen mellan insatser och avkastning. Om det är möjligt att lägga till med rimliga resurser – är det mycket bra.
Öppna operativsystem för nätverksenheter. De bästa protokollen och de bästa rutineringssystemen, till exempel RIFT. Dessutom behövs forskning om tillämpning av de bästa congestion control-schemana och eventuellt införandet av, åtminstone på vissa punkter, stöd för RDMA inom klustret.
Om vi ser på det med siktet inställt på en mer avlägsen framtid, behövs avancerade topologier och möjligen nätverk med lägre overhead. Bland de senaste sakerna – nyligen publicerades uppgifter om fabriksteknologi för HPC Cray Slingshot, som är baserad på commodity Ethernet, men med möjlighet att använda mycket kortare rubriker. Resultatet blir mindre overhead.
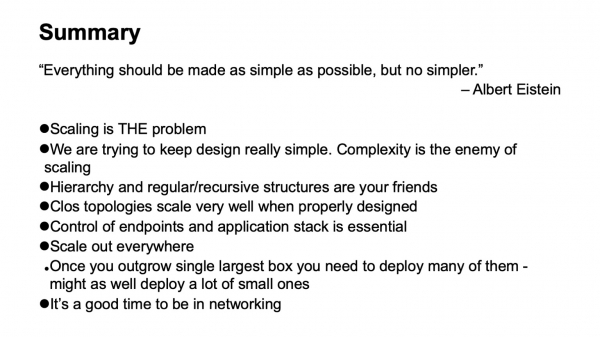
Allt bör göras så enkelt som möjligt, men inte enklare. Komplexitet är en fiende till skalbarhet. Enkelhet och regelbundna strukturer är våra vänner. Om det är möjligt att skala ut någonstans – gör det. Och just nu är det verkligen spännande att arbeta med nätverksteknologier. Mycket intressant händer. Tack.
Källa: habr.com
