

Vi lever i en fantastisk tid, hvor man hurtigt og nemt kan kombinere flere færdige open source-værktøjer, konfigurere dem med »afslappet sind« efter råd fra stackoverflow, uden at dykke ned i »mange bogstaver«, og lancere dem kommercielt. Men når der er behov for opdateringer/udvidelser, eller nogen utilsigtet genstarter et par maskiner – indser man, at man er i gang med en påtrængende dårlig drøm, hvor alt pludselig er blevet uigenkendeligt kompliceret, der er ingen vej tilbage, fremtiden er tåget, og det er sikrere at dyrke bier og lave ost end at programmere.
Det er ikke underligt, at mere erfarne kolleger, med et hår der allerede er gråsprængt af fejl, betragter det utroligt hurtige udrulning af bunker til »containere« i »kubikere« på dusinvis af servere med »moderne sprog« og indbygget støtte til asynkron ikke-blokerende input/output – de smiler beskedent. Og de fortsætter stille med at læse »man ps«, fordeler blodet fra øjnene over kildekoden til »nginx« og skriver-skriver-skriver unit tests. Kollegerne ved, at det mest interessante vil komme senere, når »alt dette« engang bliver en natlig udfordring ved nytår. Og kun en dyb forståelse af unix-natur, indlært TCP/IP-tilstande og grundlæggende sorterings-søgealgoritmer vil hjælpe dem med at genoplive systemet til klangene af klokkerne.
Åh ja, jeg kom lidt væk fra emnet, men jeg håber, jeg formåede at formidle en følelse af forventning.
I dag vil jeg dele vores erfaring med at implementere en nem og omkostningseffektiv stak til DataLake, som løser de fleste analytiske opgaver i virksomheden for helt forskellige afdelinger.
For noget tid siden kom vi til at forstå, at virksomheder i stigende grad har brug for resultater fra både produkt- og teknisk analyse (for ikke at nævne bærrene på kagen i form af maskinlæring), og for at forstå tendenser og risici – er det nødvendigt at indsamle og analysere flere og flere metrikker.
Basis teknisk analyse i »Bitrix24«
För flera år sedan, i samband med lanseringen av tjänsten «Bitrix24», investerade vi aktivt tid och resurser i att skapa en enkel och pålitlig analysplattform som skulle hjälpa till att snabbt upptäcka problem i infrastrukturen och planera nästa steg. Självklart önskade vi att använda färdiga verktyg som var så enkla och förståeliga som möjligt. Resultatet blev att nagios valdes för övervakning och munin för analys och visualisering. Nu har vi tusentals kontroller i nagios, hundratals diagram i munin och kollegor använder dem framgångsrikt varje dag. Metrikerna är tydliga, diagrammen är klara, systemet har fungerat pålitligt i flera år och ny tester och diagram läggs regelbundet till: när vi sätter en ny tjänst i drift — lägger vi till några tester och diagram. Lycka till.
Hålla hand på pulsen — utökad teknisk analys
Önskan om att få information om problem "så snart som möjligt" har lett till aktiva experiment med enkla och förståeliga verktyg — pinba och xhprof.
Pinba skickade oss statistik i UDP-paket om hastigheten på olika delar av webbplatserna i PHP, och vi kunde i realtid se en kort lista över problem i MySQL-lagret (pinba kommer med sin egen MySQL-motor för snabb händelseanalys) och reagera på dem. Och xhprof möjliggjorde automatiskt insamling av exekveringsgrafer för de mest långsamma PHP-sidorna hos kunderna och analysera vad som kunde ha orsakat detta — lugnt, medan vi hällde upp te eller något starkare.
För ett tag sedan utökades verktygsuppsättningen med ännu en ganska enkel och förståelig motor baserad på algoritmen för omvänd indexering, utmärkt implementerad i det legendariska biblioteket Lucene — Elastic/Kibana. Den enkla idén med flerdimensionell dokumentinspelning i Lucenes omvända index baserat på händelser i loggar och snabb sökning i dem med hjälp av facettering — visade sig verkligen vara användbar.
Trots det ganska tekniska utseendet på visualiseringarna i Kibana med "som flödar uppåt" låg-nivå koncepter som "bucket" och det pånyttfödda språket av den fortfarande inte glömda relationella algebran — har verktyget verkligen hjälpt oss i följande uppgifter:
- Hur många PHP-fel har kunden Bitrix24 haft på portalen p1 den senaste timmen och vilka? Förstå, förlåta och snabbt åtgärda.
- Hur många videosamtal har genomförts på portalerna i Tyskland under de senaste 24 timmarna, med vilken kvalitet och har det funnits några problem med kanalen/nätverket?
- Hur väl fungerar systemets funktionalitet (vår utvidgning i C för PHP), kompilerad från källkod i den senaste uppdateringen av tjänsten och distribuerad till kunderna? Finns det några segfaults?
- Lagrar PHP kunddata i minnet? Finns det några fel på att överskrida den tilldelade minnesmängden: "utav minne"? Hitta och åtgärda.
Här är ett konkret exempel. Trots noggrann och flerdimensionell testning uppstod en frustrerande och oväntad fel hos en kund i ett mycket ovanligt fall med skadad indata, vilket ledde till att sirenen ljöd och processen för dess snabba fixning inleddes.
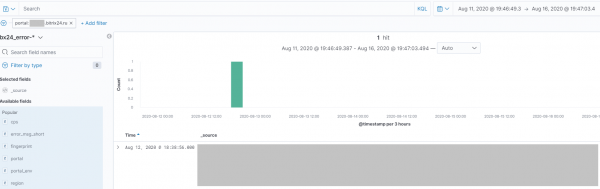
Dessutom gör Kibana det möjligt att organisera aviseringar baserade på angivna händelser och på kort tid började verktyget användas av dussintals anställda från olika avdelningar – från support och utveckling till QA.
Aktiviteten hos varje avdelning inom företaget har blivit lätt att spåra och mäta – istället för manuell analys av loggar på servrarna räcker det att en gång ställa in loggparsing och skicka dem till elastic-klustret för att njuta av att till exempel betrakta antalet sålda tvåhuvudiga kattungar, tryckta på 3D-skrivare under den senaste månaden.
Grundläggande affärsanalys
Alla vet att affärsanalys i företag ofta börjar med ett extremt aktivt användande av, ja, ja, Excel. Men det viktigaste är att den inte slutar där. Molnversionen av Google Analytics gör också sitt för att tända elden – man vänjer sig snabbt vid det goda.
I vårt harmoniskt växande företag har det börjat dyka upp "profeter" som arbetar med större data på ett mer intensivt sätt. Det har regelbundet uppstått behov av djupare och mer komplexa rapporter, och tack vare insatser från olika avdelningar organiserades för ett tag sedan en enkel och praktisk lösning – en koppling mellan ClickHouse och PowerBI.
Under lång tid har denna flexibla lösning varit till stor hjälp, men alltmer har det blivit tydligt att ClickHouse inte är oändlig och bör inte missbrukas.
Det är viktigt att förstå att ClickHouse, precis som Druid, Vertica och Amazon RedShift (som är baserat på Postgres), är analytiska motorer optimerade för ganska bekväm analys (summeringar, aggregeringar, minimum-maxiumum per kolumn och lite möjlighet till join), eftersom de är organiserade för effektiv lagring av kolumner i relationsdatabaser, till skillnad från det vi känner som MySQL och andra (rad-orienterade) databaser.
I grunden är ClickHouse bara en mer rymlig "databas", med inte särskilt bekväm punktinsättning (det är avsiktligt, allt är okej), men med trevlig analys och en uppsättning intressanta kraftfulla funktioner för att arbeta med data. Ja, man kan till och med skapa en kluster - men du förstår att det inte är helt rätt att spika med ett mikroskop, och vi började leta efter andra lösningar.
Efterfrågan på Python och analytiker
I vårt företag finns det många utvecklare som skriver kod nästan varje dag i 10-20 år på PHP, JavaScript, C#, C/C++, Java, Go, Rust, Python, Bash. Det finns också många erfarna systemadministratörer som har överlevt mer än en helt otrolig katastrof som inte passar in i statistikkens lagar (till exempel när de flesta diskarna i RAID-10 förstörs vid en kraftig blixtnedslag). Under en lång tid var det oklart vad en "analytiker på Python" egentligen innebär. Python är ju som PHP, bara med ett lite längre namn och något färre spår av substanser som förändrar medvetandet i källkoden till tolken. Men allteftersom många nya analytiska rapporter skapades blev de erfarna utvecklarna fortfarande mer medvetna om vikten av smal specialisering inom verktyg som numpy, pandas, matplotlib, seaborn.
En avgörande roll spelades troligen av den plötsliga medvetslösheten hos anställda vid kombinationen av orden "logistisk regression" och demonstrationen av effektiv rapportering på stora datamängder med hjälp av, ja, pyspark.
Apache Spark, dess funktionella paradigmer, som passar perfekt med relationsalgebra och möjligheter, gjorde ett sådant intryck på utvecklare som var vana vid MySQL, att behovet av att stärka bataljonsraderna med erfarna analytiker blev lika tydligt som dagen.
Fortsatta försök att Apache Spark/Hadoop skulle lyfta och vad som inte riktigt gick enligt planen
Det blev dock snart tydligt att det tydligen var något systematiskt fel med Spark, eller så behövde man bara tvätta händerna bättre. Om Hadoop/MapReduce/Lucene-stacken skapades av tillräckligt erfarna programmerare, vilket är tydligt om man ser på källkoden i Java eller Douglas Cutting idéer i Lucene, så är Spark plötsligt skrivet i ett mycket omdiskuterat språk sett ur praktisk synvinkel och som nu inte utvecklas, nämligen det exotiska språket Scala. Den regelbundna nedcrashningen av beräkningarna på Spark-klustret på grund av ologisk och inte särskilt genomskinlig hantering av minnesallokering för reduce-operationer (många nycklar kommer på en gång) har skapat en aura av något som har stort potential att växa. Dessutom förvärrades situationen av ett stort antal konstiga öppna portar, temporära filer som växte på de mest oklara ställena och en massa jar-beroenden – vilket väckte en bekant känsla hos systemadministratörer: en intensiv avsky (kanske var det dags att tvätta sina händer med tvål).
Vi "överlevde" som resultat flera interna analysprojekt som aktivt använde Apache Spark (inklusive Spark Streaming, Spark SQL) och Hadoop-ekosystemet (och så vidare). Trots att vi med tiden lärde oss att "lagra" detta ganska väl och övervaka det, och "det" slutade praktiskt taget att plötsligt krascha på grund av förändringar i datakaraktären och obalanserat jämnt hashning av RDD, blev lusten att få något färdigt, uppdaterat och administrerat någonstans i molnet allt starkare. Det var vid den tiden vi försökte använda en färdig molnbaserad sammansättning från Amazon Web Services — och försökte därefter lösa uppgifter på den. EMR är Amazons beredda Apache Spark med extra mjukvara från ekosystemet, ungefär som Cloudera/Hortonworks-sammansättningar.
Ett "gummiband" filsystem för analys – ett akut behov
Erfarenheten av att "lagra" Hadoop/Spark med brännskador på olika kroppsdelar har inte varit förgäves. Behovet av att skapa ett enhetligt, kostnadseffektivt och pålitligt filsystem, som är motståndskraftigt mot hårdvarufel och där man kan lagra filer i olika format från olika system och göra effektiva och rimligt snabba urval av data för rapporter, har blivit allt tydligare.
Jag skulle också vilja att programuppdateringen för denna plattform inte ska bli en mardröm likt en nyårsnatt, där man står och läser 20-sidiga Java-traces och analyserar kilometers långa loggar från klustret med hjälp av Spark History Server och ett förstoringsglas med belysning. Jag önskar mig ett enkelt och transparent verktyg som inte kräver att man regelbundet dyker ner under huven, om en utvecklare inte längre kan köra en standard MapReduce-fråga på grund av att arbetsminnet för reduce-data försvinner vid ett dåligt valt partitionsalgoritm för de ursprungliga datan.
Är Amazon S3 en kandidat för DataLake?
Erfarenheten av att arbeta med Hadoop/MapReduce har lärt mig att det behövs ett skalbart och pålitligt filsystem, samt skalbara arbetare som "kommer" närmare datan för att undvika att flytta data över nätverket. Arbetskraften måste kunna läsa data i olika format, men helst inte läsa onödig information och att man i förväg kan lagra data i format som är bekväma för arbetarna.
Återigen — huvudidén. Det finns ingen vilja att "lasta upp" stora data till en enda klusteranalysmotor som förr eller senare ändå kommer att sjunka och som måste shardas på ett fult sätt. Jag vill lagra filer, bara filer, i ett begripligt format och utföra effektiva analytiska frågor på dem med olika, men begripliga verktyg. Och antalet filer i olika format kommer bara att öka. Det är bättre att shard data snarare än motorn. Vi behöver en skalbar och universell DataLake, beslutade vi...
Vad händer om vi lagrar filer i det välkända och många känner till det skalbara molnlagringssystemet Amazon S3, istället för att bryta ner det med Hadoop?
Självklart kan vi inte använda personuppgifter, men vad om vi flyttar andra data dit och "effektivt hanterar" dem?
Klyster-biggdata-analytisk ekosystem av Amazon Web Services — med mycket enkla ord
Enligt vår erfarenhet av att arbeta med AWS används Apache Hadoop/MapReduce aktivt där under olika former, till exempel i tjänsten DataPipeline (jag avundas mina kollegor som verkligen har lärt sig att förbereda den korrekt). Här har vi ställt in backup från olika tjänster från tabeller i DynamoDB:
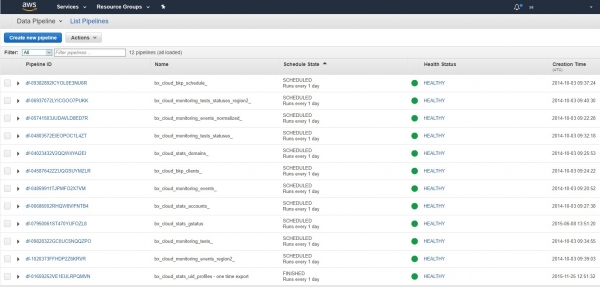
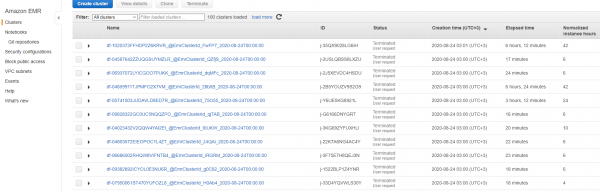
Och de körs regelbundet på inbyggda kluster av Hadoop/MapReduce som urverk redan i flera år. "Ställ in och glöm":
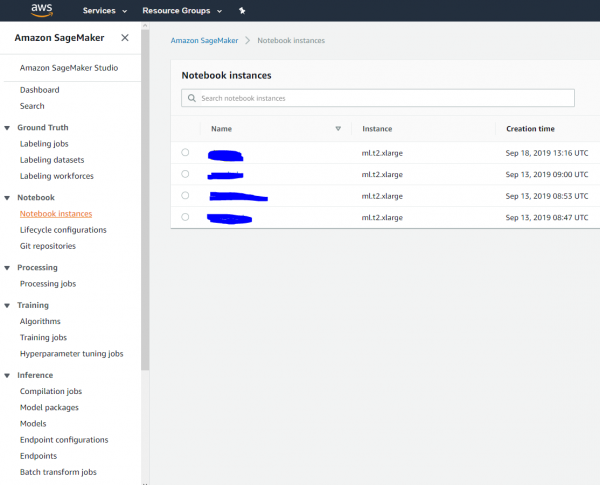
Dessutom kan man effektivt syssla med datastanism genom att lansera Jupiter-notebooks i molnet för analytiker och använda dem för träning och driftsättning av AI-modeller i AWS SageMaker. Så här ser det ut hos oss:
Och ja, man kan lansera en notebook i molnet för sig själv eller för analytikerna och koppla den till ett Hadoop/Spark-kluster, räkna och sedan 'spika' allt:
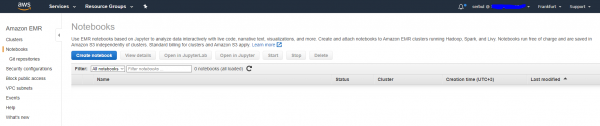
Det är verkligen bekvämt för enskilda analytiska projekt, och för vissa har vi framgångsrikt använt EMR-tjänsten för storskaliga beräkningar och analyser. Men hur står det till med ett systemlösning för DataLake, kommer det att fungera? Vid den tiden var vi på gränsen mellan hopp och förtvivlan och fortsatte att söka.
AWS Glue — snyggt paketerad Apache Spark 'på steroider'
Det visade sig att AWS har sin "egna" version av stacken "Hive/Pig/Spark". Hive:s roll, dvs. filkatalogen och dess typer i DataLake, utförs av tjänsten "Data catalog", som inte döljer sin kompatibilitet med formatet Apache Hive. I denna tjänst behöver man lägga till information om var dina filer ligger och vilket format de är i. Data kan ligga inte bara i s3, utan också i en databas, men det är inte temat för detta inlägg. Så här är vår data katalog för DataLake organiserad:
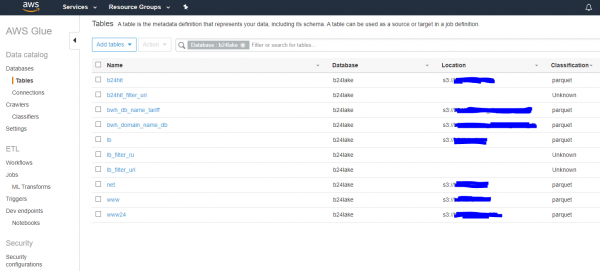
Filerna är registrerade, utmärkt. Om filerna har uppdaterats — startar vi antingen manuellt eller schemalagt crawlers som uppdaterar informationen om dem från sjön och sparar. Därefter kan data från sjön bearbetas och resultaten exporteras någonstans. I det enklaste fallet — exporteras också till s3. Data kan bearbetas var som helst, men man föreslår att ställa in bearbetningsprocessen på ett Apache Spark-kluster med utökade möjligheter genom AWS Glue API. I grund och botten kan man ta den gamla, kära och vanliga koden i python med hjälp av biblioteket pyspark och ställa in dess körning på N noder i ett kluster av viss kapacitet med övervakning, utan att gräva i Hadoop:s inre och dra runt med docker-mock-kontainrar och lösa beroendeproblem.
Återigen — en enkel idé. Det behövs ingen konfiguration av Apache Spark, man behöver bara skriva kod i python för pyspark, testa den lokalt på skrivbordet och sedan köra den på ett stort kluster i molnet, ange var de ursprungliga data ligger och var resultatet ska läggas. Ibland är det behövligt och användbart, och så här är det konfigurerat hos oss:
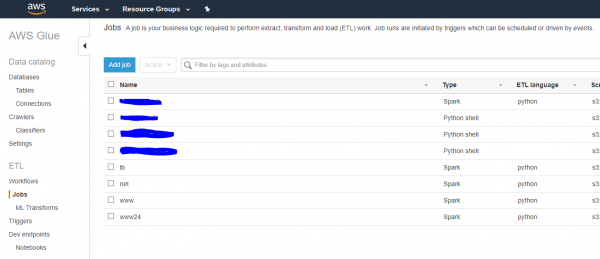
Så, om man behöver göra beräkningar på Spark-klustret med data i s3 — skriver man kod i python/pyspark, testar och sen är det fritt fram till molnet.
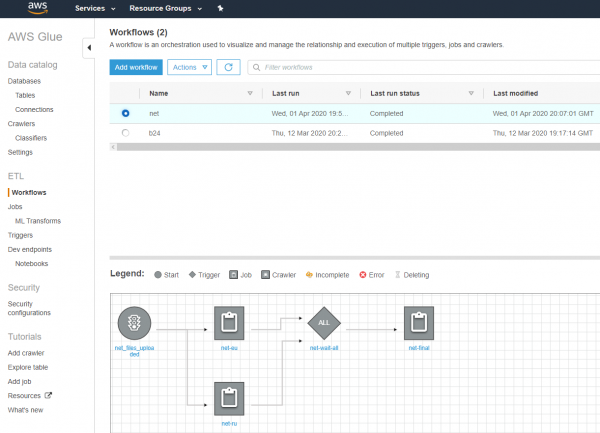
Och hur står det till med orkestreringen? Och om en uppgift faller bort? Ja, det föreslås att man gör en vacker pipeline i stil med Apache Pig och vi har till och med testat dem, men vi har valt att använda vår djupt anpassade orkestrering i PHP och JavaScript för tillfället (jag förstår att detta kan skapa kognitiv dissonans, men det fungerar, år efter år utan fel).
Formatet på de filer som lagras i sjön är nyckeln till prestanda
Det är mycket, mycket viktigt att förstå ytterligare två nyckelpunkter. För att dataförfrågningarna för filerna i sjön ska utföras så snabbt som möjligt och för att prestandan inte ska försämras vid tillägg av ny information, måste man:
- Lagra kolumnerna i filerna separat (så att man inte behöver läsa alla rader för att förstå vad som finns i kolumnerna). För detta har vi valt parquet-formatet med komprimering.
- Det är också viktigt att shardera filerna i mappar i stil med: språk, år, månad, dag, vecka. Motorer som förstår denna typ av sharding kommer endast att titta i de relevanta mapparna, utan att behöva gräva igenom all data.
I grunden lägger ni på det mest effektiva sättet av de ursprungliga data för de analytiska motorer som kan gå selektivt in i de sharderade mapparna och läsa endast de nödvändiga kolumnerna från filerna. Ni behöver inte "ladda" data någonstans (lagringen kommer att spricka) – bara lägg dem direkt smart i filsystemet i rätt format. Självklart ska det stå klart att det inte är särskilt förnuftigt att lagra en stor csv-fil i DataLake, som först måste läsas rad för rad av kluster för att extrahera kolumnerna – tänk på de två ovan nämnda punkterna en gång till om det är oklart varför allt detta.
AWS Athena – en "djävul" ur lådan
Och här, när vi skapar en sjö, snubblar vi förbi Amazon Athena. Plötsligt visar det sig att om man ordentligt lägger våra stora loggfiler i sharderade mappar i rätt (parquet) kolumnformat, kan man mycket snabbt göra extremt informativa urval och skapa rapporter UTAN, utan Apache Spark/Glue-kluster.
Athena-motorn, som arbetar med data i s3, är baserad på den legendariska — en representant av MPP (massive parallel processing) familjen av databehandlingsmetoder som hämtar data där den finns, från S3 och Hadoop till Cassandra och vanliga textfiler. Man behöver bara be Athena att köra en SQL-fråga, och sedan "fungerar allt snabbt och av sig själv". Det är värt att notera att Athena är "intelligent", går bara till de nödvändiga sharderade mapparna och läser bara de kolumner som efterfrågas.
Priser för förfrågningar till Athena är också intressanta. Vi betalar för . Det vill säga, inte för antalet maskiner i klustret per minut, utan... för de data som faktiskt har skannats på 100-500 maskiner som behövs för att utföra förfrågan.
Genom att endast begära de nödvändiga kolumnerna från rätt shardade mappar visade det sig att tjänsten Athena kostar oss några tiotals dollar per månad. Väldigt bra, nästan gratis, jämfört med analys på kluster!
Så här shardas våra data i S3:
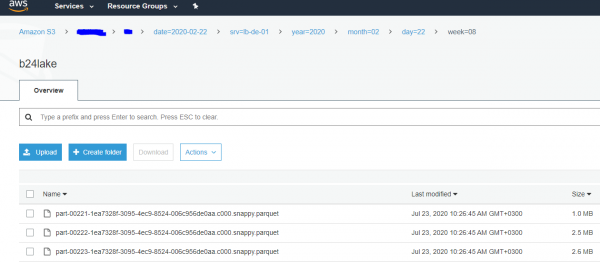
Som ett resultat, på kort tid, började helt olika avdelningar inom företaget, från informationssäkerhet till analys, aktivt göra förfrågningar till Athena och snabbt, på sekunder, få användbara svar från "big data" för ganska långa perioder: månader, halvår och så vidare.
Men vi gick vidare och började hämta svar i molnet : en analytiker skriver en SQL-fråga i sin vanliga konsol, som "för en spottstyver" skannar data i S3 med 100-500 maskiner och ger tillbaka svaret vanligtvis på några sekunder. Bekvämt. Och snabbt. Det är fortfarande svårt att tro.
I slutändan, efter att ha beslutat att lagra data i S3, i ett effektivt kolumnformat och med rimlig shardning av data i mappar... fick vi en DataLake och en snabb och billig analytisk motor — gratis. Den blev mycket populär inom företaget, eftersom den förstår SQL och arbetar många gånger snabbare än genom start/stopp/inställningar av kluster. "Och om resultatet är detsamma, varför betala mer?"
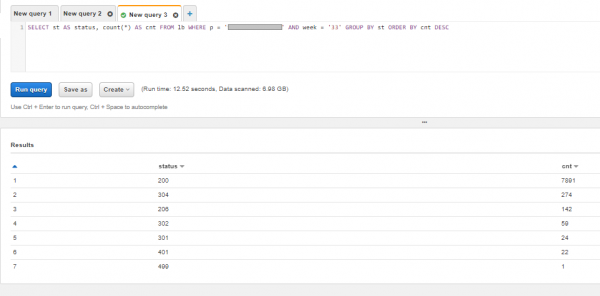
En förfrågan till Athena ser ut ungefär så här. Om så önskas kan man givetvis formulera en ganska , men vi nöjer oss med en enkel gruppering. Låt oss se vilka svarskoder kunden hade för några veckor sedan i loggarna från webbserverns arbete och bekräfta att det inte finns några fel:
Slutsatser
Efter att ha gått en väg som visserligen inte varit lång men smärtsam, där vi ständigt har bedömt risker, svårighetsgrad och kostnad för stöd, har vi hittat en lösning för DataLake och analys som fortsätter att glädja oss både med sin hastighet och ägandekostnad.
Det visade sig att det är helt möjligt att bygga en effektiv, snabb och kostnadseffektiv DataLake för behoven hos helt olika avdelningar inom företaget, även för erfarna utvecklare som aldrig har arbetat som arkitekter och som inte kan rita fyrkanter och pilar, trots att de känner till 50 termer inom Hadoop-ekosystemet.
I början av resan hade jag huvudvärk av de många galna zoos med öppen och stängd programvara och ansvarskänslan gentemot framtida generationer. Börja helt enkelt bygga din DataLake med enkla verktyg: nagios/munin -> elastic/kibana -> Hadoop/Spark/s3 …, samla feedback och förstå de fysiska processerna djupt. Allt som är komplicerat och oklart — lämna åt fiender och konkurrenter.
Om du inte vill använda molnet och älskar att stödja, uppdatera och patcha öppna projekt kan du bygga ett liknande system lokalt på billiga kontorsmaskiner med Hadoop och Presto ovanpå. Huvudsaken är att inte stanna upp utan fortsätta framåt, räkna, leta efter enkla och klara lösningar, så kommer allt att ordna sig! Lycka till alla och vi ses snart igen!
Källa: habr.com
