

Hej, Habr! De senaste månaderna har vi befunnit oss i en väldigt intressant situation, och jag skulle vilja dela med mig av vår historia om hur vi skalade vår infrastruktur. Under denna tid har SberMarket ökat sina beställningar med fyra gånger och lanserat sin tjänst i 17 nya städer. Den explosiva efterfrågan på livsmedelsleveranser har krävt att vi skalar upp vår infrastruktur. Läs mer om de mest intressanta och användbara slutsatserna efter bråkdelen.
Jag heter Dima Bobylev, jag är teknisk direktör för SberMarket. Eftersom det här är det första inlägget i vår blogg, vill jag säga några ord om mig själv och företaget. Förra hösten deltog jag i en tävling för unga ledare inom Runet. För tävlingen om hur vi på SberMarket ser på vår interna kultur och tillvägagångssättet för tjänsteutveckling. Även om jag inte lyckades vinna tävlingen, formulerade jag ändå de grundläggande principerna för utvecklingen av IT-ekosystemet.
När man leder ett team är det viktigt att förstå och hitta balansen mellan vad som behövs för affären och behoven hos varje enskild utvecklare. Just nu växer SberMarket 13 gånger år för år, och det påverkar produkten, vilket kräver ständigt ökande volymer och hastighet i utvecklingen. Trots detta ger vi tillräckligt med tid åt utvecklarna för föranalys och kvalitativ kodning. Denna etablerade metod hjälper inte bara till att skapa en fungerande produkt utan också till dess fortsatta skalning och utveckling. Som ett resultat av denna tillväxt har SberMarket redan blivit ledande inom tjänster för livsmedelsleverans: vi levererar dagligen omkring 18 000 beställningar, även om det i början av februari var omkring 3 500.
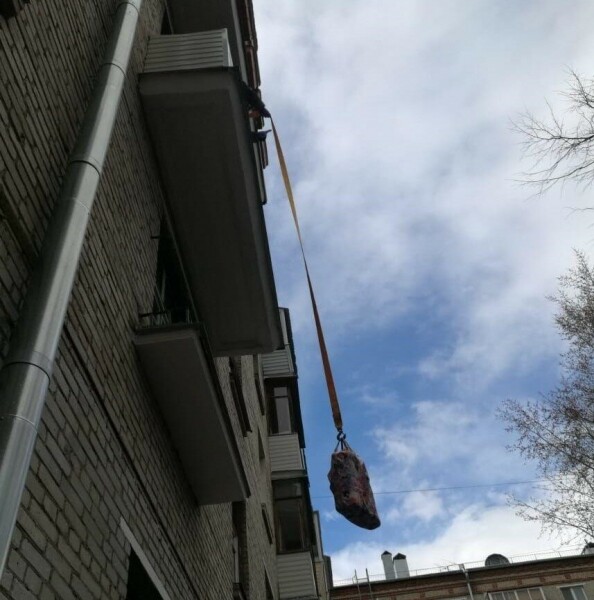
En gång bad en kund SberMarkets kurir att leverera livsmedel på ett kontaktlöst sätt — direkt till balkongen.
Men låt oss gå på konkreta punkter. Under de senaste månaderna har vi aktivt arbetat med att skala vår företagsinfrastruktur. Behovet av detta förklarades av både externa och interna faktorer. Samtidigt som vår kundbas växte, ökade antalet anslutna butiker från 90 i början av året till mer än 200 i mitten av maj. Vi förberedde oss naturligtvis, reserverade huvudinfrastrukturen och planerade för möjligheten till vertikal och horisontell skalning av alla virtuella maskiner som var placerade i Yandex moln. Men verkligheten visade: "Allt som kan gå snett, kommer att gå snett". Idag vill jag dela med mig av de mest intressanta situationerna som inträffade under dessa veckor. Jag hoppas att vår erfarenhet kommer att vara till nytta för er.
Slave är i full beredskap
Redan innan pandemin började märkte vi en ökning av antalet förfrågningar till våra backend-servrar. Tendensen att beställa produkter med hemleverans började ta fart, och med införandet av de första åtgärderna för självisolering på grund av COVID-19, ökade belastningen dramatiskt under hela dagen. Det uppstod ett behov av att snabbt avlasta masterservrarna för huvuddatabasen och flytta en del av läsförfrågningarna till replikservrar (slave).
Vi förberedde oss för det här steget i förväg, och för liknande manövrer hade redan två slave-servrar startats. De arbetade huvudsakligen med batch-uppgifter för att generera informationsflöden för datadelning med partner. Dessa processer skapade onödig belastning och var helt rimligt uteslutna "utanför parenteserna" ett par månader tidigare.
Eftersom replikation skedde på Slave, höll vi oss till konceptet att applikationerna bara fick arbeta med dem i read only-läge. Disaster Recovery Plan föreskrev att vid en katastrof skulle vi helt enkelt kunna montera Slave som Master och rikta alla skriv- och läsförfrågningar till Slave. Vi ville dock också använda replikorna för analytiska avdelningens behov, så servrarna blev inte helt överförda till read only-status, och varje värd hade sin egen uppsättning användare, av vilka vissa hade skrivbehörighet för att spara mellanresultat från beräkningar.
Vi hade tillräckligt med kapacitet från master både för skriv- och läsfunktioner vid hantering av http-förfrågningar upp till en viss belastning. I mitten av mars, precis när Sbermarket beslutade att helt övergå till distansarbete, började vi se en exponentiell ökning av RPS. Fler och fler av våra kunder gick in i självkarantän eller arbetade hemifrån, vilket påverkade belastningssiffrorna.
Prestandan hos "mastern" räckte inte längre, så vi började avlasta några av de tyngsta läsförfrågningarna till replikan. För att transparent styra skrivförfrågningar till master och läsningar till slaven använde vi ruby-gemmet "". Vi skapade en särskild användare med suffixet _readonly utan skrivbehörighet. Men på grund av ett konfigurationsfel på en av värdarna skickades vissa skrivförfrågningar till slave-servern under namnet på en användare som hade de nödvändiga rättigheterna.
Problemet visade sig inte direkt, eftersom den ökade belastningen fakturerade slaven. Inkonsistens i data uppdagades på morgonen, när slaven inte hade "kommit ikapp" mastern efter nattens importer. Vi skyllde på det höga trycket på tjänsten och importen kopplad till lanseringen av nya butiker. Men att leverera data med flera timmars fördröjning var oacceptabelt, så vi skiftade processerna till den andra analytiska slaven, eftersom den hade bbästa resultatet (subjektiv åsikt).ättre resurser och inte var belastad med läsförfrågningar (vilket var hur vi förklarade för oss själva att det inte fanns någon replikationsfördröjning).
När vi hade reda på orsakerna till "spridningen" av huvudsakliga slaven, hade den analytiska redan gått ner av samma anledning. Trots att vi hade två ytterligare servrar som vi hade planerat att flytta belastningen till i händelse av att mastern skulle krascha, visade det sig på grund av ett olyckligt misstag att vi inte hade någon i kritiska ögonblick.
Men eftersom vi gjorde mer än bara dump av databasen (återställningen vid den tidpunkten tog cirka 5 timmar), utan även en snapshot av master-servern, lyckades vi starta repliken inom 2 timmar. Dock väntade oss ett långt loggning av replikation för en lång tid efter detta (eftersom processen körs i en tråd, men det är redan en helt annan historia).
Slutsats: Efter den här incidenten blev det klart att vi måste överge praktiken att begränsa skrivåtkomst för användare och göra hela servern readonly. Med en sådan strategi kan man vara säker på att replikerna kommer att vara tillgängliga vid kritiska tillfällen.
Optimering av även en tung förfrågan kan "återuppliva" databasen.
Även om vi ständigt uppdaterar katalogen på webbplatsen, fanns det en liten fördröjning i förfrågningarna som vi körde på Slave-servrarna jämfört med Master. Tiden vi tog för att upptäcka och åtgärda problemet med "plötsligt avbrutna" slavar var längre än den "psykologiska barriären" (under denna tid kan prisändringar ha inträffat, och kunderna skulle ha sett föråldrad information), och vi var tvungna att omdirigera alla förfrågningar till huvuddatabasen. Som ett resultat fungerade webbplatsen långsamt... men åtminstone fungerade den. Och medan Slavarna återhämtade sig hade vi inget annat val än att optimera.
Medan Slave-servrarna återhämtade sig, drog minuterna ut på tiden, Master var överbelastad, och vi lade all vår energi på att optimera aktiva uppgifter enligt "Pareto-principen": vi valde TOP-förfrågningar som orsakade den största belastningen och började finjustera. Detta gjordes direkt "i processen".
En intressant effekt var att en helt överbelastad MySQL reagerar på även små förbättringar av processerna. Optimering av ett par förfrågningar som orsakade endast 5% av den totala belastningen visade redan en märkbar avlastning av CPU. Som ett resultat lyckades vi skapa en acceptabel resursmarginal för att få Master att arbeta med databasen och fick den nödvändiga tiden för att återställa repliker.
Slutsats: Även en liten optimering kan göra att man "överlever" vid överbelastning i flera timmar. Det var precis vad vi behövde under återställningstiden för servrarna med repliker. För övrigt kommer vi att diskutera den tekniska sidan av förfrågeoptimering i ett av de kommande inläggen. Så prenumerera gärna på vår blogg om detta kan vara till nytta för dig.
Organisera övervakning av partner-tjänsternas tillgänglighet.
Vi hanterar beställningar från kunder, och därför interagerar våra tjänster ständigt med externa API:er - detta inkluderar gateway som skickar SMS, betalningsplattformar, routing-system, geokodare, skatteverket och många andra system. När belastningen började öka snabbt, började vi möta begränsningar från API:erna hos våra partner som vi tidigare inte ens hade tänkt på.
Ett oväntat överskridande av kvoter hos partner-tjänster kan leda till stillestånd i din egen verksamhet. Många API:er blockerar klienter som överstiger sina begränsningar, och i vissa fall kan ett överskott av förfrågningar överbelasta produktionen hos partnern.
Till exempel, vid en ökning av antalet leveranser hade de medföljande tjänsterna svårt att hantera fördelning och ruttbestämning. Resultatet blev att beställningar genomfördes, men tjänsten som skapade rutten fungerade inte. Våra logistikteam gjorde det som nästan verkade omöjligt under dessa omständigheter, och ett tydligt samarbete inom teamet bidrog till att kompensera för tillfälliga avbrott i tjänsterna. Men en sådan mängd beställningar går inte att hantera manuellt på en kontinuerlig basis, och efter ett tag skulle vi ha stött på en oacceptabel klyfta mellan beställningarna och deras genomförande.
En rad organisatoriska åtgärder vidtogs och det samordnade arbetet i teamet hjälpte oss att vinna tid medan vi förhandlade om nya villkor och väntade på uppgraderingar av tjänster från vissa partner. Det finns även andra API:er som imponerar med hög uthållighet och ogynnsamma avgifter vid hög trafik. Till exempel, i början använde vi en känd karttjänst API för att bestämma leveransadress. Men efter en månad fick vi en räkning på nästan 2 miljoner rubel. Efter det bestämde vi oss för att snabbt byta ut den. Jag kommer inte att göra reklam, men jag kan säga att våra kostnader minskade betydligt.
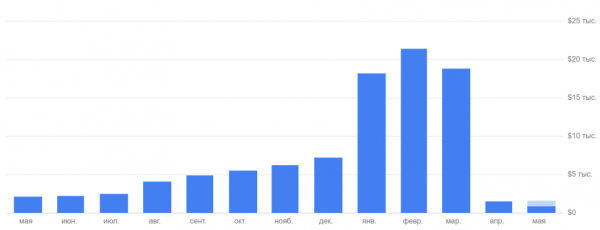
Slutsats: Det är viktigt att övervaka villkoren för alla partner-tjänster och ha dem i åtanke. Även om det idag verkar som om de har "god marginal", så betyder det inte att de inte kan bli ett hinder för tillväxt i morgon. Och självklart är det bäst att förhandla om de ekonomiska villkoren för ökade förfrågningar till tjänsten i förväg.
Ibland visar det sig att “” (c) inte hjälper
Vi är vana vid "flaskhalsar" i den primära databasen eller på applikationsservrar, men när vi skalar upp kan problem dyka upp där man minst anar det. För fulltextsökning på vår webbplats använder vi motorn Apache Solr. Med ökande belastning har vi noterat en minskning av svarstiden, samtidigt som serverns CPU-belastning nådde 100%. Vad kan vara enklare — vi ger containern med Solr mer resurser.
Istället för den förväntade prestandaökningen lade servern helt enkelt av. Den laddades omedelbart till 100% och svarade ännu långsammare. Ursprungligen hade vi 2 kärnor och 2 GB RAM. Vi beslöt att göra det som vanligtvis hjälper — vi gav servern 8 kärnor och 32 GB. Allt blev mycket sämre (hur och varför detta skedde kommer vi att berätta om i ett separat inlägg).
Inom några dagar satte vi oss in i detaljerna kring denna fråga, och vi uppnådde optimal prestanda med 8 kärnor och 32 GB. Denna konfiguration gör det möjligt att fortsätta öka belastningen, vilket är mycket viktigt, eftersom tillväxten inte bara handlar om antalet kunder utan också om antalet anslutna butiker — under de senaste 2 månaderna har deras antal fördubblats.
Slutsats: Standardmetoder som "lägg till mer hårdvara" fungerar inte alltid. Så vid skalning av vilken tjänst som helst är det viktigt att förstå hur den använder resurser och testa dess funktion i de nya förhållandena i förväg.
Stateless — nyckeln till enkel horisontell skalning
Överlag följer vårt team en välkänd princip: tjänster ska vara stateless och oberoende av körmiljön. Detta har gjort det möjligt för oss att hantera ökad belastning genom enkel horisontell skalning. Men vi hade en tjänst som var ett undantag – hanteraren av långa bakgrundsuppgifter. Denna skötte utskick av e-post och sms, bearbetning av händelser, generering av flöden, import av priser och lager, samt bildbearbetning. Det visade sig att den var beroende av ett lokalt filsystem och fanns i en enda instans.
När antalet uppgifter i kö för hanteraren växte (vilket naturligtvis hände med ökningen av antalet beställningar) blev prestandan på värden där hanteraren och fillagret var placerade en begränsande faktor. Som resultat stannade uppdateringen av sortiment och priser, utskicken av notifieringar till användare och många andra kritiska funktioner upp i kön. Ops-teamet migrerade snabbt filagret till ett S3-liknande nätverkslager, vilket gjorde att vi kunde starta flera kraftfulla maskiner för att skala hanteraren av bakgrundsuppgifter.
Slutsats: Regeln för Stateless måste följas för alla komponenter utan undantag, även om det verkar som "här kommer vi definitivt inte att stöta på problem". Det är bättre att lägga lite tid på att organisera hur alla system fungerar rätt än att i panik behöva skriva om koden och fixa en tjänst som lider av överbelastning.
7 principer för intensiv tillväxt
Trots tillgången på extra resurser trampade vi under tillväxten på några minor. Under denna tid har antalet beställningar ökat med mer än fyra gånger. Nu levererar vi redan mer än 17 000 beställningar om dagen i 62 städer och planerar att ytterligare utöka geografiskt — under första halvan av 2020 förväntas lanseringen av tjänsten över hela Ryssland. För att hantera den växande belastningen, med tanke på de misstag vi redan har lärt oss av, har vi identifierat 7 grundläggande principer för arbete under konstant tillväxt:
- Incidenthantering. Vi skapade en tavla i Jira där varje incident återspeglas som en ticket. Detta hjälper oss faktiskt att prioritera och utföra uppgifter relaterade till incidenten. Det är ju i grunden inte farligt att göra misstag — det är farligt att göra samma misstag två gånger. För de fall där incidenter upprepas innan vi har möjlighet att åtgärda orsaken, bör en handlingsplan vara redo, eftersom det är viktigt att reagera blixtsnabbt under hög belastning.
- Övervakning krävs för alla infrastrukturens komponenter utan undantag. Tack vare det kunde vi förutsäga belastningsökningen och korrekt välja "flaskhalsar" för prioritering av åtgärder. Sannolikt kommer allt som du inte ens tänkte på att bryta ihop eller börja bromsa vid hög belastning. Därför är det bäst att skapa nya varningar direkt efter att de första incidenterna inträffat, för att övervaka och förutse dem.
- Korrekt varningar är helt nödvändiga vid en plötslig belastningsökning. För det första ska de rapportera exakt vad som har gått sönder. För det andra får det inte finnas för många varningar, eftersom en överflöd av icke-kritiska varningar leder till att alla meddelanden ignoreras.
- Applikationer måste vara stateless. Vi har insett att det inte får finnas några undantag från denna regel. Fullständig oberoende från körningsmiljön behövs. För detta kan du lagra delade data i en databas eller, till exempel, direkt i S3. Det är också bättre att följa reglerna. Vid en plötslig ökning finns det helt enkelt ingen tid för att optimera koden, och du måste hantera belastningen genom att direkt öka datorkapaciteten och tillämpa horisontell skalning.
- Kvoter och prestanda för externa tjänster. Vid snabb tillväxt kan problemet uppstå inte bara i din infrastruktur, utan även i den externa tjänsten. Det mest frustrerande är när det händer inte på grund av ett fel, utan på grund av att kvoter eller gränser nås. Så externa tjänster måste skala lika bra som du själv.
- Separera processer och köer. Detta hjälper mycket när det uppstår en blockering vid en av gatewayarna. Vi skulle inte ha stött på några förseningar i dataöverföringen om de fulla SMS-sändningsköerna inte hade hindrat kommunikationen mellan informationssystemen. Och det skulle ha varit lättare att öka antalet arbetare om de hade arbetat separat.
- Finansiella realiteter. När datavolymerna ökar explosionsartat finns det ingen tid att tänka på taxor och prenumerationer. Men man måste komma ihåg dem, särskilt om man är ett litet företag. En stor räkning kan utfärdas av ägaren av vilket API som helst, liksom av din hostingleverantör. Så det är viktigt att läsa avtalen noga.
Slutsats
Inte utan förluster, men vi klarade av det steget, och idag försöker vi följa alla hittade principer, och varje maskin har möjlighet att enkelt öka prestandan fyra gånger för att hantera oväntade situationer.
I kommande inlägg kommer vi att dela med oss av vår erfarenhet av att undersöka prestandafall i Apache Solr, samt berätta om optimering av frågorna och hur samarbetet med skattemyndigheten hjälper företaget att spara pengar. Prenumerera på vår blogg så att du inte missar något och berätta i kommentarerna om du har stött på liknande problem under trafikökningar.
Endast registrerade användare kan delta i omröstningen. , tack.
Har du upplevt fördröjning eller nedgång i service vid en plötslig ökning av belastningen på grund av:
55,6%Oförmåga att snabbt lägga till beräkningsresurser 10
16,7%Begränsningar från webbhotellens infrastruktur 3
33,3%Begränsningar från externa API:er 6
27,8%Överträdelse av principerna för stateless i dina applikationer 5
88,9%Ineffektiv kod i egna tjänster 16
18 användare röstade. 6 användare avstod.
Källa: habr.com
