

Idag krävs hög tillgänglighet för tjänster alltid och överallt, inte bara i stora dyra projekt. Tillfälligt otillgängliga webbplatser med meddelandet "Förlåt, tekniskt underhåll pågår" förekommer fortfarande, men framkallar vanligtvis en överseende leende. Lägg därtill livet i molnet, där det bara krävs ett API-anrop för att starta en extra server, utan att behöva tänka på 'hårdvaru' drift. Det finns därmed inga ursäkter för varför ett kritiskt system inte har byggts på ett tillförlitligt sätt med hjälp av klusterteknologier och redundans.
Vi kommer att berätta om de lösningar vi övervägde för att säkerställa pålitlighet i databaser i våra tjänster och vad vi kom fram till. Plus en demo med långtgående slutsatser.
Legacy i arkitektur för hög tillgänglighet
Detta blir tydligare när man ser på utvecklingen av olika opensource-system. Gamla lösningar tvingades att lägga till teknologier för hög tillgänglighet i takt med att efterfrågan ökade. Kvaliteten på dessa lösningar varierade. Nyare generationers lösningar bygger hög tillgänglighet i grunden av sin arkitektur. Till exempel positionerar MongoDB kluster som det primära användningsområdet. Kluster kan skalas horisontellt, vilket utgör en stark konkurrensfördel för denna databashanterare.
Låt oss tillbaka till PostgreSQL. Det är ett av de äldsta populära opensource-projekten, vars första version släpptes 1995. Projektteamet ansåg länge inte att hög tillgänglighet var en uppgift som behövde lösas från systemets sida. Därför blev replikationstekniken för att skapa datakopior först inbyggd i version 8.2 2006, men det var en filbaserad (log shipping). I version 9.0 2010 introducerades strömreplikation, och den är grundläggande för att skapa olika kluster. Detta förvånar faktiskt människor som lär känna PostgreSQL efter Enterprise SQL eller moderna NoSQL - standardlösningen från communityn är helt enkelt ett par master-replica med synkron eller asynkron replikation. Vid det här laget görs växling av master manuellt, och frågan om klientväxling uppmanas också att lösas självständigt.
Hur vi beslutade att skapa en pålitlig PostgreSQL och vad vi valde för det
Trots allt skulle inte PostgreSQL vara så populärt om det inte fanns ett stort antal projekt och verktyg som hjälper till att bygga en hög tillgänglighetslösning som inte kräver ständig uppmärksamhet. I molnet (MCS) har enskilda PostgreSQL-servrar och par av master-replikor med asynkron replikering varit tillgängliga sedan starten av DBaaS.
Självklart ville vi förenkla livet för alla och göra installationen av PostgreSQL tillgänglig, så att den kunde fungera som grund för hög tillgängliga tjänster, utan att man hela tiden behövde övervaka den eller vakna på natten för att göra en failover. I detta segment finns både gamla beprövade lösningar och en generation av nya verktyg som använder de senaste framstegen.
I dag handlar problemet med hög tillgänglighet inte om redundans (det är en självklarhet) utan om konsensus – algoritmen för ledarval (Leader election). Oftast inträffar stora haverier inte på grund av brist på servrar, utan på grund av problem med konsensus: ingen ny ledare valdes, det fanns två ledare i olika datacenter, etc. Ett exempel är haveriet på MySQL-klustret Github – de skrev .
Den matematiska grunden för denna fråga är mycket seriös. Å ena sidan finns det , som ställer teoretiska begränsningar för möjligheterna att bygga HA-lösningar, och å den andra sidan finns det matematiskt bevisade algoritmer för att avgöra konsensus, såsom och . På dessa grunder finns det ganska populära DCS (decentraliserade konsensusystem) – Zookeeper, etcd, Consul. Därför, om beslutsfattande-systemet arbetar med någon egen algoritm som skrivits självständigt, bör man vara extremt försiktig med den. Efter att ha analyserat ett stort antal system valde vi Patroni – ett open-source-system som huvudsakligen utvecklas av företaget Zalando.
Som ett lyriskt avsnitt kan jag säga att vi också övervägde multi-master-lösningar, det vill säga kluster som kan skalas horisontellt för skrivning. Men av två huvudskäl beslutade vi oss för att inte göra ett sådant kluster. För det första har sådana lösningar hög komplexitet och därmed fler sårbara punkter. Det kommer att vara svårt att skapa en stabil lösning för alla situationer. För det andra slutar PostgreSQL att vara rent (native), vissa funktioner kommer att vara otillgängliga och vissa applikationer kan få dolda buggar under drift.
Patroni
Så hur fungerar Patroni? Utvecklarna valde att inte uppfinna hjulet på nytt och föreslog att använda en av de beprövade DCS-lösningarna som grund. Allt som rör synkronisering av konfigurationer, val av ledare och kvorum lämnas till det. Vi valde etcd för detta.
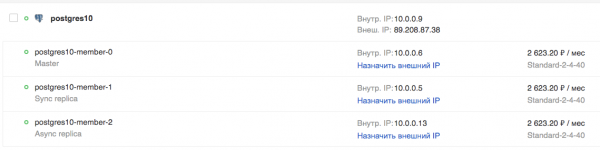
Därefter ansvarar Patroni för korrekt tillämpning av alla inställningar på PostgreSQL och inställning av replikering samt utförande av kommandon för switchover och failover (det vill säga - planerat och oplanerat byte av master). Specifikt i molnet MCS kan man skapa ett kluster av en master, en synkron replik och en eller flera asynkrona replikar. Närvaron av en synkron replik säkerställer dataskydd på minst 2 servrar, och just denna replik kommer att vara den främsta "kandidaten till master".
Eftersom etcd körs på samma servrar rekommenderas antalet servrar att vara 3 eller 5 för ett optimalt kvorum. Ett sådant kluster kan skalas horisontellt för läsning (om horizontal skalning för skrivning har jag skrivit ovan). Det bör dock beaktas att asynkrona replikar kan ha eftersläpning, särskilt vid hög belastning.
Användningen av sådana läsreplikar (hot standby) är rimlig för rapporterings- eller analyssyften och avlastar masterservrar.
Om du vill skapa ett sådant kluster själv behöver du:
- förbereda 3 eller fler servrar, konfigurera IP-adressering och brandväggsregler mellan dem;
- installera paket för tjänsterna etcd, Patroni, PostgreSQL;
- konfigurera etcd-klustret;
- konfigurera patroni-tjänsten för att arbeta med PostgreSQL.
Det vill säga, i stort sett behöver du korrekt skapa ett tiotal konfigurationsfiler och inte göra några misstag. För detta är det definitivt värt att använda ett verktyg för konfigurationshantering, som Ansible till exempel. Samtidigt saknas fortfarande en högtillgänglig TCP-lastbalanserare. Att skapa en sådan är ett separat arbete.
För dem som behöver en färdig klusterlösning, men inte vill gräva sig ner i allt detta, har vi försökt förenkla livet och gjort en färdig klusterlösning på Patroni i vårt moln, som kan testas kostnadsfritt. Förutom själva klustret har vi också skapat:
- En TCP-lastbalanserare; den pekar alltid på den aktuella masterservern via olika portar, samt en synkron eller asynkron replik, beroende på situationen;
- Ett API för att byta aktiv master på Patroni.
De kan anslutas både via MCS-molnets API och via webbkonsolet.
Demo
För att testa möjligheterna hos PostgreSQL-klustret i MCS-molnet, låt oss se hur en levande applikation beter sig vid problem med databashanteringssystemet.
Nedan presenteras koden för en applikation som kommer att logga konstgjorda händelser och rapportera detta på skärmen. Vid eventuella fel kommer den att meddela detta och fortsätta sitt arbete i en loop tills vi stoppar den med en Ctrl + C.
from __future__ import print_function

from datetime import datetime
from random import randint
from time import sleep
import psycopg2


def main():
    try:
        connection = psycopg2.connect(user = "admin",
                                      password = "P@ssw0rd",
                                      host = "89.208.87.38",
                                      port = "5432",
                                      database = "myproddb")

        cursor = connection.cursor()
        cursor.execute("SELECT version();")
        record = cursor.fetchone()
        print("Anslutning öppen till", record[0])

        cursor.execute(
            "INSERT INTO log VALUES ({});".format(randint(1, 10000)))
        connection.commit()
        cursor.execute("SELECT COUNT(event_id) from log;")
        record = cursor.fetchone()
        print("En värde har registrerats, totalt antal: {}".format(record[0]))
    except Exception as error:
        print ("Fel vid anslutning till PostgreSQL", error)
    finally:
        if connection:
            cursor.close()
            connection.close()
            print("Anslutning stängd")


if __name__ == '__main__':
    try:
        while True:
            try:
                print(datetime.now())
                main()
                sleep(3)
            except Exception as e:
                print("Fångad fel:n", e)
                sleep(1)
    except KeyboardInterrupt:
        print("avsluta")
Applikationen för arbete behöver PostgreSQL. Låt oss skapa ett kluster i MCS-molnet med hjälp av API:et. I en vanlig terminal, där OS_TOKEN-variabeln innehåller token för åtkomst till API:et (kan fås med kommandot openstack token issue), skriver vi in kommandona:
Vi skapar ett kluster:
cat < pgc10.json
{"cluster":{"name":"postgres10","allow_remote_access":true,"datastore":{"type":"postgresql","version":"10"},"databases":[{"name":"myproddb"}],"users":[{"databases":[{"name":"myproddb"}],"name":"admin","password":"P@ssw0rd"}],"instances":[{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}}]}}
EOF

curl -s -H "X-Auth-Token: $OS_TOKEN"
-H 'Accept: application/json'
-H 'Content-Type: application/json'
-d @pgc10.json https://infra.mail.ru:8779/v1.0/ce2a41bbd1434013b85bdf0ba07c770f/clusters
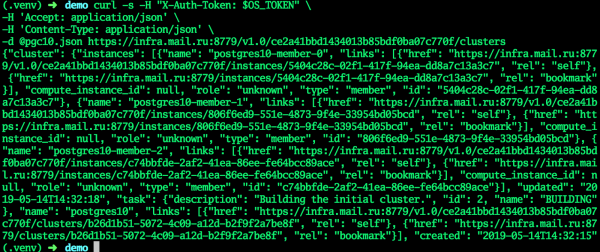
När klustret går in i status ACTIVE kommer alla fält att få aktuella värden - klustret är redo.
I GUI:
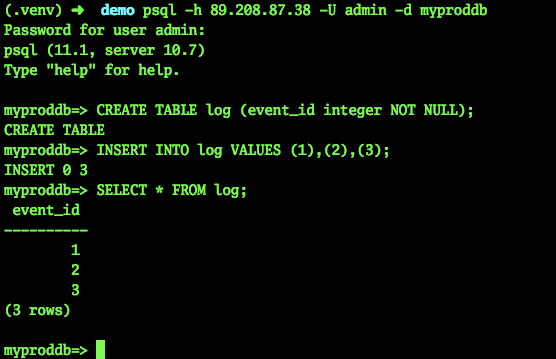
Låt oss försöka ansluta och skapa en tabell:
psql -h 89.208.87.38 -U admin -d myproddb
Lösenord för användare admin:
psql (11.1, server 10.7)
Skriv "help" för hjälp.

myproddb=> CREATE TABLE log (event_id integer NOT NULL);
CREATE TABLE
myproddb=> INSERT INTO log VALUES (1),(2),(3);
INSERT 0 3
myproddb=> SELECT * FROM log;
 event_id
----------
        1
        2
        3
(3 rows)

myproddb=>
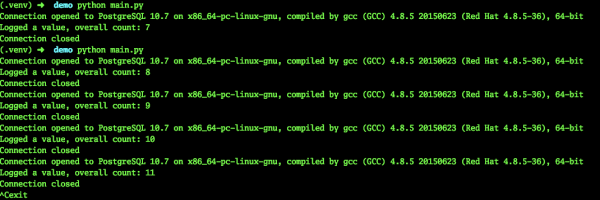
I applikationen anger vi aktuella inställningar för att ansluta till PostgreSQL. Vi anger TCP-balancerarens adress, vilket innebär att vi slipper byta manuellt till mästarens adress. Vi startar den. Som syns, loggas händelserna framgångsrikt i databasen.
Planerat byte av mästare
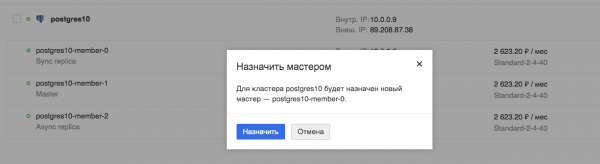
Nu testar vi vår applikations funktionalitet vid planerat byte av mästare:
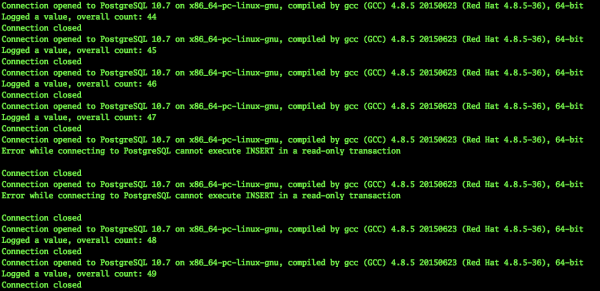
Vi observerar applikationen. Vi ser att applikationens funktionalitet faktiskt avbryts, men det tar bara några sekunder, i det här specifika fallet, max 9.
Nedstängning av maskin
Nu ska vi försöka simulera nedstängning av den virtuella maskinen, som för närvarande är mästare. Man skulle enkelt kunna stänga av den virtuella maskinen via Horizon-gränssnittet, men det skulle vara en normal avstängning. En sådan omkoppling kommer att hanteras av alla tjänster, inklusive Patroni.
Vi behöver en oförutsägbar avstängning. Därför har jag bett våra administratörer att för teständamål stänga av den virtuella maskinen — den nuvarande mästaren — på ett onormalt sätt.
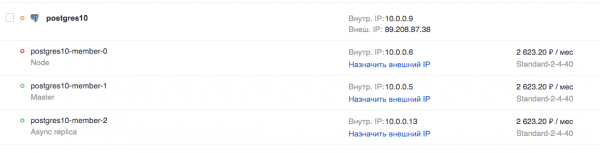
Under tiden fortsatte vår applikation att fungera. Naturligtvis kan ett sådant akut byte av mästare inte ske utan att märkas.
2019-03-29 10:45:56.071234
Anslutning öppnad till PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilerad av gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Loggad ett värde, totalt antal: 453
Anslutning stängd
2019-03-29 10:45:59.205463
Anslutning öppnad till PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilerad av gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Loggad ett värde, totalt antal: 454

Anslutning stängd
2019-03-29 10:46:02.661440
Fel vid anslutning till PostgreSQL-servern stängde anslutningen oväntat
        Detta betyder troligtvis att servern avslutades onormalt
        innan eller medan begäran behandlades.

Hittat fel:
 lokal variabel 'connection' refererad innan tilldelning
……………………………………………………….. - här är ett antal fel
2019-03-29 10:46:30.930445
Fel vid anslutning till PostgreSQL-servern stängde anslutningen oväntat
        Detta betyder troligtvis att servern avslutades onormalt
        innan eller medan begäran behandlades.

Hittat fel:
 lokal variabel 'connection' refererad innan tilldelning
2019-03-29 10:46:31.954399
Anslutning öppnad till PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilerad av gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Loggad ett värde, totalt antal: 455
Anslutning stängd
2019-03-29 10:46:35.409800
Anslutning öppnad till PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilerad av gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Loggad ett värde, totalt antal: 456
Anslutning stängd
^Cexit
Som framgår kunde applikationen fortsätta sitt arbete på mindre än 30 sekunder. Ja, vissa användare av tjänsten kommer att märka problemen. Men det här är en allvarlig serverkrasch, något som inte inträffar så ofta. Dessutom skulle en person (administratören) troligtvis inte ha kunnat reagera så snabbt, om hen inte satt vid konsolen med ett skript för att byta.
Utdata
Enligt min åsikt ger en sådan kluster en enorm fördel för administratörer. I princip kommer allvarliga krasch och systemfel på databasservrarna inte att märkas av applikationen och därmed inte av användaren. Det blir inte nödvändigt att snabbt åtgärda något och byta till temporära konfigurationer, servrar etc. Om en sådan lösning används som en färdig tjänst i molnet, behöver man inte lägga tid på förberedelse. Man kan istället fokusera på mer intressanta uppgifter.
Källa: habr.com
