

Jag heter Pavel Parkhomenko och jag är ML-utvecklare. I den här artikeln skulle jag vilja berätta om hur Yandex Zen-tjänsten fungerar och dela med mig av tekniska förbättringar som har gjort det möjligt att öka kvaliteten på rekommendationerna. I inlägget kommer du att lära dig hur man hittar de mest relevanta dokumenten för användaren bland miljoner dokument på bara några millisekunder; hur man gör kontinuerlig nedbrytning av en stor matris (som består av miljoner kolumner och tiotals miljoner rader), så att nya dokument får sin vektor på bara några minuter; hur man återanvänder nedbrytning av matrisen användare-artikel för att få en bra vektorrepräsentation för videor.
Vår rekommendationsdatabas innehåller miljoner dokument i olika format: textartiklar skapade på vår plattform och hämtade från externa webbplatser, videor, berättelser och korta inlägg. Utvecklingen av en sådan tjänst är kopplad till ett stort antal tekniska utmaningar. Här är några av dem:
- Dela upp beräkningsuppgifterna: alla tunga operationer ska göras offline, medan vi endast ska utföra snabb tillämpning av modeller i realtid för att svara inom 100-200 ms.
- Snabbt ta hänsyn till användarens handlingar. För detta behöver alla händelser omedelbart levereras till rekommendatorn och påverka modellernas resultat.
- Göra flödet så att det snabbt anpassar sig till nya användares beteende. Nya användare som just kommit in i systemet måste känna att deras feedback påverkar rekommendationerna.
- Snabbt förstå vem man ska rekommendera en ny artikel till.
- Omedelbart reagera på det ständiga flödet av nytt innehåll. Tiotusentals artiklar publiceras varje dag, och många av dem har en begränsad livslängd (låt oss säga nyheter). Detta skiljer dem från filmer, musik och annat långlivat och kostsamt innehåll.
- Överföra kunskaper från ett domänområde till ett annat. Om det finns utbildade modeller för textartiklar i rekommendationssystemet och vi lägger till videor kan vi återanvända befintliga modeller så att nytt innehåll rankas bättre.
Jag kommer att berätta hur vi löste dessa uppgifter.
Urval av kandidater
Hur man på några millisekunder kan minska mängden dokument som övervägs tusenfalt, utan att försämra rankingkvaliteten avsevärt?
Anta att vi har tränat många ML-modeller, genererat funktioner baserade på dem och tränat en annan modell som rankar dokument för användaren. Det skulle vara bra, men man kan inte bara beräkna alla funktioner för alla dokument i realtid, om det handlar om miljontals dokument och rekommendationer måste byggas på 100-200 ms. Utmaningen är att välja ett delmängd av miljontals dokument som ska rankas för användaren. Steget kallas vanligtvis kandidatselektion. Det finns flera krav på detta steg. För det första måste valet gå mycket snabbt så att det finns så mycket tid som möjligt kvar för själva rankningen. För det andra, genom att kraftigt minska antalet dokument för rankning, måste vi bevara så relevanta dokument för användaren som möjligt.
Vår princip för kandidatselektion har utvecklats över tid, och just nu har vi kommit fram till ett flerlagersschema:
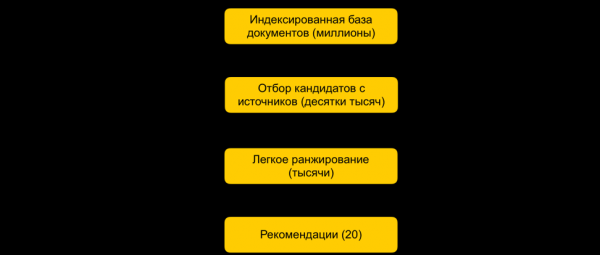
Först delas alla dokument upp i grupper, och från varje grupp väljs de mest populära dokumenten. Grupper kan vara webbplatser, ämnen, kluster. För varje användare anges de närmaste grupperna baserat på dess historik, och de bästa dokumenten tas från dessa. Vi använder dessutom ett kNN-index för att snabbt kunna hitta de mest relevanta dokumenten för användaren i realtid. Det finns flera metoder för att bygga kNN-index, och vår metod som har funkat bäst är (Hierarchical Navigable Small World graphs). Detta är en hierarkisk modell som gör det möjligt att på några millisekunder hitta de N närmaste vektorerna för användaren från en bas av miljoner. Vi indexerar hela vår dokumentbas offline i förväg. Eftersom sökningen i indexet går ganska snabbt kan man, vid tillgång till flera starka inbäddningar, skapa flera index (ett för varje inbäddning) och få åtkomst till var och en av dem i realtid.
Vi har tiotusentals dokument för varje användare. Det är fortfarande mycket att räkna på alla attribut, så i det här steget tillämpar vi en lätt rangordning — en förenklad modell av tung rangordning med färre attribut. Målet är att förutsäga vilka dokument som kommer att hamna på toppen hos den tunga modellen. Dokument med högst prediktion kommer att användas i den tunga modellen, det vill säga i det sista rangordningssteget. Denna metod gör att vi på några tiotal millisekunder kan minska mängden dokument som övervägs för användaren från miljoner till tusentals.
ALS-steget i realtid
Hur beaktar man användarfeedback direkt efter klick?
En viktig faktor i rekommendationer är responstiden på användarfeedback. Detta är särskilt viktigt för nya användare: när en person först börjar använda rekommendationssystemet får han en opersonifierad flöde av dokument av olika ämnen. Så snart han gör sitt första klick måste detta beaktas omedelbart och anpassas efter hans intressen. Om man beräknar alla faktorer offline blir systemets snabba respons omöjlig på grund av fördröjning. Så det är nödvändigt att bearbeta användarens åtgärder i realtid. För detta syfte använder vi ALS-steget i realtid för att bygga en vektorrepresentation av användaren.
Anta att vi har en vektorrepresentation för alla dokument. Till exempel kan vi offline bygga inbäddningar baserade på texten i artikeln med hjälp av ELMo, BERT eller andra maskininlärningsmodeller. Hur får man en vektorrepresentation av användarna i samma rum baserat på deras interaktioner i systemet?
Den allmänna principen för att bilda och dekomponera användardokumentmatrisenLåt oss säga att vi har m användare och n dokument. För vissa användare är deras relation till vissa dokument känd. Denna information kan då representeras i en matris m x n: raderna motsvarar användarna och kolumnerna — dokumenten. Eftersom de flesta dokument en person inte har sett, kommer en stor del av cellerna i matrisen att förbli tomma, medan andra kommer att fyllas i. För varje händelse (gilla, ogilla, klicka) finns det ett visst värde i matrisen — men låt oss överväga en förenklad modell där ett gilla motsvarar 1, och ett ogilla –1.
Vi delar upp matrisen i två: P (m x d) och Q (d x n), där d är dimensionen av den vektoriska representationen (vanligtvis ett litet tal). Då motsvarar varje objekt en d-dimensionell vektor (användaren — en rad i matrisen P, dokumentet — en kolumn i matrisen Q). Dessa vektorer kommer att vara inbäddningar av motsvarande objekt. För att förutsäga om en användare kommer att gilla ett dokument kan vi helt enkelt multiplicera deras inbäddningar.
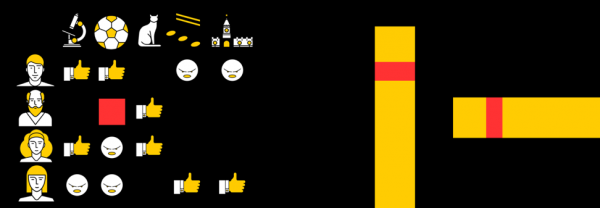
Ett av de möjliga sätten att dekonstruera matrisen är ALS (Alternating Least Squares). Vi kommer att optimera följande förlustfunktion:

Här är rui — interaktionen mellan användaren u och dokumentet i, qi — vektorn för dokument i, pu — vektorn för användare u.
Då hittas den optimala vektorn för användaren (med fasta dokumentvektorer) analytiskt genom att lösa den motsvarande linjära regressionen.
Detta kallas "steget ALS". Själva algoritmen för ALS går ut på att vi växelvis håller en av matriserna (användarna och artiklarna) fixa och uppdaterar den andra, med målet att hitta den optimala lösningen.
Lyckligtvis är det en ganska snabb operation att hitta den vektoriska representationen av användaren, vilken kan göras i realtid med hjälp av vektorinstruktioner. Denna trick gör att vi genast kan ta hänsyn till användarens feedback i rankningen. Samma inbäddning kan också användas i kNN-indexet för att förbättra urvalet av kandidater.
Distribuerad kollaborativ filtrering
Hur man gör inkrementell distribuerad matrisfaktorisering och snabbt finner den vektoriska representationen av nya artiklar?
Innehåll är inte den enda källan till signaler för rekommendationer. En annan viktig källa är den kollaborativa informationen. Bra indikationer för rangordning kan traditionellt fås genom att bryta ner användardokumentmatrisen. Men när vi försökte göra en sådan nedbrytning stötte vi på problem:
1. Vi har miljoner dokument och tiotals miljoner användare. Matrisen får inte plats på en enda dator, och nedbrytningen kommer att ta väldigt lång tid.
2. Den största delen av innehållet i systemet har kort livslängd: dokumenten förblir relevanta endast i några timmar. Därför är det nödvändigt att skapa deras vektorrepresentation så snabbt som möjligt.
3. Om nedbrytningen görs direkt efter publiceringen av dokumentet kommer det inte att ha utvärderats av tillräckligt många användare. Därför kommer dess vektorrepresentation med stor sannolikhet att vara av ganska dålig kvalitet.
4. Om en användare ger en positiv eller negativ feedback kan vi inte direkt beakta detta i nedbrytningen.
För att lösa de nämnda problemen har vi implementerat en distribuerad nedbrytning av användardokumentmatrisen med frekventa inkrementella uppdateringar. Hur fungerar detta?
Anta att vi har en kluster av N datorer (N räkna hundratals) och vi vill göra en distribuerad nedbrytning av matrisen som inte får plats på en enda dator. Frågan är hur vi ska genomföra denna nedbrytning så att, å ena sidan, varje dator har tillräckligt med data och, å andra sidan, att beräkningarna är oberoende?
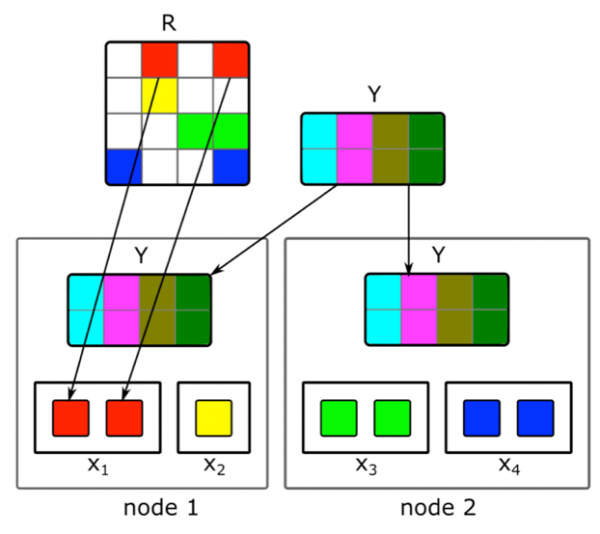
Vi kommer att använda den ovan beskrivna ALS-nedbrytningsalgoritmen. Låt oss se hur ett steg av ALS utförs i distribuerad form – de övriga stegen kommer att vara liknande. Anta att vi har låst dokumentmatrisen och vi vill bygga användarmatrisen. För detta kommer vi att dela upp den i N delar efter rader, varje del kommer att innehålla ungefär lika många rader. Vi skickar icke-tomma celler från aktuella rader till varje dator, samt hela dokumentens embeddingsmatris. Eftersom den inte har så stor storlek och användardokumentmatrisen vanligtvis är mycket gles, får dessa data plats på en vanlig dator.
Denna teknik kan upprepas under flera epoker tills modellens konvergens, genom att växla den fasta matrisen. Men även då kan matrisfaktorisering ta flera timmar. Och det löser inte problemet att snabbt få inbäddningar för nya dokument och uppdatera inbäddningar för dem som hade lite information när modellen byggdes.
Vi har hjälpt till med att införa en snabb inkrementell uppdatering av modellen. Anta att vi har en aktuell tränad modell. Sedan dess har nya artiklar dykt upp, som våra användare har interagerat med, samt artiklar som hade lite interaktion under träningen. För att snabbt få inbäddningar för sådana artiklar använder vi inbäddningar för användare som fick under den första stora träningen av modellen, och vi gör ett steg av ALS för att beräkna dokumentmatrisen med en fast användarmatris. Detta möjliggör att få inbäddningar ganska snabbt — inom några minuter efter publiceringen av dokumentet — och ofta uppdatera inbäddningar för nya dokument.
För att användarens handlingar ska beaktas omgående använder vi inte användarinbäddningarna som erhölls offline i realtid. Istället gör vi ett steg av ALS och får den aktuella användarvektorn.
Överföring till ett annat domänområde
Hur kan vi använda användarfeedback på textartiklar för att skapa en vektorrepresentation av videor?
Inledningsvis rekommenderade vi endast textartiklar, så många av våra algoritmer är anpassade för denna typ av innehåll. Men när vi lade till innehåll av annan typ ställdes vi inför behovet av att anpassa modellerna. Hur löste vi denna uppgift med videoinnehåll? Ett alternativ är att träna om alla modeller från grunden. Men detta tar tid, dessutom är vissa algoritmer krävande när det kommer till storleken på träningsdata, som ännu inte finns i tillräcklig mängd för det nya typen av innehåll under de första ögonblicken av dess liv på tjänsten.
Vi valde en annan väg och återanvände textmodeller för videor. I skapandet av vektorrepräsentationer av videor hjälpte samma trick med ALS oss. Vi tog användarnas vektorrepräsentation baserad på textartiklar och gjorde ett ALS-steg, med hjälp av information om videovisningar. Så vi fick enkelt vektorrepräsentationen av videon. Vid körning beräknar vi bara närheten mellan användarens vektor, som erhållits baserat på textartiklar, och videovektorn.
Slutsats
Utvecklingen av kärnan i det realtidsbaserade rekommendationssystemet är förenad med många utmaningar. Det krävs snabb databehandling och tillämpning av ML-metoder för att effektivt använda dessa data; bygga komplexa distribuerade system som kan bearbeta användarsignaler och nya innehållsenheter på minimal tid; och många andra uppgifter.
I det nuvarande systemet, vars arkitektur jag beskrev, ökar kvaliteten på rekommendationerna för användaren i takt med hans aktivitet och den tid han spenderar på tjänsten. Men självklart ligger den största svårigheten här: systemet har svårt att snabbt förstå intressena hos en person som har interagerat minimalt med innehållet. Förbättringen av rekommendationer för nya användare är vår centrala uppgift. Vi kommer att fortsätta optimera algoritmerna så att relevant innehåll snabbare når deras flöde, medan irrelevant innehåll inte visas.
Källa: habr.com
