

Jag heter Anton Baderyn. Jag arbetar på Center for High Technologies och ägnar mig åt systemadministration. För en månad sedan avslutades vår företagskonferens där vi delade med oss av våra erfarenheter med IT-gemenskapen i vår stad. Jag pratade om övervakning av webbapplikationer. Materialet var avsett för junior- eller medelnivå, som ännu inte har byggt upp denna process från grunden.
Stolpen som ligger till grund för varje övervakningssystem är att lösa affärens problem. Övervakning för övervakningens skull intresserar ingen. Vad vill affären? Att allt ska fungera snabbt och utan fel. Affären vill ha proaktivitet, så att vi själva kan identifiera problem i tjänstens drift och snabbt åtgärda dem. Detta är i grunden de uppgifter jag har löst under hela förra året i projektet för en av våra kunder.
Om projektet
Projektet är ett av de största lojalitetsprogrammen i landet. Vi hjälper detaljhandelskedjor att öka försäljningsfrekvensen genom olika marknadsföringsverktyg som bonuskort. Totalt ingår 14 applikationer i projektet som arbetar på tio servrar.
Vid genomförande av intervjuer har jag flera gånger observerat att administratörer inte alltid närmar sig övervakningen av webbapplikationer på rätt sätt: fortfarande är det många som stannar vid operativsystemets metrik och sällan övervakar tjänster.
I mitt fall vilade systemet för kundens övervakning tidigare på Icinga. Den löste inte de angivna problemen. Ofta rapporterade kunden själva problem till oss och vi hade oftast inte tillräckligt med data för att komma till rotorsaken.
Dessutom fanns det en tydlig förståelse för meningslösheten i hennes vidare utveckling. Jag tror att de som är bekanta med Icinga förstår mig. Så vi beslutade att helt omarbeta systemet för övervakning av webbapplikationer i projektet.
Prometheus
Vi valde Prometheus baserat på tre huvudindikatorer:
- Ett stort antal tillgängliga metrik. I vårt fall är de 60 000. Naturligtvis bör det påpekas att majoriteten av dem knappt används (troligen omkring 95%). Å andra sidan är de alla relativt billiga. För oss är detta den andra extremen jämfört med det tidigare använda Icinga. I den var tillägg av metrik en särskild plåga: de befintliga kostade dyrt (det räcker att titta på källkoden för vilket plugin som helst). Varje plugin var ett skript i Bash eller Python, vars körning inte är billig i fråga om resursanvändning.
- Detta system konsumerar relativt få resurser. För alla våra metrik räcker 600 MB RAM, 15% av en kärna och ett par dussin IOPS. Naturligtvis måste exportörer av metrik köras, men de är alla skrivna i Go och skiljer sig inte heller i resurskrav. Jag tror inte att detta är ett problem i dagens läge.
- Ger möjlighet till övergång till Kubernetes. Med tanke på kundens planer är valet uppenbart.
ELK
Tidigare samlade vi inte och bearbetade inte loggar. Nackdelarna är uppenbara för alla. Vi valde ELK eftersom vi redan hade erfarenhet av att arbeta med detta system. Vi lagrar endast applikationsloggar där. De viktigaste urvalskriterierna var fulltextsökning och dess hastighet.
Clickhouse
Ursprungligen föll valet på InfluxDB. Vi insåg behovet av att samla loggar från Nginx, statistik från pg_stat_statements, lagra historiska data från Prometheus. Influx föll inte i smaken, eftersom det då och då började konsumera stora mängder minne och kraschade. Dessutom ville vi gruppera förfrågningar efter remote_addr, men gruppering i denna databas var endast möjlig efter taggar. Taggar är dyra (minne), och deras antal är begränsat.
Vi började sökandet på nytt. Vi behövde en analytisk databas med minimal resursanvändning, helst med data komprimering på disken.
Clickhouse uppfyller alla dessa kriterier, och vi har inte ångrat vårt val en enda gång. Vi skriver inte in några exceptionellt stora datamängder (antalet insättningar är bara cirka fem tusen per minut).
NewRelic
NewRelic har historiskt varit med oss, eftersom det var kundens val. Vi använder det som APM.
Zabbix
Vi använder Zabbix uteslutande för att övervaka Black Box av olika API.
Bestämning av övervakningsmetod
Vi ville dekomponera uppgiften och på så sätt systematisera tillvägagångssättet för övervakning.
För detta har jag delat vårt system i följande nivåer:
- hårdvara och VMS;
- operativsystem;
- systemtjänster, programvarustack;
- applikation;
- affärslogik.
Vad som är praktiskt med detta tillvägagångssätt:
- vi vet vem som är ansvarig för att varje nivå fungerar och i enlighet med detta kan vi skicka varningar;
- vi kan använda strukturen vid undertryckning av varningar – det skulle vara märkligt att skicka en varning om en databas inte är tillgänglig när hela den virtuella maskinen är otillgänglig.
Eftersom vår uppgift är att identifiera överträdelser i systemets funktion, bör vi på varje nivå identifiera ett visst antal mätvärden som vi bör uppmärksamma när vi skriver regler för varningar. Låt oss gå igenom nivåerna 'VMS', 'Operativsystem' och 'Systemtjänster, programvarustack'.
Virtuella maskiner
Hosting utser en processor, disk, minne och nätverk till oss. Och med de två första hade vi problem. Så, mätvärden:
CPU stolen time – när du köper en virtuell maskin på Amazon (t.ex. t2.micro) bör du förstå att du inte får en hel kärna av processorn, utan bara en kvot av dess tid. Och när du har förbrukat det, börjar processorn bli stulen.
Detta mätvärde gör att vi kan övervaka sådana ögonblick och fatta beslut. Till exempel, behöver vi ta en bättre plan eller dela upp bearbetningen av bakgrundsuppgifter och API-förfrågningar på olika servern.
IOPS + CPU iowait time – av någon anledning har många molnhostingtjänster en tendens att inte ge tillräckligt med IOPS. Dessutom är en graf med låga IOPS inget argument för dem. Därför är det värt att samla både IOPS och CPU iowait. Med detta par av grafer – med låga IOPS och hög i/o-väntan – kan man redan börja prata med hostingleverantören och lösa problemet.
Operativsystem
Mätvärden för operativsystemet:
- andelen tillgängligt minne i %;
- aktivitet av swap-användning: vmstat swapin, swapout;
- antal tillgängliga inode och ledigt utrymme på filsystemet i %
- genomsnittlig belastning;
- antal anslutningar i tillstånd tw;
- fyllning av conntrack-tabellen;
- kvaliteten på nätverksarbetet kan övervakas med hjälp av verktyget ss, med paketet iproute2 – få från dess utdata indikatorn för RTT-anslutningar och gruppera efter dest-port.
Även på nivå operativsystem får vi en entitet som processer. Det är viktigt att identifiera en uppsättning processer i systemet som spelar en viktig roll i dess funktion. Om du till exempel har flera pgpool, behöver du samla in information om var och en av dem.
Uppsättningen av mätvärden är följande:
- CPU;
- minne är främst resident;
- IO – helst i IOPS;
- FileFd – öppna och begränsningar;
- betydande sidor avvisningar – så kan du förstå vilken process som swappar.
All övervakning är distribuerad i Docker, för att samla in metricsdata använder vi Cadvisor. På andra maskiner använder vi process-exporter.
Systemtjänster, mjukvarustack
Varje applikation har sina specifika egenskaper, och det är svårt att lyfta fram något visst set av metrics.
Ett universellt set är:
- frågefrekvens;
- antal fel;
- latens;
- saturation.
De mest uppenbara exemplen på övervakning på denna nivå hos oss är – Nginx och PostgreSQL.
Den mest belastade tjänsten i vårt system är databasen. Tidigare hade vi ganska ofta problem med att ta reda på vad databasen höll på med.
Vi såg hög belastning på diskarna, men slowlogs visade inte något av värde. Detta problem löste vi med hjälp av pg_stat_statements, en vy som samlar statistik över förfrågningar.
Det är allt som behövs för en admin.
Vi bygger grafer för aktivitet av läs- och skrivförfrågningar:
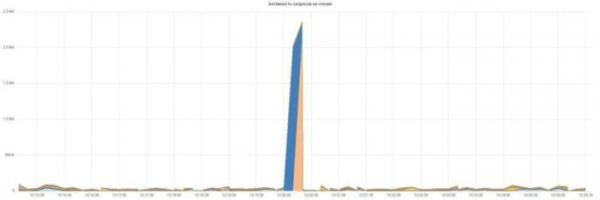
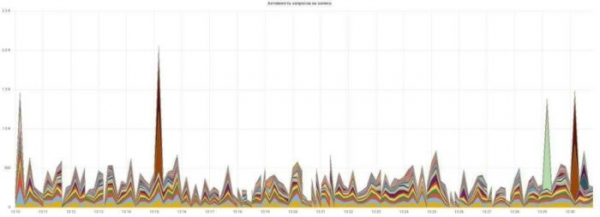
Det är enkelt och tydligt, varje förfrågan har sin egen färg.
Ett minst lika tydligt exempel är Nginx-loggar. Det är inte överraskande att få personer parsar dem eller nämner dem i listan över obligatoriska. Standardformatet är inte särskilt informativt och behöver utökas.
Personligen har jag lagt till request_time, upstream_response_time, body_bytes_sent, request_length, request_id. Vi bygger grafer för svarstid och antal fel:
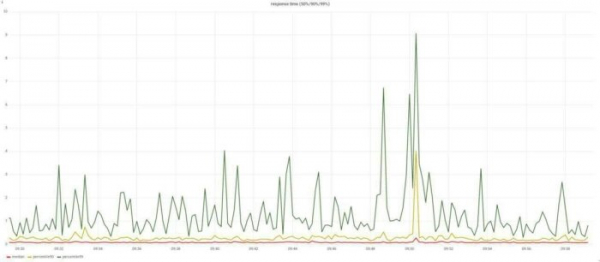
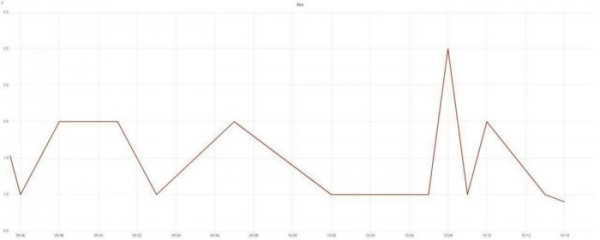
Vi bygger grafer för svarstid och antal fel. Kommer du ihåg? Jag pratade om affärens uppgifter? För att vara snabba och utan fel? Vi har redan stängt dessa frågor med två grafer. Och på dem går det redan att ringa till de ordinarie administratörerna.
Men det finns fortfarande ett problem kvar – att säkerställa snabb lösning av orsaken till incidenten.
Incidentlösning
Hela processen från att identifiera till att lösa problemet kan delas upp i flera steg:
- identifiering av problemet;
- meddelande till den ordinarie administratören;
- reaktion på incidenten;
- lösning av orsakerna.
Det är viktigt att vi gör detta så snabbt som möjligt. Och även om vi inte kan vinna mycket tid på stegen att identifiera problemet och skicka meddelande – två minuter tar de oavsett, så är de efterföljande stegen ett rent fält för förbättringar.
Låt oss bara föreställa oss att telefonen ringer för operatören. Vad kommer han att göra? Söka svar på frågorna – vad har gått sönder, var har det gått sönder, hur ska man reagera? Så här svarar vi på dessa frågor:
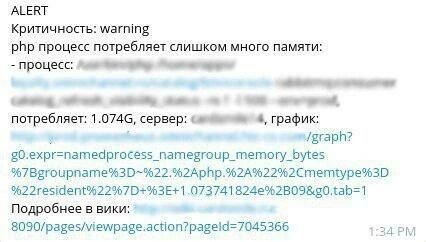
Vi inkluderar helt enkelt all denna information i meddelandetexten och ger en länk till sidan i wikin som beskriver hur man ska reagera på detta problem, hur man löser det och eskalerar.
Jag har fortfarande inte sagt något om nivåerna av applikationen och affärslogik. Tyvärr har vi ännu ingen insamling av metrik i våra applikationer. Den enda källan till någon information på dessa nivåer – är loggar.
Några punkter.
För det första, skriv strukturerade loggar. Inkludera inte kontexten i meddelandetexten. Det gör det svårare att gruppera och analysera dem. Logstash kräver mycket tid för att normalisera allt detta.
För det andra, använd allvarlighetsnivåerna korrekt. Varje språk har sin egen standard. Personligen jag skiljer mellan fyra nivåer:
- ingen fel;
- klientfel;
- fel på vår sida, vi förlorar inga pengar, vi bär inga risker;
- fel på vår sida, vi förlorar pengar.
Jag sammanfattar. Vi bör sträva efter att bygga övervakning utifrån affärslogiken. Försök att övervaka själva applikationen och arbeta med metrik som antalet försäljningar, antalet nya användarregistreringar, antalet aktiva användare för tillfället och så vidare.
Om hela ditt företag är en knapp i webbläsaren måste du övervaka om den trycks, om den fungerar som den ska. Allt annat är oviktigt.
Om du inte har det kan du försöka kompensera för detta i applikationens loggar, Nginx-loggar och så vidare, som vi har gjort. Du måste vara så nära applikationen som möjligt.
Operativsystemets metrik är självklart viktiga, men för affärerna är de inte intressanta, vi får inte betalt för dem.
Källa: habr.com
