

Under de senaste åren har databaser för tidsserier (Time-series databases) gått från att vara en ovanlig företeelse (som tillämpades antingen i specifika övervakningssystem eller i Big Data-projekt) till en "massmarknadprodukt". I Ryssland är det värt att nämna Yandex och ClickHouse för detta. Fram tills dess, om du behövde lagra en stor mängd tidsseriedata, var du tvungen att antingen acceptera att bygga en monstruös Hadoop-stack och underhålla den, eller att hantera protokoll specifika för varje system.
Det kan verka som om artikeln från 2019 om vilken TSDB som är värd att använda skulle bestå av en enda mening: "använd bara ClickHouse". Men… det finns nyanser.
Verkligen, ClickHouse utvecklas aktivt, användarbasen växer, och stödet är mycket aktivt, men har vi inte blivit fångar av ClickHouse:s offentliga framgång, som överskuggat andra, kanske mer effektiva/pålitliga lösningar?
I början av förra året började vi omarbeta vårt eget övervakningssystem, där vi stötte på frågan om att välja en lämplig databas för datalagring. Jag vill berätta historien om detta val här.
Uppgiftsställande
Först och främst - en nödvändig inledning. Varför behöver vi överhuvudtaget vårt eget övervakningssystem och hur var det uppbyggt?
Vi började erbjuda supporttjänster 2008, och 2010 blev det tydligt att aggregera data om processerna i kundens infrastruktur med de lösningar som fanns då blev svårt (vi pratar om, för guds skull, Cacti, Zabbix och det framväxande Graphite).
Våra grundkrav var:
- att hantera (vid den tiden - tiotals, och på sikt - hundratals) kunder inom ett system och dessutom ha ett centraliserat system för hantering av aviseringar;
- flexibilitet i hanteringen av aviseringar (eskalering av aviseringar mellan vaktmästare, beaktande av scheman, kunskapsdatabas);
- möjlighet till djup detaljering av diagram (Zabbix vid den tiden ritade diagram som bilder);
- långvarig lagring av stora mängder data (ett år eller mer) och möjlighet till snabb hämtning.
I den här artikeln är vi intresserade av den senaste punkten.
När det gäller lagring var kraven följande:
- systemet måste fungera snabbt;
- det är önskvärt att systemet har ett SQL-gränssnitt;
- systemet måste vara stabilt och ha en aktiv användarbas och support (någon gång stötte vi på behovet av att stödja system som MemcacheDB, som slutade utvecklas, eller det distribuerade lagret MooseFS, vars bugtracking sköttes på kinesiska: vi ville inte upprepa den historien för vårt projekt);
- överensstämmelse med CAP-teoremet: Consistency (något som krävs) — data måste vara aktuella, vi vill inte att systemet för hantering av aviseringar inte får nya data och spottar ut varningar om att ingen data kommit in för alla projekt; Partition Tolerance (något som krävs) — vi vill inte få ett Split Brain-system; Availability (inte kritiskt, om det finns en aktiv replik) — vi kan själva växla till reservsystemet vid en nödsituation, via kod.
Konstigt nog visade sig MySQL vara den perfekta lösningen för oss vid den tiden. Vår datastruktur var extremt enkel: server-id, räknarens id, tidsstämpel och värde; snabb hämtning av heta data säkerställdes genom storleken på buffer pool, och hämtning av historiska data genom SSD.
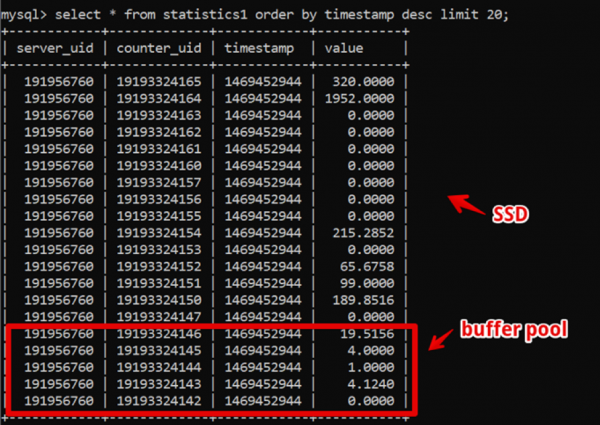
Därmed lyckades vi hämta färska tvåveckorsdata med en detaljeringsgrad ner till sekunden på 200 ms fram till den fullständiga renderingstiden, och vi levde med det systemet ganska länge.
Under tiden gick tiden och mängden data växte. Vid 2016 års slut nådde datamängderna tiotals terabyte, vilket var en betydande kostnad för hyrda SSD-lagringar.
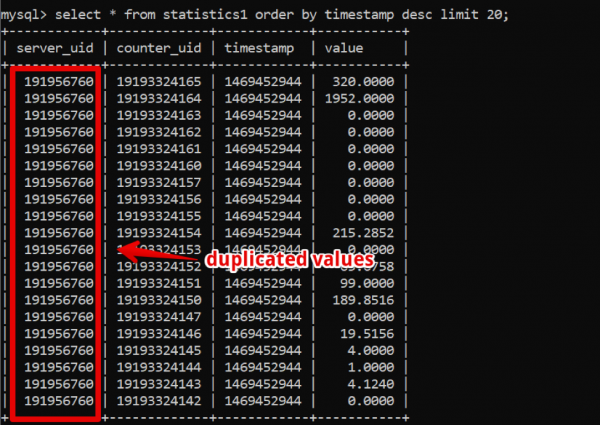
Vid denna tidpunkt hade kolumnbaserade databaser blivit populära, som vi började tänka på: i kolumnbaserade databaser lagras data, som namnet antyder, i kolumner, och om man ser på våra data kan man lätt se ett stort antal dubbletter, som i fallet med användning av en kolumnbaserad databas skulle kunna komprimeras.
Men det kritiska systemet för företagets verksamhet fortsatte att fungera stabilt, och vi ville inte experimentera med att byta till något annat.
År 2017 på konferensen Percona Live i San Jose gjorde Clickhouse-utvecklarna förmodligen sin första stora presentation. Vid första anblick verka systemet vara produktion-klar (Yandex.Metrica är trots allt en tuff produktion), supporten var snabb och enkel, och framförallt, driften var okomplicerad. Från och med år 2018 påbörjade vi övergångsprocessen. Men vid den tiden fanns det många 'mogna' och välbeprövade TSDB-system, och vi beslutade att avsätta betydande tid för att jämföra alternativ, för att säkerställa att det inte fanns några alternativ till Clickhouse som uppfyllde våra krav.
Utöver de redan angivna kraven på lagringssystemet tillkom nya:
- det nya systemet ska ge åtminstone samma prestanda som MySQL, på samma hårdvarukonfiguration;
- lagringssystemet för den nya plattformen ska ta upp betydligt mindre utrymme;
- DBMS:en ska fortfarande vara enkel att hantera;
- vi ville minimera förändringarna i applikationen vid byte av DBMS.
Vilka system började vi överväga
Apache Hive/Apache Impala
Den gamla pålitliga Hadoop-stacken. I grund och botten är detta ett SQL-gränssnitt byggt ovanpå lagring av data i egna format på HDFS.
Fördelar.
- Vid stabil drift är det mycket enkelt att skala data.
- Det finns kolumnbaserade lösningar för datalagring (mindre utrymme).
- Mycket snabb exekvering av parallella uppgifter med tillräckliga resurser.
Nackdelar.
- Det är Hadoop, och det är komplicerat att hantera. Om vi inte är redo att ta ett färdigt molnlösning (vilket vi inte är kostnadsmässigt), måste hela stacken byggas och underhållas av administratörer, vilket vi verkligen vill undvika.
- Data aggregeras .
Men:
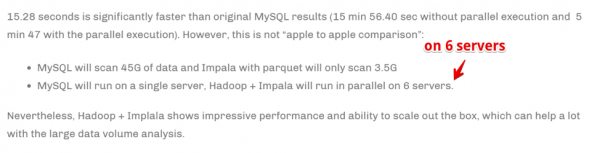
Hastigheten uppnås genom att öka antalet beräkningsservrar. Enkelt uttryckt, om vi är ett stort företag, arbetar med analys och det är kritiskt för affären att aggregera informationen så snabbt som möjligt (även på bekostnad av att använda en stor mängd beräkningsresurser) — kan detta vara vårt val. Men vi var inte redo att kraftigt öka hårdvaruflottan för att uppnå snabbhet i uppgifternas utförande.
Druid/Pinot
Mycket mer specifikt om TSDB, men återigen — Hadoop-stacken.
Det finns .
Om man sammanfattar: Druid/Pinot ser bättre ut än Clickhouse i fall där:
- Du har en heterogen datakaraktär (i vårt fall registrerar vi bara tidsserier av servermetrik, och i grunden handlar det om en tabell. Men det kan finnas andra fall: tidsserier från utrustning, ekonomiska tidsserier osv. — var och en med sin egen struktur, som måste aggregeras och bearbetas).
- Det finns mycket av dessa data.
- Tabeller och data med tidsserier dyker upp och försvinner (det vill säga att en datamängd har kommit, har analyserats och sedan tagits bort).
- Det finns inget tydligt kriterium för hur data kan partitioneras.
I motsatta fall presterar ClickHouse bättre, och det är vårt fall.
ClickHouse
- SQL-liknande.
- Enkel att hantera.
- Folk säger att den fungerar.
Kommer med på testlistan.
InfluxDB
Utomland alternativ till ClickHouse. Nackdelar: Hög tillgänglighet finns endast i den kommersiella versionen, men det måste jämföras.
Kommer med på testlistan.
Cassandra
Å ena sidan vet vi att den används för att lagra metrisk tidsserie av system för övervakning som till exempel eller OkMeter. Men det finns specifika aspekter.
Cassandra är inte en kolumndatabas i den traditionella bemärkelsen. Den ser mer ut som en radbaserad databas, men i varje rad kan det finnas ett varierande antal kolumner, vilket gör det lätt att organisera en kolumnrepresentation. Därför är det förståeligt att med en begränsning på 2 miljarder kolumner kan du lagra viss data i kolumner (som tidsserier). Till exempel har MySQL en begränsning på 4096 kolumner och det är lätt att stöta på felkod 1117 om man försöker göra samma sak.
Cassandra-motorn är inriktad på lagring av stora mängder data i ett distribuerat system utan en master, och i den ovan nämnda CAP-teorin handlar Cassandra mer om AP, det vill säga tillgänglighet av data och motståndskraft mot partitionering. Därför kan detta verktyg vara utmärkt om det endast behövs skriva till denna databas och sällan läsa från den. Här är det logiskt att använda Cassandra som ett "kallt" lagringsalternativ. Det vill säga som en långsiktig och pålitlig plats för att lagra stora mängder historiska data som sällan krävs, men som kan hämtas vid behov. För att ge en fullständig bild kommer vi dock att testa det också. Men som jag nämnde tidigare, finns det ingen önskan att aktivt omarbeta koden för den valda databaslösningen, så vi kommer att testa det på ett begränsat sätt – utan att anpassa databasstrukturen efter Cassandras specifikationer.
Prometheus
Och av ren nyfikenhet beslöt vi oss för att testa prestandan hos Prometheus-lagringen – helt enkelt för att förstå om vi är snabbare eller långsammare än de nuvarande lösningarna och hur mycket.
Metodik och testresultat
Så, vi testade 5 databaser i följande 6 konfigurationer: ClickHouse (1 nod), ClickHouse (distribuerad tabell på 3 noder), InfluxDB, Mysql 8, Cassandra (3 noder) och Prometheus. Testplanen är följande:
- vi laddar upp historiska data för en vecka (840 miljoner värden per dag; 208 tusen mätningar);
- vi genererar en skrivbelastning (vi övervägde 6 belastningslägen, se nedan);
- parallellt med skrivningen gör vi periodiska förfrågningar, som simulerar användarfrågor som arbetar med grafer. För att inte komplicera för mycket valde vi att använda data från 10 mätningar (just så många finns på CPU-grafen) under en vecka.
Vi belastar genom att simulera beteendet hos vår övervakningsagent, som skickar värden till varje mätning var 15:e sekund. Vi är intresserade av att variera:
- det totala antalet mätningar som data skrivs till;
- intervallet för att skicka värden till en mätning;
- batchstorleken.
Om batchstorleken. Eftersom nästan alla våra testdatabaser inte rekommenderas att belasta med enskilda insättningar, behöver vi en relay som samlar in de inkommande mätningarna och grupperar dem något och sedan skriver till databasen med batchinsert.
För att bättre förstå hur vi senare ska tolka de erhållna data, tänk på att vi inte bara skickar en massa metrik, utan att metrik är organiserade i servrar - med 125 metrik per server. Här är servern bara en virtuell entitet - för att förstå att, till exempel, 10000 metrik motsvarar ungefär 80 servrar.
Och med hänsyn till allt detta, våra 6 lastlägen för databasen vid skrivning:
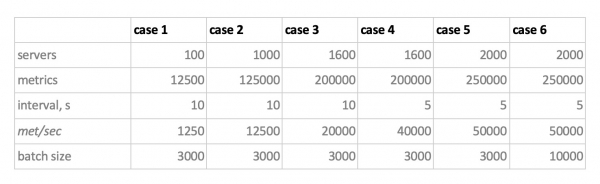
Det finns två saker att notera. För det första, för Cassandra visade sig dessa batchstorlekar vara för stora, där använde vi värdena 50 eller 100. För det andra, eftersom Prometheus fungerar strikt i pull-läge, det vill säga att den själv går och hämtar data från metrik-källor (och även pushgateway, trots namnet, förändrar i grunden inte situationen), implementerades motsvarande belastningar med en kombination av statiska konfigurationer.
Testresultaten är följande:
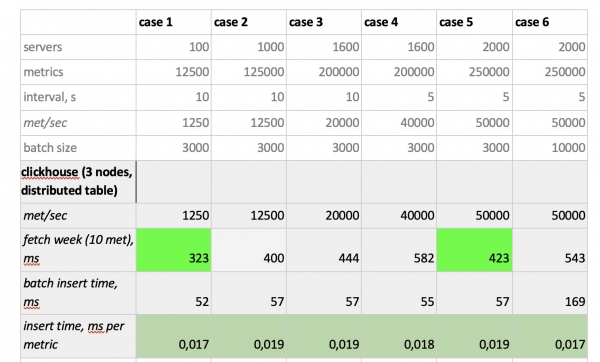
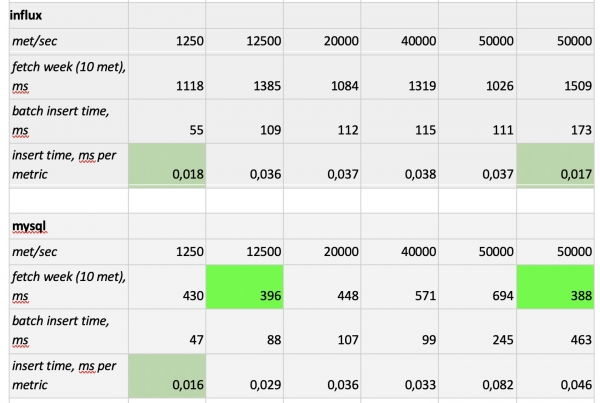
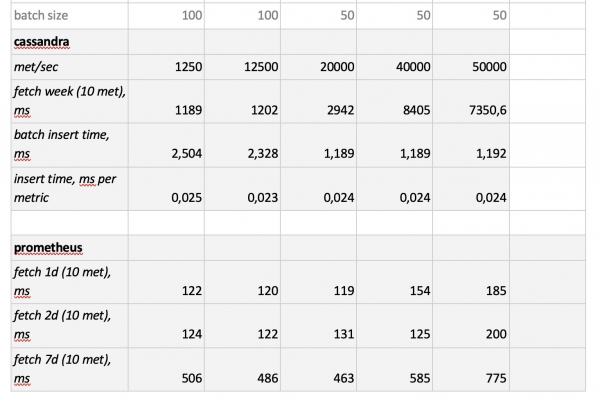
Vad som är värt att notera: fantastiskt snabba urval från Prometheus, fruktansvärt långsamma urval från Cassandra, oacceptabelt långsamma urval från InfluxDB; när det kommer till skrivhastighet vann ClickHouse överlägset, och Prometheus deltog inte i tävlingen eftersom den gör insättningar själv internt och vi mäter ingenting.
I slutändan: ClickHouse och InfluxDB visade sig vara bäst, men en kluster av Influx kan bara byggas på grundval av Enterprise-versionen som kostar pengar, medan ClickHouse är gratis och tillverkas i Ryssland. Det är rimligt att valet i USA, förmodar jag, är i riktning mot InfluxDB, medan vi föredrar ClickHouse.
Källa: habr.com
