

Hej! Jag heter Alexey Pyankov, jag är utvecklare på företaget Sportmaster. I detta berättade jag om hur arbetet med Sportmasters webbplats började 2012, vilka initiativ vi lyckades "trycka igenom" och tvärtom, vilka fallgropar vi stötte på.
Idag vill jag dela med mig av tankar som följer ett annat ämne – valet av cache-system för java-backenden i webbplatsens adminpanel. Detta ämne har en särskild betydelse för mig – även om historien utspelade sig under bara 2 månader, arbetade vi dessa 60 dagar 12-16 timmar om dagen utan en enda ledig dag. Jag har aldrig tidigare tänkt eller föreställt mig att man kan arbeta så mycket.
Därför delar jag texten i 2 delar för att inte överbelasta helt. Tvärtom, första delen kommer att vara mycket lätt – en förberedelse, en introduktion, några tankar om vad caching är. Om du redan är en erfaren utvecklare eller har arbetat med cachar, kommer det troligtvis inte finnas något nytt ur teknisk synpunkt i denna artikel. Men för en junior kan en liten översikt ge en vink om vilken riktning man ska titta i, om man befinner sig vid en sådan korsning.
När den nya versionen av Sportmasters webbplats lanserades i produktion, kom data på ett sätt som, milt sagt, inte var särskilt praktiskt. Grunden var tabeller som förberetts för den tidigare versionen av webbplatsen (Bitrix), som behövde dras in i ETL, omformas och berikas med olika tillägg även från ett dussin andra system. För att den nya bilden eller produktbeskrivningen skulle dyka upp på webbplatsen, var man tvungen att vänta till nästa dag – uppdateringen skedde bara på natten, en gång om dagen.
I början var det så många bekymmer under de första veckorna av produktlanseringen att content managers' besvär kändes som struntsaker. Men så snart allt hade stabiliserat sig fortsatte projektet att utvecklas — några månader senare, i början av 2015, började vi aktivt utveckla administrationsgränssnittet. Under 2015 och 2016 gick allt bra, vi släppte regelbundet nya versioner, administrationsgränssnittet täckte allt större delar av databehandlingen och vi förberedde oss på att snart få det mest viktiga och utmanande – produktflödet (fullständig hantering och underhåll av data för alla produkter). Men sommaren 2017, precis innan lanseringen av produktflödet, befann sig projektet i en mycket svår situation – just på grund av problem med cachehantering. Om detta avsnitt vill jag berätta i den andra delen av denna tvådelade publikation.
Men i detta inlägg börjar jag från början, sammanfattar några tankar – föreställningar om caching, som det skulle vara bra att ha förhandsgranskat innan ett stort projekt.
När cachingproblematiken uppstår
Cachingproblematiken uppstår inte av sig själv. Vi är utvecklare, vi skriver mjukvaruprodukter och vill att de ska vara efterfrågade. Om produkten är efterfrågad och framgångsrik — så kommer användarna. De kommer och kommer, och plötsligt har vi en stor mängd användare, och produkten blir högt belastad.
I de tidiga stadierna tänker vi inte på kodens optimering och prestanda. Det viktigaste är funktionaliteten, att snabbt rulla ut en pilotversion och testa hypoteser. Och om belastningen ökar – förbättrar vi hårdvaran. Vi ökar kapaciteten med två till tre, fem, kanske tio gånger. Vid en viss punkt kommer ekonomin att sätta stopp. Men hur mycket kommer antalet användare att öka? Det kommer inte bara vara 2-5-10, utan i händelse av framgång – kan det gå från 100-1000 upp till 100 000 gånger. Så förr eller senare kommer vi att behöva ta itu med optimering.
Anta att en viss del av koden (låt oss kalla den här delen för en funktion) tar orimligt lång tid att köra, och vi vill minska exekveringstiden. En funktion kan vara åtkomst till databas, det kan vara att utföra någon komplex logik - huvudsaken är att det tar lång tid. Hur mycket kan vi minska exekveringstiden? I teorin kan vi minska den till noll, inte längre. Men hur kan vi minska exekveringstiden till noll? Svaret: helt enkelt hoppa över exekveringen. Istället kan vi direkt returnera resultatet. Hur vet vi resultatet? Svaret: antingen beräkna det eller kolla någonstans. Att beräkna det är långsamt. Att kolla betyder till exempel att komma ihåg det resultat som funktionen gav vid senaste anropet med samma parametrar.
Det betyder att implementationen av funktionen är irrelevant för oss. Det är tillräckligt att veta vilka parametrar som resultatet beror på. Om vi då kan representera värdena för parametrarna som ett objekt som kan användas som nyckel i något lagringsutrymme - kan vi spara resultatet av beräkningen och vid nästa anrop hämta det. Om dessa skrivning-och-läsning av resultatet går snabbare än att köra funktionen - har vi en hastighetsfördel. Styrkan i fördelen kan nå upp till 100, 1000 eller 100 000 gånger (10^5 - det är mer av en undantag, men i ett fall med en ordentligt slö databas - helt möjligt).
Huvudkraven för ett cache-system
Det första som kan bli ett krav för ett cache-system är snabb läshastighet och i något mindre grad - skrivhastighet. Det är sant, men bara tills vi rullar ut systemet i produktion.
Låt oss ta ett sådant scenario.
Anta att vi har säkerställt hårdvaran för den nuvarande belastningen och nu långsamt börjar införa caching. Antalet användare ökar något, belastningen växer - vi lägger till några cache-poster, kopplar in dem här och där. Så fortsätter det ett tag, och nu anropas de tunga funktionerna i stort sett inte längre - hela den huvudsakliga belastningen faller på cachen. Antalet användare har under denna tid ökat N gånger.
Och om den initiala hårdvarureserven kunde vara 2-5 gånger, så kunde vi med caching dra upp prestandan 10 gånger eller, i bästa fall, 100 gånger, ibland kanske även 1000 gånger. Det vill säga, på samma hårdvara - behandlar vi 100 gånger fler förfrågningar. Fantastiskt, vi förtjänar en belöning!
Men nu, plötsligt, gav systemet upp och cachen kraschade. Inget speciellt – cachen valdes efter kravet "hög läshastighet och skrivhastighet, resten spelar ingen roll".
Vad gäller den initiala belastningen hade vi en hårdvarumarginal på 2-5 gånger, medan belastningen under den tiden ökade 10-100 gånger. Med hjälp av cachen uteslöt vi anrop för tunga funktioner och därför flöt allt på. Men nu, utan cache – hur mycket kommer vår system att sjunka? Vad kommer att hända? Systemet kommer att gå ner.
Även om vår cache inte kraschade, utan bara rensades under en tid – måste den värmas upp, och det kommer att ta tid. Och under den tiden kommer den huvudsakliga belastningen att ligga på funktionaliteten.
Slutsats: högbelastade projekt i produktion kräver att systemet för caching inte bara har hög läshastighet och skrivhastighet, utan också dataskydd och stabilitet mot störningar.
Valets plågor
I projektet med adminpanelen gjordes valet så här: först installerades Hazelcast, eftersom vi redan var bekanta med denna produkt från erfarenheten av huvudwebbplatsen. Men här visade sig detta val vara olyckligt – för vår belastningsprofil arbetar Hazelcast inte bara långsamt, utan fruktansvärt långsamt. Och med tidsramarna för att få ut det i produktion hade vi redan skrivit på.
Spoiler: hur omständigheterna utvecklade sig till att vi missade en sådan överraskning och hamnade i en akut och spänd situation – kommer jag att berätta i del två — och hur vi hamnade där, och hur vi kom ut. Men just nu – säger jag bara att det var en stor stress, och "att tänka – går liksom inte, vi skakar flaskan". "Vi skakar flaskan" – det är också en spoiler, om det lite längre fram.
Vad vi gjorde:
- Vi sammanställer en lista över alla system som Google och StackOverflow föreslår. Lite mer än 30.
- Vi skriver tester med belastning som är typisk för produktion. För detta har vi spelat in data som passerar genom systemet i produktionsmiljön – en typ av sniffer för data som inte är på nätet, men inom systemet. Dessa data körde vi i testerna.
- Hela teamet, var och en väljer nästa system från listan, konfigurerar och kör tester. Går inte testet, klarar inte belastningen – slänger vi det och går vidare till nästa på tur.
- Vid det 17:e systemet blev det klart att allt var hopplöst. Dags att sluta med "att skaka flaskan", vi måste tänka allvarligt.
Men detta är ett alternativ när man behöver välja ett system som "klarar hastighetskraven" i förberedda tester. Men om sådana tester inte finns och man vill välja något snabbare?
Vi modellerar ett sådant alternativ (det är svårt att föreställa sig att en medelnivå+ utvecklare lever i vakuum, och vid valet ännu inte har bestämt vilket produkt de vill prova först — därför är de följande resonemangen mer teoretiska/filosofiska/om en junior).
När vi har fastställt kraven börjar vi välja en färdig lösning. Varför återuppfinna hjulet: vi går och plockar en färdig cachelösning.
Om du just har börjat och kommer att googla, så är ordningen ungefär densamma, men överlag kommer riktlinjerna att vara som följer. Först kommer du att stöta på Redis, som är allmänt känt. Sedan får du veta att det finns EhCache, som är det äldsta och mest beprövade systemet. Sedan följer Tarantool — en inhemsk utveckling med unika lösningar. Och även Ignite, eftersom det nu är på uppgång och stöds av SberTech. Slutligen kommer Hazelcast, som ofta dyker upp i företagsvärlden bland stora företag.
Denna lista är inte uttömmande, det finns många system. Men vi kommer att fokusera på ett enda. Vi tar de utvalda 5 systemen till en "skönhetstävling" och gör en urval. Vem blir vinnaren?
Redis
Låt oss läsa vad som står på den officiella hemsidan.
— ett opensource-projekt. Erbjuder ett in-memory datalagringssystem, möjlighet till on-disk lagring, automatisk partitionering, hög tillgänglighet och återställning efter nätverksavbrott.
Det verkar bra, man kan ta det och koppla in — allt vad som behövs görs. Men låt oss titta på de andra kandidaterna av ren nyfikenhet.
EhCache
— "den mest använda cachen för Java" (översättning av slogan från den officiella hemsidan). Även detta är opensource. Här förstår vi att Redis inte är för Java, utan allmänt, och för att interagera med det behövs en wrapper. EhCache kommer att vara bekvämare. Vad lovar systemet mer? Tillförlitlighet, beprövadhet, fullständighet. Och det är den mest spridda. Och cachen hanterar terabyte av data.
Redis är glömt, jag är redo att välja EhCache.
Men min patriotism driver mig att kolla vad som är bra med Tarantool.
Tarantool
— möter beteckningen "Plattform för realtidsintegration av data". Det låter mycket komplicerat, så vi läser sidan noggrant och hittar det stora påståendet: "Cachar 100% av data i RAM". Detta bör väcka frågor – eftersom datan kan vara betydligt mer än minnet. Förklaringen är att här syftas det på att för att skriva data till disken från minnet, använder Tarantool inte serialization. Istället använder den lågnivåfunktioner i systemet, där minnet helt enkelt mappas på filsystemet med mycket bra I/O-prestanda. Så, det har gjorts på ett fantastiskt och smart sätt.
Låt oss titta på implementationerna: Mail.ru företagsbackbone, Avito, Beeline, Megafon, Alfa-Bank, Gazprom…
Om det fortfarande finns några tvivel kring Tarantool, så övertygar mig fallet med Mastercard. Jag väljer Tarantool.
Men ändå…
Ignite
… finns det mer , som anges som "in-memory beräkningsplattform... in-memory hastigheter på petabyte data". Här finns också många fördelar: distribuerad in-memory cache, den snabbaste key-value lagring och cache, horisontell skalbarhet, hög tillgänglighet, strikt integritet. Så det visar sig att den snabbaste är Ignite.
Implementationer: Sberbank, American Airlines, Yahoo! Japan. Och sedan får jag också veta att Ignite inte bara har implementerats i Sberbank, utan att SberTech-teamets medlemmar skickas till Ignite-teamet för att förbättra produkten. Det här övertygar mig helt och jag är redo att välja Ignite.
Helt oklart varför, jag ser på den femte punkten.
Hazelcast
Jag går in på webbplatsen , läser. Och det visar sig att den snabbaste lösningen för distribuerad caching är Hazelcast. Det är många gånger snabbare än alla andra lösningar och är verkligen ledande inom in-memory data grid. I ljuset av detta, att välja något annat – att inte respektera sig själv. Dessutom använder den redundant datalagring för att säkerställa att klustret fortsätter att fungera utan dataläckage.
Det är klart, jag är redo att välja Hazelcast.
Jämförelse
Men om vi ser på det, så är alla fem kandidater så beskrivna att var och en av dem är den bästa. Hur väljer man? Vi kan titta på vilken av dem som är mest populär, leta efter jämförelser, och huvudvärken försvinner.
Vi hittar en sådan , vi väljer våra 5 system.
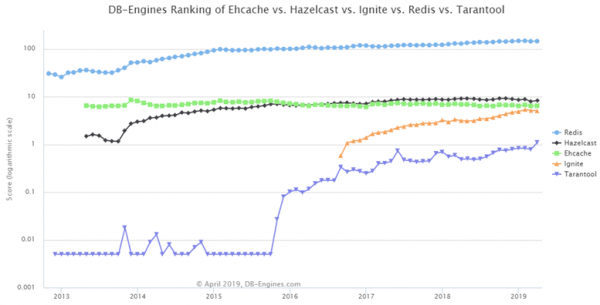
Här är de sorterade: högst upp Redis, tvåa är Hazelcast, Tarantool och Ignite vinner popularitet, EhCache förblir som det var.
Men låt oss titta på : länkar till webbplatser, allmän intresse för systemet, jobbannonser – fantastiskt! Så, när mitt system går ner, kommer jag att säga: «Nej, den är ju pålitlig! Här är många jobb erbjudanden...». En sådan enkel jämförelse fungerar inte.
Dessa system är inte bara cachingsystem. De har mycket mer funktionalitet, inklusive – när inte data överförs till klienten för bearbetning, utan tvärtom: koden som måste utföras på data flyttas till servern, där den körs och resultatet returneras. Och som ett separat cachingsystem övervägs de inte så ofta.
Okej, vi ger inte upp, vi ska hitta en direkt jämförelse av systemen. Vi tar de två bästa alternativen – Redis och Hazelcast. Vi är intresserade av hastighet, och vi ska jämföra dem efter detta kriterium.
Hz vs Redis
Vi hittar något sådant :
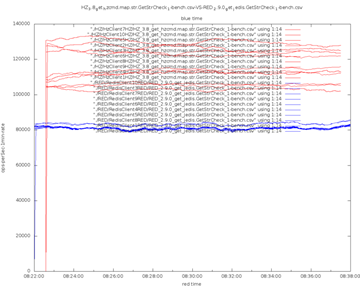
Blått är Redis, rött är Hazelcast. Hazelcast vinner överallt, och detta har en förklaring: det är flödesbaserat, högoptimerat, varje tråd arbetar med sin partition, så det finns inga lås. Redis är flödesbaserat, från moderna flerprocessorer tar det inte några vinster. Hazelcast har asynkron I/O, hos Redis-Jedis är socketarna blockerande. I slutändan använder Hazelcast ett binärt protokoll, medan Redis är textorienterat, vilket innebär att det är ineffektivt.
För säkerhets skull ska vi vända oss till en annan källa för jämförelse. Vad kommer den att visa oss?
Redis vs Hz
Ännu en :
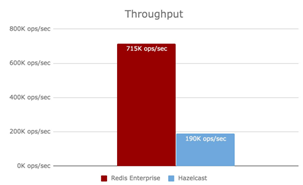
Här är det tvärtom, rött är Redis. Det innebär att Redis prestanda vinner över Hazelcast. I den första jämförelsen vann Hazelcast, i den andra – Redis. det mycket noggrant förklarat varför Hazelcast vann i den föregående jämförelsen.
Det visar sig att resultatet från den första jämförelsen faktiskt var manipulerat: Redis togs i sin grundläggande version, medan Hazelcast anpassades för testscenariot. Så det visar sig: för det första, ingen kan man lita på, för det andra, när vi ändå väljer ett system, måste vi också konfigurera det korrekt. Dessa inställningar inkluderar dussintals, nästan hundra parametrar.
Skakar flaskan
Och hela processen som vi just har genomfört kan jag förklara med metaforen «Skakar flaskan». Det vill säga, just nu behöver man inte programmera, det viktigaste är att kunna läsa stackoverflow. Och jag har en professionell person i mitt team som just arbetar så i kritiska stunder.
Vad gör han? Han ser en trasig grej, ser stack trace, tar några ord från den (vilka exakt — det är hans expertis i programmet), söker på Google, hittar stackoverflow bland svaren. Utan att läsa, utan att tänka, bland svaren på frågan — väljer han något som liknar förslaget "gör det här och det här" (att välja ett sådant svar — det är hans talang, för det är inte alltid den svar som fått flest gilla). Han tillämpar det, tittar: om något har förändrats, bra. Om inget har förändrats — vi backar. Och vi upprepar körning-kontroll-sökning. På det intuitiva sättet lyckas han få koden att fungera efter ett tag. Han vet inte varför, han vet inte vad han gjorde, han kan inte förklara. Men! Den fungerar. Och "branden är släckt". Nu går vi igenom vad vi har gjort. När programmet fungerar — är det mycket lättare. Och sparar betydligt tid.
Det här sättet förklaras mycket bra med ett exempel.
Det var en gång mycket populärt att bygga en segelbåt i en flaska. Segelbåten är stor och skör, medan flaskans hals är väldigt smal, man kan inte pressa in den. Hur ska man bygga den?
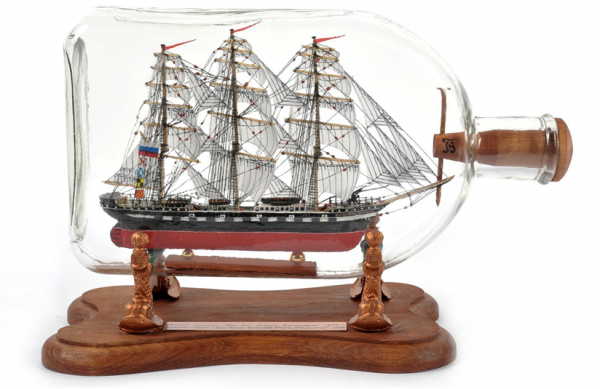
Det finns en metod som är väldigt snabb och effektiv.
Båten består av massor av smådelar: pinnar, snören, segel, lim. Allt detta lägger vi i flaskan.
Vi tar flaskan med båda händerna och börjar skaka. Vi skakar den och skakar. Och oftast blir det en total katastrof, såklart. Men ibland. Ibland blir det en båt! Närmare bestämt, något som liknar en båt.
Vi visar detta något för någon: "Sergej, ser du!?". Och faktiskt, på avstånd — ser det ut som en båt. Men längre än så kan man inte gå.
Det finns också ett annat sätt. Mer avancerade killar, sådana hackare, använder det.
Jag gav en sådan kille en uppgift, han gjorde allt och gick. Och man ser – det ser ut som gjort. Men efter ett tag, när man behöver justera koden — då börjar det hända konstiga saker på grund av honom… Tur att han redan har lyckats springa långt bort. Det är sådana killar som, på exempel med flaskan, gör så: ser ni, där botten är – glaset böjer sig. Och det är inte helt klart, är det genomskinligt eller inte. Då "hackarna" sågar av botten, sätter in båten, sätter sedan tillbaka botten med lim, och så ser det ut som det alltid ska vara.
Ur ett uppgiftsformuleringsperspektiv verkar allt rätt. Men när det gäller båtar: varför i hela världen skulle man ens göra denna båt, vem behöver den ens? Den har ingen funktionalitet. Vanligtvis är sådana båtar gåvor till mycket högstående personer, som ställer dem på en hyllan ovanför sig, som en symbol, som ett tecken. Och om en sådan person, en ledare för ett stort företag eller en hög tjänsteman, har sådan värdelöshet som flagga, vars hals är avskuren? Det är bättre att han aldrig får veta det. Så hur gör man dessa båtar som kan ges till viktiga personer?
Det enda stället, det enda viktiga, som man verkligen inte kan ändra på, är skrovet. Och skrovet på båten går just genom halsen. Men båten sätts ihop utanför flaskan. Men det är inte bara att sätta ihop en båt, det är ett riktigt hantverk. I delarna läggs speciella spakar till, som gör det möjligt att senare lyfta dem. Till exempel, seglen viks ihop, förs varsamt in, och sedan, med pincett, lyfts de mycket noggrant och exakt. Resultatet blir ett konstverk som man kan ge bort med gott samvete och stolthet.
Och om vi vill att projektet ska bli framgångsrikt – måste det finnas minst en juvelerare i teamet. Den som bryr sig om produktens kvalitet och tar hänsyn till alla aspekter, utan att offra något, inte ens i stressiga stunder när omständigheterna kräver snabba åtgärder på bekostnad av det viktiga. Alla framgångsrika projekt som är hållbara och har stått tidens prov bygger på denna princip. De har något väldigt exakt och unikt, något som utnyttjar alla tillgängliga möjligheter. I exemplet med båten i en flaska beskrivs hur skrovet på båten passerar genom halsen.
Återkommande till uppgiften att välja vår cache-server, hur skulle denna metod kunna tillämpas? Jag föreslår ett sätt att göra urval från alla system som finns – att inte skaka flaskan, inte välja, utan att se vad som egentligen finns där som man borde tänka på när man väljer system.
Var ska man leta efter flaskhalsar
Vi försöker att inte skaka flaskan, inte gå igenom allt en och en, men vi ser vilka uppgifter som dyker upp om vi helt plötsligt, för vår uppgift - att designa ett sådant system på egen hand. Vi kommer givetvis inte att bygga en cykel, utan vi ska använda detta schema för att orientera oss om vilka punkter vi ska uppmärksamma i produktbeskrivningarna. Vi skissar på ett sådant schema.
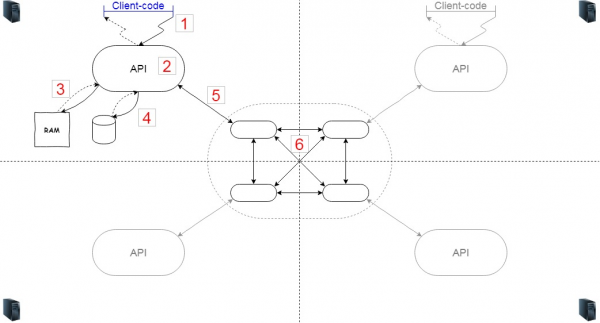
Om systemet är distribuerat, innebär det att vi kommer att ha flera servrar (6). Låt oss anta att det är fyra (det är bekvämt att placera i bilden, men det kan förstås vara hur många som helst). Om servrarna är på olika noder, innebär det att det körs viss kod på dem alla, som ansvarar för att dessa noder bildar ett kluster och vid avbrott - ansluter, känner igen varandra.
Vi behöver också koden-logik (2), som handlar om cachelagring. Denna kod interagerar med klienterna via ett visst API. Klientkoden (1) kan antingen vara inom samma JVM eller kontakta den över nätverket. Logiken som är implementerad internt handlar om att fatta beslut om vilka objekt som ska behållas i cachen och vilka som ska slängas. För att lagra cachen använder vi minne (3), men om det behövs kan vi också spara delar av data på disken (4).
Vi ska se var belastningen kommer att uppstå. Faktiskt kommer varje pil och varje nod att belastas. Först och främst, mellan klientkoden och API:et, om det är en nätverksinteraktion, kan nedgången vara ganska märkbar. För det andra, inom själva API:et - om vi överdriver med komplicerad logik kan vi stöta på CPU-problem. Det skulle vara bra om logiken inte behöver hantera minnet i onödan. Och kvarstår är interaktionen med filsystemet - i det vanliga fallet handlar det om att serialisera / återställa och skriva / läsa.
Vidare interaktion med klustret. Troligtvis kommer den att finnas i samma system, men den kan också vara separat. Här måste man också ta hänsyn till dataöverföringen till det, hastigheten för dataserialisering och interaktionen mellan klustret.
Nu, å ena sidan - kan vi föreställa oss "vilka kugghjul som kommer att snurra" i cachen-systemet vid behandling av förfrågningar från vår kod, och å andra sidan - kan vi uppskatta hur många och vilka förfrågningar vår kod kommer att generera till detta system. Det är tillräckligt för att göra ett mer eller mindre rationellt val - att välja ett system som passar vår användning.
Hazelcast
Låt oss se hur vi kan tillämpa en sådan uppdelning på vår lista. Till exempel, Hazelcast.
För att lagra/hämta data från Hazelcast, interagerar klientkoden (1) med API:et. Hz tillåter att kör servern som inbäddad, och i det fallet är interaktionen med API:et ett metodanrop inom JVM, vilket kan anses vara kostnadsfritt.
För att logiken ska fungera i (2), förlitar sig Hz på en hash av byte-arrayen av den serialiserade nyckeln – det vill säga, serialiseringen av nyckeln kommer att ske oavsett. Detta är en oundviklig overhead för Hz.
Evictionsstrategierna är väl implementerade, men för speciella fall kan egna kopplas in. För denna del kan man vara lugn.
Lagringen (4) kan kopplas in. Utmärkt. Interaktionen (5) för inbäddad kan ses som omedelbar. Datautbyte mellan noder i klustret (6) – ja, det finns. Detta bidrar till motståndskraftighet på bekostnad av hastighet. Kostnaden kan sänkas genom Hz-funktionen Near-cache – data som erhållits från andra noder i klustret kommer att cachas.
Vad kan man göra i sådana omständigheter för att öka hastigheten?
Till exempel, för att undvika serialisering av nyckeln i (2) – kan man lägga till ytterligare en cache ovanpå Hazelcast, för de hetaste data. På Sportmaster valde man för detta ändamål Caffeine.
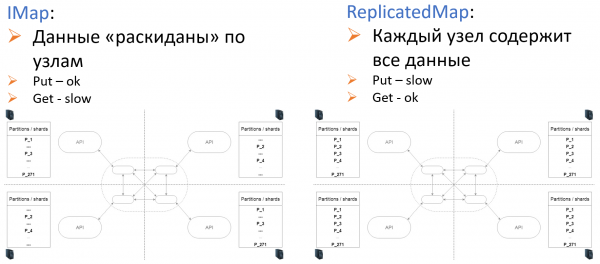
För justeringar på nivå (6), erbjuder Hz två typer av lagring: IMap och ReplicatedMap.
Det är värt att nämna hur Hazelcast kom in i Sportmasters teknikstack.
År 2012, när vi arbetade med den första piloten av framtida webbplatsen, var det faktiskt Hazelcast som visade sig vara den första länken sökmotorn gav. Bekantskapen inleddes 'från första taget' — vi blev imponerade av att bara två timmar efter att vi kopplat in Hz i systemet — fungerade det. Och fungerade bra. Fram till slutet av dagen skrev vi några tester, blev glada. Och det lilla lagret av energi räckte för att övervinna de överraskningar som Hz gav över tid. Nu har Sportmasters team inga skäl att avstå från Hazelcast.
Men sådana argument som 'första länken i sökmotorn' och 'snabbt satte ihop HelloWorld' är självklart undantag och egenskaper hos det ögonblick då valet gjordes. De verkliga prövningarna för det valda systemet börjar när man går produktionsvägen, och det är just på det här steget man bör fokusera vid valet av vilket system som helst, inklusive cache. I vårt fall kan man säga att vi valde Hazelcast av en slump, men det visade sig senare att vi valde rätt.
För produktion är mycket viktigare: övervakning, hantering av fel på enskilda noder, datareplication, kostnad för skalning. Det vill säga, man bör uppmärksamma de utmaningar som kan uppstå just under systemets drift – när belastningen tio gånger överstiger den planerade, när vi av misstag laddar upp fel saker på fel ställen, när det behövs en ny version av koden rullas ut, byta data och göra detta osynligt för kunderna.
För alla dessa krav passar Hazelcast definitivt.
Fortsättning följer
Men Hazelcast är ingen universallösning. År 2017 valde vi Hazelcast för cache i adminpanelen, helt enkelt baserat på tidigare positiva erfarenheter. Detta spelade en avgörande roll i ett väldigt intrikat skämt, vilket ledde till att vi hamnade i en svår situation och "hjältedådigt" kämpade oss ur den på 60 dagar. Men mer om detta i nästa del.
Och tills dess… Happy New Code!
Källa: habr.com
