

I den här artikeln beskrivs implementeringen av pipelines i Unix-kärnan. Jag blev ganska besviken över att en nyligen publicerad artikel med titeln "" visade sig vara inte om den interna strukturen. Jag blev nyfiken och grävde ner mig i gamla källor för att hitta svaret.
Vad handlar det om?
Pipelines — "förmodligen den viktigaste uppfinningen inom Unix" — är en avgörande egenskap av den centrala Unix-filosofin om att kombinera små program, samt den välkända prompten i kommandoraden:
$ echo hello | wc -c
6
Denna funktionalitet beror på det systemanrop som tillhandahålls av kärnan pipe, vilket beskrivs i dokumentationen på sidorna och :
Pipelines tillhandahåller en ensidig kanal för mellanprocesskommunikation. En pipeline har en ingång (write end) och en utgång (read end). Data som skrivs till ingången av pipelinen kan läsas på utgången.
En pipeline skapas med hjälp av anropet
pipe(2), vilket returnerar två filbeskrivare: en hänvisar till ingången av pipelinen, den andra till utgången.
Resultaten av spårningen av det angivna kommandot visar skapandet av en pipeline och strömmen av data genom den från en process till en annan:
$ strace -qf -e execve,pipe,dup2,read,write
    sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4])                            = 0
[pid 2604795] dup2(4, 1)                = 1
[pid 2604795] write(1, "hellon", 6)    = 6
[pid 2604796] dup2(3, 0)                = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2)        = 2
Föräldraprocessen anropar pipe(), för att få anslutna filbeskrivare. En barnprocess skriver till en filbeskrivare, medan en annan process läser samma data från en annan filbeskrivare. Skalet "byter namn" på filbeskrivarna 3 och 4 med hjälp av dup2 för att de ska matcha stdin och stdout.
Utan pipelines skulle skalet behöva skriva utdata från en process till en fil och sedan överföra den till en annan process för att läsa data från filen. Resultatet skulle vara att vi skulle använda mer resurser och diskutrymme. Men pipelines är inte bara bra för att undvika användningen av temporära filer:
Om en process försöker läsa från en tom pipeline, kommer då
read(2)att blockera tills data blir tillgängliga. Om en process försöker skriva till en full pipeline, dåwrite(2)blockeras tills tillräckligt med data har lästs från pipelinen för att utföra en skrivning.
Enligt POSIX-kraven är denna egenskap viktig: skrivning till pipelinen upp till PIPE_BUF bytes (minst 512) måste vara atomär så att processer kan interagera med varandra via pipelinen, på ett sätt som vanliga filer (som inte erbjuder sådana garantier) inte kan.
När du använder en vanlig fil kan en process skriva ut all sin utdata och överföra den till en annan process. Eller så kan processerna agera i strikt parallellisering, med hjälp av en extern signalmekanism (som en semafor) för att informera varandra om att skrivning eller läsning är klar. Pipelines befriar oss från alla dessa besvär.
Vad söker vi?
Jag ska förklara enkelt så att du lättare kan föreställa dig hur en pipeline kan fungera. Du behöver allokera en buffert i minnet och något tillstånd. Du kommer behöva funktioner för att lägga till och ta bort data från bufferten. Du behöver något sätt att anropa funktioner vid läs- och skrivoperationer till filbeskrivare. Och du behöver lås för att implementera det speciella beteende som beskrivits ovan.
Nu är vi redo att i starkt ljus granska källkoden till kärnan för att bekräfta eller motbevisa vår vaga mentala modell. Men var alltid beredd på överraskningar.
Var söker vi?
Jag vet inte var jag hittar mitt exemplar av den kända boken "" med källkoden till Unix 6, men tack vare kan man söka online i ännu äldre versioner av Unix.
Att vandra genom TUHS-arkiven är som att besöka ett museum. Vi kan se på vår gemensamma historia, och jag känner respekt för de många årens ansträngningar att återskapa allt detta material, bit för bit, från gamla kasetter och utskrifter. Och jag är skarpt medveten om de fragment som fortfarande saknas.
Efter att ha tillfredsställt min nyfikenhet om den antika historien om pipeliner, kan vi för jämförelse se på moderna kärnor.
Förresten, pipe är systemanrop nummer 42 i tabellen sysent[]. En tillfällighet?
Traditionella Unix-kärnor (1970–1974)
Jag har inte funnit några spår pipe(2) varken i (januari 1970), varken i (november 1971), eller i den ofullständiga källkoden (juni 1972).
TUHS hävdar att (februari 1973) blev den första versionen med pipeliner:
Den tredje versionen av Unix var den sista utgåvan med en kärna skriven i assembler, men också den första versionen med pipelining. Under 1973 arbetade man på att förbättra den tredje versionen, och kärnan skrevs om i C, vilket ledde till den fjärde versionen av Unix.
En av läsarna hittade en skanning av ett dokument där Doug McIlroy föreslog idén om "att koppla program enligt principen för en trädgårdsslang".
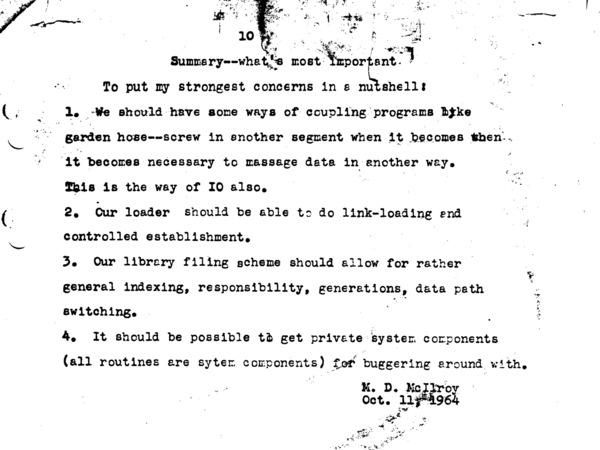
I Brian Kernighans bok "", nämns också detta dokument i historien om pipelining: "...den hängde på väggen i mitt kontor på Bell Labs i 30 år". Här är , och ännu en historia från :
När Unix kom, fick min fascination för koroutiner mig att be operativsystemets skapare, Ken Thompson, att låta data som skrivs av en process gå inte bara till en enhet, utan också till en annan process. Ken tyckte att det var möjligt. Men som minimalisten han var ville han att varje systemfunktion skulle spela en betydande roll. Har direkt skrivning mellan processer verkligen stora fördelar jämfört med skrivning till en mellanlagrad fil? Och först när jag kom med ett specifikt förslag med den snärtiga titeln "pipeline" och en beskrivning av syntaxen för processinteraktion, utbrast Ken finally "Jag ska göra det!".
Och han gjorde. En ödesdiger kväll ändrade Ken kärnan och skalet, rättade några standardprogram och standardiserade deras indatahanteringsprocedurer (som kan komma från pipelinan), och ändrade också filnamnen. Nästa dag började pipeliner användas i stor utsträckning i applikationer. I slutet av veckan använde sekreterarna dem för att skicka dokument från textredigerare till skrivaren. Strax därefter ersatte Ken den ursprungliga API:n och syntaxen för skalanvändning av pipeliner med renare konventioner som sedan dess har använts.
Tyvärr har källkoden till kärnan i den tredje versionen av Unix gått förlorad. Även om vi har den skrivna i C källkoden till den , som släpptes i november 1973, släpptes den flera månader innan den officiella lanseringen och innehåller inte implementeringen av pipeliner. Det är tråkigt att källkoden till den legendariska Unix-funktionen har gått förlorad, kanske för alltid.
Vi har texten i dokumentationen om pipe(2) från båda versionerna, så man kan börja med att söka i dokumentationen (genom vissa ord som är markerade "manuellt", en rad av litteraler ^H, efter vilken det finns ett understreck!). Denna proto-pipe(2) är skriven i assembler och returnerar endast en filbeskrivare, men erbjuder redan den förväntade grundläggande funktionen:
Systemanropet pipe skapar en in-/utgångsmekanism som kallas en pipeline. Den returnerade filbeskrivaren kan användas för läs- och skrivoperationer. När något skrivs in i pipelinen buffras det upp till 504 byte data, varefter skrivprocessen pausas. Vid läsning från pipelinen tas de buffrade uppgifterna.
Till nästa år hade kärnan skrivits om i C, och fick sin moderna form med prototypen "pipe(fildes)»:
Systemanropet pipe skapar en in-/utgångsmekanism som kallas en pipeline. De returnerade filbeskrivarna kan användas i läs- och skrivoperationer. När något skrivs in i pipelinen, används den beskrivare som returneras i r1 (dvs. fildes[1]), och det buffras upp till 4096 byte data, varefter skrivprocessen pausas. Vid läsning från pipelinen hämtar den beskrivare som returneras i r0 (dvs. fildes[0]) data.
Det förutsätts att efter att pipelinen har definierats kommer två (eller fler) interagerande processer (skapade av efterföljande anrop fork) att överföra data från pipelinen via anrop läs och skriv.
I skalet finns det syntax för att definiera en linjär array av processer kopplade via pipelinen.
Anrop för att läsa från en tom pipeline (som inte innehåller buffrade data), som endast har en ände (alla skrivande filbeskrivare är stängda), returnerar "ände på filen". Anrop för att skriva i en liknande situation ignoreras.
Den tidigaste tillhör (juni 1974), men den är nästan identisk med den som dök upp i nästa version. Endast kommentarer lades till, så den femte upplagan kan utelämnas.
Den sjätte upplagan av Unix (1975)
Vi börjar läsa källkoden för Unix (maj 1975). Mycket tack vare Lions är det mycket lättare att hitta än källkoden till tidigare versioner:
Många år boken Lions var det enda dokumentet om Unix-kärnan som var tillgängligt utanför väggarna på Bell Labs. Även om licensen för den sjätte utgåvan tillät lärare att använda dess källkod, exkluderade licensen för den sjunde utgåvan denna möjlighet, så boken spreds i form av olagliga maskingranskningar.
Idag kan man köpa en reprotryck av boken, med en omslagsbild som visar studenter vid en kopieringsmaskin. Tack vare Warren Toomey (som startade projektet TUHS) kan du ladda ner . Jag vill ge er en uppfattning om hur mycket arbete som lagts ner på att skapa filen:
För mer än 15 år sedan knäppte jag en kopia av källkoden som ges i Lions, eftersom jag inte gillade kvaliteten på min kopia jämfört med det okända antal andra kopior. TUHS existerade inte än, och jag hade inte tillgång till några gamla källor. Men 1988 hittade jag en gammal band med 9 spår som innehöll en säkerhetskopia från PDP11-datorn. Det var svårt att avgöra om den fungerade, men där fanns en oskadad mapp \/usr\/src\/ där de flesta filerna var märkta med årtalet 1979, vilket redan då såg uråldrigt ut. Detta var den sjunde utgåvan eller en avkomma till PWB, som jag trodde.
Jag tog fyndet som grund och redigerade manuellt källorna till tillståndet för den sjätte utgåvan. Delar av koden förblev desamma, medan andra fick göras något justerade genom att byta ut den moderna token += mot den föråldrade =+. Vissa delar raderade jag helt, medan andra fick skrivas om helt, men inte alltför många.
Idag kan vi online läsa källkoden för den sjätte utgåvan på TUHS från .
För övrigt, vid första anblick verkar den främsta egenskapen hos C-koden innan Kernighan och Ritchie vara dess korthet. Jag får sällan in fragment av kod utan omfattande redigering för att det ska passa en relativt smal visningsyta på min webbplats.
I början finns det en förklarande kommentar (och ja, det finns mer ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
Buffertstorleken har inte förändrats sedan den fjärde utgåvan. Men här, utan någon offentlig dokumentation, ser vi att rörledningar någon gång använde filer som en backup-lagring!
Vad gäller LARG-filer, så motsvarar de , som används av "den stora adresseringsalgoritmen" för bearbetning. för att stödja större filsystem. Eftersom Ken sagt att det är bäst att inte använda dem, litar jag gladeligen på hans ord.
Här är ett riktigt systemanrop pipe:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
I kommentaren beskrivs tydligt vad som händer här. Men att förstå koden är inte så enkelt, delvis på grund av hur "" och registren R0 och R1 används för att överföra parametrar för systemanrop och returnerade värden.
Vi ska försöka med hjälp av placera på disken , och med hjälp av — placera i minnet två . Om allt går bra, ställer vi in flaggorna för att identifiera dessa filer som de två ändarna av en pipeline, vi anger dem i samma inode (vars referensräknare blir 2), och markerar inode som ändrad och använd. iput()
pipe() i felvägar (error paths) för att minska referensräknaren i den nya inode. R0 och R1 måste genom att falloc() återvända filbeskrivare nummer för läsning och skrivning. återvänder en pekare till filstrukturen, men "återvänder" också genom u.u_ar0[R0] är lika med noll. och filbeskrivaren. Det vill säga att koden sparar i återvänder en pekare till filstrukturen, men "återvänder" också genom filbeskrivaren för läsning och tilldelar beskrivaren för skrivning direkt från falloc().
Flagga efter den andra anropetFPIPE rdwr() i sys2.c
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
, som anropar specifika I/O underprogram: Sedan läser funktionen på readp() pipe.c data från pipen. Men att följa implementeringen är bättre att börja medwritep().
Jag upprepar, koden har blivit mer komplicerad på grund av särskilda överenskommelser om argumentöverföring, men vissa detaljer kan förbises.
writep(fp) { register *rp, *ip, c;rp = fp; ip = rp->f_inode; c = u.u_count;loop: /* Om allt är klart, återvänd. */plock(ip); if(c == 0) { prele(ip); u.u_count = 0; return; }/* * Om det inte finns både läs- och skrivsidor av * pipen aktiva, återvänd med fel och signalera också. */if(ip->i_count i_size1 == PIPSIZ) { ip->i_mode |= IWRITE; prele(ip); sleep(ip+1, PPIPE); goto loop; }/* Skriv vad som är möjligt och loopa tillbaka. */u.u_offset[0] = 0; u.u_offset[1] = ip->i_size1; u.u_count = min(c, PIPSIZ-u.u_offset[1]); c -= u.u_count; writei(ip); prele(ip); if(ip->i_mode & IREAD) { ip->i_mode &= ~IREAD; wakeup(ip+2); } goto loop; } Till pipens ingång vill vi skriva byteu.u_count. Först måste vi kräva att indexdescriptoren låses (se nedan/plock, prele).
Sedan kontrollerar vi inode-länkräknaren. Så länge båda ändar av pipen förblir öppna, bör räknaren vara lika med 2. Vi håller en länk (från rp->f_inode), så om räknaren är mindre än 2, betyder det att läsprocessen har stängt sin ände av pipen. Med andra ord försöker vi skriva till en stängd pip, och det är ett fel. Felkoden EPIPE och signalen SIGPIPE kom i sjätte upplagan av Unix.
Men även om pipen är öppen kan den vara full. I så fall tar vi bort låsningen och går och lägger oss i hopp om att en annan process läser från pipen och frigör tillräckligt med utrymme. När vi vaknar går vi tillbaka till början, hänger på låsningen igen och startar en ny skrivcykel.
Om det finns tillräckligt med ledigt utrymme i pipen skriver vi data med . Parametern i_size1 från inode (i en tom pip kan detta vara 0) anger slutet på de data som redan finns i den. Om det finns utrymme för att skriva kan vi fylla pipen från i_size1 till PIPESIZ. Sedan tar vi bort låsningen och försöker väcka vilken process som helst som väntar på att läsa från pipen. Vi går tillbaka till början för att se om vi lyckades skriva så många byte som vi behövde. Om vi inte lyckas, börjar vi en ny skrivcykel.
Normalt används parametern i_mode från inode för att lagra behörigheter. är lika med noll., — kolumnvektorer, och $inline$(.)^H$inline$ är operationen och xMen i fallet med pipar signalerar vi väntan av någon skrivande eller läsande process med hjälp av bitarna IREAD och IWRITE respektive. Processen sätter en flagga och anropar sleep(), och det förväntas att i framtiden kommer någon annan process att anropa wakeup().
Det verkliga magin sker i sleep() och wakeup(). De är implementerade i , källan till den berömda kommentaren "Du behöver inte förstå detta" (You are not expected to understand this). Lyckligtvis behöver vi inte förstå koden, utan vi kollar bara några kommentarer:
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
Processen som anropar sleep() för en viss kanal kan senare väckas av en annan process som anropar wakeup() för samma kanal. data från pipen. Men att följa implementeringen är bättre att börja med och Sedan läser funktionen Koordinerar sina åtgärder genom sådana parvisa anrop. Observera att readp() alltid prioriterar PPIPE vid anropet sleep(), så att alla sleep() kan avbrytas av signalen.
Nu har vi allt för att förstå funktionen Sedan läser funktionen:
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Mycket konservativ låsning. */

    plock(ip);

    /*
     * Om huvudet (läs) har ikapp med
     * svansen (skriv), återställ båda till 0.
     * /

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode &= ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * Om det inte finns både läsare och
         * skrivare aktiva, återställ utan
         * att tillfredsställa läsning.
         * /

        prele(ip);
        if(ip->i_count i_mode |= IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Läs och returnera */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Det kan vara lättare för dig att läsa denna funktion uppifrån och ner. Grenen "läs och returnera" används vanligtvis när det finns data i pipeline. I det här fallet använder vi för att läsa så mycket data som är tillgängligt från den aktuella f_offset läspositionen, och uppdaterar sedan värdet för motsvarande förskjutning.
Vid nästa läsning kommer pipelinen att vara tom om läspositionen har nått värdet i_size1 för inode. Vi återställer positionen till 0 och försöker väcka alla processer som vill skriva till pipelinen. Vi vet att när pipelinen är full, data från pipen. Men att följa implementeringen är bättre att börja med kommer den att somna på ip+1. Och nu, när pipelinen är tom, kan vi väcka den så att den återupptar sin skrivcykel.
Om det inte finns något att läsa, kan den ställa en flagga Sedan läser funktionen och somna på IREAD ip+2 . Vi vet att den kommer att väckasnär den skriver data till pipelinen. data från pipen. Men att följa implementeringen är bättre att börja medKommentarer till
readi() och writei() ", kan vi hantera dem som vanliga in- och utdata funktioner som tar en fil, position, minnesbuffert och räknar antalet byte att läsa eller skriva.uVad gäller "konservativ" låsning, låser
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
inode tills den har avslutat arbetet eller fått resultat (det vill säga kallat Sedan läser funktionen och data från pipen. Men att följa implementeringen är bättre att börja med wakeup plock()). prele() och fungerar helt enkelt: med hjälp av en annan uppsättning anrop kan vi väcka vilken process som helst som behöver den lås som vi just har släppt: sleep och plock() Till en början kunde jag inte förstå varför
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
inte kallar Sedan läser funktionen prele(ip) före anropet wakeup(ip+1). Det första som anropar i sin loop ärplock(ip), vilket leder till dödlåsning om data från pipen. Men att följa implementeringen är bättre att börja med den inte redan har släppt sin lås, så koden måste på något sätt fungera korrekt. Om vi ser på plock(ip), som leder till en död låsning om Sedan läser funktionen han fortfarande inte har tagit bort sin lås, så koden måste på något sätt fungera korrekt. Om man tittar på wakeup(), blir det tydligt att det bara markerar den sovande processen som redo för körning, så att den i framtiden sched() verkligen kan köras. Så att Sedan läser funktionen orsakar wakeup(), tar bort låsningen, ställer in IREAD och anropar sleep(ip+2)— allt detta innan data från pipen. Men att följa implementeringen är bättre att börja med den återupptar cykeln.
Med detta är beskrivningen av rör i den sjätte utgåvan avslutad. Enkel kod, långtgående konsekvenser.
(januari 1979) var en ny stor release (efter fyra år), där många nya applikationer och kärnegenskaper introducerades. Det har också genomgått betydande förändringar på grund av typkonvertering, unioner och typade pekare till strukturer. Men har praktiskt taget inte förändrats. Vi kan hoppa över denna utgåva.
Xv6, en enkel Unix-liknande kärna
Kreationen av kärnan påverkades av den sjätte utgåvan av Unix, men den är skriven i modern C för att köras på x86-processorer. Koden är lättläst, den är begriplig. Dessutom, till skillnad från Unix-källorna från TUHS, kan du kompilera, modifiera och köra den på något annat än PDP 11/70. Därför används denna kärna ofta på universitet som undervisningsmaterial om operativsystem. Källkoden .
Koden innehåller en tydlig och genomtänkt implementering , som stöds av en buffert i minnet istället för en inode på disken. Här ger jag bara definitionen av "strukturell rör" och funktionerna pipealloc():
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
pipealloc() sätter tillståndet för hela den återstående implementeringen, som inkluderar funktionerna piperead(), pipewrite() och pipeclose(). Det faktiska systemanropet sys_pipe är ett wrap, implementerat i . Jag rekommenderar att du läser hela dess kod. Komplexiteten är på nivån av den sjätte utgåvans kod, men det är mycket lättare och trevligare att läsa.
Linux 0.01
Du kan hitta källkoden för Linux 0.01. Det kommer att vara värdefullt att studera implementeringen av rör i dess fs/readp(). Här används inode för att representera röret, men själva röret är skrivet i modern C. Om du har tagit dig igenom koden för den sjätte utgåvan, så kommer du inte att ha några svårigheter här. Så här ser funktionen write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* no readers */
        current->signal |= (1< 0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE(PIPE_HEAD(*inode));
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
Även utan att se definitionsstrukturerna kan man förstå hur referensräknaren inode används för att kontrollera om skrivoperationen leder till SIGPIPE. Förutom byte-för-byte-arbetet är det lätt att koppla den här funktionen till de tidigare nämnda idéerna. Även logiken sleep_on/wake_up ser inte så främmande ut.
Moderna Linux-kärnor, FreeBSD, NetBSD, OpenBSD
Jag gick snabbt igenom några moderna kärnor. Ingen av dem har längre en implementation som använder disken (inte förvånande). I Linux finns en egen implementation. Och även om de tre moderna BSD-kärnorna innehåller implementationer baserade på kod som skrevs av John Dyson, har de under åren blivit alltför olika varandra.
För att läsa fs/readp() (på Linux) eller sys/kern/sys_pipe.c (på *BSD) krävs det verkligt engagemang. Idag är prestanda och stöd för funktioner som vektorisering och asynkrona I/O-operationer viktiga i koden. Och detaljer kring minnesallokering, lås och kärnkonfiguration—allt detta varierar kraftigt. Det är inte något som universitet skulle använda för en introduktionskurs i operativsystem.
I vilket fall som helst var det intressant att gräva fram några gamla mönster (t.ex. generering SIGPIPE och återvändande EPIPE vid skrivning till en stängd pipelin) i alla dessa, så olika, moderna kärnor. Troligtvis kommer jag aldrig att se en PDP-11-dator i verkligheten, men det finns fortfarande mycket att lära av koden som skrevs flera år före min födelse.
Den artikel som skrevs av Divi Kapoor 2011 "" ger en översikt över hur (fortfarande) pipelinare fungerar i Linux. Och illustrerar pipelinemodellen för interaktion vars möjligheter övergår de temporära filernas; den visar dessutom hur långt pipelinerna har kommit från "den mycket konservativa låsningen" i den sjätte versionen av Unix.
Källa: habr.com
