

Hög prestanda är ett av de viktigaste kraven när man arbetar med stora datamängder. Vi på dataladdningshantering i Sber arbetar med att pumpa nästan alla transaktioner till vår Data Cloud baserat på Hadoop, och därmed hanterar vi verkligen stora informationsflöden. Naturligtvis letar vi hela tiden efter sätt att öka prestandan, och nu vill vi berätta hur vi lyckades patcha RegionServer HBase och HDFS-klienten, vilket har ökat hastigheten för läsoperationer betydligt.
Men innan vi går vidare till detaljerna i ändringarna, är det värt att nämna begränsningarna som i princip inte går att kringgå om man använder HDD.
Varför HDD och snabba Random Access-läsningar är oförenliga
Som bekant lagrar HBase och många andra databaser data i block, vanligtvis med en storlek på flera tiotals kilobyte. Som standard är detta cirka 64 KB. Låt oss nu tänka oss att vi behöver hämta endast 100 byte och ber HBase att ge oss dessa data via en viss nyckel. Eftersom storleken på blocket i HFiles är 64 KB kommer det begärda att vara 640 gånger mer (tänk på det!) än vad vi behöver.
Dessutom, eftersom förfrågan kommer att gå genom HDFS och dess mekanism för cache av metadatan ShortCircuitCache (som möjliggör direkt åtkomst till filer), leder det till att man läser 1 MB från disken. Det är dock möjligt att reglera detta med parametern dfs.client.read.shortcircuit.buffer.size och i många fall är det meningsfullt att minska detta värde, till exempel till 126 KB.
Antag att vi gör detta, men dessutom, när vi börjar läsa data genom java API:er, med funktioner som FileChannel.read och ber operativsystemet att läsa den angivna datamängden, läser det "för säkerhets skull" dubbelt så mycket, det vill säga 256 KB i vårt fall. Detta sker eftersom det i java inte finns en enkel möjlighet att ställa in flaggan FADV_RANDOM som förhindrar ett sådant beteende.
Som ett resultat, för att få våra 100 byte på insidan läses 2600 gånger mer. Tycktes uppenbart — låt oss minska blockstorleken till en kilobyte, ställa in den nämnda flaggan och uppnå stort accelererat resultat. Men problemet är att genom att halvera blockstorleken minskar vi också antalet lästa byte per tidsenhet med samma faktor.
Det är möjligt att få viss vinst av att sätta flaggan FADV_RANDOM, men endast vid hög grad av flertrådadhet och med en blockstorlek på minst 128 kB, vilket ger högst ett par tiotal procent:
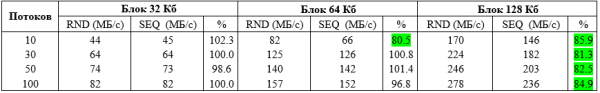
Tester utfördes på 100 filer, var och en med en storlek på 1 GB, som lagrades på 10 HDD-enheter.
Låt oss beräkna vad vi i princip kan förvänta oss med sådan hastighet:
Anta att vi läser från 10 enheter med en hastighet av 280 MB/s, d.v.s. 3 miljoner gånger 100 byte. Men som vi minns förekommer de data vi behöver 2600 gånger mindre än vad som läses. Således delar vi 3 miljoner med 2600 och får 1100 poster per sekund.
Tråkigt, eller hur? Sådan är verkligheten Random Access av data på HDD – oavsett blockstorlek. Detta är den fysiska gränsen för slumpmässig åtkomst och ingen databas kan få ut mer än det under dessa förhållanden.
Hur kan databaserna då uppnå betydligt högre hastigheter? För att svara på denna fråga, låt oss titta på vad som händer i nästa bild:
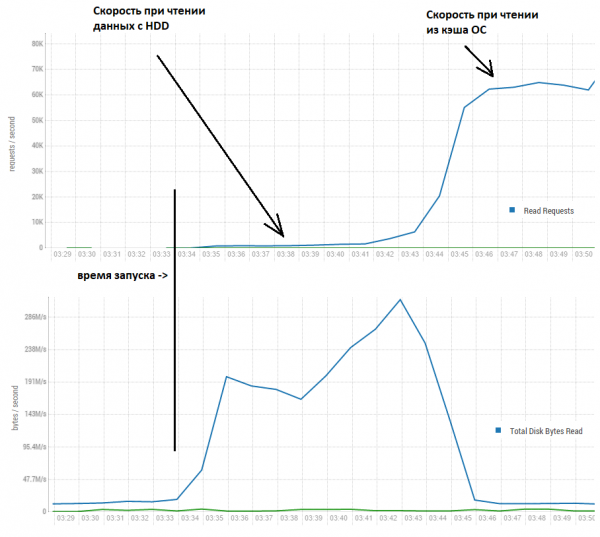
Här ser vi att hastigheten de första minuterna faktiskt är omkring tusen poster per sekund. Men därefter, eftersom det läses betydligt mer än vad som begärts, lagras data i buff/cache i operativsystemet (linux) och hastigheten ökar till mer respektabla 60 000 per sekund.
Således kommer vi framöver att fokusera på att öka åtkomsten endast till de data som finns i OS-cache eller tillgängliga i jämförbara snabba lagringssystem som SSD/NVMe.
I vårt fall kommer vi att utföra tester på en rigg bestående av 4 servrar, där varje enhet är konfigurerad på följande sätt:
CPU: Xeon E5-2680 v4 @ 2.40GHz 64 trådar.
Minne: 730 GB.
java version: 1.8.0_111
Och här är den avgörande punkten – mängden data i tabellerna som behöver läsas. Det är så att om man läser data från en tabell som helt får plats i HBase-cache, kommer det inte ens att bli aktuellt att läsa från buff/cache i operativsystemet. Eftersom HBase som standard avsätter 40% av minnet för en struktur som kallas BlockCache. I praktiken är detta en ConcurrentHashMap, där nyckeln är filnamn + blockoffset, och värdet är de faktiska data vid denna förskjutning.
Således, när läsning endast sker från denna struktur, , ungefär en miljon förfrågningar per sekund. Men låt oss föreställa oss att vi inte kan allokera hundratals gigabyte minne enbart för databasens behov, eftersom på dessa servrar körs många andra användbara applikationer.
Till exempel, i vårt fall är storleken på BlockCache på en RS cirka 12 GB. Vi har lanserat två RS på en nod, vilket innebär att 96 GB har avsatts för BlockCache på alla noder. Och mängden data är åtskilligt större, låt oss säga att det handlar om 4 tabeller, med 130 regioner, där filerna har en storlek på 800 MB, komprimerade med FAST_DIFF, vilket i summan ger 410 GB (detta är ren data, utan hänsyn till replikationsfaktorn).
Således utgör BlockCache endast cirka 23% av den totala datamängden, och detta ligger mycket närmare de verkliga förhållandena för vad som kallas BigData. Och här börjar det intressanta – det är uppenbart att ju färre träffar i cachen, desto sämre prestanda. För i fallet med missar kommer vi att behöva utföra en hel del arbete – det vill säga, vi måste gå ner till anropen av systemfunktioner. Men det går inte att undvika, så låt oss överväga en helt annan aspekt – vad händer med datan inne i cachen?
Låt oss förenkla situationen och anta att vi har en cache som bara rymmer 1 objekt. Här är ett exempel på vad som händer när vi försöker arbeta med en datamängd som är 3 gånger så stor som cachen:
1. Placera block 1 i cachen
2. Ta bort block 1 från cachen
3. Placera block 2 i cachen
4. Ta bort block 2 från cachen
5. Placera block 3 i cachen
Fem åtgärder har genomförts! Men det går inte att kalla denna situation normal, vi tvingar i praktiken HBase att utföra en hel del helt meningslös arbetsinsats. Det läser ständigt ut data från operativsystemets cache, lägger det i sin BlockCache, för att nästan omedelbart kasta bort det, eftersom en ny mängd data anlände. Animationen i början av inlägget visar problemets kärna – Garbage Collector överbelastas, atmosfären värms upp, lilla Greta i fjärran och varma Sverige blir nedslagen. Och vi IT-proffs gillar verkligen inte när barn är ledsna, så vi börjar tänka på vad vi kan göra åt detta.
Men vad om vi bara lägger in en viss procent av blocken i cachen, så att cachen inte överfylls? Låt oss för börja med att bara lägga till några rader kod i början av funktionen för att placera data i BlockCache:
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
Poängen här är att offset är positionen för blocket i filen och de sista siffrorna är slumpmässigt och jämnt fördelade från 00 till 99. Därför kommer vi enbart att hoppa över de som faller inom det intervall vi behöver.
Till exempel, låt oss sätta cacheDataBlockPercent = 20 och se vad som händer:
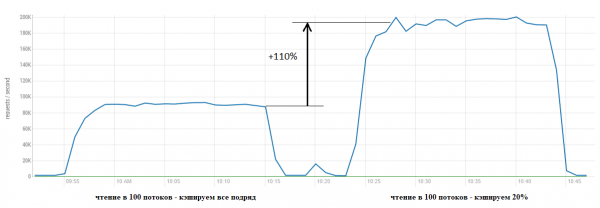
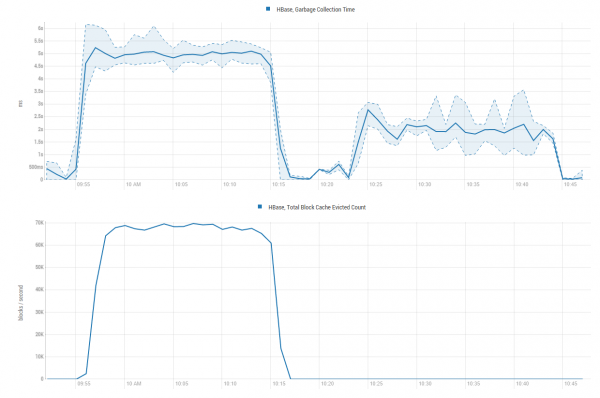
Resultatet talar för sig själv. I graferna nedan blir det tydligt vad som orsakar denna acceleration - vi sparar en massa resurser från GC genom att inte ägna oss åt Sisypheus arbete med att placera data i cachen, endast för att genast kasta bort dem till marsianerna under svansen:
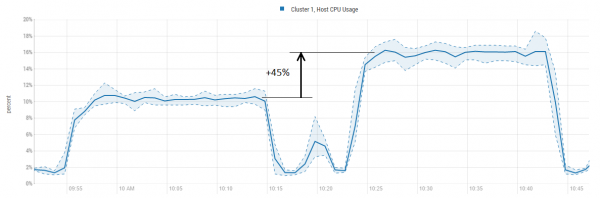
CPU-användningen ökar, men betydligt mindre än prestandan:
Det är också värt att nämna att block som lagras i BlockCache kan vara av olika slag. Merparten, omkring 95%, är faktiskt data. Resten är metadata, såsom Bloom-filter eller LEAF_INDEX och . Denna metadata är liten men mycket användbar, eftersom HBase, innan den direkt vänder sig till data, först konsulterar metadata för att förstå om det behövs en vidare sökning här, och om så är fallet, var det intressanta blocket ligger.
Därför ser vi en villkorskontroll i koden buf.getBlockType().isData() och tack vare denna metadata kommer vi alltid att behålla den i cachen.
Nu låt oss öka belastningen och också justera funktionen något. I det första testet satte vi gränsen för urvalet till 20 och BlockCache var något överbelastad. Nu låter vi det vara 23% och lägger till 100 trådar var 5:e minut för att se vid vilken punkt mättnaden inträffar:
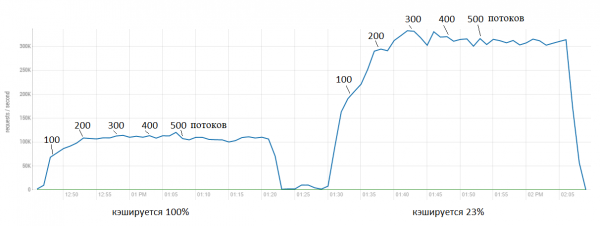
Här ser vi att den ursprungliga versionen nästan omedelbart når taket på omkring 100 tusen förfrågningar per sekund. Medan patchen ger en acceleration upp till 300 tusen. Det är tydligt att vidare acceleration inte är lika "gratis", och CPU-användningen ökar också.
Men det är inte en särskilt elegant lösning eftersom vi i förväg inte vet vilken procentandel av blocken som behöver cachas, det beror på belastningsprofilen. Därför implementerades en mekanism för automatisk justering av denna parameter beroende på aktivitetsnivån av läsningsoperationer.
För att hantera detta har tre parametrar lagts till:
hbase.lru.cache.heavy.eviction.count.limit — ställer in hur många gånger datavalvets utskiljandeprocess bör köras innan vi börjar använda optimering (dvs. hoppa över block). Som standard är det MAX_INT = 2147483647, vilket i praktiken innebär att funktionen aldrig kommer att börja fungera vid detta värde. Utskiljningsprocessen körs var 5:e till 10:e sekund (det beror på belastningen) och 2147483647 * 10 / 60 / 60 / 24 / 365 = 680 år. Vi kan dock ställa in detta parameter till 0 och tvinga funktionen att fungera omedelbart efter start.
Det finns dock en nyttolast i denna parameter. Om vår belastningskaraktär innebär att kortvariga läsningar (antagligen under dagen) ständigt växlar med långvariga läsningar (på natten), kan vi göra så att funktionen aktiveras endast under pågående långvariga läsningsoperationer.
Till exempel vet vi att kortvariga läsningar vanligtvis varar i cirka 1 minut. Under denna tid behöver vi inte börja ta bort block, cachen hinner inte bli föråldrad och vi kan ställa in denna parameter till exempelvis 10. Det innebär att optimering börjar fungera först när en långvarig läsning har inletts, det vill säga efter 100 sekunder. Således, om vi har en kortvarig läsning, kommer alla block att hamna i cachen och vara tillgängliga (förutom de som tas bort med den standardalgoritmen). Men när vi genomför långvariga läsningar, aktiveras funktionen och vi får betydligt högre prestanda.
hbase.lru.cache.heavy.eviction.mb.size.limit — ställer in hur många megabyte vi skulle vilja placera i cachen (och naturligtvis ta bort) var 10:e sekund. Funktionen kommer att försöka nå detta värde och upprätthålla det. Syftet är följande: om vi trycker in gigabyte i cachen, kommer vi också att behöva ta bort gigabyte, vilket, som vi sett ovan, är ganska kostsamt. Men man bör inte försöka göra det för litet, eftersom det kan leda till att blockhoppsläget avslutas för tidigt. För kraftfulla servrar (omkring 20-40 fysiska kärnor) är det optimalt att ställa in detta på cirka 300-400 MB. För medelklass system (ungefär 10 kärnor) 200-300 MB. För svagare system (2-5 kärnor) kan 50-100 MB vara rimligt (detta har inte testats på sådana system).
Låt oss titta på hur detta fungerar: anta att vi har ställt in hbase.lru.cache.heavy.eviction.mb.size.limit = 500, det finns en viss belastning (läsningar) och var 10:e sekund beräknar vi hur många byte som har friställts med formeln:
Overhead = Frigjorda byte-summan (MB) * 100 / Gräns (MB) — 100;
Om det faktiskt har friställts 2000 MB, blir Overhead:
2000 * 100 / 500 — 100 = 300%
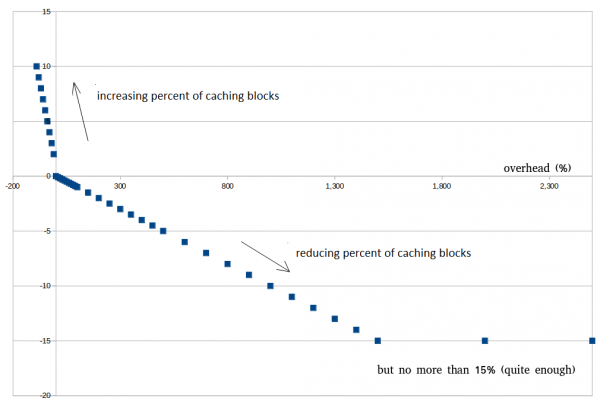
Algoritmerna strävar efter att hålla overhead under några tiotal procent, så funktionen kommer att minska procenten av cachelagrade block och därmed implementera en automatisk justeringsmekanism.
Men om belastningen minskar, låt oss säga att det har friställts totalt 200 MB och Overhead blivit negativt (så kallad overshooting):
200 * 100 / 500 — 100 = -60%
Så kommer funktionen istället att öka procenten av cachelagrade block tills Overhead blir positiv.
Nedan följer ett exempel på hur detta ser ut med verkliga data. Försök inte sträva efter 0%, det är omöjligt. Det är ganska bra när det ligger runt 30–100%, det hjälper till att undvika ett för tidigt avbrott i optimeringsläget vid kortsiktiga toppar.
hbase.lru.cache.heavy.eviction.overhead.coefficient — ställer in hur snabbt vi skulle vilja få resultat. Om vi vet att våra läsningar mestadels är långvariga och inte vill vänta, kan vi öka denna koefficient och få hög prestanda snabbare.
Till exempel, om vi har ställt in denna koefficient till 0.01. Detta betyder att Overhead (se ovan) kommer att multipliceras med detta tal och procenten av cachelagrade block kommer att minskas. Låt oss säga att Overhead = 300%, och koefficienten = 0.01, då kommer procenten av cachelagrade block att minskas med 3%.
En liknande logik för «Backpressure» är implementerad även för negativa värden av Overhead (overshooting). Eftersom kortsiktiga svängningar i läsnings- och friställningsvolymer alltid är möjliga, så tillåter denna mekanism att undvika ett för tidigt avbrott i optimeringsläget. Backpressure har en omvänd logik: ju mer overshooting, desto fler block cachelagras.
Implementeringskod
        LruBlockCache cache = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict() / 1024 / 1024;
        /*
        * Ibland läser vi mer data än vad som får plats i BlockCache
        * och detta orsakar en hög frekvens av utslagning.
        * Detta leder i sin tur till mycket arbete för skräpföraren.
        * Så många block läggs in i BlockCache men läses aldrig,
        * men använder mycket CPU-resurser.
        * Här kommer vi att analysere hur många byte som frigjordes och besluta
        * huruvida tiden har kommit att minska mängden cachade block.
        * Det hjälper till att undvika att lägga för många block i BlockCache
        * när evict() arbetar väldigt aktivt och sparar CPU för andra uppgifter.
        * Mer detaljer: https://issues.apache.org/jira/browse/HBASE-23887
        */

        // Först och främst måste vi kontrollera hur mycket tid
        // som har passerat sedan föregående evict() kördes
        // Detta bör vara nästan samma tid (+/- 10s)
        // eftersom vi får jämförbara volymer av frigjorda byte varje gång.
        // 10s eftersom detta är den standardperiod för att köra evict() (se ovan this.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Här måste vi beräkna vilken situation vi har fått.
          // Vi har begränsningen "hbase.lru.cache.heavy.eviction.bytes.size.limit"
          // och kan beräkna överbelastningen på den.
          // Vi kommer använda denna information för att besluta,
          // hur man ändrar procenten av cachade block.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Nu är vi i en situation där vi är över gränsen
            // Men kanske vi kommer att ignorera det eftersom det kommer att ta slut ganska snart
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // Det har pågått länge och vi måste minska cachningen
              // av block nu. Så vi beräknar här hur många block vi vill hoppa över.
              // Det beror på:
              // 1. Överbelastning - om överbelastningen är stor kan vi vara mer aggressiva
              // reducera mängden cachade block.
              // 2. Hur snabbt vi vill få resultatet. Om vi vet att vår
              // tunga läsning pågår länge, vill vi inte vänta och kan
              // öka koefficienten och få bra prestanda ganska snart.
              // Men om vi inte är säkra kan vi göra det långsamt och det kan förhindra
              // för tidig åtgärd från detta läge. Så när koefficienten är
              // högre kan vi få bättre prestanda när tunga läsningen är stabil.
              // Men när läsningen ändras kan vi justera det och sätta
              // koefficienten till ett lägre värde.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // Men praktiken visar att 15% minskning är ganska tillräckligt.
              // Vi är inte giriga (det kan leda till för tidig åtgärd).
              change = Math.min(15, change);
              change = Math.max(0, change); // Jag tror aldrig att det kommer att hända men kontrollera för säkerhets skull
              // Så detta är nyckelpunkten, här minskar vi % av cachade block
              cache.cacheDataBlockPercent -= change;
              // Om vi går ner för djupt måste vi stoppa här, 1% måste vara kvar.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // Tja, vi har fått överskott.
            // Kanske är det bara en kortsiktig fluktuation och vi kan stanna kvar i detta läge.
            // Det hjälper att undvika för tidig utgång under kortsiktiga fluktuationer.
            // Om överskottet är mindre än 90% kommer vi att försöka öka procenten av
            // cachade block och hoppas att det är tillräckligt.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Enkel logik: mer överskott - fler cachade block (mottryck)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // Men det kan inte vara mer än 100%, så kontrollera det.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // Det verkar som om den tunga läsningen är över.
              // Bara avsluta detta läge.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache utslagen (MB): {}, överbelastning (%): {}, " +
            "tung utslagningsräknare: {}, " +
            "nuvarande cachad DataBlock (%): {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Låt oss nu titta på detta med ett verkligt exempel. Vi har följande testscenarie:
- Vi börjar med att göra en Scan (25 trådar, batch = 100)
- Efter 5 minuter lägger vi till multi-gets (25 trådar, batch = 100)
- Efter 5 minuter stänger vi av multi-gets (enbart scan kvar)
Vi gör två körningar, först hbase.lru.cache.heavy.eviction.count.limit = 10000 (vilket i praktiken stänger av funktionen), och sedan ställer vi in limit = 0 (aktiverar).
I loggarna nedan ser vi hur funktionen aktiveras och återställer Overshooting till 14-71%. Ibland minskar belastningen, vilket aktiverar Backpressure och HBase cachelagrar fler block igen.
Logg RegionServer
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 2170, ratio 1.09, overhead (%): 985, heavy eviction counter: 1, current caching DataBlock (%): 91 < start
evicted (MB): 3763, ratio 1.08, overhead (%): 1781, heavy eviction counter: 2, current caching DataBlock (%): 76
evicted (MB): 3306, ratio 1.07, overhead (%): 1553, heavy eviction counter: 3, current caching DataBlock (%): 61
evicted (MB): 2508, ratio 1.06, overhead (%): 1154, heavy eviction counter: 4, current caching DataBlock (%): 50
evicted (MB): 1824, ratio 1.04, overhead (%): 812, heavy eviction counter: 5, current caching DataBlock (%): 42
evicted (MB): 1482, ratio 1.03, overhead (%): 641, heavy eviction counter: 6, current caching DataBlock (%): 36
evicted (MB): 1140, ratio 1.01, overhead (%): 470, heavy eviction counter: 7, current caching DataBlock (%): 32
evicted (MB): 913, ratio 1.0, overhead (%): 356, heavy eviction counter: 8, current caching DataBlock (%): 29
evicted (MB): 912, ratio 0.89, overhead (%): 356, heavy eviction counter: 9, current caching DataBlock (%): 26
evicted (MB): 684, ratio 0.76, overhead (%): 242, heavy eviction counter: 10, current caching DataBlock (%): 24
evicted (MB): 684, ratio 0.61, overhead (%): 242, heavy eviction counter: 11, current caching DataBlock (%): 22
evicted (MB): 456, ratio 0.51, overhead (%): 128, heavy eviction counter: 12, current caching DataBlock (%): 21
evicted (MB): 456, ratio 0.42, overhead (%): 128, heavy eviction counter: 13, current caching DataBlock (%): 20
evicted (MB): 456, ratio 0.33, overhead (%): 128, heavy eviction counter: 14, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 15, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.32, overhead (%): 71, heavy eviction counter: 16, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.31, overhead (%): 71, heavy eviction counter: 17, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.3, overhead (%): 14, heavy eviction counter: 18, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.29, overhead (%): 14, heavy eviction counter: 19, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.27, overhead (%): 14, heavy eviction counter: 20, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.25, overhead (%): 14, heavy eviction counter: 21, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.24, overhead (%): 14, heavy eviction counter: 22, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.22, overhead (%): 14, heavy eviction counter: 23, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.21, overhead (%): 14, heavy eviction counter: 24, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.2, overhead (%): 14, heavy eviction counter: 25, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.17, overhead (%): 14, heavy eviction counter: 26, current caching DataBlock (%): 19
utsedda (MB): 456, förhållande 0.17, overhead (%): 128, tung utsättningsräknare: 27, nuvarande cachad DataBlock (%): 18 < tillagda begärningar (men tabellen är densamma)
utsedda (MB): 456, förhållande 0.15, overhead (%): 128, tung utsättningsräknare: 28, nuvarande cachad DataBlock (%): 17
utsedda (MB): 342, förhållande 0.13, overhead (%): 71, tung utsättningsräknare: 29, nuvarande cachad DataBlock (%): 17
utsedda (MB): 342, förhållande 0.11, overhead (%): 71, tung utsättningsräknare: 30, nuvarande cachad DataBlock (%): 17
utsedda (MB): 342, förhållande 0.09, overhead (%): 71, tung utsättningsräknare: 31, nuvarande cachad DataBlock (%): 17
utsedda (MB): 228, förhållande 0.08, overhead (%): 14, tung utsättningsräknare: 32, nuvarande cachad DataBlock (%): 17
utsedda (MB): 228, förhållande 0.07, overhead (%): 14, tung utsättningsräknare: 33, nuvarande cachad DataBlock (%): 17
utsedda (MB): 228, förhållande 0.06, overhead (%): 14, tung utsättningsräknare: 34, nuvarande cachad DataBlock (%): 17
utsedda (MB): 228, förhållande 0.05, overhead (%): 14, tung utsättningsräknare: 35, nuvarande cachad DataBlock (%): 17
utsedda (MB): 228, förhållande 0.05, overhead (%): 14, tung utsättningsräknare: 36, nuvarande cachad DataBlock (%): 17
utsedda (MB): 228, förhållande 0.04, overhead (%): 14, tung utsättningsräknare: 37, nuvarande cachad DataBlock (%): 17
utsedda (MB): 109, förhållande 0.04, overhead (%): -46, tung utsättningsräknare: 37, nuvarande cachad DataBlock (%): 22 < baktryck
utsedda (MB): 798, förhållande 0.24, overhead (%): 299, tung utsättningsräknare: 38, nuvarande cachad DataBlock (%): 20
utsedda (MB): 798, förhållande 0.29, overhead (%): 299, tung utsättningsräknare: 39, nuvarande cachad DataBlock (%): 18
utsedda (MB): 570, förhållande 0.27, overhead (%): 185, tung utsättningsräknare: 40, nuvarande cachad DataBlock (%): 17
utsedda (MB): 456, förhållande 0.22, overhead (%): 128, tung utsättningsräknare: 41, nuvarande cachad DataBlock (%): 16
utsedda (MB): 342, förhållande 0.16, overhead (%): 71, tung utsättningsräknare: 42, nuvarande cachad DataBlock (%): 16
utsedda (MB): 342, förhållande 0.11, overhead (%): 71, tung utsättningsräknare: 43, nuvarande cachad DataBlock (%): 16
utsedda (MB): 228, förhållande 0.09, overhead (%): 14, tung utsättningsräknare: 44, nuvarande cachad DataBlock (%): 16
utsedda (MB): 228, förhållande 0.07, overhead (%): 14, tung utsättningsräknare: 45, nuvarande cachad DataBlock (%): 16
utsedda (MB): 228, förhållande 0.05, overhead (%): 14, tung utsättningsräknare: 46, nuvarande cachad DataBlock (%): 16
utsedda (MB): 222, förhållande 0.04, overhead (%): 11, tung utsättningsräknare: 47, nuvarande cachad DataBlock (%): 16
utsedda (MB): 104, förhållande 0.03, overhead (%): -48, tung utsättningsräknare: 47, nuvarande cachad DataBlock (%): 21 < avbrutna begärningar
utsedda (MB): 684, förhållande 0.2, overhead (%): 242, tung utsättningsräknare: 48, nuvarande cachad DataBlock (%): 19
utsedda (MB): 570, förhållande 0.23, overhead (%): 185, tung utsättningsräknare: 49, nuvarande cachad DataBlock (%): 18
utsedda (MB): 342, förhållande 0.22, overhead (%): 71, tung utsättningsräknare: 50, nuvarande cachad DataBlock (%): 18
utsedda (MB): 228, förhållande 0.21, overhead (%): 14, tung utsättningsräknare: 51, nuvarande cachad DataBlock (%): 18
utsedda (MB): 228, förhållande 0.2, overhead (%): 14, tung utsättningsräknare: 52, nuvarande cachad DataBlock (%): 18
utsedda (MB): 228, förhållande 0.18, overhead (%): 14, tung utsättningsräknare: 53, nuvarande cachad DataBlock (%): 18
utsedda (MB): 228, förhållande 0.16, overhead (%): 14, tung utsättningsräknare: 54, nuvarande cachad DataBlock (%): 18
utsedda (MB): 228, förhållande 0.14, overhead (%): 14, tung utsättningsräknare: 55, nuvarande cachad DataBlock (%): 18
utsedda (MB): 112, förhållande 0.14, overhead (%): -44, tung utsättningsräknare: 55, nuvarande cachad DataBlock (%): 23 < baktryck
utsedda (MB): 456, förhållande 0.26, overhead (%): 128, tung utsättningsräknare: 56, nuvarande cachad DataBlock (%): 22
utsedda (MB): 342, förhållande 0.31, overhead (%): 71, tung utsättningsräknare: 57, nuvarande cachad DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 58, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 59, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 60, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 61, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 62, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 63, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.32, overhead (%): 71, tung utkastningsräknare: 64, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 65, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 66, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.32, overhead (%): 71, tung utkastningsräknare: 67, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 68, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.32, overhead (%): 71, tung utkastningsräknare: 69, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.32, overhead (%): 71, tung utkastningsräknare: 70, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 71, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 72, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 73, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 74, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 75, aktuell cache DataBlock (%): 22
utkastad (MB): 342, förhållande 0.33, overhead (%): 71, tung utkastningsräknare: 76, aktuell cache DataBlock (%): 22
utkastad (MB): 21, förhållande 0.33, overhead (%): -90, tung utkastningsräknare: 76, aktuell cache DataBlock (%): 32
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
Skanningarna behövdes för att visa samma process i form av ett diagram som visar förhållandet mellan två cache-sektioner – single (där block som ännu ingen har begärt hamnar) och multi (här lagras 'efterfrågade' data även om de har begärts minst en gång):
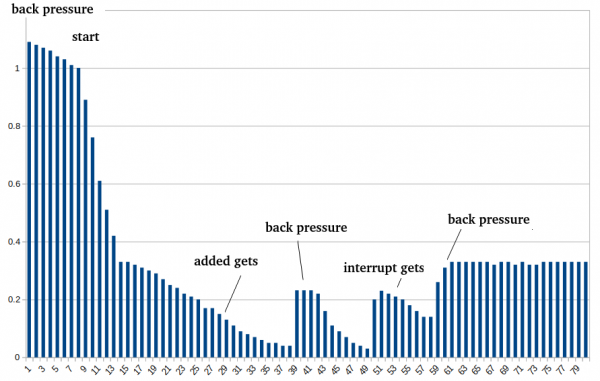
Och slutligen hur parameternas arbete ser ut i form av ett diagram. För jämförelse var cachen helt avstängd i början, sedan startades HBase med caching och en fördröjning på 5 minuter innan optimeringen påbörjades (30 cykler av utkastning).
Den fullständiga koden kan hittas i Pull Request på github.
Men 300 000 läsningar per sekund är inte allt som kan pressas ur denna utrustning under dessa förhållanden. Anledningen är att när man behöver komma åt data via HDFS används mekanismen ShortCircuitCache (hädanefter SSC), som gör det möjligt att få direkt åtkomst till data utan att involvera nätverksinteraktion.
Profileringsresultatet visade att denna mekanism, trots att den ger stor vinst, också blir en flaskehals vid en tidpunkt, eftersom praktiskt taget alla tunga operationer sker inom låset, vilket leder till blockeringar en stor del av tiden.
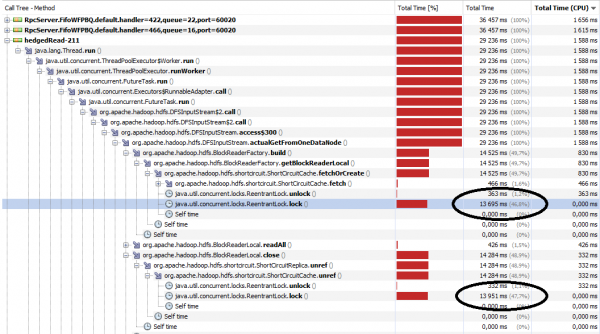
När vi insåg detta förstod vi att vi kunde kringgå problemet genom att skapa en uppsättning oberoende SSC:
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
Och sedan arbeta med dem, utesluta överlappningar även baserat på den sista siffran i offset:
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Nu kan vi börja med testerna. För detta kommer vi att läsa filer från HDFS med en enkel flerkärnig applikation. Vi ställer in parametrarna:
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); // som standard = 1 MB och detta saktar ner läsningen, så det är bättre att anpassa det till de verkliga behoven
conf.set("dfs.client.short.circuit.num", num); // från 1 till 10
Och vi läser helt enkelt filerna:
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i  900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
Denna kod körs i separata trådar och vi kommer att öka antalet filer som läses samtidigt (från 10 till 200 — horisontell axel) och antalet cacher (från 1 till 10 — grafer). Den vertikala axeln visar den acceleration som uppnås genom att öka SSC i förhållande till fallet när cache bara är en.
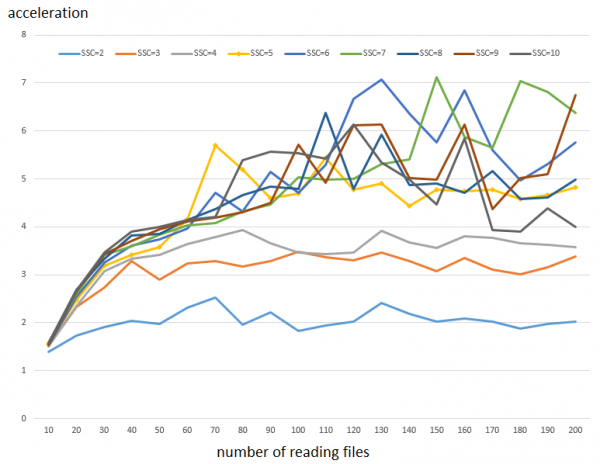
Så här läser man grafen: tiden för 100 000 läsningar i block om 64 KB med en enda cache tar 78 sekunder. Med 5 cacher utförs det på 16 sekunder. Det vill säga, det finns en acceleration på ~5 gånger. Som man kan se från grafen är effekten inte särskilt märkbar vid ett litet antal parallella läsningar; det börjar spela en märkbar roll när läsningarna är fler än 50. Det är också tydligt att ökningen av antalet SSC från 6 och uppåt ger betydligt mindre prestandaförbättring.
Not 1: Eftersom testresultaten är ganska volatila (se nedan) genomfördes 3 körningar och de erhållna värdena genomsnittsbildades.
Not 2: Prestandaförbättringen från inställningen för slumpmässig åtkomst är densamma, även om själva åtkomsten är något långsammare.
Det är dock viktigt att notera att, till skillnad från fallet med HBase, denna ökning inte alltid är gratis. Här "låser vi upp" CPU:ns möjligheter att utföra arbete istället för att fastna på lås.
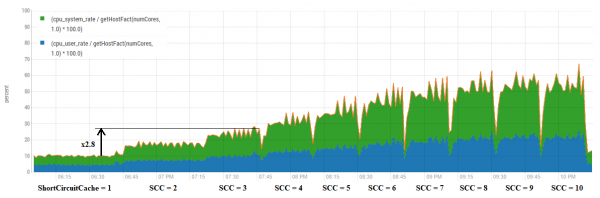
Här kan man se att en allmän ökning av antalet cachar ger en ungefär proportionerlig ökning av CPU-användningen. Det finns dock några mer fördelaktiga kombinationer.
Till exempel, låt oss titta närmare på inställningen SSC = 3. Prestandaökningen i intervallet ligger på cirka 3,3 gånger. Nedan visas resultaten från alla tre enskilda körningar.
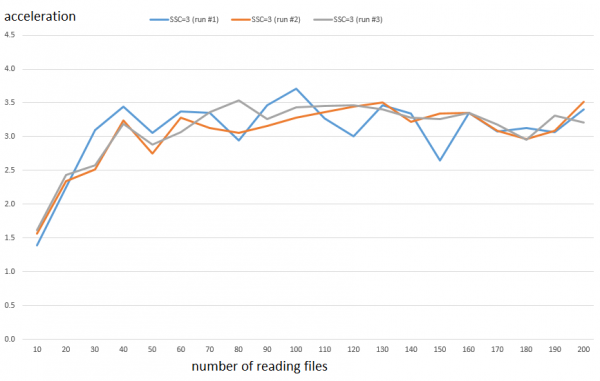
Däremot ökar CPU-förbrukningen med ungefär 2,8 gånger. Skillnaden är inte så stor, men lilla Greta är redan glad och kanske får hon tid att besöka skolan och lektionerna.
Således kommer detta att ha en positiv effekt för vilket verktyg som helst som använder massivt tillgång till HDFS (t.ex. Spark med mera), förutsatt att applikationskoden är lätt (det vill säga flaskhalsen ligger på HDFS-klientsidan) och att det finns ledig CPU-kapacitet. För att kontrollera detta, låt oss testa vilken effekt det ger att kombinera optimeringar av BlockCache och tunning av SSC för läsning från HBase.
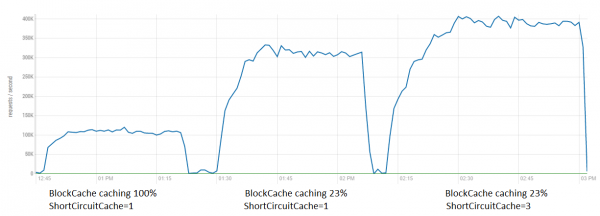
Här syns det att under sådana förhållanden är effekten inte lika stor som i raffinerade tester (läsning utan någon bearbetning), men att få ut ytterligare 80K är fullt möjligt. Tillsammans ger båda optimeringarna en hastighetsökning på upp till 4 gånger.
En PR har också gjorts för denna optimering. , som har sammanfogats och denna funktionalitet kommer att vara tillgänglig i kommande utgåvor.
Och slutligen var det intressant att jämföra läsprestandan hos en liknande wide-column databas Cassandra och HBase.
För detta kördes instanser av det standardiserade belastningstestverktyget YCSB från två värdar (totalt 800 trådar). På server-sidan - 4 instanser av RegionServer och Cassandra på 4 värdar (inte de där klienterna körs, för att undvika påverkan). Läsningarna gjordes från tabeller av storleken:
HBase - 300 GB på HDFS (100 GB rena data)
Cassandra - 250 GB (replication factor = 3)
Det vill säga, volymen var ungefär densamma (HBase något mer).
HBase-parametrar:
dfs.client.short.circuit.num = 5 (HDFS-klientoptimering)
hbase.lru.cache.heavy.eviction.count.limit = 30 — detta innebär att patchen kommer att börja fungera efter 30 vräkningar (cirka 5 minuter)
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 — det mål som ska cachas och vräkas
YCSB-loggarna har parsats och sammanställts i Excel-diagram:
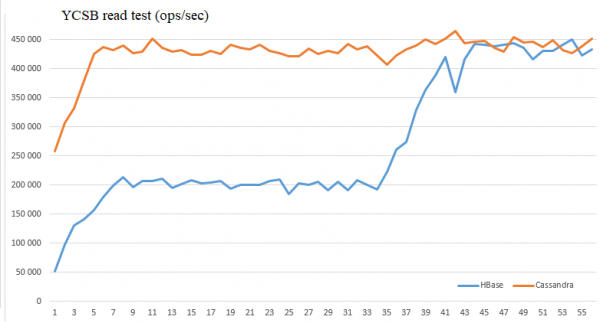
Som det framgår gör dessa optimeringsåtgärder att vi kan jämföra prestandan hos dessa databaser under dessa förhållanden och uppnå 450 000 läsningar per sekund.
Vi hoppas att denna information kan vara till nytta för någon i den spännande kampen om prestanda.
Källa: habr.com
