

Många är bekanta med databashanteringssystemet PostgreSQL, som har presterat utmärkt på mindre installationer. Men trenden mot att övergå till Open Source har blivit allt tydligare, även när det gäller stora företag och företagskrav. I denna artikel kommer vi att berätta hur man integrerar Postgres i en företagsmiljö och dela med oss av erfarenheterna från att skapa ett backup-system (BÄS) för denna databas, med hjälp av Commvaults backup-system som exempel.
PostgreSQL har redan bevisat sitt värde — databashanteringssystemet fungerar utmärkt, och det används av moderna digitala företag som Alibaba och TripAdvisor, medan avsaknaden av licensavgifter gör det till ett attraktivt alternativ till jättar som MS SQL eller Oracle DB. Men så snart vi börjar tänka på PostgreSQL i företagslandskapet stöter vi på strikta krav: "Hur står det till med konfigurationens hög tillgänglighet? Katastrofåterställning? Var är den omfattande övervakningen? Vad med automatiserade säkerhetskopior? Hur om användningen av bandbibliotek både direkt och som sekundär lagring?"
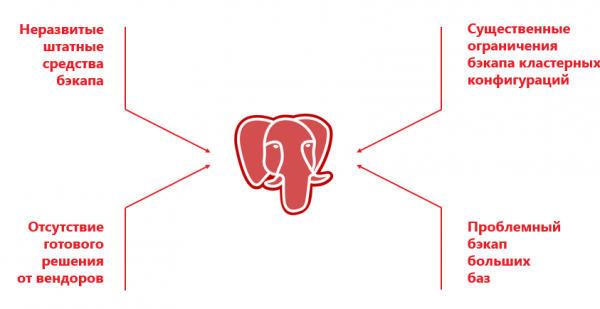
Å ena sidan har PostgreSQL inga inbyggda backup-funktioner, som "vuxna" databashanteringssystem som RMAN i Oracle DB eller SAP Database Backup. Å andra sidan stöder leverantörer av företagsbackup-system (Veeam, Veritas, Commvault) även PostgreSQL, men arbetar i praktiken endast med specifika (vanligtvis fristående) konfigurationer och med ett antal begränsningar.
Backup-system som är speciellt utvecklade för PostgreSQL, som Barman, Wal-g, pg_probackup, är extremt populära i små installationer av PostgreSQL eller där tunga säkerhetskopior av andra IT-element inte behövs. Till exempel kan det finnas både fysiska och virtuella system i infrastrukturen som PostgreSQL, OpenShift, Oracle, MariaDB, Cassandra, etc. Allt detta bör helst säkerhetskopieras med ett gemensamt verktyg. Att installera en separat lösning enbart för PostgreSQL är en dålig idé: data kommer att kopieras någonstans på en disk, och sedan måste de flyttas till band. Denna överlappning av säkerhetskopior ökar tiden för bakåtkopiering och, ännu viktigare, återställning. servrar, OpenShift, Oracle, MariaDB, Cassandra och så vidare. Det är önskvärt att säkerhetskopiera allt med ett gemensamt verktyg. Att sätta upp en separat lösning enbart för PostgreSQL är en dålig idé: data kommer att kopieras till en disk och sedan måste de flyttas till band. Denna dubbelkopiering av säkerhetskopieringen ökar tiden för säkerhetskopiering, och vad som är ännu viktigare — återställningen.
I företagslösningar sker säkerhetskopiering av installationen med ett visst antal noder i den dedikerade klustern. Till exempel kan Commvault bara fungera med en tvånodenkluster, där Primary och Secondary är strikt kopplade till specifika noder. Och det finns egentligen ingen mening med att backa upp från Secondary, eftersom det medför sina begränsningar. På grund av databashanteringssystemets egenskaper skapas ingen dump på Secondary, så det kvarstår endast en möjlighet för filbackup.
För att minska risken för driftstopp skapas en "levande" klusterkonfiguration för att bilda ett felfritt system, och Primary kan gradvis migrera mellan olika servrar. Till exempel startar programvaran Patroni själv Primary på en slumpmässigt vald nod i klustret. SRK har ingen möjlighet att spåra detta "utanför lådan", och om konfigurationen ändras, bryts processerna. Det vill säga att införandet av extern hantering hindrar SRK från att fungera effektivt, eftersom den styrande servern helt enkelt inte förstår varifrån och vilka data som ska kopieras.
En annan fråga är genomförandet av backup i Postgres. Det är möjligt via dump, och på små databaser fungerar det. Men i stora databaser tar dumpen lång tid, kräver många resurser och kan leda till att databasen kraschar.
Filbackup löser situationen, men på stora databaser är den långsam, eftersom den arbetar i en endast trådad läge. Dessutom får leverantörerna ett helt antal ytterligare begränsningar. Ibland kan man inte använda filbackup och dumpbackup samtidigt, ibland stöds inte deduplicering. Det uppstår många problem, och oftare är det enklare att istället för Postgres välja en dyrare, men beprövad databas.
Det finns ingen väg tillbaka! Bakom oss Moskva utvecklare!
Men nyligen ställdes vårt team inför en utmaning: i projektet för att skapa AIS OSAGO 2.0, där vi byggde IT-infrastrukturen, valde utvecklarna PostgreSQL för det nya systemet.
För stora programvaruutvecklare är det mycket enklare att använda "moderna" open-source-lösningar. Bland Facebooks anställda finns det tillräckligt med specialister som upprätthåller arbetet med detta databashanteringssystem. När det gäller RSA låg alla "andra dags"-uppgifter på våra axlar. Vi krävdes att säkerställa felfri funktion, samla klustret och självklart organisera säkerhetskopiering. Handlingslogiken var så här:
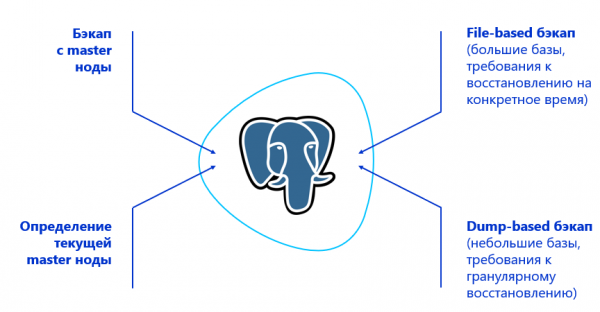
- Lära SRK att göra en backup med primärnoden i klustret. För detta måste SRK kunna hitta den — vilket betyder att integration med någon form av hanteringslösning för PostgreSQL-kluster behövs. I fallet med RCA användes programvaran Patroni för detta.
- Bestämma backup-typ baserat på datavolymer och återställningskrav. Till exempel, när det behövs granular återställning av sidor, använd dump, och om databaserna är stora och ingen granular återställning krävs — arbeta på filnivå.
- Lägga till möjlighet för blockbackup i lösningen, så att det går att skapa backup i flertrådad driftsätt.
Vi satte från början som mål att skapa ett effektivt och enkelt system utan en monsterbelastning av extra komponenter. Ju färre provisoriska lösningar, desto mindre belastning på personalen och lägre risk för att SRK går sönder. Metoder där Veeam och RMAN användes, uteslöt vi direkt, eftersom paketet med två lösningar redan antyder systemets otillförlitlighet.
Lite magi för företag
Så, vi behövde garantera pålitlig backup för 10 kluster med 3 noder vardera, samtidigt som en speglad infrastruktur finns i den reserv-DC. DC:n arbetar enligt principen aktiv-passiv när det gäller PostgreSQL. Den totala databaskapaciteten var 50 TB. Det här kan enkelt hanteras av vilken nivå företags-SRK som helst. Men problemet är att Postgres från början inte har en grund för full och djup kompatibilitet med backup-system. Därför var vi tvungna att leta efter en lösning som från början har maximalt med funktionalitet kopplad till PostgreSQL, och sedan utveckla systemet.
Vi genomförde 3 interna "hackathon" — granskade mer än femtio alternativ, testade dem, gjorde justeringar baserat på våra hypoteser, och kontrollerade dem igen. Efter att ha analyserat tillgängliga alternativ valde vi Commvault. Denna produkt kunde redan "ur lådan" arbeta med den enklaste klusterinstallation av PostgreSQL, och dess öppna arkitektur väckte hopp (som visade sig vara berättigat) om framgångsrik vidareutveckling och integration. Dessutom kan Commvault utföra backup av loggar för PostgreSQL. Till exempel kan Veritas NetBackup endast göra fullständiga backuper när det gäller PostgreSQL.
Mer information om arkitekturen. Commvaults styrservrar installerades i var och en av de två datacenter i en CommServ HA-konfiguration. Systemet är speglat, hanteras via en enda konsol och uppfyller alla företagskrav vad gäller HA.
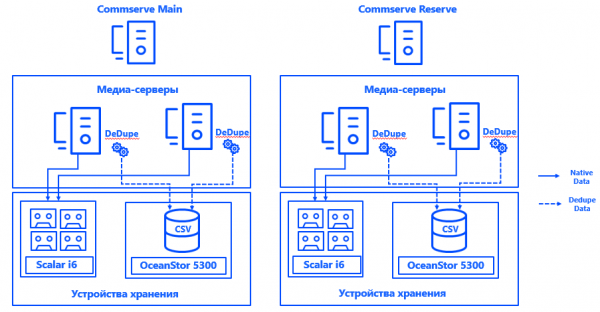
Vi har också startat två fysiska medieservrar i varje datacenter, som via SAN genom Fibre Channel är anslutna till diskarrayer och bandbibliotek som särskilt har tilldelats för backuper. Utsträckta dedupliceringsbaser säkerställde medieservrarnas redundans, och anslutningen av varje server till varje CSV ger möjlighet till kontinuerlig drift vid eventuell komponentfel. Systemarkitekturen tillåter fortsatt backup, även om ett datacenter faller.
Patroni bestämmer Primary-noden för varje kluster. Det kan vara vilken ledig nod som helst i datacentret — men endast i huvudklustret. I reservklustret är alla noder Secondary.
För att Commvault ska förstå vilken nod i klustret som är Primary, integrerade vi systemet (tack för den öppna arkitekturen) med Postgres. För detta skapades ett skript som rapporterar aktuell plats för Primary-noden till kontrollsystemet. servern Commvault.
Övergripande ser processen ut så här:
Patroni väljer Primary → Keepalived startar IP-klustret och kör skriptet → Commvault-agenten på den valda klusternoden får en avisering om att detta är Primary → Commvault justerar automatiskt backupen inom ramverket för pseudoklienten.
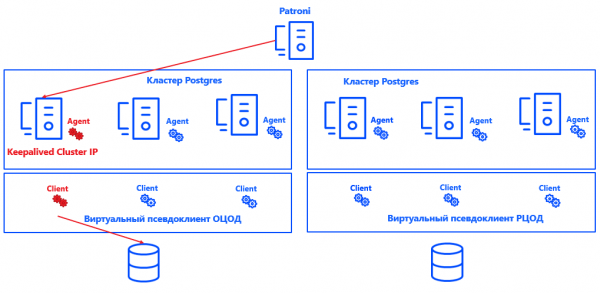
Fördelen med detta tillvägagångssätt är att lösningen inte påverkar varken konsistens, korrekthet av loggar eller återställning av Postgres-instansen. Den är också lätt att skala, eftersom det nu inte längre är nödvändigt att fastställa Primary och Secondary-noder för Commvault. Det räcker med att systemet förstår var Primary är, och antalet noder kan ökas praktiskt taget till vilket värde som helst.
Lösningen påstår sig inte vara perfekt och har sina nyanser. Commvault kan bara säkerhetskopiera hela instanser, inte enskilda databaser. Därför skapades en separat instans för varje databas. Riktiga kunder har sammanställts till virtuella pseudoklienter. Varje pseudoklient i Commvault representerar ett UNIX-kluster. Noderna i klustret som har Commvault-agenten för Postgres installerad läggs till. Som ett resultat säkerhetskopieras alla virtuella noder i pseudoklienten som en enda instans.
Inuti varje pseudokund anges en aktiv nod i klustret. Det är denna som vår integrationslösning för Commvault definierar. Principen bakom dess funktion är ganska enkel: om en kluster-IP aktiveras på noden, ställer skriptet in parameter "aktiv nod" i Commvault-agentens binärfil – i praktiken sätter skriptet "1" i rätt del av minnet. Agenten överför dessa uppgifter till CommServe, och Commvault gör en säkerhetskopiering från den nödvändiga noden. Dessutom kontrollerar skriptet konfigurationens korrekthet, vilket hjälper till att undvika fel vid start av säkerhetskopiering.
Stora databaser säkerhetskopieras dessutom blockvis i flera trådar, vilket uppfyller kraven för RPO och säkerhetskopieringsfönstret. Belastningen på systemet är obetydlig: Fullständiga kopior sker inte så ofta, under övriga dagar samlas endast loggar, och det görs under perioder med låg belastning.
För övrigt har vi tillämpat särskilda policys för säkerhetskopiering av arkivloggar i PostgreSQL – de lagras enligt andra regler, kopieras enligt ett annat schema och deduplicering aktiveras inte för dem, eftersom dessa loggar bär unik information.
För att säkerställa konsistensen i hela IT-infrastrukturen är separata filklienter för Commvault installerade på varje nod i klustret. De utesluter Postgres-filer från säkerhetskopiorna och är avsedda enbart för säkerhetskopiering av operativsystem och applikationer. För denna del av datan finns också en specifik policy och en egen förvaringsperiod.
Just nu påverkar SRK inte produktiva tjänster, men om situationen förändras kan man i Commvault aktivera en belastningsbegränsningssystem.
Bra? Bra!
Så, vi har fått en inte bara fungerande utan även helt automatiserad säkerhetskopiering för den klusterbaserade installationen av PostgreSQL, som uppfyller alla krav i enterprise-utmaningar.
Parametrarna RPO och RTO på 1 timme och 2 timmar är överträffade med marginal, vilket innebär att systemet kommer att uppfylla dem även vid en betydande ökning av lagringsvolymerna. Trots många tvivel visade sig PostgreSQL och en enterprise-miljö vara helt kompatibla. Och nu vet vi av egen erfarenhet att säkerhetskopiering för sådana databashanterare är möjlig i de mest varierande konfigurationerna.
Naturligtvis har vi på denna väg slitit ut sju par järnsandaler, övervunnit ett antal svårigheter, trampat på några vältor och rättat till ett antal misstag. Men nu har metoden testats och kan tillämpas för att införa Open Source istället för proprietära databashanteringssystem under tuffa företagsförhållanden.
Har du provat att arbeta med PostgreSQL i en företagsmiljö?
Författare:
Oleg Lavrenov, systemdesigner för datalagring på "Infosystem Jet"
Dmitry Yerykin, systemdesigner för datorkomplex på "Infosystem Jet"
Källa: habr.com
