

När den nyåriga oliven var slut, fanns det inget mer att göra, så jag bestämde mig för att ladda ner alla artiklar från Habrakhabr (och relaterade plattformar) till min dator och undersöka dem.
Det resulterade i flera intressanta berättelser. Den första av dem handlar om utvecklingen av formatet och ämnena i artiklarna under 12 år av webbplatsens existens. Till exempel är dynamiken hos vissa teman ganska talande. Fortsättning följer nedan.
Parse-processen
För att förstå hur Habr har utvecklats var jag tvungen att gå igenom alla artiklar och extrahera meta-information (till exempel datum). Att göra det gick lätt, eftersom länkarna till alla artiklar ser ut som "habrahabr.ru/post/337722/", och numren är strikt i ordning. Med vetskapen om att det senaste inlägget har ett nummer lite under 350 000, gick jag bara igenom alla möjliga dokument-id med en loop (kod i Python):
import numpy as np
from multiprocessing import Pool
with Pool(100) as p:
    docs = p.map(download_document, np.arange(350000))
Funktionen download_document försöker ladda sidan med motsvarande id och försöker hämta innehållsinformation från html-strukturen.
import requests
from bs4 import BeautifulSoup

def download_document(pid):
    """ Ladda ner och bearbeta ett Habr-dokument och dess kommentarer """
    # hämta dokumentet
    r = requests.get('https://habrahabr.ru/post/' + str(pid) + '/')
    # analysera dokumentet
    soup = BeautifulSoup(r.text, 'html5lib') # istället för html.parser
    doc = {}
    doc['id'] = pid
    if not soup.find("span", {"class": "post__title-text"}):
        # så kan hända om artikeln inte existerade eller togs bort
        doc['status'] = 'title_not_found'
    else:
        doc['status'] = 'ok'
        doc['title'] = soup.find("span", {"class": "post__title-text"}).text
        doc['text'] = soup.find("div", {"class": "post__text"}).text
        doc['time'] = soup.find("span", {"class": "post__time"}).text
        # skapa andra fält: hubbar, taggar, visningar, kommentarer, röster, etc.
        # ...
    # spara resultatet i en separat fil
    fname = r'files/' + str(pid) + '.pkl'
    with open(fname, 'wb') as f:
        pickle.dump(doc, f)
Under parse-processen upptäckte jag flera nya saker.
För det första säger man att det är meningslöst att skapa fler processer än kärnor i processorn. Men i mitt fall visade det sig att den begränsande resursen är inte processorn utan nätverket, och 100 processer arbetar snabbare än 4 eller, säg, 20.
För det andra, i vissa inlägg fanns det kombinationer av specialtecken — till exempel eufemismer som "%&#@". Det visade sig att html.parser, som jag använde först, reagerar på kombinationen &# smärtsamt och anser att det är början på en html-enhet. Jag tänkte redan på att göra svart magi, men på forumet föreslogs det att man bara kunde byta parser.
För det tredje lyckades jag överföra alla publikationer, utom tre. Dokumenten med nummer 65927, 162075 och 275987 raderades omedelbart av min antivirusprogram. Dessa artiklar handlar om en JavaScript-kedja som laddar en skadlig pdf, en SMS-uttömningsattack i form av ett plugin-set för webbläsare och sidan CrashSafari.com, som får iPhones att starta om. En annan artikel upptäckte antivirusprogrammet senare, under systemscanning: inlägg 338586 om skript på en djuraffärs hemsida som utnyttjar användarens processor för kryptovaluta-mining. Så man kan anse att antivirusets arbete varit fullt tillfredsställande.
"Levande" artiklar utgjorde bara hälften av den potentiella maxkapaciteten — 166307 stycken. För de andra ger Habr alternativ som "sidan är föråldrad, har tagits bort eller existerade inte överhuvudtaget". Nåväl, sånt händer.
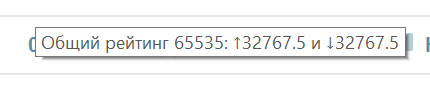
Efter överföringen av artiklarna följde tekniskt arbete: exempelvis behövde publiceringsdatum konverteras från formatet "21 december 2006 10:47" till standardformat, datetime, och "12,8k" visningar behövde omvandlas till 12800. Vid detta steg dök det upp några fler knasigheter. Den roligaste var kopplad till röstberäkningen och datatyper: i vissa gamla inlägg inträffade ett heltalsöverflöd och de fick 65535 röster.
Som ett resultat tog texterna till artiklarna (utan bilder) 1,5 gigabyte, och kommentarer med meta-information tog ytterligare 3, och cirka hundra megabyte gick till meta-information om artiklarna. Sådant kan hållas helt i RAM, vilket var en trevlig överraskning för mig.
Jag började analysera artiklarna, inte med texterna själva, utan med metadata: datum, taggar, hubbar, visningar och "gilla". Det visade sig att även detta kunde berätta mycket.
Trender för utvecklingen av Habr
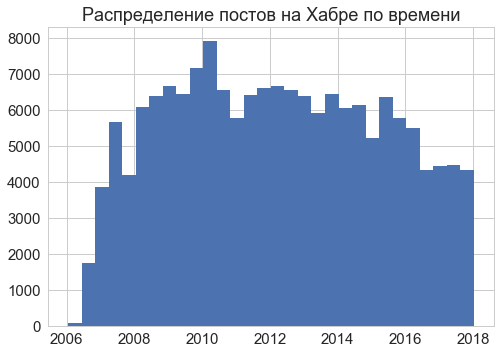
Artiklar publiceras på webbplatsen sedan 2006; mest intensivt mellan 2008 och 2016.
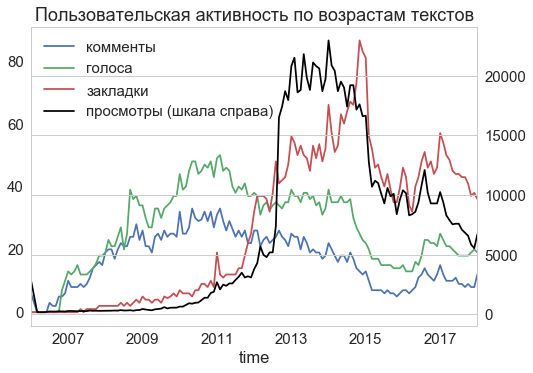
Att bedöma hur aktivt dessa artiklar lästes vid olika tidpunkter är inte så enkelt. Texter från 2012 och yngre kommenterades och rankades mer aktivt, men nyare texter har fler visningar och sparningar. Dessa mätvärden uppvisade liknande beteende (de föll med hälften) endast en gång, 2015. Kanske i en situation med ekonomisk och politisk kris skiftade läsarnas uppmärksamhet från IT-bloggar till mer brännande frågor.
Förutom artiklarna har jag även hämtat kommentarerna till dem. Det blev 6 miljoner kommentarer, men 240 000 av dem visade sig vara blockerade ("ett UFO har landat och publicerat detta meddelande här"). En nyttig egenskap hos kommentarerna är att tiden anges. Genom att studera tidpunkten för kommentarerna kan man få en ungefärlig förståelse för när artiklarna läses överhuvudtaget.
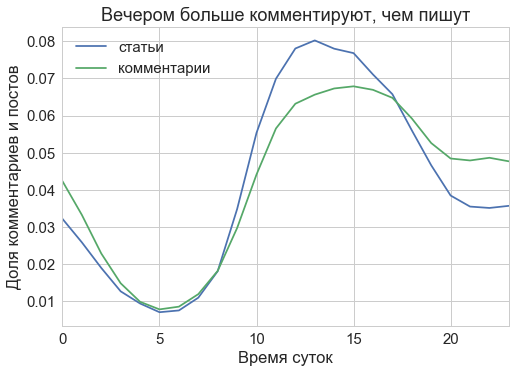
Det visade sig att den största delen av artiklarna skrivs och kommenteras mellan klockan 10 och 20, det vill säga under en typisk arbetsdag i Moskva. Det kan betyda att Habr läses i professionella syften, och att det är ett bra sätt att procrastinera på jobbet. Förresten har denna tidsfördelning varit stabil sedan Habr grundades fram till idag.
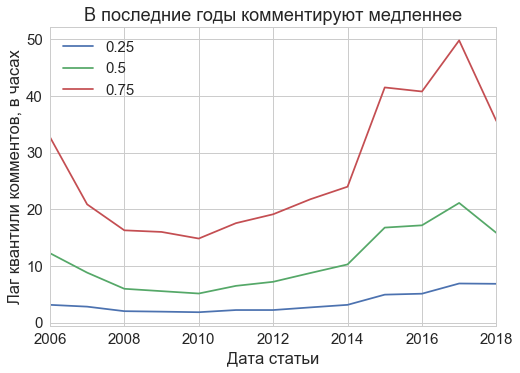
Men den största nyttan med tidstämpeln för kommentarer är inte tidpunkten på dagen, utan den "aktiva livslängden" för artikeln. Jag räknade ut hur tiden fördelas från publiceringen av artikeln till dess kommentar. Det visade sig att den nuvarande median-kommentaren (den gröna linjen) kommer ungefär 20 timmar senare, det vill säga inom de första 24 timmarna efter publicering lämnar man i genomsnitt lite mer än hälften av alla kommentarer till artikeln. Efter två dagar lämnas 75% av alla kommentarer. Tidigare lästes artiklarna ännu snabbare — så, år 2010 kom hälften av kommentarerna redan inom de första 6 timmarna.
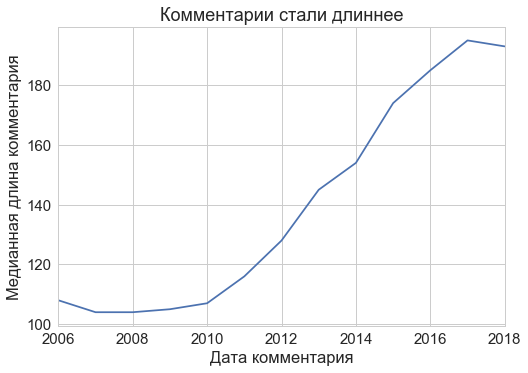
Det blev en överraskning för mig att kommentarerna har blivit längre: det genomsnittliga antalet tecken i kommentarerna har under Habrs existens nästan fördubblats!
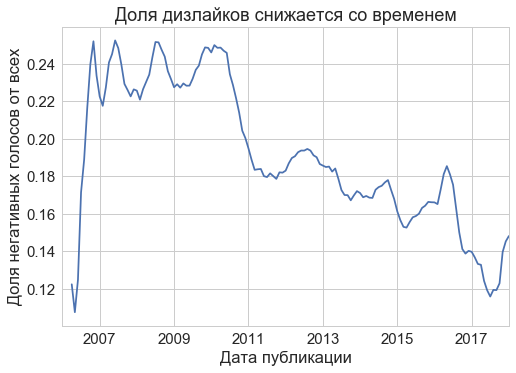
Ett enklare sätt att ge tillbaka än kommentarer är röster. Till skillnad från många andra resurser kan man på Habr ge både plus och minus. Emellertid används den senaste möjliga möjligheten inte så ofta: den nuvarande andelen nedröster utgör cirka 15% av alla avgivna röster. Tidigare var det mer, men över tid har läsarna blivit snällare.
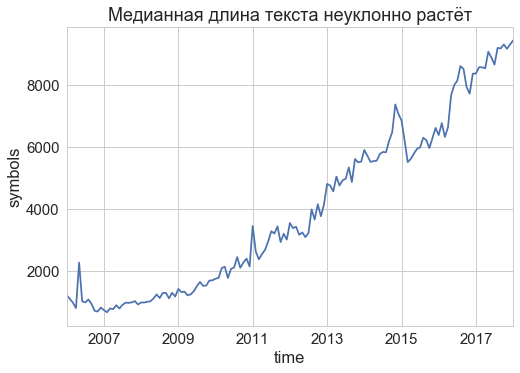
Även texterna har förändrats över tid. Till exempel fortsätter den typiska längden på texterna att stadigt öka sedan webbplatsens lansering, trots kriser. På ett decennium har texterna blivit nästan tio gånger längre!
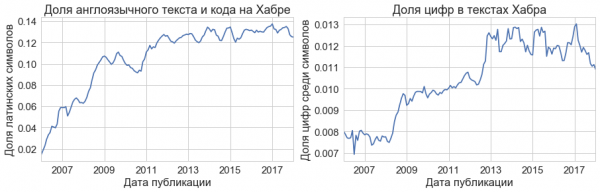
Stilen på texterna (i första hand) har också förändrats. Under de första åren av Habrs existens har till exempel andelen kod och siffror i texterna ökat:
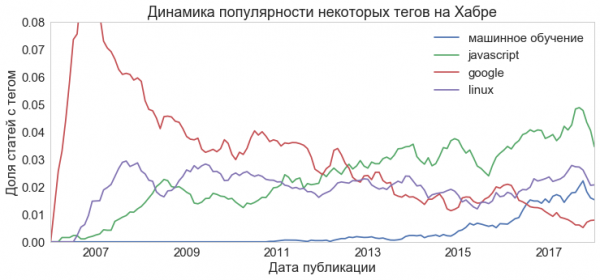
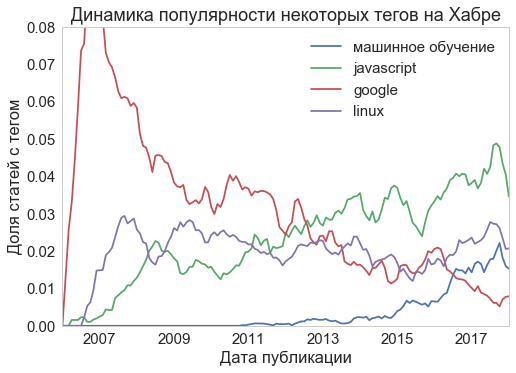
Efter att ha förstått den allmänna dynamiken på webbplatsen ville jag mäta hur populariteten för olika ämnen har förändrats. Ämnen kan automatiskt identifieras från texterna, men för att börja kan man enkelt använda de färdiga taggarna som författarna till varje artikel har tilldelat. Jag har sammanfattat fyra typiska trender i en graf. Ämnet "Google" dominerade initialt (möjligtvis i stor utsträckning på grund av SEO-optimering), men förlorade gradvis i vikt varje år. Javascript var en populär ämne och fortsätter att öka sakta, medan maskininlärning började få fart först de senaste åren. Linux förblir lika relevant under hela decenniet.
Naturligtvis blev jag nyfiken på vilka ämnen som attraherar mest läsaraktivitet. Jag räknade det mediala antalet visningar, betyg och kommentarer för varje ämne. Här är resultatet:
- De mest betraktade ämnena: arduino, webbdesign, webbutveckling, sammanställning, länkar, css, html, html5, nginx, algoritmer.
- De mest "gillade" ämnena: vkontakte, humor, jquery, opera, c, html, webbutveckling, html5, css, webbdesign.
- De mest diskuterade ämnena: opera, skype, frilans, vkontakte, ubuntu, arbete, nokia, nginx, arduino, firefox.
Förresten, eftersom jag jämför ämnen, kan vi göra en ranking baserat på frekvens (och jämföra resultaten med ).
- Under alla år av existensen av Habra har de mest populära taggarna (i fallande ordning) blivit google, android, javascript, microsoft, linux, php, apple, java, python, programmering, startups, utveckling, ios, startup, sociala nätverk.
- År 2017 var de mest populära javascript, python, java, android, utveckling, linux, c++, programmering, php, c#, ios, maskininlärning, informationssäkerhet, microsoft, react.
När man jämför dessa rankingar kan man till exempel uppmärksamma den segerrika gången för Python och nedgången för php, eller "solnedgången" för startup-temat och uppgången för maskininlärning.
Inte alla taggar på Habr har en så uppenbar tematisk koppling. Här är till exempel ett dussin taggar som bara förekommit en gång, men som jag tyckte var roliga. Så: "idén driver framsteg", "ladda från bild av diskett", "delstat Iowa", "dramaturgi", "superaljesa", "ångmaskin", "vad göra på lördagen", "jag har en räv i köttkvarnen", "och det blev som vanligt", "det gick inte att komma på några roliga taggar". För att bestämma temat för sådana artiklar är taggar inte tillräckliga — vi måste göra tematisk modellering av artikeltexterna.
En mer detaljerad analys av artikelinnehållet kommer i nästa inlägg. För det första planerar jag att bygga en modell som förutspår antalet visningar av en artikel beroende på dess innehåll. För det andra vill jag lära en neuronnät att generera texter i samma stil som författarna på Habr. Så prenumerera gärna 🙂
P.S. Här är den censurerade .
Källa: habr.com
