

Bakgrund
Som retrohobbyist köpte jag en gång en ZX Spectrum+ från en säljare i Storbritannien. Tillsammans med datorn fick jag några ljudkassetter med spel (i originalförpackningen med instruktioner), samt program som var inspelade på kassetter utan några särskilda märkningar. Till min förvåning lästes datan från kassetterna som var 40 år gamla väl, och jag lyckades ladda nästan alla spel och program från dem.
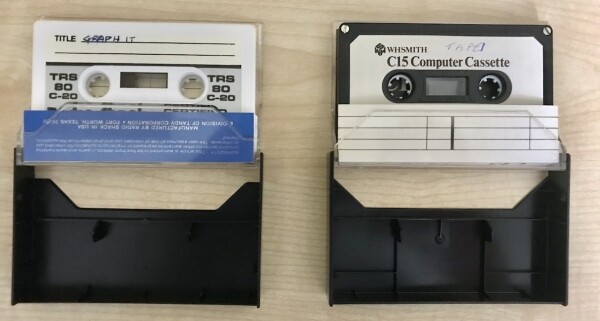
Men på vissa kassetter upptäckte jag inspelningar som uppenbarligen inte var gjorda av ZX Spectrum-datorn. De lät helt annorlunda och, till skillnad från inspelningarna från den nämnda datorn, började de inte med en kort BASIC-laddare som vanligtvis finns i inspelningar av alla program och spel.
En tid gav detta mig ingen ro — jag ville verkligen veta vad som döljer sig i dem. Om jag kunde läsa ljudsignalen som en sekvens av bytes skulle jag kunna leta efter tecken eller något som indikerar signalens ursprung. En form av retro-arkeologi.
Nu, när jag har gått igenom hela processen och ser på etiketterna på kassetterna, ler jag eftersom
svaret har varit framför ögonen hela tiden
På etiketten av den vänstra kassetten står namnet på datorn TRS-80, och strax under står tillverkarens namn: 'Manufactured by Radio Shack in USA.'
(Om du vill bevara spänningen till slutet, gå inte in under spoilern)
Jämförelse av ljudsignaler
Först digitaliserar vi ljudinspelningarna. Här kan du höra hur det låter:
Och så här låter inspelningen från ZX Spectrum:
I båda fallen finns det i början av inspelningen så kallad pilotton — ljud av en enda frekvens (på den första inspelningen är den mycket kort <1 sek, men ändå hörbar). Pilottonen fungerar som en signal till datorn att förbereda sig för att ta emot data. Som regel känner varje dator igen endast sin egen pilotton baserat på signalens form och dess frekvens.
Det bör nämnas något om själva signalformen. Till exempel är dess form rektangulär på ZX Spectrum:
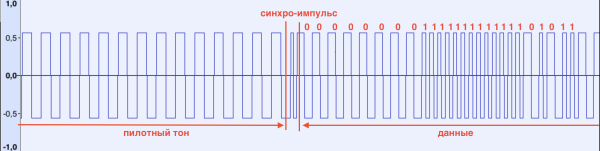
När pilottonen detekteras visar ZX Spectrum växlande röd-blå ränder i den kantiga delen av skärmen, vilket visar att signalen har identifierats. Pilottonen avslutas med en synkroniseringsimpuls, som signalerar till datorn att börja ta emot data. Den kännetecknas av en kortare (jämfört med pilottonen och efterföljande data) varaktighet (se bild)
När synkronimpulsen har mottagits registrerar datorn varje upp- och nedgång av signalen och mäter dess varaktighet. Om varaktigheten är mindre än en viss gräns registreras bit 1 i minnet, annars 0. Bitar samlas i byte och processen upprepas tills N byte har mottagits. Talet N tas vanligen från rubriken av den nedladdade filen. Sekvensen för nedladdningen är följande:
- pilotton
- rubrik (fast längd), innehåller storleken på de nedladdade data (N), filnamn och typ
- pilotton
- själva datan
För att säkerställa att datan har laddats korrekt läser ZX Spectrum den sista byten av det så kallade paritetsbyte (parity byte), som beräknas vid filens lagring genom XOR-operation över alla byte av de skrivna data. Vid läsning av filen beräknar datorn paritetsbyten av de mottagna data, och om resultatet skiljer sig från den lagrade, visas ett felmeddelande "R Tape loading error". Strikt taget kan datorn ge detta meddelande tidigare om den inte kan känna igen impulsen vid läsning (om den saknas eller dess varaktighet inte överensstämmer med vissa gränser)
Låt oss nu titta på hur en okänd signal ser ut:
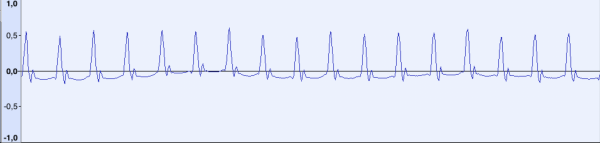
Detta är pilottonen. Signalens form skiljer sig avsevärt, men det är tydligt att signalen består av upprepade korta impulser med en viss frekvens. Vid en samplingsfrekvens av 44100 Hz är avståndet mellan "topparna" cirka 48 prover (vilket motsvarar en frekvens på ~918 Hz). Kom ihåg detta tal.
Låt oss nu titta på ett fragment med data:
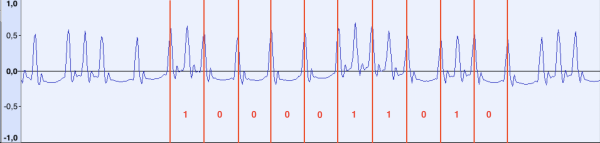
Om vi mäter avståndet mellan de enskilda impulserna visar det sig att avståndet mellan "långa" impulser fortfarande är ~48 prover, medan avståndet mellan korta är ~24. Lite framåtblickande kan jag säga att det med tiden visade sig att "referens" impulser på frekvensen 918 Hz följer kontinuerligt, från början till slut av filen. Man kan anta att vid dataöverföring, om en extra impuls mellan referensimpulserna möts, räknas det som bit 1, annars 0.
Vad händer med synkronimpulsen? Låt oss titta på början av datan:
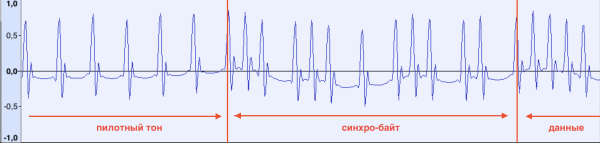
Pilottonen slutar och data börjar omedelbart. Lite senare, efter att ha analyserat flera olika ljudinspelningar, upptäckte vi att den första databit alltid är densamma (10100101b, A5h). Kanske börjar datorn att läsa data efter att den har fått den.
Man kan också uppmärksamma förskjutningen av den första referensimpulsen strax efter den sista 1:an i synkronbyte. Denna lyckades vi upptäcka betydligt senare under utvecklingen av programmet för datakännedom, när data i början av filen inte gick att läsa stabilt.
Nu ska vi försöka beskriva algoritmen som kommer att bearbeta ljudfilen och ladda data.
Dataimport
Först ska vi överväga några antaganden för att inte komplicera algoritmen:
- Vi kommer att betrakta filer endast i WAV-format;
- Ljudfilen måste börja med pilottonen och får inte innehålla tystnad i början.
- Den ursprungliga filen måste ha en samplingsfrekvens på 44100 Hz. I så fall är avståndet mellan referensimpulserna i 48 prover redan fastställt och vi behöver inte beräkna det programmässigt;
- Formatet på proverna kan vara vilket som helst (8\/16 bitar\/flyttal) – eftersom vi kan konvertera det till det nödvändiga vid läsning;
- Vi antar att den ursprungliga filen är normaliserad efter amplitud, vilket ska stabilisera resultatet;
Uppläsningsalgoritmen blir följande:
- Vi läser filen i minnet och konverterar samtidigt formatet på proverna till 8 bitar;
- Vi bestämmer positionen för den första impulsen i ljuddata. För detta behöver vi beräkna numret på provet med maximal amplitud. För enkelhetens skull räknar vi det en gång manuellt. Vi sparar det i variabeln prev_pos;
- Vi lägger till 48 till positionen för den senaste impulsen (pos := prev_pos + 48)
- Eftersom en ökning av positionen med 48 inte garanterar att vi kommer att nå nästa referensimpuls (banddefekter, instabil drift av bandtransportmekanismen och annat) måste vi justera positionen för impulsen pos. För detta tar vi ett litet datautdrag (pos-8;pos+8) och hittar maximum av amplituden i detta område. Positionen som motsvarar maximumet sparar vi i pos. Här är 8 = 48/6 - en experimentellt fastställd konstant som garanterar att vi identifierar rätt maximum och inte påverkar andra impulser som kan ligga nära. I de mycket dåliga fallen, där avståndet mellan impulserna är betydligt mindre eller större än 48, kan man genomföra en tvingad sökning av impulsen, men jag kommer inte att beskriva detta i algoritmen;
- I det föregående steget är det också nödvändigt att kontrollera att referensimpulsen faktiskt har hittats. Det vill säga, om man bara söker maximum garanterar det inte att impulsen är närvarande i detta segment. I min senaste version av läsprogrammet kontrollerar jag skillnaden mellan det maximala och minimala amplitudvärdet i segmentet, och om den överskrider en viss gräns, räknar jag med att impulsen är närvarande. Frågan är också vad man ska göra om referensimpulsen inte hittas. Här finns det två alternativ: antingen har datan tagit slut och det följer tystnad, eller så bör detta betraktas som ett läsningsfel. Men vi skippar detta för att förenkla algoritmen;
- I nästa steg måste vi bestämma närvaron av datapuls (bit 0 eller 1), för detta tar vi mitten av segmentet (prev_pos;pos) middle_pos som är lika med middle_pos := (prev_pos+pos)/2 och i en viss omgivning av middle_pos inom segmentet (middle_pos-8;middle_pos+8) räknar vi maximum och minimum av amplituden. Om skillnaden mellan dem är större än 10, skriver vi bit 1 i resultatet, annars bit 0. 10 - en konstant fastställd genom erfarenhet;
- Spara den aktuella positionen i prev_pos (prev_pos := pos)
- Upprepa från steg 3 tills hela filen har lästs;
- Den mottagna bitarrayn bör sparas som en uppsättning byte. Eftersom vi inte beaktade synkrobytet vid läsningen kan antalet bitar visa sig vara ojämt med 8, och även det nödvändiga bitförskjutningen är okänt. I den första implementationen av algoritmen visste jag inte om synkrobytet och sparade därför bara 8 filer med olika bitförskjutningar. En av dem innehöll korrekta data. I den slutgiltiga algoritmen tar jag helt enkelt bort alla bitar fram till A5h, vilket gör att jag direkt får en korrekt fil i utgången.
Algoritmen i Ruby, för den som är intresserad.
Som programmeringsspråk valde jag Ruby, eftersom jag programmerar mestadels i det. Lösningen är inte högpresterande, men uppgiften att göra läshastigheten så snabb som möjligt är inte prioriterad.
# Используем gem 'wavefile'
require 'wavefile'

reader = WaveFile::Reader.new('input.wav')
samples = []
format = WaveFile::Format.new(:mono, :pcm_8, 44100)

# Читаем WAV файл, конвертируем в формат Mono, 8 bit
# Массив samples будет состоять из байт со значениями 0-255
reader.each_buffer(10000) do |buffer|
  samples += buffer.convert(format).samples
end

# Позиция первого импульса (вместо 0)
prev_pos = 0
# Расстояние между импульсами
distance = 48
# Значение расстояния для окрестности поиска локального максимума
delta = (distance / 6).floor
# Биты будем сохранять в виде строки из "0" и "1"
bits = ""

loop do
  # Рассчитываем позицию следующего импульса
  pos = prev_pos + distance

  # Выходим из цикла если данные закончились
  break if pos + delta >= samples.size

  # Корректируем позицию pos обнаружением максимума на отрезке [pos - delta;pos + delta]
  (pos - delta..pos + delta).each { |p| pos = p if samples[p] > samples[pos] }

  # Находим середину отрезка [prev_pos;pos]
  middle_pos = ((prev_pos + pos) / 2).floor

  # Берем окрестность в середине
  sample = samples[middle_pos - delta..middle_pos + delta]

  # Определяем бит как "1" если разница между максимальным и минимальным значением на отрезке превышает 10
  bit = sample.max - sample.min > 10
  bits += bit ? "1" : "0"
end

# Определяем синхро-байт и заменяем все предшествующие биты на 256 бит нулей (согласно спецификации формата)
bits.gsub! /^[01]*?10100101/, ("0" * 256) + "10100101"

# Сохраняем выходной файл, упаковывая биты в байты
File.write "output.cas", [bits].pack("B*")
Resultat
Efter att ha testat flera varianter av algoritmen och konstanter hade jag turen att få fram något ytterst intressant:
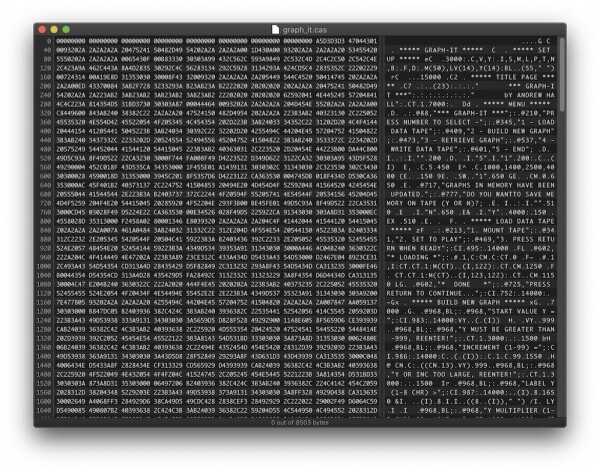
Så, baserat på teckensträngarna har vi ett program för att bygga diagram. Emellertid saknas nyckelord i programtexten. Alla nyckelord är kodade som byte (där värdet överstiger 80h). Nu måste vi ta reda på vilken dator från 80-talet som kunde spara program i ett sådant format.
Faktum är att detta liknar ett program skrivet i BASIC. På ungefär samma sätt lagrar datorn ZX Spectrum program i minnet och sparar dem på kassett. Jag kontrollerade även nyckelorden mot Resultatet var dock uppenbarligen negativt.
Jag kontrollerade även nyckelorden i BASIC för populära datorer från den tiden som Atari, Commodore 64 och flera andra för vilka jag kunde hitta dokumentation, men utan framgång – mina kunskaper om retro-datorer var inte så omfattande.
Då bestämde jag mig för att gå efter , och här föll min blick på tillverkarens namn Radio Shack och datorn TRS-80. Just dessa namn var skrivna på etiketterna på kassettarna som låg på mitt skrivbord! Jag visste inte tidigare dessa namn och var inte bekant med datorn TRS-80, därför trodde jag att Radio Shack var en tillverkare av ljudkassetter, liknande BASF, Sony eller TDK, och TRS-80 – längden på uppspelningen. Varför inte?
Datorn Tandy/Radio Shack TRS-80
Det är mycket troligt att den ljudinspelning som jag gav som exempel i början av artikeln är gjord på en sådan dator:
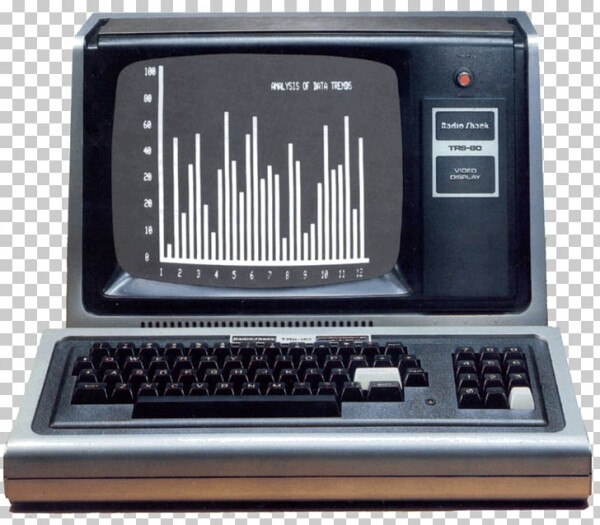
Det visade sig att denna dator och dess varianter (Model I/Model III/Model IV osv.) var mycket populära under sin tid (naturligtvis inte i Ryssland). Det är anmärkningsvärt att processorn som användes i dem också var Z80. Det går att hitta . På 80-talet spreds information om datorn i . För närvarande finns det flera av datorn för olika plattformar.
Jag laddade ner emulatorn och fick för första gången titta på hur denna dator arbetade. Naturligtvis stödde datorn inte färgutgång, skärmupplösningen var bara 128x48 punkter, men det fanns många tillägg och modifieringar som kunde öka skärmupplösningen. Det fanns också många olika operativsystem för denna dator och varianter av implementeringen av BASIC-språket (vilket, till skillnad från ZX Spectrum, i vissa modeller inte ens var "inbakat" i ROM och vilken version som helst kunde laddas från disketten, precis som själva OS)
Jag hittade också ett verktyg för att konvertera ljudinspelningar till CAS-format, vilket stöds av emulatorerna, men av någon anledning kunde jag inte läsa inspelningarna från mina kassettband med hjälp av dem.
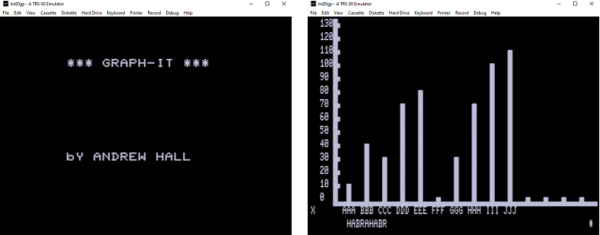
Efter att ha förstått CAS-filformatet (som visade sig vara en bit-för-bit-kopia av datan från bandet som jag redan hade, förutom att det fanns en rubrik med en synkroniseringsbyte) gjorde jag några ändringar i mitt program och kunde få ut en fungerande CAS-fil, som fungerade i emulatorn (TRS-80 Model III):
Den senaste versionen av verktyget för konvertering med automatisk upptäckte av första impulsen och avståndet mellan referensimpulserna har jag gjort i form av ett GEM-paket, källkoden är tillgänglig på .
Slutsats
Den resa jag har gjort har varit en fascinerande resa tillbaka i tiden, och jag är glad att jag till slut hittade lösningen. Förutom det har jag:
- Förstått hur data sparas i ZX Spectrum och studerat de inbyggda underprogrammen i ROM för att spara/läsa data från ljudkassetter
- Bekantat mig med datorn TRS-80 och dess varianter, studerat operativsystemet, sett exempel på program och haft möjlighet att syssla med avlusning i maskinkod (alla mnemonics för Z80 är mig välbekanta)
- Jag har skrivit ett fullständigt verktyg för att konvertera ljudinspelningar till CAS-format, som kan läsa data som den "officiella" verktyget inte känner igen.
Källa: habr.com
