

Man säger att man bör prova allt minst en gång i livet. Och om du är van vid att arbeta med relationsdatabaser är det värt att bekanta sig med NoSQL i praktiken, åtminstone för din allmänna utveckling. Just nu, på grund av den snabba utvecklingen av denna teknik, finns det många motstridiga åsikter och heta debatter om ämnet, vilket särskilt väcker intresse.
Om man går till botten med dessa diskussioner kan man se att de uppstår på grund av felaktiga angreppssätt. De som använder NoSQL-databaser där de verkligen behövs är nöjda och får alla fördelar av lösningen. De som experimenterar och hoppas på teknologin som en universal lösning där den överhuvudtaget inte är tillämplig, känner besvikelse och förlorar styrkorna hos relationsdatabaser utan att få några betydande vinster.
Jag ska berätta om vår erfarenhet av att implementera en lösning baserad på databasen Cassandra: vad vi ställdes inför, hur vi lyckades lösa svåra situationer, om vi lyckades få vinster från att använda NoSQL och var vi behövde investera ytterligare ansträngningar/medel.
Den ursprungliga uppgiften var att bygga ett system för att registrera samtal i ett visst lagringsutrymme.
Systemets princip är följande. In data kommer filer med en viss struktur som beskriver samtalets struktur. Därefter ser programmet till att denna struktur sparas i motsvarande kolumner. De sparade samtalen används senare för att visa information om trafikförbrukning för abonnenter (debiteringar, samtal, saldohistorik).
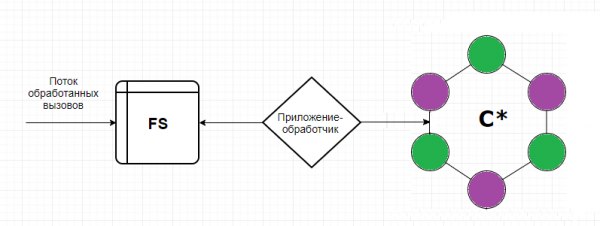
Varför vi valde Cassandra är ganska tydligt – den skriver som en kulspruta, är lätt att skala och är motståndskraftig mot fel.
Så här har vår erfarenhet givit oss.
Ja, en störd nod är inte en tragedi. Det är just poängen med Cassandras motståndskraft. Men en nod kan vara aktiv och samtidigt börja få prestandaproblem.. Det visade sig att detta omedelbart påverkar hela klustrets prestanda.
Cassandra skyddar inte i de situationerna där Oracle räddade med sina begränsningar.. Och om applikationens författare inte förstod detta i förväg, så är en duplikatpost för Cassandra inte ett dugg sämre än originalet. Kommit in, så låt oss sätta in.
Den kostnadsfria Cassandra "ur lådan" uppskattades inte av säkerhetsavdelningen: det finns ingen loggning av användaråtgärder, inte heller rättighetsindelning.. Information about calls relates to personal data, meaning that all attempts to request/change it in any way must be logged with the possibility of subsequent audits. It is also necessary to understand the need to separate rights at different levels for different users. A simple operations engineer and a superadmin, who can freely delete the entire keyspace, are different roles, with different responsibilities and competencies. Without such access rights segregation, the value and integrity of the data will quickly come into question, faster than with an ANY consistency level.
We did not consider that call data requires both serious analytics and periodic samples under various conditions. Since the selected records are expected to be deleted and overwritten later (as part of the task, we need to support the data update process for initially incorrectly received data), Cassandra is not our friend here. Cassandra, as a piggy bank – it's convenient to store things, but you can't really count on it.
Encountered a problem transferring data to test zones. (5 nodes in test compared to 20 in production). In this case, a dump cannot be used.
The problem of updating the application’s data schema that writes to Cassandra. Rolling back will create a great many tombstones, which may unpredictably degrade performance.. Cassandra is optimized for writes, and before writing, it doesn’t think much. Any operation with existing data is also a write. That is, by deleting the unnecessary, we just create even more records, only some of which will be marked as tombstones.
Timeouts when inserting. Cassandra is great at writing, but sometimes the incoming stream can significantly puzzle it.. This happens when the application starts looping through several records that cannot be inserted for some reason. And we will need a real DBA who will monitor gc.log, system, and debug logs for slow queries, and metrics on compaction pending.
Several data centers in the cluster. Where to read from and where to write to?
Är det möjligt att separera läsning och skrivning? Och i så fall, ska den datacenter som hanterar skrivning eller läsning vara närmare till applikationen? Kommer vi att drabbas av riktig split brain om vi väljer fel nivå av konsistens? Det finns många frågor och många outforskade inställningar och möjligheter som vi verkligen vill utforska.
Hur vi löste det
För att noderna inte ska påverkas negativt har vi stängt av SWAP. Och nu, vid brist på minne, bör noden gå ner istället för att skapa långa gc-pauser.
Så vi litar inte längre på logiken i databasen. Applikationsutvecklarna lär om sig och börjar aktivt skydda sig i sin egen kod. En perfekt och tydlig uppdelning mellan lagring och databehandling.
Vi köpte support från DataStax. Den förpackade Cassandra utvecklas inte längre (senaste commit i februari 2018). Samtidigt erbjuder Datastax en utmärkt tjänst och ett stort antal förbättrade och anpassade lösningar för befintliga informationssystem.
Jag vill också nämna att Cassandra inte är särskilt bekväm för urvalsförfrågningar. Självklart är CQL ett stort steg mot användarna (jämfört med Thrift). Men om ni har hela avdelningar som är vana vid sådana bekväma joins, fri filtrering på valfritt fält och optimeringsmöjligheter för frågorna, så verkar en lösning baserad på Cassandra både fientlig och dum för dem. Och vi började fundera på hur våra kollegor kan göra urval.
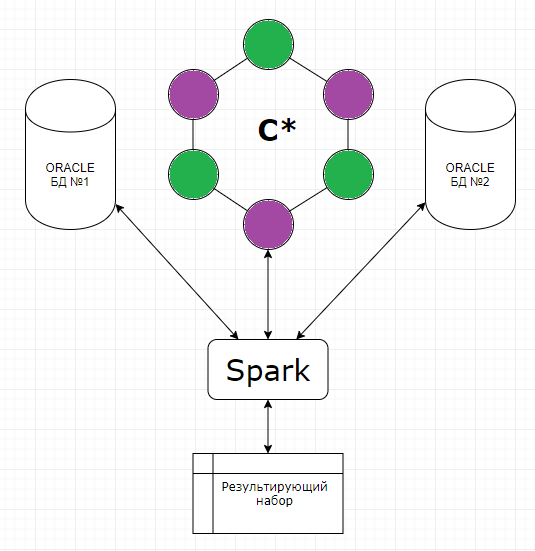
Vi övervägde två alternativ. I det första alternativet skriver vi anrop inte bara till C*, utan också till den arkiverade Oracle-databasen. Men till skillnad från C* lagras endast anrop för den aktuella månaden i denna databas (tillräcklig lagringsdjup för omprövningsfall). Här såg vi genast ett problem: om vi skriver synkront förlorar vi alla fördelar med C* kopplade till snabb insättning, om asynkront – finns det ingen garanti för att alla nödvändiga anrop faktiskt kommer in i Oracle. En fördel fanns, men den var stor: för drift behöver vi fortsätta använda det vanliga PL/SQL Developer, det vill säga vi kan i praktiken implementera mönstret "Fasad". Alternativt alternativ. Vi implementerar en mekanism som exporterar anrop från C*, hämtar data för berikning från motsvarande tabeller i Oracle, sammanfogar de erhållna urvalen och ger oss det resulterande resultatet, som vi sedan på något sätt använder (återkallar, repetera, analyserar, beundrar). Nackdelar: processen blir ganska flerstegad, och dessutom finns det inget gränssnitt för driftpersonalen.
Till slut bestämde vi oss ändå för det andra alternativet. För urval från olika databaser använde vi Apache Spark. Essensen av mekanismen reducerades till Java-kod som hämtar data från C* enligt angivna nycklar (abonnent, tid för samtal – nycklar för avsnittet) samt de nödvändiga data för berikning från vilken annan databas som helst. Därefter sammanfogar den dem i sinnet och presenterar resultatet i den resulterande tabellen. Över Spark tog vi fram ett webbgränssnitt och det blev helt klart användbart för drift.
Vid hanteringen av uppdateringsuppgiften för dataöverföring har vi återigen övervägt flera lösningar. Både överföring via Sstloader och alternativet att dela klustret i testområdet i två delar har diskuterats, där varje del växelvis går in i ett kluster med produktionen, och på så sätt får ström från den. Vid uppdateringen av testet var det planerat att byta deras platser: den del som arbetade i testet skulle rensas och föras in i produktionen, medan den andra skulle börja arbeta med data separat. Men efter att ha tänkt igenom det en gång till bedömde vi mer rationellt vilka data som egentligen bör överföras, och insåg att själva anropen är en inkonsekvent enhet för tester, snabbt genererad vid behov, och just produktuppsättningen av data har inget värde för att överföras till testet. Det finns flera objektlagringsenheter som bör överföras, men det är bokstavligen ett par tabeller som inte är särskilt tunga. Därför... kom vi återigen tillbaka till lösningen med hjälp av Spark, med vilken vi skrev och började aktivt använda ett skript för dataöverföring mellan tabellerna produktion-test.
Vår nuvarande policy för distribution tillåter oss att arbeta utan återställningar. Innan produktionen sker en obligatorisk uppdatering på testet, där fel kostar mindre. Vid misslyckande kan man alltid ta bort case-space och återuppdatera hela schemat från början.
För att säkerställa kontinuerlig tillgång till Cassandra behövs en DBA och inte bara han. Alla som arbetar med applikationen måste förstå var och hur man ser den aktuella situationen och hur man snabbt diagnostiserar problem. För detta använder vi aktivt DataStax OpsCenter (administration och övervakning av arbetsbelastningar), systemmetrik Cassandra Driver (antal tidsgränser för skrivningar i C*, antal tidsgränser för läsningar från C*, maximal latens osv.), vi övervakar funktionen hos själva applikationen som arbetar med Cassandra.
När vi funderade över den tidigare frågan insåg vi var den största risken kan ligga. Det handlar om sättet att visa data som hämtar information från flera oberoende förfrågningar till lagringslösningen. På så sätt kan vi få ganska inkonsekvent information. Men detta problem skulle också vara aktuellt om vi bara arbetade med ett datacenter. Det mest rimliga här är förstås att skapa en batchfunktion för dataläsning i en tredjepartsapplikation, som säkerställer att vi får data vid en och samma tidpunkt. När det gäller separering av läsning och skrivning i termer av prestanda, så stoppade oss risken att när vi tappar anslutningen mellan datacentren, kan vi få två helt inkonsekventa kluster.
Således, för närvarande har vi landat på nivåerna av överensstämmelse för skrivning till EACH_QUORUM, för läsning – LOCAL_QUORUM
Kortfattade intryck och slutsatser
För att utvärdera den lösning vi fått angående operativt stöd och framtida utveckling, beslutade vi att tänka på var vi ytterligare kan tillämpa en sådan utveckling.
Om vi ser det direkt, så poängsättning av data för program som "Betala när det passar" (laddar information i S*, beräkning på Spark-skript), att hantera klagomål med aggregering per inriktning, lagra roller och beräkna i en rollmatris för användarnas åtkomsträttigheter.
Som vi ser är repertoaren bred och varierad. Och om man ska välja sida mellan anhängare/motståndare av NoSQL, kommer vi att ansluta oss till anhängarna, eftersom vi fått fördelar, just där var vi förväntade oss det.
Även versionen av Cassandra direkt ur lådan möjliggör horisontell skalning i realtid och löser helt utan problem frågan om ökning av data i systemet. Vi lyckades avgränsa en mycket högbelastad mekanism för beräkning av aggregat utifrån samtal, samt dela schemat och logiken av applikationen, vilket befriade oss från den dåliga vanan att skriva egna jobb och objekt i själva databasen. Vi fick möjlighet att välja och konfigurera, för att öka hastigheten, i vilka datacenter vi ska genomföra beräkningar och i vilka data ska skrivas, och vi säkrade oss mot nedgångar i både enskilda noder och datacenter i stort.
När vi tillämpar vår arkitektur på nya projekt, och redan har viss erfarenhet, vill vi omedelbart ta hänsyn till de nu nämnda nyanserna för att undvika vissa misstag och jämna ut de vassa kanter som inte gick att undvika från början.
Till exempel, att i tid följa uppdateringar av själva Cassandra., eftersom många av de problem vi har haft redan var kända och åtgärdades.
Att inte placera både databasen och Spark på samma noder. (eller strikt dela upp efter tillåtna resursanvändningar), eftersom Spark kan använda mer RAM än tillåtet, vilket snabbt leder till problem nummer 1 på vår lista.
Att förbättra övervakningen och kompetensen för drift redan under testningen av projektet. Att initialt ta hänsyn till alla potentiella användare av vår lösning så mycket som möjligt,eftersom det i slutändan kommer att påverka databassens struktur.
Att snurra den resulterande schemat några gånger för att hitta eventuella optimeringsmöjligheter. Att identifiera vilka fält som kan serialiseras. Att förstå vilka ytterligare tabeller vi behöver skapa för att korrekt och optimalt beakta och sedan leverera den begärda informationen (till exempel, genom att anta att vi kan lagra samma data i olika tabeller, med hänsyn till olika uppdelningar enligt olika kriterier, kan vi avsevärt spara processor tid vid läsfrågor).
Bra att omedelbart förutse installation av TTL och rengöring av föråldrad data.
Vid export av data från Cassandra bör applikationens logik fungera enligt principen FETCH, så att inte alla rader laddas in i minnet på en gång utan väljs i omgångar.
Det är önskvärt att innan projektet flyttas till den beskrivna lösningen kontrollera systemets felresistens genom att utföra en serie krashtester, såsom dataförlust i en datacenter, återställning av korrupt data under en viss period, och nätverksproblem mellan datacentren. Sådana tester kommer inte bara att möjliggöra en bedömning av fördelarna och nackdelarna med den föreslagna arkitekturen, utan också ge en bra övning för ingenjörerna som genomför dem, och den färdigheten kommer att vara mer än användbar om systemfel inträffar i produktion.
Om vi arbetar med kritisk information (såsom data för fakturering, beräkning av kundens skuld), bör vi också uppmärksamma verktyg som kan minska de risker som uppstår på grund av egenskaperna hos databashanteringssystem. Till exempel, att använda verktyget nodesync (Datastax) med en väl utvecklad strategi för dess användning för att inte skapa överbelastning på Cassandra för konsistensens skull och använda det endast för specifika tabeller under angiven tid.
Nåväl, efter ett halvår med Cassandra? Överlag har det inte funnits några olösta problem. Vi har inte heller råkat ut för allvarliga krascher eller dataförluster. Ja, vi var tvungna att tänka på sätt att kompensera för vissa problem som inte hade uppstått tidigare, men i slutändan har det inte påverkat vår arkitektoniska lösning negativt. Om du vill prova något nytt och inte är rädd för att misslyckas, förbered dig på att ingenting är gratis. Du måste engagera dig, sätta dig in i dokumentationen och samla på dig dina egna misstag mer än med de gamla legacy-lösningarna, och ingen teori kan i förväg berätta för dig vilka misstag just du kommer att stöta på.
Källa: habr.com
