

Många stöter på Elasticsearch. Men vad händer när man vill använda det för att lagra loggar "i en särskilt stor mängd"? Och dessutom utan att känna av ett eventuellt misslyckande av något av flera datacenter? Hur bör arkitekturen se ut, och vilka fallgropar kan man stöta på?
Vi på Odnoklassniki har beslutat att använda Elasticsearch för att lösa frågan om logghantering, och nu delar vi med oss av våra erfarenheter till Habr: både om arkitekturen och om fallgroparna.
Jag heter Pjotr Zaitsev, och jag arbetar som systemadministratör på Odnoklassniki. Tidigare var jag också admin och arbetade med Manticore Search, Sphinx search, Elasticsearch. Om det dyker upp ytterligare någon … search, kommer jag troligen också att arbeta med den. Jag deltar också i flera open source-projekt på frivillig basis.
När jag kom till Odnoklassniki sade jag oförsiktigt på intervjun att jag kunde arbeta med Elasticsearch. Efter att ha kommit in i det och genomfört några enklare uppgifter fick jag en stor uppgift att reformera det logghanteringssystem som fanns vid den tidpunkten.
Krav
Krav på systemet formulerades på följande sätt:
- Som frontend skulle Graylog användas. Eftersom företaget redan hade erfarenhet av att använda denna produkt, kände programmerare och testare till den, den var bekant och bekväm för dem.
- Dataflödet: i genomsnitt 50-80 tusen meddelanden per sekund, men om något går sönder är trafiken oreglerad, det kan bli 2-3 miljoner rader per sekund.
- Efter att ha diskuterat kraven på hastigheten för att bearbeta sökfrågor med beställarna insåg vi att det typiska användningsmönstret för ett sådant system är att människor söker loggar för sin applikation för de senaste två dagarna och inte vill vänta längre än en sekund på resultatet av sin fråga.
- Administratörer insisterade på att systemet enkelt skulle kunna skalas om det behövdes, utan att det krävdes att de hade djup kunskap om hur det är uppbyggt.
- Så den enda uppgiften för underhåll som systemet regelbundet krävde var att byta ut viss hårdvara.
- Dessutom har Odnoklassniki en fantastisk teknisk tradition: varje tjänst vi lanserar måste klara av att hantera ett datacenteravbrott (plötsligt, oförutsett och vid vilken tidpunkt som helst).
Det senaste kravet i genomförandet av detta projekt har kostat oss mest blod, vilket jag kommer att berätta mer om senare.
Miljö
Vi arbetar på fyra datacenter, medan datanoder för Elasticsearch bara kan placeras i tre (av flera icke-tekniska anledningar).
I dessa fyra datacenter finns ungefär 18 000 olika loggkällor — hårdvara, containrar, virtuella maskiner.
En viktig funktion: klustret startas i containrar inte på fysiska maskiner, utan på . Containrarna garanteras 2 kärnor, motsvarande 2.0Ghz v4 med möjlighet att använda resterande kärnor om de är lediga.
Med andra ord:
Topologi
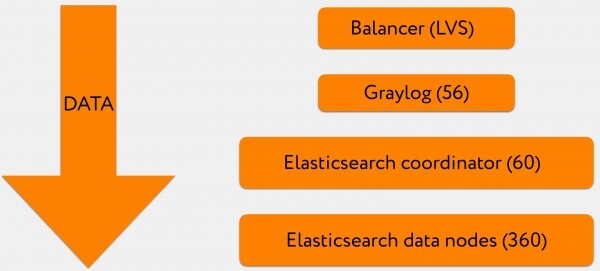
Den övergripande lösningen såg jag initialt ut på följande sätt:
- 3-4 VIP:ar står bakom A-posterna för domänen Graylog, det är adressen dit loggarna skickas.
- varje VIP är en LVS-belastningsbalanserare.
- Efter det kommer loggarna till ett batteri av Graylog, där en del av datan går i GELF-format och en annan del i syslog-format.
- Därefter skrivs allt detta i stora batchar till ett batteri av Elasticsearch-koordinatorer.
- Och de, i sin tur, skickar skriv- och läsförfrågningar till relevanta datanoder.
Terminologi
Kanske är inte alla insatta i terminologin, så jag skulle vilja stanna vid den en stund.
I Elasticsearch finns det flera typer av noder — master, koordinator, datanod. Det finns också två andra typer för olika loggtransformationer och för att länka ihop olika kluster, men vi använde bara de nämnda.
Master
Pingar alla noder närvarande i klustret, upprätthåller en aktuell karta över klustret och sprider den mellan noderna, hanterar händelselogik, sysslar med olika typer av cluster wide housekeeping.
Koordinator
Utför en enda uppgift: tar emot förfrågningar från kunder för läsning eller skrivning och dirigerar denna trafik. Om det är en skrivförfrågan kommer den troligtvis att fråga master vilken shard av den relevanta indexen den ska lägga detta i och vidarebefordra förfrågningen.
Datanod
Lagrar data, utför sökförfrågningar och operationer på de shards som finns där.
Graylog
Det här är en slags sammanslagning av Kibana med Logstash i ELK-stacken. Graylog kombinerar både UI och en pipeline för logghantering. Under huven hos Graylog arbetar Kafka och Zookeeper, som möjliggör kommunikation mellan Graylog som en kluster. Graylog kan cacha loggar (Kafka) vid avbrott av Elasticsearch och repetera misslyckade läs- och skrivförfrågningar, gruppera och märka loggar enligt angivna regler. Precis som Logstash har Graylog funktionalitet för att modifiera strängar innan de skrivs till Elasticsearch.
Dessutom har Graylog inbyggd service discovery som gör det möjligt att få en översikt över hela klustret baserat på en tillgänglig Elasticsearch-nod och filtrera den efter en viss tagg, vilket ger möjlighet att rikta förfrågningar mot specifika containrar.
Visuellt ser det ut så här:

Detta är en skärmdump från en specifik instans. Här bygger vi en histogram baserat på en sökförfrågan och visar relevanta rader.
Index
När vi återvänder till systemets arkitektur skulle jag vilja gå närmare in på hur vi byggde indexmodellen så att allt fungerade korrekt.
I det tidigare diagrammet är detta den lägsta nivån: Elasticsearch datanoder.
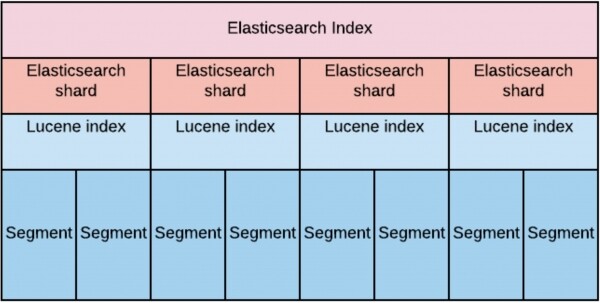
Ett index är en stor virtuell entitet som består av Elasticsearch-shards. Varje shard är i sig inget annat än ett Lucene-index. Och varje Lucene-index består i sin tur av ett eller flera segment.
Vid designen räknade vi med att för att uppfylla kravet på läshastighet vid stora datamängder måste vi jämnt "sprida ut" dessa data över datanoderna.
Det resulterade i att antalet shards per index (med repliker) måste vara strikt lika med antalet datanoder. För det första för att säkerställa en replikationsfaktor på två (det vill säga vi kan förlora hälften av klustret). För det andra för att kunna hantera läs- och skrivförfrågningar med minst hälften av klustret.
Vi definierade lagringstiden initialt som 30 dagar.
Distributionen av shards kan grafiskt representeras på följande sätt:
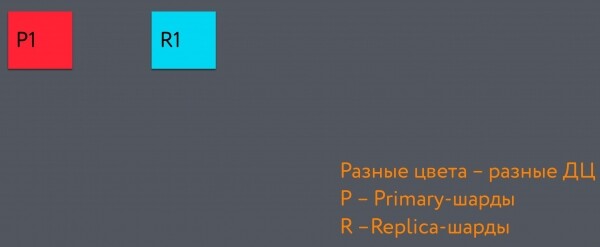
Hela den mörkgrå rektangeln är indexet i sin helhet. Den vänstra röda fyrkanten i den är primärsharden, den första i indexet. Och den blå fyrkanten är replica-sharden. De finns i olika datacenter.
När vi lägger till en ytterligare shard hamnar den i det tredje datacentret. Och i slutändan får vi en sådan struktur som möjliggör förlust av datacenter utan att förlora konsistensen av data:
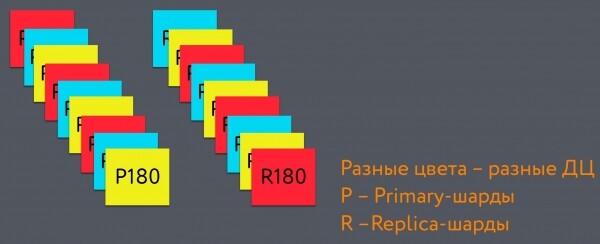
Vi har ställt in rotationen av index, det vill säga skapandet av ett nytt index och borttagning av det äldsta, till 48 timmar (baserat på mönstret för användning av indexet: de senaste 48 timmarna söks oftast).
Denna rotationsintervall för index är kopplad till följande orsaker:
När en specifik datanod får en sökfråga är det ur ett prestandaperspektiv fördelaktigt att fråga en shard om dess storlek är jämförbar med storleken på nodens heap. Detta tillåter att hålla den "heta" delen av indexet i heapen och snabbt få åtkomst till den. När det blir många "heta delar" degraderas sökhastigheten för indexet.
När en nod börjar hantera en sökfråga på en shard tilldelar den ett antal trådar motsvarande antalet hypertrådade kärnor i den fysiska maskinen. Om sökfrågan berör ett stort antal shards ökar antalet trådar proportionellt. Detta påverkar sökhastigheten negativt och har en negativ inverkan på indexeringen av nya data.
För att säkerställa nödvändig söklatens beslöt vi att använda SSD. För snabb hantering av förfrågningar måste maskinerna där dessa containrar var placerade ha minst 56 kärnor. Siffran 56 har valts som en förhållandevis tillräcklig mängd som definierar antalet trådar som Elasticsearch kommer att generera under sin drift. Många parametrar för trådpoolen i Elasticsearch beror direkt på antalet tillgängliga kärnor, vilket i sin tur påverkar det nödvändiga antalet noder i klustret enligt principen "färre kärnor — fler noder".
I slutändan verkar det som att en shard i genomsnitt väger omkring 20 gigabyte, och det finns 360 shards per index. Om vi roterar dem var 48:e timme har vi totalt 15 stycken. Varje index rymmer data för 2 dagar.
Skriva och läsa data scheman
Låt oss gå igenom hur data skrivs i detta system.
Anta att vi får en förfrågan från Graylog till koordinatorn. Till exempel, vi vill indexera 2-3 tusen rader.
Koordinatorn får en förfrågan från Graylog och frågar mastern: "I indexeringsförfrågan angav vi specifikt index men inte vilken shard den ska skrivas till."
Mastern svarar: "Skriv denna information i shard nummer 71", varefter den direkt skickas till den relevanta data-noden där primary-shard nummer 71 finns.
Därefter replikerar transaktionsloggen till replica-shard som ligger i ett annat datacenter.
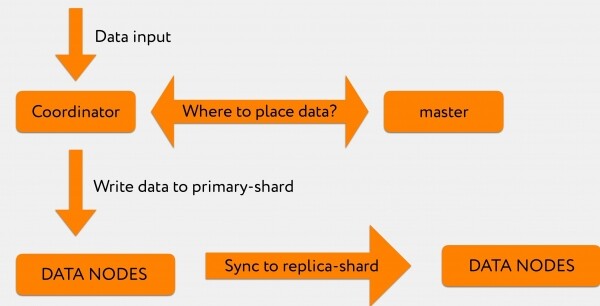
Från Graylog kommer en sökförfrågan till koordinatorn. Koordinatorn vidarebefordrar den enligt index, där Elasticsearch via round-robin fördelar förfrågningar mellan primary-shard och replica-shard.
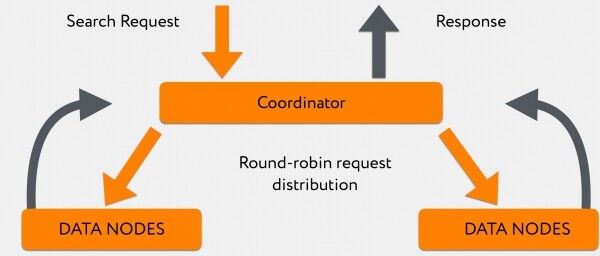
Noderna, totalt 180 stycken, svarar ojämnt, och medan de svarar samlar koordinatorn information som de snabbare data-noderna redan "spottat ut". När all information antingen kommit in eller tidsgränsen nåtts, skickar den allt direkt till klienten.
Hela detta system hanterar i genomsnitt sökförfrågningar från de senaste 48 timmarna på 300-400ms, med undantag för de förfrågningar som har leading wildcard.
"Smått och gott" med Elasticsearch: Java-inställningar
För att allt skulle fungera som vi från början ville, finjusterade vi under en lång tid olika saker i klustret.
Den första delen av de upptäckta problemen var relaterade till hur Java är förinställd i Elasticsearch.
Första problemet
Vi observerade ett stort antal meddelanden om att på Lucene-nivå, när bakgrundsjobb körs, faller segmentmerges av Lucene med fel. Loggarna visade att det var ett OutOfMemoryError-fel. Enligt telemetrin såg vi att minnet var fritt, och vi förstod inte varför denna operation misslyckades.
Det visade sig att Lucene-indexmerges äger rum utanför heapen. Och containrarna är ganska hårt begränsade vad gäller resurser. Dessa resurser rymde endast heapen (heap.size var ungefär lika med RAM), och vissa off-heap-operationer misslyckades med minnesallokeringsfel om de av någon anledning inte passade inom de ~500MB som återstod till gränsen.
Fixen var ganska trivial: vi ökade det tillgängliga RAM-minnet för containern och efter det glömde vi att vi ens hade sådana problem.
Det andra problemet
Fyra till fem dagar efter att klustret startades märkte vi att data-noderna började periodiskt falla ut ur klustret och komma tillbaka efter 10-20 sekunder.
När vi började undersöka det visade det sig att denna off-heap minne i Elasticsearch knappt kontrolleras alls. När vi gav containern mer minne fick vi möjlighet att fylla direkt buffertpoolerna med olika information, och den rensades endast efter att en explicit GC kördes från Elasticsearch.
I vissa fall tog denna operation ganska lång tid, och under denna tid hann klustret märka denna nod som redan nedstängd. Detta problem är väl beskrivet. .
Lösningen blev följande: vi begränsade Java:s möjlighet att använda största delen av minnet utanför heapen för dessa operationer. Vi begränsade det till 16 gigabyte (-XX:MaxDirectMemorySize=16g), vilket resulterade i att explicit GC kallades betydligt oftare och genomfördes betydligt snabbare, vilket slutade med att klustret inte blev instabilt.
Problem tre
Om du tror att problem med 'noder som lämnar klustret vid de mest oväntade ögonblicken' avslutades här, tar du fel.
När vi konfigurerade arbete med indexen valde vi mmapfs för att för nya shards med hög segmentering. Detta var ett ganska grovt misstag, eftersom när man använder mmapfs så mappas filen in i RAM, och vi arbetar sedan med den mappade filen. Detta gör att när garbage collection försöker stoppa trådarna i applikationen tar det mycket lång tid att nå safepoint, och på vägen dit slutar applikationen att svara på masterns förfrågningar om huruvida den fortfarande lever. Följaktligen anser master att noden inte längre finns i klustret. Efter cirka 5-10 sekunder genomförs garbage collector, noden återupplivas, går åter in i klustret och påbörjar initialisering av shards. Allt detta påminde starkt om 'produktionen vi förtjänade' och var olämpligt för något seriöst.
För att bli av med ett sådant beteende gick vi först över till standard nio-fs, och sedan, när vi migrerade från femte versioner av Elastic till sjätte, försökte vi hybridfs där detta problem inte återkom. Mer om lagringstyper kan läsas. .
Problem fyra
Sedan fanns det ytterligare ett mycket intressant problem som vi behandlade rekordlänge. Vi jagade det i 2-3 månader eftersom dess mönster var helt oklart.
Ibland gick våra koordinatorer in i Full GC, vanligtvis någon gång efter lunch, och kom därifrån inte tillbaka. Vid loggning av GC-förseningar såg det ut så här: vi hade allt under kontroll, under kontroll, under kontroll, men sedan plötsligt — och allt gick snabbt dåligt.
Först trodde vi att vi hade en illvillig användare som körde en förfrågan som fick koordinatorn att sluta fungera. Vi loggade länge förfrågningar för att ta reda på vad som hände.
Till slut visade det sig att vid den tidpunkt då en användare kör en stor förfrågan, och den hamnar på en specifik Elasticsearch-koordinator, svarar vissa noder långsammare än andra.
Och den tid som koordinatorn väntar på svar från alla noder, samlar den resultaten som skickats från de noder som redan svarat. För GC innebär det att vårt mönster för användning av heapen förändras snabbt. Och den GC vi använde klarade inte av denna uppgift.
Den enda fix vi hittade för att ändra klusterbeteendet i en sådan situation var migration till JDK13 och användning av skräpuppsamlaren Shenandoah. Detta löste problemet, och våra koordinatorer slutade krascha.
Med detta slutade problemen med Java och problemen med genomströmning började.
"Bär" med Elasticsearch: genomströmning
Problem med genomströmningen innebär att vårt kluster fungerar stabilt, men under toppar av antalet indexerade dokument och vid manipulationer är prestandan otillräcklig.
Det första symptom vi märkte: vid vissa "explosioner" i produktionen, när det plötsligt genereras en mycket stor mängd loggar, dyker det ofta upp ett indexeringsfel i Graylog som heter es_rejected_execution.
Detta hände eftersom thread_pool.write.queue på en data-nod, innan Elasticsearch kan bearbeta indexeringsförfrågan och skicka informationen till shard på disk, som standard kan cacha endast 200 förfrågningar. Och i särskilt om denna parameter nämns väldigt lite. Endast det maximala antalet trådar och den standardstorlek som nämns.
Självklart började vi justera detta värde och kom fram till följande: specifikt i vår setup fungerar det ganska bra att cacha upp till 300 förfrågningar, medan ett högre värde innebär att vi åker tillbaka i Full GC.
Dessutom, eftersom detta är meddelandepaket som anländer inom en enda begäran, behövde vi också justera Graylog så att det skriver inte ofta och med små batcher, utan stora batcher eller en gång var tredje sekund om batchen fortfarande inte är full. I så fall blir informationen vi skriver till Elasticsearch tillgänglig inte efter två sekunder, utan efter fem (vilket vi är helt okej med), men antalet retrys som vi måste göra för att trycka igenom en stor mängd information minskar.
Detta är särskilt viktigt i de stunder när något oväntat händer och det rapporteras intensivt, så att vi inte får en helt spamad Elastic, utan efter en tid — en icke-fungerande Graylog-nod på grund av överfulla buffertar.
Dessutom, när dessa explosioner inträffade i produktionen, fick vi klagomål från programmerare och testare: just när de verkligen behöver dessa loggar, ges de ut mycket långsamt.
Vi började undersöka. Å ena sidan var det tydligt att både sökfrågor och indexeringsfrågor kördes i praktiken på samma fysiska maskiner, och på ett eller annat sätt skulle det alltid bli vissa nedgångar.
Men detta kunde delvis undvikas genom att den sjätte versionen av Elasticsearch introducerade en algoritm som gör att man kan fördela förfrågningar mellan relevanta datanoder inte på ett slumpmässigt round-robin-sätt (containern som hanterar indexering och håller primary-shard kan vara mycket upptagen, och där blir det ingen möjlighet att svara snabbt), utan att dirigera denna begäran till en mindre belastad container med replica-shard som svarar betydligt snabbare. Med andra ord kom vi fram till use_adaptive_replica_selection: true.
Bild av läsningen börjar se ut så här:
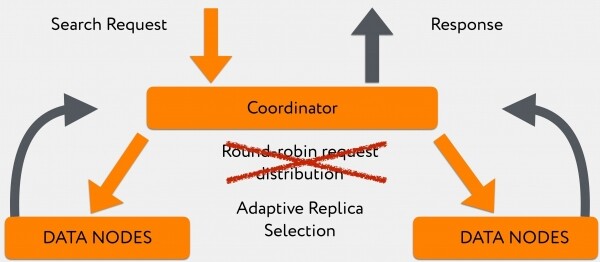
Övergången till denna algoritm gjorde att vi märkbart förbättrade fråga tiden när vi hade en stor mängd loggar att skriva.
Till sist var det största problemet att smärtfritt ta bort datacentret.
Vad vi ville ha från klustret omedelbart efter att ha förlorat kontakten med ett datacenter:
- Om vår nuvarande master befinner sig i det bortfallande datacentret, så kommer det att väljas om och flyttas som roll till en annan nod i ett annat datacenter.
- Mastern kommer snabbt att ta bort alla otillgängliga noder från klustret.
- Baserat på de kvarstående kommer han att förstå: i det förlorade datacentret hade vi sådana primary-shardar, snabbt kommer han att främja komplementära replica-shardar i de kvarstående datacentren, och vi kommer att fortsätta indexera data.
- Som ett resultat av detta kommer vi att uppleva en gradvis nedgång i klusterets bandbredd för skrivning och läsning, men generellt kommer allt att fungera, även om det är sakta, så stabilt.
Som det visade sig ville vi ha något sådant här:
Och fick följande:
Hur kom det sig?
Vid tiden för datacentrets nedgång blev vår flaskhals mästaren.
Varför?
Det hela handlar om att det finns en TaskBatcher i mästaren som ansvarar för att sprida specifika uppgifter, händelser i klustret. Varje nodutfall, varje uppgradering av shard från replica till primary, varje uppgift för att skapa någon shard någonstans – allt detta hamnar först i TaskBatcher, där det behandlas sekventiellt och i en enda ström.
Vid utfallet av ett datacenter hände det att alla datakluster i de överlevande datacentren tyckte att det var deras plikt att informera mästaren "vi har förlorat sådana shardar och sådana datanoder".
Samtidigt skickade de överlevande datanoderna all denna information till den aktuella mästaren och försökte vänta på bekräftelse på att han hade mottagit den. De väntade inte på detta, eftersom mästaren fick uppgifter snabbare än han kunde svara. Noderna upprepade sina förfrågningar efter en tidsgräns, och mästaren försökte inte ens svara på dem under tiden utan var helt försjunken i uppgiften att sortera förfrågningar efter prioritet.
I ett terminalt läge hände det att datanoder spamade mästaren så mycket att han gick in i full GC. Efter detta flyttades mästarens roll till någon nästa nod, och samma sak hände med den, och i slutändan kollapsade klustret helt.
Vi gjorde mätningar och fram till version 6.4.0, där detta blev fixat, var det tillräckligt för oss att ta ner endast 10 datanoder från 360 för att helt krossa klustret.
Det såg ungefär ut så här:
Efter version 6.4.0, där denna hemska bugg blev fixad, slutade datanoderna att döda mästaren. Men han blev inte "smartare" av detta. Det vill säga: när vi tar ner 2, 3 eller 10 (vilket antal som helst som inte är ett) datanoder får mästaren något första meddelande som säger att nod A har gått ner och försöker berätta om detta för nod B, nod C, nod D.
Och för tillfället kan man bara hantera detta genom att sätta en timeout för att försöka berätta något för någon, som ligger på omkring 20-30 sekunder, och på så sätt styra hastigheten för datacenterets utträde ur klustret.
I princip överensstämmer detta med de krav som ursprungligen ställdes på den slutliga produkten inom projektet, men sett ur ett "rent vetenskapligt" perspektiv är det en bugg. Som för övrigt framgångsrikt åtgärdades av utvecklarna i version 7.2.
Dessutom, när en viss datanod gick ur drift, visade det sig att sprida information om dess utträde var viktigare än att informera hela klustret om att det fanns vissa primary-shard på den (för att kunna uppgradera replica-shard i ett annat datacenter till primary, och där kunna skriva information).
Därför, när allt "har tystnat", markeras de utträdande datanoderna inte som stale omedelbart. Följaktligen tvingas vi vänta på att alla pings till de utträdande datanoderna timeoutar, innan vårt kluster börjar berätta att där, där och där behöver vi fortsätta skriva information. Mer detaljerat kan man läsa om detta .
Resultatet är att operationen för att ta ut datacentret idag tar omkring 5 minuter under rusningstid. För en så stor och otymplig maskin är det ett ganska bra resultat.
Till slut kom vi fram till följande lösning:
- Vi har 360 datanoder med diskar på 700 gigabyte.
- 60 koordinatorer för att styra trafiken mellan dessa datanoder.
- 40 master, som vi har kvar som en slags arv från versioner före 6.4.0 - för att överleva utträdet av datacentret var vi moraliskt beredda att förlora några maskiner, för att garantera att vi även vid det sämsta scenariot skulle ha quorum bland mastrarna.
- Alla försök att kombinera roller på en och samma container har kört fast i att förr eller senare har noden brutit samman under belastning.
- I hela klustret används en heap.size på 31 gigabyte: alla försök att minska storleken ledde till att tunga sökförfrågningar med leading wildcard antingen dödade vissa noder eller att circuit breaker slog till i själva Elasticsearch.
- Dessutom, för att säkerställa sökprestanda har vi försökt hålla antalet objekt i klustret så lågt som möjligt, för att bearbeta så få händelser som möjligt på den mest trånga punkten, vilket vi hade i mastern.
Till sist om övervakningen
För att allt detta ska fungera som tänkt övervakar vi följande:
- Varje datanod rapporterar till vår molntjänst att den finns, och att den har dessa shardar. När vi stänger ner något, rapporterar klustret efter 2-3 sekunder att i datacenter A har vi stängt ner nod 2, 3 och 4 - detta innebär att vi på inga villkor kan stänga ner de noder i andra datacenter där det finns shardar i en enda kopia.
- Genom att känna till beteendet hos mastern ser vi noga på antalet väntande uppgifter. För även en enda hängande uppgift, om den inte timeoutas i tid, kan teoretiskt sett i en krissituation bli orsaken till att vår promotering av en replica-shard till primary inte fungerar, vilket i sin tur stoppar indexeringen.
- Vi övervakar även noggrant fördröjningarna hos garbage collector, eftersom vi redan har haft stora problem med detta vid optimering.
- Rejektionsstatistik för trådar för att på förhand förstå var "flaskhalsen" befinner sig.
- Och de vanliga mätvärdena, som heap, RAM och I/O.
Vid byggandet av övervakningen måste man ta hänsyn till egenskaperna hos Thread Pool i Elasticsearch. beskriver möjligheterna för anpassning och standardvärden för sökning och indexering, men nämner helt och hållet inte thread_pool.management. Dessa trådar hanterar bland annat förfrågningar av typen _cat/shards och andra liknande, som är praktiska att använda vid skrivandet av övervakning. Ju större klustret är, desto fler sådana förfrågningar utförs per tidsenhet, och den nämnda thread_pool.management är inte bara inte representerad i den officiella dokumentationen, utan den är också begränsad till 5 trådar som standard, vilket snabbt utnyttjas, vilket gör att övervakningen slutar att fungera korrekt.
Som en avslutning vill jag säga: vi lyckades! Vi har kunnat ge våra programutvecklare och utvecklare ett verktyg som nästan i vilken situation som helst snabbt och pålitligt kan ge information om vad som händer i produktion.
Ja, det blev ganska komplext, men ändå lyckades vi få in våra krav i redan existerande produkter utan att behöva patcha eller skriva om dem.
Källa: habr.com
