

Vad vi kommer att berätta om:
Hur snabbt man kan implementera en gemensam lagring för två servrar baserat på lösningarna drbd+ocfs2.
Vem detta kommer att vara användbart för:
Denna tutorial kommer att vara användbar för systemadministratörer och alla som väljer en metod för att implementera lagring eller vill prova en lösning.
Vilka lösningar vi avstod från och varför
Ofta stöter vi på situationer där vi behöver implementera en gemensam lagring med bra prestanda för läsning och skrivning på en liten webbklyft. Vi har försökt olika alternativ för att implementera gemensam lagring för våra projekt, men få av dem har kunnat tillfredsställa oss på flera punkter. Nu berättar vi varför.
- Glusterfs gav oss inte tillräcklig prestanda för läsning och skrivning, det uppstod problem med att läsa stora mängder filer samtidigt, och CPU-belastningen var hög. Problemet med att läsa filer kunde lösas genom att direkt gå till brickorna, men detta är inte alltid tillämpligt och överlag fel.
- Ceph tilltalade oss inte på grund av dess överdrivna komplexitet, vilket kan vara skadligt för projekt med 2-4 servrar, särskilt om projektet senare underhålls. Dessutom finns det allvarliga prestandabegränsningar som tvingar oss att bygga separata lagringskluster, precis som med glusterfs.
- Att använda en enda nfs-server för att implementera gemensam lagring väcker frågor angående avbrottssäkerhet.
- s3 — en utmärkt populär lösning för vissa typer av uppgifter, men det är inte heller ett filsystem, vilket inskränker användningsområdet.
- lsyncd. Om vi redan har börjat prata om "icke-filsystem", så bör vi ta en titt på denna populära lösning. Det faktum att den inte är lämplig för tvåvägskommunikation (men om man verkligen vill kan det göras) är dessutom en annan faktor; den fungerar inte heller stabilt med ett stort antal filer. En trevlig egenskap är att den är enkeltrådad. Anledningen är programmets arkitektur: den använder inotify för att övervaka arbetets objekt, som den fäster vid uppstart och vid omscanning. För överföring används rsync.
Tutorial: hur man implementerar gemensam lagring baserat på drbd+ocfs2
En av de mest praktiska lösningarna för oss blev kombinationen ocfs2+drbd. Nu ska vi berätta hur man snabbt kan implementera en gemensam lagring för två. servrar baserat på lösningar. Men först lite om komponenterna:
DRBD — ett lagringssystem levererat med standardversionen av Linux som möjliggör replikering av data mellan servrar block för block. Huvudsyftet är att bygga redundanta lagringslösningar.
OCFS2 — ett filsystem som erbjuder delning av samma lagring mellan flera system. Det ingår i Linux-distributionen och består av en kärnmodul och användarutrymmeverktyg för att arbeta med FS. OCFS2 kan användas inte bara ovanpå DRBD, utan även ovanpå iSCSI med multipla anslutningar. I vårt exempel använder vi DRBD.
Alla åtgärder utförs på ubuntu server 18.04 i minimal konfiguration.
Steg 1. Konfigurera DRBD:
I filen /etc/drbd.d/drbd0.res beskriver vi vår virtuella blockenhet /dev/drbd0:
resource drbd0 {
    syncer { rate 1000M; }
    net {
        allow-two-primaries;
        after-sb-0pri discard-zero-changes;
        after-sb-1pri discard-secondary;
        after-sb-2pri disconnect;
    }
    startup { become-primary-on both; }
    on drbd1 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.192:7789;
}
    on drbd2 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.193:7789;
}
}
meta-disk internal — använda samma blockenheter för att lagra metadata
device /dev/drbd0 — använda /dev/drbd0 som väg till drbd.
disk /dev/vdb1 — använda /dev/vdb1
syncer { rate 1000M; } — använda gigabit bandbredd från kanalen
allow-two-primaries — en viktig inställning som tillåter att ändringar accepteras på två primära servrar
after-sb-0pri, after-sb-1pri, after-sb-2pri — alternativ som anger vad noden ska göra vid splitbrain-situationer. Mer information finns i dokumentationen.
become-primary-on both — ställer in båda noderna som primära.
I vårt fall har vi två helt identiska VM:er, med ett dedikerat virtuellt nätverk med en bandbredd på 10 gigabit.
I vårt exempel är nätverksnamnen för de två noderna i klustret drbd1 och drbd2. För korrekt funktion måste namnen och IP-adresserna för noderna matchas i /etc/hosts.
10.10.10.192 drbd1
10.10.10.193 drbd2
Steg 2. Konfigurera noder:
På båda servrarna kör vi:
drbdadm create-md drbd0 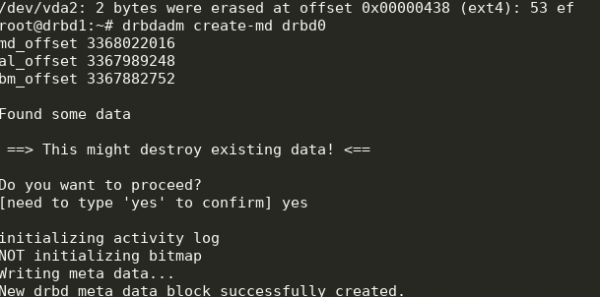
modprobe drbd
drbdadm up drbd0
cat /proc/drbd
Vi får följande:
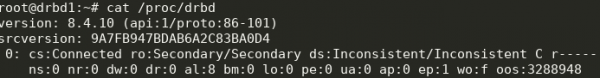
Vi kan börja synkroniseringen. På den första noden måste vi köra:
drbdadm primary --force drbd0Kolla status:
cat /proc/drbd 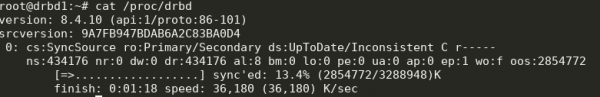
Utmärkt, synkroniseringen har påbörjats. Vänta tills den är klar och se resultatet:
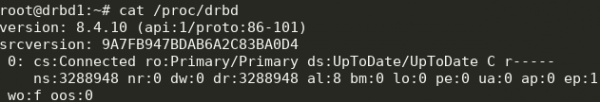
Steg 3. Starta synkroniseringen på den andra noden:
drbdadm primary --force drbd0
Vi får följande:
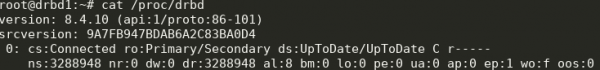
Nu kan vi skriva till drbd från två servrar.
Steg 4. Installation och konfiguration av ocfs2.
Vi kommer att använda en ganska trivial konfiguration:
cluster:
     node_count = 2
     name = ocfs2cluster

node:
     number = 1
     cluster = ocfs2cluster
     ip_port = 7777
     ip_address = 10.10.10.192
     name = drbd1

node:
     number = 2
     cluster = ocfs2cluster
     ip_port = 7777
     ip_address = 10.10.10.193
     name = drbd2
Den måste skrivas till /etc/ocfs2/cluster.conf på båda noderna.
Vi skapar filsystem på drbd0 på vilken nod som helst:
mkfs.ocfs2 -L "testVol" /dev/drbd0
Här har vi skapat ett filsystem med etiketten testVol på drbd0, med standardinställningarna.
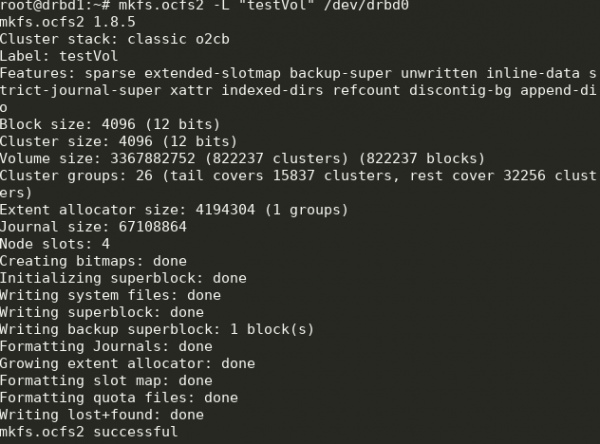
I /etc/default/o2cb måste vi ställa in (som i vår konfigurationsfil)
O2CB_ENABLED=true
O2CB_BOOTCLUSTER=ocfs2cluster
och utföra på varje nod:
o2cb register-cluster ocfs2clusterDärefter aktiverar vi och lägger till alla nödvändiga enheter för autostart:
systemctl enable drbd o2cb ocfs2
systemctl start drbd o2cb ocfs2
En del av detta kommer redan att köras under installationsprocessen.
Steg 5. Lägger till monteringspunkter i fstab på båda noderna:
/dev/drbd0 /media/shared ocfs2 defaults,noauto,heartbeat=local 0 0Katalog /media/shared dessa måste vara skapade i förväg.
Här använder vi alternativet noauto, vilket innebär att filsystemet inte kommer att monteras vid start (jag föredrar att montera nätverksfilsystem via systemd) och heartbeat=local, vilket betyder att tjänsten heartbeat används på varje nod. Det finns även global heartbeat, som passar bättre för större kluster.
Därefter kan vi montera /media/shared och kontrollera synkronisering av innehållet.
Klart! Resultatet blir ett mer eller mindre felsäkert lagringssystem med möjlighet till skalning och bra prestanda.
Källa: habr.com
