

Hej, Habr-nätverksmedlemmar! Den här boken passar alla utvecklare som vill förstå strömmande bearbetning. Att förstå distribuerad programmering kommer att hjälpa till att lära sig mer om Kafka och Kafka Streams. Det skulle vara bra att känna till själva Kafka-ramverket, men det är inte nödvändigt: jag kommer att berätta allt du behöver veta. Både erfarna Kafka-utvecklare och nybörjare kommer med hjälp av den här boken att kunna skapa intressanta applikationer för strömmande bearbetning med Kafka Streams-biblioteket. Java-utvecklare på medelnivå och högre, som redan är bekanta med begrepp som serialisering, kommer att lära sig att använda sina färdigheter för att skapa Kafka Streams-applikationer. Källkoden till boken är skriven i Java 8 och använder i stor utsträckning syntaxen för lambda-uttryck i Java 8, så att kunna arbeta med lambda-funktioner (även om det är på ett annat programmeringsspråk) kommer att vara till nytta.
Utdrag. 5.3. Agregering och fönsteroperationer
I den här sektionen går vi vidare med att utforska de mest lovande delarna av Kafka Streams. Hittills har vi undersökt följande aspekter av Kafka Streams:
- skapa en behandlings-topologi;
- använda tillstånd i strömmande applikationer;
- utföra datastream-anslutningar;
- skillnaderna mellan händelseströmmar (KStream) och uppdateringsströmmar (KTable).
I de följande exemplen kommer vi att sätta ihop alla dessa element. Dessutom kommer du att bekanta dig med fönsteroperationer – en annan fantastisk möjlighet för strömmande applikationer. Vårt första exempel kommer att handla om enkel aggregering.
5.3.1. Aggerering av aktieförsäljning efter branscher
Aggreggering och gruppering är livsnödvändiga verktyg när man arbetar med strömmade data. Att undersöka individuella poster i takt med att de kommer in visar sig ofta vara otillräckligt. För att extrahera mer information från data behöver de grupperas och kombineras.
I det här exemplet kommer du att få prova en inrikesdagshandlares kostym, som behöver följa aktieförsäljning för företag i flera branscher. Specifikt är du intresserad av fem företag med de högsta aktieförsäljningarna inom varje bransch.
För att göra denna typ av aggregering kommer flera steg att behöva tas för att översätta data till önskat format (om man talar i allmänna termer).
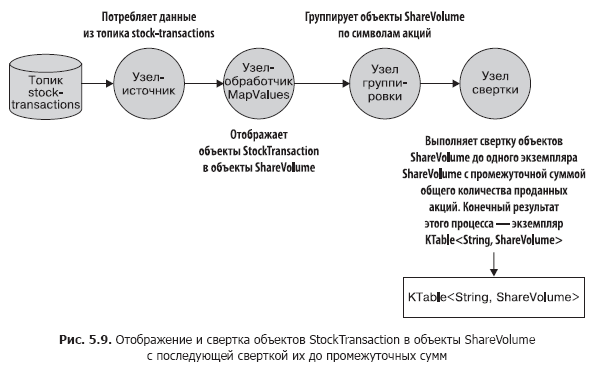
- Skapa en källa baserad på ämnet som publicerar rå information om aktiehandel. Vi måste avbilda ett objekt av typen StockTransaction till ett objekt av typen ShareVolume. Det handlar om att objektet StockTransaction innehåller metadata om försäljning, och vi behöver endast data om antalet sålda aktier.
- Gruppera data i ShareVolume efter aktiesymboler. Efter gruppering efter symboler kan dessa data reduceras till mellanliggande summor av aktieförsäljningsvolymer. Det är värt att notera att metoden KStream.groupBy returnerar en instans av typen KGroupedStream. En instans av KTable kan erhållas genom att anropa metoden KGroupedStream.reduce.
Vad är gränssnittet KGroupedStream?
Metoderna KStream.groupBy och KStream.groupByKey returnerar en instans av KGroupedStream. KGroupedStream är en mellanliggande representation av en ström av händelser efter gruppering av nycklar. Den är inte avsedd för direkt arbete. Istället används KGroupedStream för aggregationsoperationer vars resultat alltid är en KTable. Eftersom resultatet av aggregationsoperationer är en KTable och dessa använder ett tillståndslager, kan det hända att inte alla uppdateringar i resultatet skickas vidare i kedjan.
Metoden KTable.groupBy returnerar en motsvarande KGroupedTable — en mellanliggande representation av en ström av uppdateringar omgrupperade efter nyckel.
Låt oss ta en kort paus och titta på fig. 5.9, som visar vad vi har åstadkommit. Denna topologi bör redan vara bekant för dig.
Låt oss nu titta på koden för denna topologi (den finns i filen src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listning 5.2).
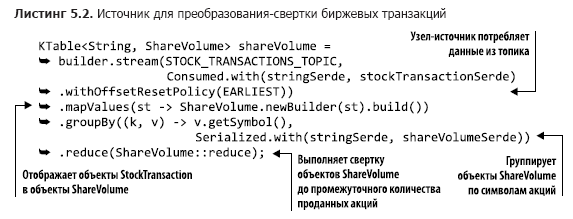
Koden som presenteras är kompakt och utför en stor mängd åtgärder på några få rader. I den första parametern av metoden builder.stream kan du se något nytt: värdet av den uppräknade typen AutoOffsetReset.EARLIEST (det finns också LATEST), som ställs in med hjälp av metoden Consumed.withOffsetResetPolicy. Med denna uppräknade typ kan du ange en strategi för offsetåterställning för varje KStream eller KTable, vilket har högre prioritet än parametern för offsetåterställning i konfigurationen.
GroupByKey och GroupBy
I gränssnittet KStream finns det två metoder för att gruppera poster: GroupByKey och GroupBy. Båda returnerar en KGroupedTable, så du kanske undrar: vad är skillnaden mellan dem och när ska man använda vilken?
Metoden GroupByKey används när nycklarna i KStream redan är icke-tomma. Viktigt är att flaggan "kräver ompartitionering" aldrig har satt.
Metoden GroupBy föreslår att du har ändrat nycklarna för grupperingen, så flaggan för ompartitionering är satt till true. Genomförande efter metoden GroupBy avkopplingar, aggregering och liknande kommer att leda till automatisk ompartitionering.
Sammanfattning: använd alltid GroupByKey vid minsta möjlighet, snarare än GroupBy.
Vad metoderna mapValues och groupBy gör är självklart, så låt oss titta på metoden sum() (den kan hittas i filen src/main/java/bbejeck/model/ShareVolume.java) (listing 5.3).
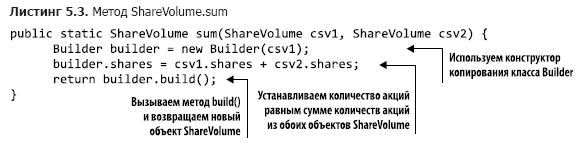
Metoden ShareVolume.sum returnerar det mellanliggande summan av aktieförsäljningsvolymen, och resultatet av hela beräkningskedjan representerar ett objekt KTable. Nu förstår du vilken roll KTable spelar. När objekt ShareVolume kommer in, sparas den senaste aktuella uppdateringen i den motsvarande KTable-objektet. Det är viktigt att komma ihåg att alla uppdateringar återspeglas i föregående shareVolumeKTable, men inte alla skickas vidare.
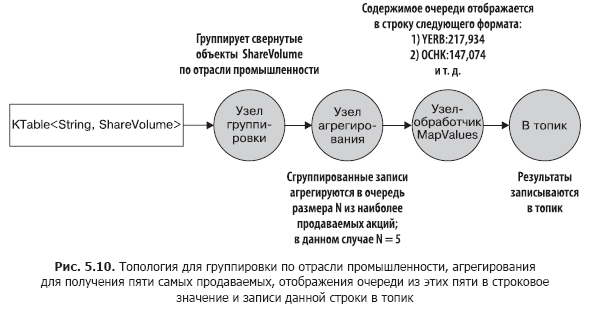
Vidare använder vi denna KTable för att utföra aggregering (baserat på antalet sålda aktier) för att få fram fem företag med störst försäljningsvolymer av aktier inom varje bransch. Våra åtgärder kommer att vara liknande dem som vid den första aggregeringen.
- Utför ytterligare en groupBy-operation för att gruppera individuella ShareVolume-objekt efter branscher.
- Börja summera ShareVolume-objekten. Denna gång representerar aggregationsobjektet en prioritetskö med fast storlek. I en sådan kö med fast storlek lagras endast fem företag med de största mängderna sålda aktier.
- Konvertera köerna från föregående punkt till ett strängvärde och returnera de fem mest sålda aktierna per bransch.
- Skriv resultaten i strängformat till ämnet.
Figur 5.10 visar topologin för datarörelsen. Som du kan se, är den andra bearbetningscykeln ganska enkel.
Nu, efter att tydligt ha förstått strukturen av denna andra bearbetningscykel, kan du gå till dess källkod (du hittar den i filen src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listing 5.4).
I den här initialiseringen finns en variabel fixedQueue. Det är ett anpassat objekt - en adapter för java.util.TreeSet, som används för att spåra de N största resultaten i fallande ordning av sålda aktier.
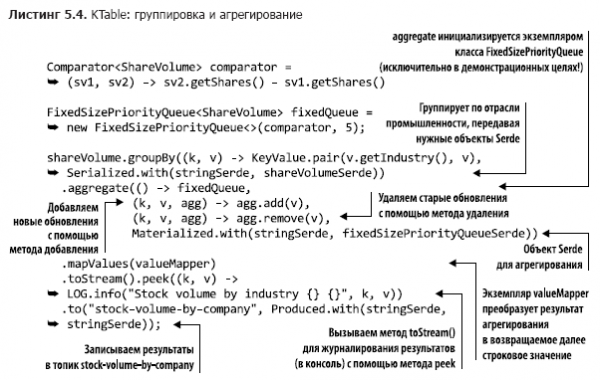
Du har redan stött på anropen groupBy och mapValues, så vi kommer inte att stanna vid dem (vi anropar metoden KTable.toStream, eftersom metoden KTable.print anses vara föråldrad). Men du har ännu inte sett KTable-versionen av metoden aggregate(), så vi kommer att ta lite tid för att diskutera den.
Som du kommer ihåg, kännetecknas KTable av att poster med samma nycklar betraktas som uppdateringar. KTable ersätter den gamla posten med den nya. Aggering sker på liknande sätt: senaste poster med samma nyckel aggeras. När en post kommer in läggs den till en instans av klassen FixedSizePriorityQueue med hjälp av en summerare (den andra parametern i anropet till metoden aggregate), men om det redan finns en annan post med samma nyckel, tas den gamla posten bort med hjälp av en subtraherar (den tredje parametern i anropet till metoden aggregate).
Detta betyder att vår aggregator, FixedSizePriorityQueue, inte aggerar alla värden med samma nyckel, utan lagrar det glidande medelvärdet av de N mest sålda aktietyperna. I varje inkommande post finns det totala antalet aktier som sålts hittills. KTable ger dig information om vilka företags aktier som säljer mest just nu; glidande aggering av varje uppdatering behövs inte.
Vi har lärt oss att göra två viktiga saker:
- gruppera värden i KTable efter en gemensam nyckel;
- utföra nyttiga operationer på dessa grupperade värden, såsom reduktion och aggering.
Förmågan att utföra dessa operationer är viktig för att förstå betydelsen av de data som rör sig genom Kafka Streams-applikationen och att ta reda på vilken information de bär.
Vi har också sammanfört några av de centrala begreppen som diskuterats tidigare i denna bok. I kapitel 4 berättade vi hur viktigt det är för en streamingapplikation att ha ett motståndskraftigt, lokalt tillstånd. Det första exemplet från detta kapitel visade varför lokalt tillstånd är så viktigt – det möjliggör spårning av vilken information du redan har sett. Lokalt tillträde eliminerar nätverksfördröjningar, vilket gör att applikationen blir mer presterande och felresistent.
Vid utförande av någon form av aggregerings- eller sammanfogning måste namnet på tillståndslagringen anges. Aggregerings- och sammanfogningsoperationer returnerar en instans av KTable, och KTable använder tillståndslagringen för att ersätta gamla resultat med nya. Som du har sett skickas långt ifrån alla uppdateringar vidare i kedjan, och detta är viktigt eftersom aggregeringsoperationer är avsedda för att skaffa slutgiltig information. Om du inte använder lokalt tillstånd kommer KTable att skicka vidare alla aggregerings- och sammanfogningsresultat.
Näst ska vi titta på utförandet av operationer som aggregering inom angiven tidsram – de så kallade fönsteroperationerna (windowing operations).
5.3.2. Fönsteroperationer
I föregående avsnitt bekantade vi oss med "glidande" sammanfogning och aggregering. Applikationen genomförde en kontinuerlig sammanfogning av aktieförsäljningsvolymen följt av aggregering av de fem mest sålda aktierna på börsen.
Ibland är sådana kontinuerliga aggregeringar och sammanfogningar av resultat nödvändiga. Och ibland måste operationer utföras endast över en angiven tidsperiod. Till exempel beräkna hur många aktieaffärer som gjordes med en specifik företagets aktie under de senaste 10 minuterna. Eller hur många användare som klickade på den nya reklam bannern under de senaste 15 minuterna. Applikationen kan genomföra sådana operationer flera gånger, men med resultat som endast gäller för angivna tidsperioder (tidsfönster).
Räkna aktietransaktioner per köpare
I nästa exempel kommer vi att spåra aktietransaktioner för flera handlare – antingen stora organisationer eller smarta finansierare som agerar ensamma.
Det finns två möjliga skäl för sådan spårning. Det ena är behovet av att veta vad marknadsledare köper/säljer. Om dessa stora aktörer och erfarna investerare ser möjligheter för sig själva, är det värt att följa deras strategi. Den andra anledningen är att upptäcka tecken på olagliga affärer med användning av insiderinformation. För detta behöver du analysera korrelationen mellan stora försäljningsökningar och viktiga pressmeddelanden.
Denna spårning består av följande steg:
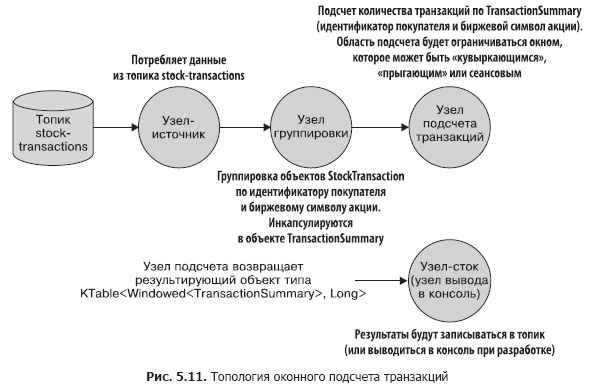
- skapa en ström för att läsa från ämnet stock-transactions;
- gruppera inkommande poster efter köparens identifierare och aktiens börssymbol. Anrop av metoden groupBy returnerar en instans av klassen KGroupedStream;
- återvända med metoden KGroupedStream.windowedBy en datastream begränsad av ett tidsfönster, vilket gör det möjligt att utföra fönsteraggregat. Beroende på fönstertypen returneras antingen TimeWindowedKStream eller SessionWindowedKStream;
- räkna transaktioner för aggregationsoperationen. Det fönsterdataflöde som definieras avgör om en specifik post räknas med;
- skriva resultaten till ämnet eller skriva ut dem till konsolen under utvecklingen.
Topologin för denna applikation är enkel, men en visuell representation kan vara till hjälp. Låt oss titta på fig. 5.11.
Därefter kommer vi att titta på funktionerna hos fönsteroperationer och motsvarande kod.
Typer av fönster
I Kafka Streams finns det tre typer av fönster:
- sessionsfönster;
- tumbling fönster;
- glidande/påhoppande fönster.
Vilket du väljer beror på affärskrav. Tumbling och hoppande fönster begränsas av tid, medan sessionsfönstrens begränsningar är kopplade till användarnas handlingar — längden på sessionen(-erna) bestäms enbart av hur aktivt användaren beter sig. Huvudsaken är att komma ihåg att alla typer av fönster baseras på tidsstämplar för posterna, och inte på systemtiden.
Därefter implementerar vi vår topologi med varje typ av fönster. Fullständig kod kommer att ges endast i det första exemplet, för de andra typerna av fönster kommer inget att förändras förutom typen av fönsteroperation.
Sessionsfönster
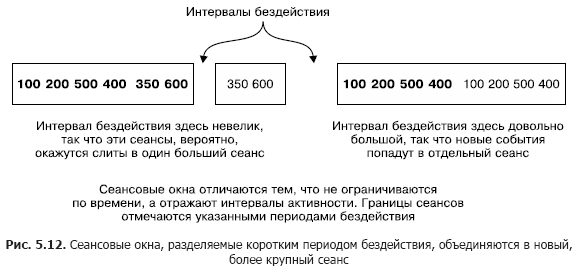
Sessionsfönster skiljer sig starkt från alla andra typer av fönster. De begränsas inte så mycket av tid som av användarens aktivitet (eller aktiviteten hos den enhet som du vill spåra). Sessionsfönster avgränsas av perioder av inaktivitet.
Figur 5.12 illustrerar begreppet sessionsfönster. En mindre session kommer att glida samman med sessionen till vänster om den. Och sessionen till höger kommer att vara separat, eftersom den följer efter en lång period av inaktivitet. Sessionsfönster baseras på användaraktiviteter, men använder tidsstämpel-taggar från poster för att avgöra vilken session posten tillhör.
Användning av sessionsfönster för att spåra börstransaktioner.
Vi använder sessionsfönster för att fånga information om börstransaktioner. Implementeringen av sessionsfönster visas i listing 5.5 (som kan hittas i filen src/main/java/bbejeck/chapter_5/CountingWindowingAndKTableJoinExample.java).
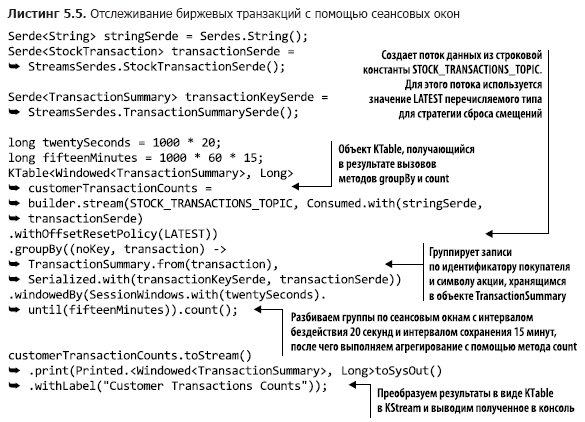
De flesta operationerna i denna topologi har du redan stött på, så det finns ingen anledning att gå igenom dem igen här. Men här finns också några nya element som vi nu kommer att diskutera.
Vid varje operation groupBy utförs vanligtvis någon form av aggregering (aggregering, sammanställning eller räkning). Antingen kan du utföra en ackumulerande aggregering med löpande totalsummor, eller ett fönsteraggregat där poster beaktas inom ett givet tidsfönster.
Koden från listing 5.5 räknar antalet transaktioner inom sessionsfönster. I figur 5.13 analyseras dessa åtgärder steg för steg.
Med anropet windowedBy(SessionWindows.with(twentySeconds).until(fifteenMinutes)) skapade vi ett sessionsfönster med en inaktivitetsperiod på 20 sekunder och en bevarandeperiod på 15 minuter. Inaktivitetsperioden på 20 sekunder innebär att applikationen kommer att inkludera varje post som kommer in inom 20 sekunder efter slutet eller början av den aktuella sessionen i den nuvarande (aktiva) sessionen.
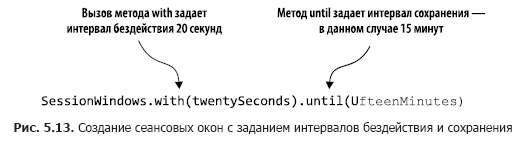
Här anger vi vilken aggregationsoperation som ska utföras i sessionsfönstret – i detta fall count. Om den inkommande posten går utanför inaktivitetens intervall (på valfri sida av tidsstämpeln), skapar applikationen en ny session. Bevarandeintervallet innebär att sessionen hålls aktiv under en viss tid och tillåter fördröjda data som går utanför inaktivitetsperioden för sessionen men som fortfarande kan kopplas. Dessutom motsvarar början och slutet på den nya sessionen, som skapats genom sammanslagning, den tidigaste och den senaste tidsstämpeln.
Låt oss titta på några poster från count-metoden för att se hur sessioner fungerar (tabell 5.1).
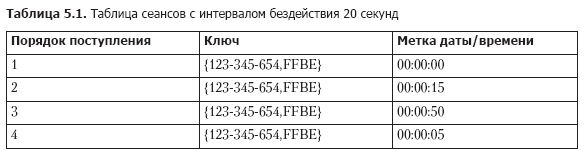
När poster kommer in, letar vi efter redan existerande sessioner med samma nyckel, där slutetiden är tidigare än den aktuella tidsstämpeln – inaktivitetsintervallet, och starttiden är senare än den aktuella tidsstämpeln + inaktivitetsintervallet. Med detta i åtanke slås fyra poster från tabell 5.1 samman till en enda session på följande sätt.
1. Först kommer post 1, så starttiden är lika med sluttiden och är 00:00:00.
2. Därefter kommer post 2, och vi letar efter sessioner som slutar senast 23:59:55 och börjar senast 00:00:35. Vi hittar post 1 och slår samman sessionerna 1 och 2. Vi tar starttiden för session 1 (den tidigare) och sluttiden för session 2 (den senare), så vår nya session börjar kl. 00:00:00 och slutar kl. 00:00:15.
3. Post 3 kommer in, vi letar efter sessioner mellan 00:00:30 och 00:01:10 och hittar inga. Vi lägger till den andra sessionen för nyckeln 123-345-654,FFBE, som börjar och slutar kl. 00:00:50.
4. Post 4 kommer in, och vi letar efter sessioner mellan 23:59:45 och 00:00:25. Denna gång hittar vi båda sessionerna – 1 och 2. Alla tre sessionerna slås samman i en, med starttid 00:00:00 och sluttid 00:00:15.
Från det som har beskrivits i detta avsnitt är det viktigt att komma ihåg följande kriterier:
- sessioner är inte fönster av fast storlek. Sessionens längd bestäms av aktiviteten inom det angivna tidsintervallet;
- tidsstämplarna i data avgör om en händelse faller inom en befintlig session eller i inaktivitetsintervallet.
Därefter kommer vi att diskutera den nästa typen av fönster – "rullande" fönster.
"Rullande" fönster
«Kullande» (tumbling) fönster fångar händelser som inträffar under en viss tidsperiod. Tänk dig att du behöver fånga alla aktietransaktioner för ett företag var 20:e sekund, så att du samlar alla händelser under denna tidsperiod. I slutet av den 20-sekundersintervallet "kullar" fönstret och går vidare till det nya 20-sekunders observationsintervallet. Figur 5.14 illustrerar denna situation.
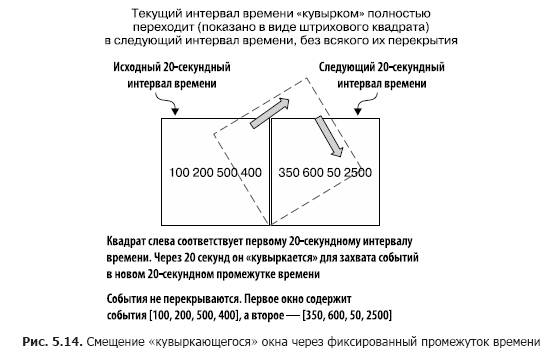
Som du kan se inkluderar alla händelser som kommit in under de senaste 20 sekunderna i fönstret. I slutet av denna tidsperiod skapas ett nytt fönster.
I listing 5.6 visas koden som demonstrerar användningen av «kullande» fönster för att fånga aktietransaktioner var 20:e sekund (den kan hittas i filen src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
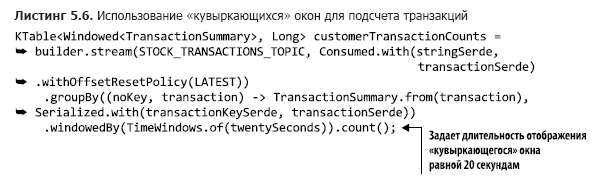
Tack vare denna lilla förändring i metoden TimeWindows.of kan ett «kullande» fönster användas. I det här exemplet finns det ingen metodanrop till until(), vilket innebär att standardbevarandet av intervall, som är 24 timmar, kommer att användas.
Slutligen är det dags att gå till den sista av fönsteralternativen - «hoppar» (hopping) fönster.
Glidande («hoppar») fönster
Glidande/«hoppar» (sliding/hopping) fönster liknar «kullande», men med en liten skillnad. Glidande fönster väntar inte tills tidsintervallet är slut innan ett nytt fönster skapas för att bearbeta nyligen inträffade händelser. De initierar nya beräkningar efter ett väntetidsintervall som är kortare än fönstrets varaktighet.
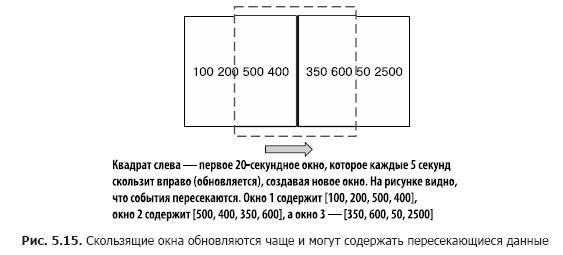
För att illustrera skillnaderna mellan «kullande» och «hoppar» fönster, återvänder vi till exemplet med aktietransaktionsräkning. Vårt mål är fortfarande att räkna antalet transaktioner, men vi vill inte vänta hela tidsintervallet innan vi uppdaterar räknaren. Istället kommer vi att uppdatera räknaren genom kortare tidsperioder. Till exempel, vi kommer fortfarande att räkna antalet transaktioner var 20:e sekund, men uppdatera räknaren var 5:e sekund, som visas i fig. 5.15. På så sätt får vi tre resultatfönster med överlappande data.
I listing 5.7 visas koden för att ställa in glidande fönster (den kan hittas i filen src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
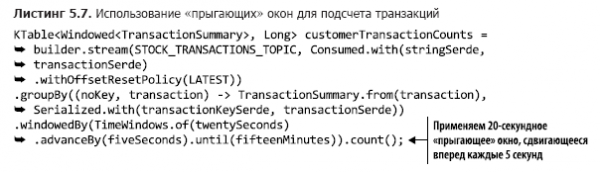
Det "rullande" fönstret kan omvandlas till ett "hoppa" genom att lägga till anropet till metoden advanceBy(). I det angivna exemplet är intervallet för lagring 15 minuter.
I detta avsnitt har du sett hur man begränsar aggregatresultat med tidsfönster. I synnerhet vill jag att du ska komma ihåg följande tre saker från detta avsnitt:
- storleken på sessionfönster begränsas inte av tidsspannet, utan av användarnas aktivitet;
- de "rullande" fönstren ger en översikt över händelser under en given tidsperiod;
- längden på "hoppa" fönster är fast, men de uppdateras ofta och kan innehålla överlappande poster i alla fönster.
Vi kommer nu att lära oss hur man omvandlar KTable tillbaka till KStream för anslutning.
5.3.3. Anslutning av KStream- och KTable-objekt
I kapitel 4 diskuterade vi anslutningen av två KStream-objekt. Nu ska vi lära oss att koppla KTable och KStream. Detta kan vara nödvändigt av följande enkla anledning. KStream är en ström av poster, medan KTable är en ström av uppdateringar av poster, men ibland kan det vara nödvändigt att lägga till ytterligare kontext till strömmen av poster med hjälp av uppdateringar från KTable.
Låt oss ta data om antalet börshandler och koppla dem till börsnyheter inom de relevanta branscherna. Här är vad vi behöver göra för att uppnå detta med den redan existerande koden.
- Omvandla KTable-objektet med data om antal börshandler till KStream med efterföljande byte av nyckeln till den som representerar branschen som motsvarar denna aktiesymbol.
- Skapa ett KTable-objekt som läser data från ämnet med börsnyheter. Denna nya KTable kommer att kategoriseras efter branscher.
- Koppla nyhetsuppdateringar med information om antalet börshandler efter branscher.
Nu ska vi se hur vi genomför den här handlingsplanen.
Omvandling av KTable till KStream
För att omvandla KTable till KStream behöver man göra följande.
- Anropa metoden KTable.toStream().
- Genom att anropa metoden KStream.map, ersätt nyckeln med namnet på branschen, och extrahera sedan objektet TransactionSummary från instansen av Windowed.
Vi kommer att kedja dessa operationer på följande sätt (koden finns i filen src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listning 5.8).
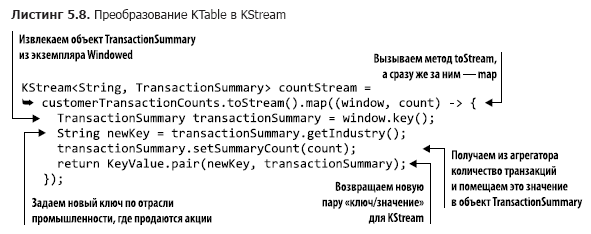
Eftersom vi utför operationen KStream.map kommer om-sektioneringen av den returnerade KStream-instansen att göras automatiskt när den används i en sammanfogning.
Vi har slutfört konverteringsprocessen, nu behöver vi skapa ett KTable-objekt för att läsa börsnyheter.
Skapande av KTable för börsnyheter
Lyckligtvis räcker det med en rad kod för att skapa KTable-objektet (denna kod finns i filen src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.9).
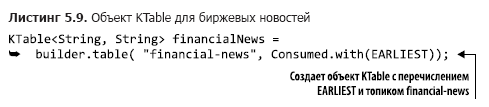
Det bör noteras att inga Serde-objekt behöver anges, eftersom sträng-Surde används i inställningarna. Dessutom fylls tabellen med poster i början tack vare användningen av uppräkningen EARLIEST.
Nu kan vi gå vidare till det sista steget – sammanfogning.
Sammanfogning av nyhetsuppdateringar med data om antalet transaktionen
Att skapa sammanfogningen är inte svårt. Vi kommer att använda en vänster-sammanfogning för att hantera fallet där det inte finns några börsnyheter för den aktuella branschen (den nödvändiga koden kan hittas i filen src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.10).
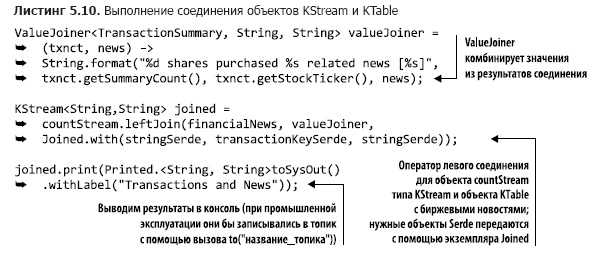
Denna leftJoin-operator är ganska enkel. Till skillnad från sammanfogningarna i kapitel 4 används metoden JoinWindow inte, eftersom det för varje nyckel i KTable finns endast en post vid KStream-KTable-sammanfogningen. Denna sammanfogning är inte tidsbegränsad: posten antingen finns i KTable eller inte. Den viktigaste insikten är att KTable-objekt kan berika KStream med mindre frekvent uppdaterad referensdata.
Nu ska vi titta på ett mer effektivt sätt att berika händelser från KStream.
5.3.4. GlobalKTable-objekt
Som ni förstått finns det ett behov av att berika händelseflöden eller lägga till kontext till dem. I kapitel 4 såg ni sammanfogningarna av två KStream-objekt, och i det föregående avsnittet sammanfogningen av KStream och KTable. I alla dessa fall är det nödvändigt att om-sektera datan vid kartläggning av nycklar till en ny typ eller värde. Ibland görs om-sektering explicit, och ibland gör Kafka Streams det automatiskt. Om-sektering är nödvändig eftersom nycklarna har ändrats och posterna måste hamna i nya sektioner, annars kommer sammanfogningen att vara omöjlig (detta diskuterades i kapitel 4, avsnittet 'Om-sektering av data' del 4.2.4).
Ominaraktivering har sitt pris
Ominaraktivering kräver resurser - ytterligare resurskostnader för att skapa mellanliggande ämnen, lagra duplicerade data i ytterligare ett ämne; det innebär också en ökad latens på grund av skrivning och läsning från det ämnet. Dessutom, om man behöver utföra en förening utöver en aspekt eller dimension, måste man organisera föreningarna i en kedja, avbilda poster med nya nycklar och återigen genomföra processen för omaraktivering.
Förening med mindre datamängder
I vissa fall är volymen av referensdata som planeras för förening relativt liten, så att hela deras kopior kan rymmas lokalt på varje nod. För sådana situationer finns det en klass som heter GlobalKTable i Kafka Streams.
Exemplaren av GlobalKTable är unika eftersom applikationen replikeras alla data på varje nod. Och eftersom alla noder innehåller all data, är det inte nödvändigt att omarakterisera händelseflödet efter referensdatanyckeln för att den ska vara tillgänglig för alla sektioner. Med hjälp av objekten GlobalKTable kan man även utföra nyckellösa föreningar. Låt oss återkomma till ett av de tidigare exemplen för att demonstrera den här funktionen.
Förening av KStream-objekt med GlobalKTable-objekt
I avsnitt 5.3.2 genomförde vi fönsteraggregering av börstransaktioner utifrån köpare. Resultaten av denna aggregering såg ungefär ut så här:
{customerId='074-09-3705', stockTicker='GUTM'}, 17
{customerId='037-34-5184', stockTicker='CORK'}, 16
Även om dessa resultat motsvarade det uppsatta målet skulle det vara mer praktiskt om också kundens namn och företagets fullständiga namn visades. För att lägga till kundens namn och företagets namn kan man utföra vanliga föreningar, men då behöver man göra två nyckelavbildningar och omaraktivering. Med GlobalKTable kan man undvika kostnader för sådana operationer.
För detta kommer vi att använda objektet countStream från listings 5.11 (den motsvarande koden kan hittas i filen src/main/java/bbejeck/chapter_5/GlobalKTableExample.java), och förena det med två GlobalKTable-objekt.
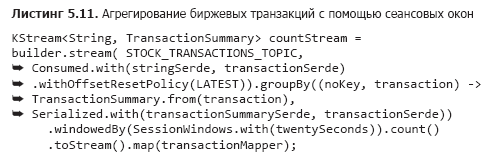
Vi har redan diskuterat detta tidigare, så jag ska inte upprepa mig. Jag vill dock notera att koden i funktionen toStream().map är abstraherad i ett funktionellt objekt istället för en inbäddad lambda-uttryck för läsbarhetens skull.
Nästa steg är att deklarera två instanser av GlobalKTable (den medföljande koden finns i filen src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (lista 5.12).
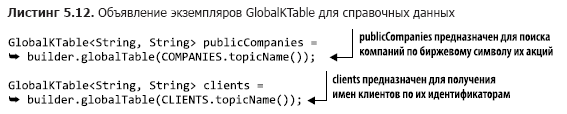
Observera att ämnesnamnen anges med hjälp av uppräkningsbara typer.
Nu när vi har förberett alla komponenter återstår det att skriva koden för föreningen (som kan hittas i filen src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (lista 5.13).
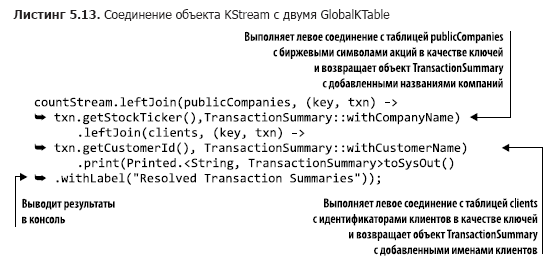
Även om det finns två föreningar i denna kod, är de organiserade i en kedja eftersom inget av resultaten används separat. Resultaten visas i slutet av hela operationen.
När du kör den ovanstående föreningsoperationen får du resultat av följande slag:
{customer='Barney, Smith' company="Exxon", transactions= 17}Kärnan är oförändrad, men dessa resultat ser mer förståeliga ut.
Om vi räknar med kapitel 4 har du redan sett flera typer av föreningar i aktion. De listas i tabell 5.2. Denna tabell återspeglar föreningsmöjligheterna som är aktuella för version 1.0.0 av Kafka Streams; i framtida utgåvor kan något förändras.
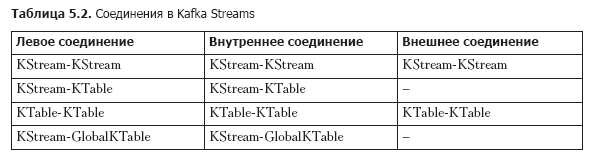
Som en sammanfattning påminner jag om det viktigaste: du kan förena händelseströmmar (KStream) och uppdateringsflöden (KTable) med hjälp av lokal stat. Dessutom, om storleken på referensdata inte är för stor, kan du använda objektet GlobalKTable. GlobalKTable replikerar alla partitioner på varje nod i Kafka Streams-applikationen, vilket garanterar tillgången till all data oavsett vilken partition nyckeln tillhör.
Därefter kommer vi att se en funktion i Kafka Streams som gör det möjligt att övervaka förändringar i tillståndet utan att konsumera data från Kafka-ämnet.
5.3.5. Tillgängligt för frågetillstånd
Vi har redan utfört flera operationer som involverar tillstånd och alltid skrivit ut resultaten i konsolen (för utvecklingsändamål) eller skrivit dem till ett ämne (för industriellt bruk). När resultaten skrivs till ett ämne måste du använda en Kafka-konsument för att se dem.
Att läsa data från dessa ämnen kan betraktas som en form av materialiserade vyer. För våra ändamål kan vi använda definitionen av en materialiserad vy från "Wikipedia": „... ett fysiskt objekt i databasen som innehåller resultaten av en fråga. Det kan till exempel vara en lokal kopia av fjärrdata, eller en delmängd av rader och/eller kolumner från en tabell eller resultaten av en sammanfogning, eller en pivottabell som erhållits genom aggregering" (https://en.wikipedia.org/wiki/Materialized_view).
Kafka Streams möjliggör också interaktiva frågor mot tillståndslager, vilket ger betydelsen av direkt läsning av dessa materialiserade vyer. Det är viktigt att notera att en förfrågan till tillståndslagret är en "endast läsning"-operation. Tack vare detta behöver du inte vara rädd för att oavsiktligt göra tillståndet inkonsekvent under databehandlingen i applikationen.
Möjligheten att direkt fråga tillståndslager är mycket betydelsefull. Det innebär att man kan skapa applikationer — instrumentpaneler utan att först behöva få data från Kafka-konsumenten. Den ökar också effektiviteten i applikationen, eftersom det inte behövs att skriva om data:
- tack vare datalokaliteten kan de snabbt nås;
- dataduplicering utesluts, eftersom de inte skrivs till ett externt lagringsutrymme.
Det viktigaste jag vill att du ska komma ihåg: du kan direkt utföra frågor mot tillståndet från applikationen. Möjligheterna som detta ger dig kan inte överskattas. Istället för att konsumera data från Kafka och lagra poster i en databas för applikationen, kan du fråga tillståndslager med samma resultat. Direkt frågor mot tillståndslager innebär mindre kod (ingen konsument) och mindre mjukvara (ingen behov av en databastabell för att lagra resultaten).
Vi har täckt en stor mängd information i detta kapitel, så vi kommer att pausa vår diskussion om interaktiva förfrågningar till tillståndslager. Men oroa dig inte: i kapitel 9 kommer vi att skapa en enkel applikation – en informationspanel med interaktiva förfrågningar. För att demonstrera interaktiva förfrågningar och möjligheterna att lägga till dem i Kafka Streams-applikationer kommer vi att använda några av exemplen från detta och föregående kapitel.
Sammanfattning
- KStream-objekt representerar flöden av händelser, jämförbara med insättningar i en databas. KTable-objekt representerar flöden av uppdateringar och liknar mer uppdateringar i en databas. Storleken på KTable-objekt växer inte, gamla poster ersätts med nya.
- KTable-objekt behövs för aggregeringsoperationer.
- Med hjälp av fönsteroperationer kan man dela upp aggregerade data i tidsfack.
- Tack vare GlobalKTable-objekt kan man få tillgång till referensdata var som helst i applikationen, oavsett partitionering.
- Det är möjligt att göra anslutningar mellan KStream-, KTable- och GlobalKTable-objekt.
Hitintills har vi fokuserat på att skapa Kafka Streams-applikationer med hjälp av det högre nivåns DSL KStream. Även om den högre nivåns metod möjliggör skapandet av rena och koncisa program, är det en viss kompromiss. Att arbeta med DSL KStream innebär en ökning av koden koncishet på bekostnad av kontrollnivå. I nästa kapitel kommer vi att titta på det lägre nivåns API för bearbetningsnoder och överväga andra kompromisser. Programmen kommer att bli längre än de har varit tidigare, men vi kommer att ha möjlighet att skapa nästan vilken bearbetningsnod vi än kan behöva.
→ Läs mer om boken på
→ För Habr-anhängare finns det 25% rabatt med kupong — Kafka Streams
→ Vid betalning av den tryckta versionen av boken skickas e-boken via e-post.
Källa: habr.com
