

Så här ser överskottsdata ut
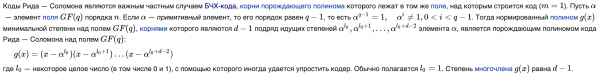
Överskottskoder* används i stor utsträckning i datorsystem för att öka tillförlitligheten vid datalagring. På Yandex används de i många projekt. Till exempel sparar användningen av överskottskoder istället för replikering i vårt interna objektlagringssystem miljontals utan att minska tillförlitligheten. Men trots den utbredda användningen är en begriplig beskrivning av hur överskottskoder fungerar mycket sällsynt. De som vill förstå stöter ofta på följande (från ):
Jag heter Vadim, och på Yandex arbetar jag med utvecklingen av det interna objektlagringssystemet MDS. I denna artikel ska jag på ett enkelt sätt beskriva de teoretiska grunderna för överskottskoder (Reed-Solomon-koder och LRC). Jag kommer att förklara hur det fungerar utan komplicerad matematik och sällsynta termer. I slutet kommer jag att ge exempel på användning av överskottskoder i Yandex.
Jag kommer inte att gå in på en rad matematiska detaljer, men jag ger länkar för dem som vill fördjupa sig mer. Jag noterar också att vissa matematiska definitioner kanske inte är strikta, eftersom artikeln är avsedd för ingenjörer som vill förstå kärnan i frågan.
* I engelskspråkig litteratur kallas överskottskoder ofta för erasure codes.
1. Kärnan i överskottskoder
Kärnan i alla överskottskoder är mycket enkel: att lagra (eller överföra) data på ett sätt som förhindrar dataförlust vid uppkomst av fel (diskfel, dataöverföringsfel osv.).
I de flesta* överskottskoder delas data upp i n datablokker, och för dessa beräknas m överskottskoder, vilket ger totalt n + m block. Överskottskoderna konstrueras så att man kan återställa n datablokker genom att använda endast en del av de n + m blocken. Nedan kommer vi endast att titta på blocköverskottskoder, det vill säga sådana där data delas upp i block.
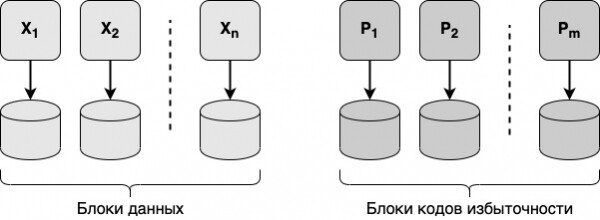
För att återställa alla n datablok måste man ha minst n av n + m block, eftersom man inte kan få n block med endast n-1 block (i så fall skulle man behöva ta 1 block "från ingenstans"). Är n godtyckliga block av n + m block tillräckligt för att återställa all data? Det beror på typen av överflödskoder, till exempel tillåter Reid-Solomon-koder att återställa all data med hjälp av godtyckliga n block, medan LRC-överflödskoder inte alltid gör det.
Databevarande
I datalagringssystem lagras vanligtvis varje databasblock och överflödsblock på enskilda diskar. Om en godtycklig disk går sönder kan de ursprungliga uppgifterna fortfarande återställas och läsas. Data kan återställas även vid samtidig fel på flera diskar.
Datatransmission
Överflödskoder kan användas för pålitlig datatransmission i opålitliga nätverk. De överförda uppgifterna delas upp i block, och överflödskoder beräknas för dessa. Både datablok och överflödsblock överförs över nätverket. När fel uppstår i godtyckliga block (upp till ett visst antal block) kan data fortfarande överföras felfritt över nätverket. Reid-Solomon-koder, till exempel, används för datatransmission över optiska kommunikationslinjer och i satellitkommunikation.
* Det finns även överflödskoder där data inte delas upp i block, till exempel Hamming-koder och CRC-koder, som är vanligt förekommande för datatransmission i Ethernet-nätverk. Dessa är koder för felkorrigerande kodning och är avsedda för att upptäcka fel snarare än att korrigera dem (Hamming-koden tillåter också delvis korrigering av fel).
2. Reid-Solomon-koder
Reid-Solomon-koder är en av de mest spridda överflödskoderna, uppfunna redan på 1960-talet och som först fick stor användning på 1980-talet för massproduktion av CD-skivor.
Det finns två nyckelfrågor för att förstå Reid-Solomon-koder: 1) hur man skapar överflödsblock; 2) hur man återställer data med hjälp av överflödsblock. Låt oss hitta svar på dem.
För enkelhetens skull kommer vi att anta att n=6 och m=4. Andra scheman behandlas på liknande sätt.
Hur man skapar överflödsblock
Varje block av felkorrigeringskoder betraktas oberoende av de andra. För att räkna varje block används samtliga n datablokkar. I diagrammet nedan är X1-X6 datablokkar och P1–P4 är felkorrigeringsblocks.
Alla datablokkar måste vara samma storlek; för att justera kan nollbitar användas. De resulterande felkorrigeringsblocken kommer att ha samma storlek som datablokkarna. Alla datablokkar delas upp i ord (till exempel 16 bitar). Anta att vi delar upp datablokkarna i k ord. Då kommer alla felkorrigeringsblocker också att delas in i k ord.
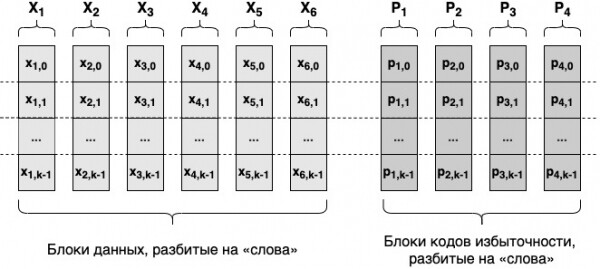
För att räkna i:e ordet i varje felkorrigeringsblock kommer i:e orden från alla datablokkar att användas. De kommer att beräknas enligt följande formel:
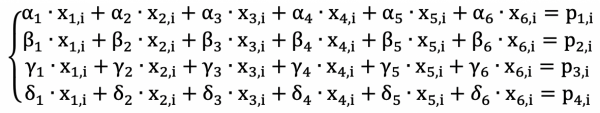
Här är värdena x = ord från datablokkar, p = ord från felkorrigeringsblock, alla alfa, beta, gamma och delta är speciellt valda tal, lika för alla i. Det måste genast sägas att alla dessa värden inte är vanliga tal, utan element i Galoisfältet, operationerna +, -, *, / - är inte de vi känner till, utan speciella operationer som införts över elementen i Galoisfältet.
Vad är Galoisfält till för
Det verkar enkelt: vi delar upp data i block, blocken i ord, med hjälp av orden från datablokkarna beräknar vi orden från felkorrigeringsblocken – vi får felkorrigeringsblock. I stort sett fungerar det så, men djävulen ligger i detaljerna:
- Som nämnts tidigare är ordstorleken fast, i vårt exempel 16 bitar. Formlerna ovan för Reed-Solomon-koder är sådana att när vanliga heltal används kan resultatet av beräkningen av p vara orepresenterbart med hjälp av ett ord av giltig storlek.
- Vid återställande av data kommer ovanstående formler att betraktas som ett system av ekvationer som måste lösas för att återställa data. Under lösningen kan det bli nödvändigt att utföra division av heltal med varandra, vilket ger ett reellt tal som inte kan representeras exakt i datorns minne.
Dessa problem gör att hela tal inte kan användas för Reed-Solomon-koder. Lösningen på problemet är originell och kan beskrivas på följande sätt: låt oss tänka ut speciella tal som kan representeras med ord av önskad längd (till exempel 16 bitar) och resultatet av alla operationer på dem (addition, subtraktion, multiplikation, division) också kommer att representeras i datorns minne med ord av önskad längd.
Dessa "speciella" tal har länge studerats inom matematik och kallas kroppar. En kropp är en mängd element med specifika operationer för addition, subtraktion, multiplikation och division.
Galois-kroppar* är kroppar där det finns ett entydigt resultat för varje operation (+, -, *, \/) för vilka som helst två element i kroppen. Galois-kroppar kan byggas för tal som är en potens av 2: 2, 4, 8, 16 och så vidare (i praktiken är vi dock bara intresserade av potenser av 2). Till exempel, för ord av storlek 16 bitar är detta en kropp som innehåller 65 536 element, för vilka man kan hitta resultatet av vilken operation (+, -, *, \/) som helst för varje par. Värdena x, p, alfa, beta, gamma, delta i ovanstående ekvationer kommer att betraktas som element av Galois-kroppen för beräkningarna.
Således har vi ett system av ekvationer, med hjälp av vilket vi kan bygga redundanta kodblock genom att skriva ett motsvarande datorprogram. Med hjälp av detta system av ekvationer kan vi också utföra datag återställning.
* Detta är ingen strikt definition, snarare en beskrivning.
Hur man återställer data
Återställning är nödvändig när en del av blocken är saknade från n + m block. Det kan vara antingen datablock eller redundanta kodblock. Frånvaro av datablock och/eller redundanta kodblock innebär att de motsvarande variablerna x och/eller p i ovanstående ekvationer är okända.
Ekvationerna för Reed-Solomon-koder kan betraktas som ett system av ekvationer, där alla värden alfa, beta, gamma, delta är konstanter, alla x och p som motsvarar tillgängliga block är kända variabler, medan de övriga x och p är okända.
Till exempel, låt oss anta att datablock 1, 2, 3 och redundanta kodblock 2 är otillgängliga, då kommer följande system av ekvationer att gälla för den i:te ordgruppen (okända markerade i rött):
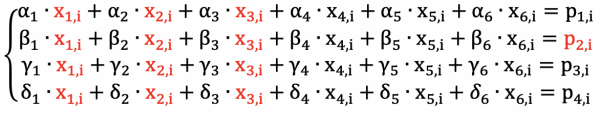
Vi har ett system med 4 ekvationer och 4 obekanta, vilket innebär att vi kan lösa det och återställa data!
Från detta ekvationssystem följer en rad slutsatser om datarader för Reed-Solomon-koder (n datablokkar, m redundanta kodblock):
- Data kan återställas vid förlust av vilket som helst av m block eller färre. Vid förlust av m+1 block eller fler kan data inte återställas: det går inte att lösa ett system med m ekvationer och m + 1 obekanta.
- För att återställa även ett enda datablock måste du använda vilka som helst n av de återstående blocken, samtidigt som du kan använda valfritt av redundanskoderna.
Vad mer behöver man veta
I beskrivningen ovan hoppar jag över en rad viktiga frågor, vars övervägande kräver en djupare fördjupning i matematiken. Särskilt pratar jag inte om följande:
- Ekvationssystemet för Reed-Solomon-koder måste ha (enligt) lösning för alla kombinationer av obekanta (inte mer än m obekanta). Baserat på detta krav väljs värdena alpha, beta, gamma och delta.
- Ekvationssystemet måste kunna byggas automatiskt (beroende på vilka block som är otillgängliga) och lösas.
- Det är nödvändigt att konstruera ett Galoisfält: för en given ordstorlek ska man kunna hitta resultatet av vilken operation som helst (+, -, *, /) för vilka två element som helst.
I slutet av artikeln finns hänvisningar till litteratur om dessa viktiga frågor.
Val av n och m
Hur väljer man n och m i praktiken? I praktiken används redundanskoder i datalagringssystem för att spara utrymme, så därför väljs m alltid mindre än n. Deras specifika värden beror på flera faktorer, inklusive:
- Tillförlitlighet i datalagring. Ju fler m, desto fler diskfel kan hanteras, vilket innebär högre pålitlighet.
- Överflödighet i lagring. Ju högre förhållande m / n, desto högre blir överflödigheten i lagringen och desto dyrare blir systemet.
- Bearbetningstid för förfrågningar. Ju större summa n + m, desto längre blir svarstiden på förfrågningar. Eftersom det för att läsa data (under återställning) krävs att läsa n block som lagras på n olika diskar, kommer läsningstiden att bestämmas av den långsammaste disken.
Dessutom innebär lagring av data i flera datacenter ytterligare begränsningar för valet av n och m: när ett datacenter är urkopplat måste data fortfarande vara läsbara. Till exempel, vid lagring av data i 3 datacenter måste villkoret hållas: m >= n/2, annars kan situationer uppstå där data inte är läsbara när ett datacenter är urkopplat.
3. LRC — Lokala Rekonstruktionskoder
För att återställa data med hjälp av Reed-Solomon-koder måste n godtyckliga datablokkar användas. Detta är en mycket betydande nackdel för distribuerade datalagringssystem, eftersom för att återställa data på en trasig disk måste data läsas från majoriteten av de övriga, vilket skapar betydande extra belastning på diskar och nätverk.
De vanligaste felen är otillgänglighet av en datablokk på grund av en trasig eller överbelastad disk. Kan man på något sätt minska den överflödiga belastningen för dataräddning i ett sådant (vanligast förekommande) fall? Det visar sig att det går: just för detta finns det redundanskodning i form av LRC.
LRC (Lokala Rekonstruktionskoder) är redundanskoder som uppfanns av Microsoft för användning i Windows Azure Storage. Idén med LRC är mycket enkel: dela alla datablokkar i två (eller fler) grupper och beräkna en del av redundanskoderna för varje grupp separat. Då kommer en del av kodblocken för redundans att beräknas med hjälp av alla datablokkar (i LRC kallas de globala redundanskoder), medan en del beräknas med hjälp av en av de två grupperna av datablokkar (de kallas lokala redundanskoder).
LRC betecknas med tre siffror: n-r-l, där n är antalet datablokkar, r är antalet globala redundanskoder, l är antalet lokala redundanskoder. För att läsa data när en datablokk är otillgänglig behöver man bara läsa n/l blokkar — detta är l gånger mindre än med Reed-Solomon-koder.
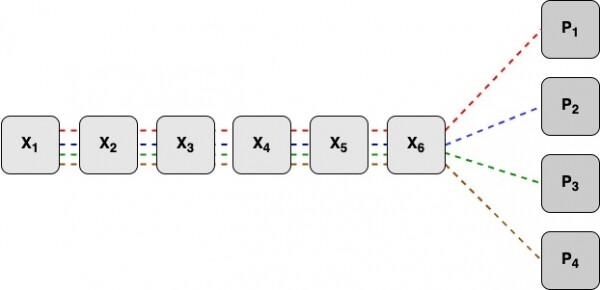
För att ge ett exempel, betrakta LRC-schemat 6-2-2. X1–X6 är 6 datablokkar, P1, P2 är 2 globala redundanskoder, P3, P4 är 2 lokala redundanskoder.
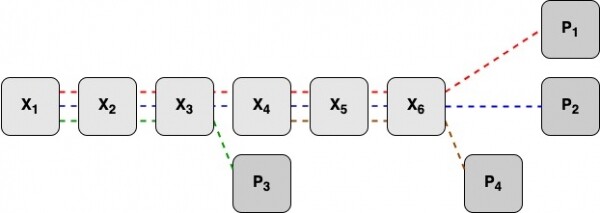
Redundansblocken P1, P2 beräknas med hjälp av alla datablokkar. Redundansblocket P3 beräknas med hjälp av datablokkarna X1–X3, redundansblocket P4 beräknas med hjälp av datablokkarna X4–X6.
Det övriga görs i LRC på liknande sätt som med Reed-Solomon-koder. Ekvationerna för att räkna orden i överskottskodblocken kommer att vara sådana:
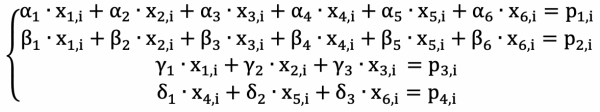
För att välja siffrorna alfa, beta, gamma, delta måste en rad villkor uppfyllas som säkerställer möjlighet att återställa data (dvs. att lösa ekvationssystemet). Mer om dem kan läsas i .
I praktiken används också XOR-operationen för att räkna lokala överskottkoder P3, P4.
Från ekvationssystemet för LRC följer flera slutsatser:
- För att återställa vilket 1 datablok som helst räcker det att läsa n/l block (n/2 i vårt exempel).
- Om r + l block är otillgängliga, och alla block ingår i en grupp, kan data inte återställas. Detta kan enkelt förklaras med ett exempel. Låt oss säga att blocken X1–X3 och P3 är otillgängliga: detta är r + l block från en grupp, 4 i vårt fall. Då har vi ett system med 3 ekvationer och 4 okända, vilket inte går att lösa.
- I alla andra fall av otillgänglighet av r + l block (när minst 1 block från varje grupp är tillgängligt) kan data återställas i LRC.
Således överträffar LRC Reed-Solomon-koderna när det gäller dataräddning efter enkla fel. I Reed-Solomon-koder krävs att även ett block av data återställs genom att använda n block, medan för att återställa ett block av data i LRC räcker det att använda n/l block (n/2 i vårt exempel). Å andra sidan, LRC förlorar mot Reed-Solomon-koderna när det gäller maximalt antal tillåtna fel. I de tidigare exemplen kan Reed-Solomon-koder återställa data vid upp till 4 fel, medan det för LRC finns 2 kombinationer av 4 fel där data inte kan återställas.
Vad som är viktigast beror på den specifika situationen, men ofta väger den besparing av överskottsbelastning som LRC erbjuder tyngre än den något lägre lagringssäkerheten.
4. Andra överskottkoder
Förutom Reed-Solomon-koder och LRC finns det många andra överskottkoder. Olika överskottkoder använder olika matematik. Här är några andra överskottkoder:
- Överskottkod med hjälp av XOR-operatorn. XOR-operationen utförs över n datablock, och en överskottskodblock genereras, det vill säga schema n+1 (n datablock, 1 överskottskod). Används i , där datablock och överskottskoder cykliskt skrivs på alla diskar i arrayen.
- Even-odd-algoritmen, baserat på XOR-operationen. Möjliggör skapandet av 2 block av redundanta koder, dvs n+2-schema.
- STAR-algoritmen, baserat på XOR-operationen. Gör det möjligt att bygga 3 block av redundanta koder, dvs n+3-schema.
- Pyramidkoder — ytterligare redundanta koder från Microsoft.
5. Användning inom Yandex
En rad infrastrukturella projekt från Yandex använder redundanta koder för säker datalagring. Här är några exempel:
- Det interna objektlagret MDS, som jag nämnde i början av artikeln.
- — Yandexs MapReduce-system.
- (Yandex DataBase) — en distribuerad newSQL-databas.
I MDS används LRC-redundanskoder, 8-2-2-schema. Data med redundanskoder skrivs på 12 olika diskar på olika servrar i 3 olika datacenter: 4 servrar i varje datacenter. Läs mer om detta i .
I YT används både Reed-Solomon-koder (6-3-schema), som var de första som implementerades, samt LRC-redundanskoder (12-2-2-schema), där LRC är den föredragna lagringsmetoden.
I YDB används redundanskoder baserade på even-odd (4-2-schema). Redundanskoderna i YDB har redan .
Användningen av olika redundanskodescheman beror på de olika kraven som ställs på systemen. Till exempel, i MDS placeras data som lagras med LRC omedelbart i 3 datacenter. Det är viktigt för oss att data förblir tillgängliga för läsning även om 1 datacenter går ner, därför måste blocken distribueras över datacentren så att antalet otillgängliga block inte överskrider det tillåtna vid nedläggning av något datacenter. I 8-2-2-schemat kan 4 block placeras i varje datacenter, så att om något datacenter stängs av, kommer 4 block att vara otillgängliga och data kan fortfarande läsas. Oavsett vilket schema vi väljer när vi placerar i 3 datacenter, måste det alltid vara (r + l) / n >= 0,5, vilket betyder att lagringsredundansen kommer att vara minst 50%.
I YT är situationen annorlunda: varje YT-kluster ligger helt inom 1 datacenter (olika kluster i olika datacenter), därför finns det inga sådana begränsningar där. 12-2-2-schemat ger en redundans på 33%, vilket gör att data kan lagras billigare, samtidigt som de kan klara av upp till 4 samtidiga diskavbrott, precis som schemat i MDS.
Det finns fortfarande många särdrag kring användningen av redundanskoder i lagrings- och databehandlingssystem: nyanser av dataräddning, inverkan av återställning på svarstider, särskilda aspekter av dataskrivning osv. Jag planerar att berätta mer om dessa och andra särdrag av tillämpning av redundanskoder i praktiken om ämnet är av intresse.
6. Länkar
- Serien artiklar om Reed-Solomon-koder och Galois-fält:
I dem behandlas matematiken mer ingående på ett lättförståeligt sätt. - Artikel från Microsoft om LRC:
I avsnitt 2 förklaras teorin kort, och därefter behandlas erfarenheter av LRC i praktiken. - Even-odd-schema:
- STAR-schema:
- Pyramidkoder:
- Redundanskoder i MDS:
- Redundanskoder i YT:
- Redundanskoder i YDB:
Källa: habr.com
