

För en tid sedan stod vi inför valet av ett ETL-verktyg för arbete med Big Data. Den tidigare använda lösningen Informatica BDM var inte tillfredsställande på grund av dess begränsade funktionalitet. Användningen begränsades till ett ramverk för att köra spark-submit-kommandon. Det fanns inte så många analoger på marknaden som egentligen kunde hantera den datamängd som vi arbetar med varje dag. I slutändan valde vi Ab Initio. Under pilotdemonstrationer visade produkten mycket hög hastighet vid databehandling. Det finns nästan ingen information om Ab Initio på ryska, därför beslutade vi att dela med oss av vår erfarenhet på Habr.
Ab Initio har många klassiska och ovanliga transformationer, vars kod kan utvidgas med hjälp av sitt eget språk PDL. För små företag kan ett så kraftfullt verktyg vara överflödigt, och de flesta av dess funktioner kan visa sig vara dyra och oanvändbara. Men om din verksamhet närmar sig storleken på Sberbank, kan Ab Initio vara intressant för er.
Det hjälper företag att globalt samla kunskap och utveckla ekosystemet, och för utvecklare ger det möjlighet att förbättra sina färdigheter inom ETL, fördjupa sina kunskaper i shell, ger möjlighet att lära sig PDL-språket, erbjuder en visuell bild av inläsningsprocesserna, och förenklar utvecklingen genom ett överflöd av funktionskomponenter.
I detta inlägg kommer jag att berätta om möjligheterna med Ab Initio och ge jämförande egenskaper för dess arbete med Hive och GreenPlum.
- Beskrivning av ramverket MDW och arbeten med dess anpassning för GreenPlum
- Jämförande prestandakarakteristika för Ab Initio i arbetet med Hive och GreenPlum
- Arbete med Ab Initio och GreenPlum i Near Real Time-läget
Funktionaliteten hos denna produkt är mycket bred och kräver gott om tid för att lära sig. Men med rätt arbetsfärdigheter och optimala inställningar kan databehandlingsresultaten vara mycket imponerande. Användningen av Ab Initio kan ge utvecklaren en intressant erfarenhet. Det erbjuder ett nytt perspektiv på ETL-utveckling, en hybrid mellan visuell miljö och utveckling av inläsningar med ett skriptliknande språk.
Företag utvecklar sina ekosystem och det här verktyget kommer som en aldrig tidigare skådad hjälp. Med hjälp av Ab Initio kan man samla kunskap om den aktuella affärsverksamheten och använda denna kunskap för att expandera gamla och öppna nya affärsmöjligheter. Alternativ till Ab Initio inkluderar de visuella utvecklingsmiljöerna Informatica BDM och de icke-visuella miljöerna – Apache Spark.
Beskrivning av Ab Initio
Ab Initio, precis som andra ETL-verktyg, är en uppsättning produkter.
Ab Initio GDE (Graphical Development Environment) är en miljö för utvecklare där de konfigurerar datatransformationer och kopplar dem med datastreams i form av pilar. En sådan uppsättning transformationer kallas ett graf:
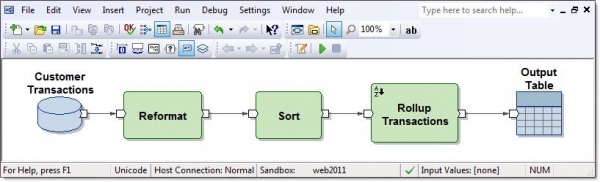
In- och utgångsanslutningar för funktionella komponenter är portar och innehåller fält som beräknas inom transformationerna. Flera grafer, sammankopplade med strömmar i form av pilar i den ordning de utförs, kallas en plan.
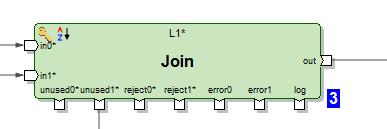
Det finns flera hundra funktionella komponenter, vilket är mycket. Många av dem är smal specialiserade. Möjligheterna för klassiska transformationer i Ab Initio är bredare än i andra ETL-verktyg. Till exempel har Join flera utgångar. Utöver resultatet av sammankopplingen av dataset kan man få ut poster från de inmatade dataset vars nycklar inte kunde koblas samman. Man kan också få rejects, errors och loggar från transformationens arbete, som kan läsas i samma graf som en textfil och bearbetas med andra transformationer:
Eller, som exempel, kan man materialisera datamottagaren i form av en tabell och läsa data från den i samma graf.
Det finns unika transformationer. Till exempel har transformationen Scan funktioner som liknar analytiska funktioner. Det finns transformationer med beskrivande namn: Create Data, Read Excel, Normalize, Sort within Groups, Run Program, Run SQL, Join with DB och fler. Grafer kan använda parametrar för körningen, inklusive överföring av parametrar från operativsystemet eller till operativsystemet. Filer med en färdig uppsättning parametrar som överförs till grafen kallas parameter sets (psets).
Som sig bör har Ab Initio GDE sitt eget repository, benämnt EME (Enterprise Meta Environment). Utvecklare har möjlighet att arbeta med lokala versioner av koden och checka in sina utvecklingar i det centrala repositoryt.
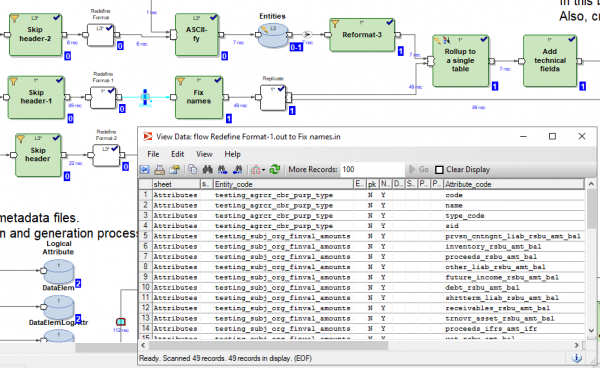
Det finns möjlighet att under körning eller efter att grafen har körts klicka på vilket som helst anslutande transformationsflöde och se data som har passerat mellan dessa transformationer:
Det finns också möjlighet att klicka på vilket som helst flöde och se spårningsdetaljer – hur många paralleller transformationen har arbetat med, hur många rader och byte som laddades i vilken av parallellerna:
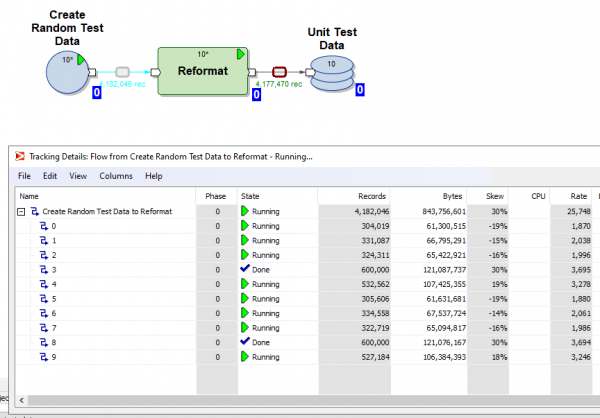
Det finns möjlighet att dela upp körningen av grafen i faser och markera vilka transformationer som ska utföras först (i nollfasen), följande i första fasen, nästa i andra fasen etc.
Varje transformation kan välja en så kallad layout (var den ska köras): utan paralleller eller i parallella flöden, vars antal kan anges. Temporära filer som Ab Initio skapar under transformationsarbetet kan placeras antingen i filsystemet servern, eller i HDFS.
I varje transformation baserad på en standardmall kan man skapa sitt eget skript på PDL-språket, som påminner lite om shell.
Med hjälp av PDL-språket kan du utöka funktionaliteten för transformationerna och specifikt kan du dynamiskt (under körning) generera godtyckliga kodfragment beroende på körningsparametrarna.
Ab Initio har också bra integration med operativsystemet via shell. Specifikt används linux ksh på Sberbank. Man kan utbyta variabler med shell och använda dem som parametrar för grafer. Man kan anropa körningen av Ab Initio-grafen från shell och administrera Ab Initio.
Förutom Ab Initio GDE levereras många andra produkter. Det finns sin egen Co>Operation System som gör anspråk på att vara ett operativsystem. Det finns Control>Center, där man kan schemalägga och övervaka laddningsflöden. Det finns produkter för att utföra utveckling på en mer primitiv nivå än vad Ab Initio GDE tillåter.
Beskrivning av ramverket MDW och arbeten med dess anpassning för GreenPlum
Tillsammans med sina produkter levererar leverantören produkten MDW (Metadata Driven Warehouse), som är en grafkonfigurator avsedd att hjälpa till med typiska uppgifter för att fylla datalager eller data vaults.
Den innehåller användardefinierade (projektspecifika) metadata-parse och färdiga kodgeneratorer “ur lådan”.
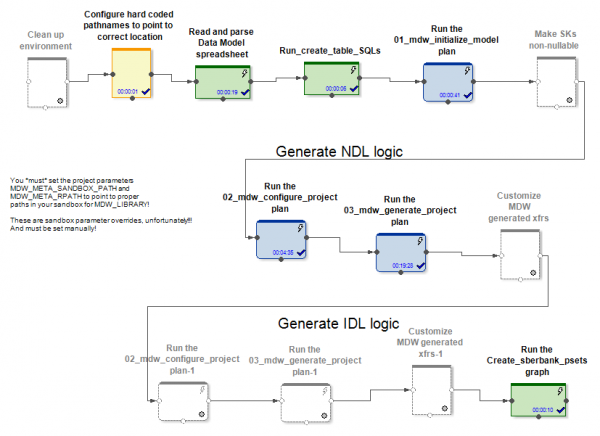
MDW tar emot en datamodell, en konfigurationsfil för anslutning till databasen (Oracle, Teradata eller Hive) och några andra inställningar. Projekt-specifika delar, som att distribuera modellen i databasen, hanteras också. Produktens standarddel genererar grafer och konfigurationsfiler för dem när data laddas in i modellens tabeller. Grafer (och psets) skapas för flera lägen av initierande och inkrementell uppdatering av entiteter.
För Hive och RDBMS genereras olika grafer för initierande och inkrementell datauppdatering.
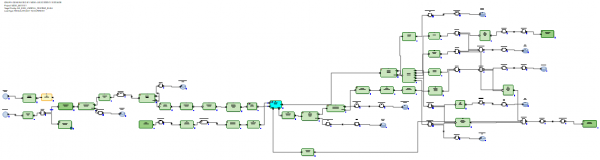
I fallet med Hive så kopplas de inkommande delta-data ihop med data som fanns i tabellen innan uppdateringen genom Ab Initio Join. Datainladdare i MDW (både i Hive och RDBMS) injicerar inte bara nya data från delta, utan stänger också av perioder av datavaliditet baserat på de primära nycklar som delta-data har kommit in via. Dessutom måste den oförändrade datadelen skrivas om. Men detta är nödvändigt eftersom Hive inte har delete- eller update-operationer.
I fallet RDBMS ser graferna för inkrementell datauppdatering mer optimala ut eftersom RDBMS faktiskt har uppdateringsmöjligheter.
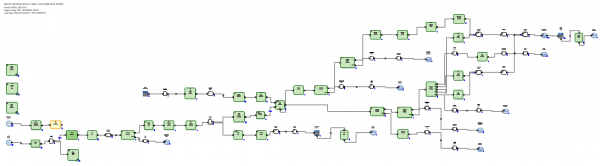
Det inkommande delta laddas in i en mellanliggande tabell i databasen. Därefter kopplas delta ihop med data som fanns i tabellen innan uppdateringen, och detta görs med hjälp av SQL via en genererad SQL-fråga. Sedan utförs en insert av nya data från delta till den måltabellen och perioderna för datavaliditet baserat på de primära nycklar som delta-data har kommit in via, stängs av med SQL-kommandon delete+insert.
Det finns ingen anledning att skriva om oförändrad data.
Därmed drar vi slutsatsen att när det gäller Hive, så måste MDW gå till att skriva om hela tabellen eftersom Hive inte har någon uppdateringsfunktion. Inga bättre metoder för full dataskrivning vid uppdatering har hittats. I fallet med RDBMS, däremot, beslöt produktens skapare att överlåta ansvaret för koppling och uppdatering av tabeller till användningen av SQL.
För projektet på Sberbank skapade vi en ny, återanvändbar implementering av databasladdaren för GreenPlum. Detta baserades på den version som MDW genererar för Teradata. Just Teradata, inte Oracle, passade bäst och var närmast, eftersom det också är ett MPP-system. Arbetsmetoder samt syntaxen för Teradata och GreenPlum visade sig vara liknande.
Exempel på kritiska skillnader för MDW mellan olika RDBMS är följande. I GreenPlum, till skillnad från Teradata, måste en klausul skrivas vid skapande av tabeller.
distributed byI Teradata skriver man
ta bort <table> all, medan i GreenPlum skriver man
ta bort från <table>I Oracle skriver man för att optimera
delete from t where rowid in (), medan i Teradata och GreenPlum skriver man
delete from t where exists (select * from delta where delta.pk=t.pk)Vi noterade också att för att Ab Initio skulle fungera med GreenPlum krävdes installation av GreenPlum-klienten på alla noder i Ab Initio-klustret. Detta berodde på att vi anslöt oss till GreenPlum samtidigt från alla noder i vårt kluster. För att möjliggöra parallell läsning från GreenPlum, så att varje parallell ström av Ab Initio skulle läsa sin portion data från GreenPlum, var vi tvungna att införa en konstruktion som Ab Initio förstår i sektionen «where» i SQL-frågorna.
where ABLOCAL()och definiera värdet av denna konstruktion genom att ange parameter för databasinläsande transformationer
ablocal_expr=«string_concat("mod(t.", string_filter_out("{$TABLE_KEY}","{}"), ",", (decimal(3))(number_of_partitions()),")=", (decimal(3))(this_partition()))», vilket kompileras till något liknande
mod(sk,10)=3, det vill säga vi måste ge GreenPlum ett explicit filter för varje partition. För andra databaser (Teradata, Oracle) kan Ab Initio automatiskt utföra denna parallellisering.
Jämförande prestandakarakteristika för Ab Initio i arbetet med Hive och GreenPlum
På Sberbank genomfördes ett experiment för att jämföra prestanda av de genererade MDW-grafarna i förhållande till Hive och GreenPlum. Inom ramen för experimentet fanns det 5 noder för Hive i samma kluster som Ab Initio, medan det för GreenPlum fanns 4 noder på ett separat kluster. Det vill säga, Hive hade en viss fördel över GreenPlum vad gäller hårdvaran.
Två par grafar som utförde samma datauppdateringsuppgift i Hive och GreenPlum granskades. Dessa kördes med grafar som genererats av MDW-konfiguratorn:
- initiell laddning + inkrementell laddning av slumpmässigt genererade data till en Hive-tabell
- initiell laddning + inkrementell laddning av slumpmässigt genererade data till en liknande GreenPlum-tabell
I båda fallen (Hive och GreenPlum) kördes dataladdningar i 10 parallella strömmar på samma Ab Initio-kluster. Intermediära data för beräkningarna sparades i HDFS (i termer av Ab Initio användes MFS layout using HDFS). En rad slumpmässigt genererade data tog i båda fallen 200 byte.
Resultatet blev följande:
Hive:
Initierande laddning i Hive
Satts in rader
6 000 000
60 000 000
600 000 000
Varaktighet av den initierande
laddningen i sekunder
41
203
1 601
Inkrementell laddning i Hive
Antal rader som fanns i
måltabellen vid experimentets början
6 000 000
60 000 000
600 000 000
Antal delta-rader som tillämpades på
måltabellen under experimentet
6 000 000
6 000 000
6 000 000
Varaktighet av den inkrementella
laddningen i sekunder
88
299
2 541
GreenPlum:
Initierande laddning i GreenPlum
Satts in rader
6 000 000
60 000 000
600 000 000
Varaktighet av den initierande
laddningen i sekunder
72
360
3 631
Inkrementell laddning i GreenPlum
Antal rader som fanns i
måltabellen vid experimentets början
6 000 000
60 000 000
600 000 000
Antal delta-rader som tillämpades på
måltabellen under experimentet
6 000 000
6 000 000
6 000 000
Varaktighet av den inkrementella
laddningen i sekunder
159
199
321
Vi ser att hastigheten på den initierande laddningen, både i Hive och GreenPlum, linjärt beror på datamängden och på grund av bättre hårdvara är den något snabbare för Hive än för GreenPlum.
Den inkrementella laddningen i Hive beror också linjärt på mängden tidigare inlästa data i måltabellen och går ganska långsamt i takt med att volymen ökar. Detta orsakas av behovet av att skriva om hela måltabellen. Det betyder att tillämpningen av små förändringar på stora tabeller – inte är ett särskilt bra användningsalternativ för Hive.
Den inkrementella laddningen i GreenPlum beror svagt på mängden tidigare inlästa data i måltabellen och går ganska snabbt. Detta beror på SQL Joins och GreenPlums arkitektur, som tillåter delete-operationer.
Således injicerar GreenPlum delta med delete+insert-metoden, medan det inte finns några delete- eller update-operationer i Hive, vilket innebär att hela datamängden vid inkrementell uppdatering var tvungen att skrivas om helt. Det mest exempelaktiga jämförelsen av de fetmarkerade cellerna, eftersom de motsvarar det vanligaste användningsalternativet för resurskrävande laddningar. Vi ser att GreenPlum vann över Hive i detta test med 8 gånger.
Arbete med Ab Initio och GreenPlum i Near Real Time-läget
I detta experiment kommer vi att undersöka möjligheten för Ab Initio att uppdatera GreenPlum-tabellen med slumpmässigt genererade datamängder i ett läge som är nära realtidsbehandling. Vi kommer att titta på GreenPlum-tabellen dev42_1_db_usl.TESTING_SUBJ_org_finval, som kommer att arbete med.
Vi kommer att använda tre Ab Initio-grafer för att arbeta med den:
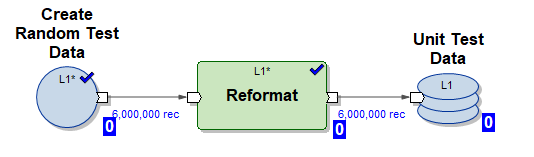
1) Graf Create_test_data.mp – skapar i 10 parallella flöden filer med data i HDFS med 6 000 000 rader. Data är slumpmässiga, deras struktur är organiserad för insättning i vår tabell.
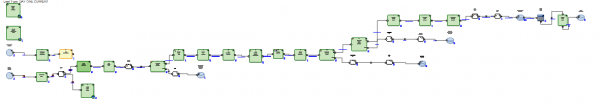
2) Graf mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset – genererad MDW graf för initierande insättning av data i vår tabell i 10 parallella flöden (testdata som genererats av graf (1) används).
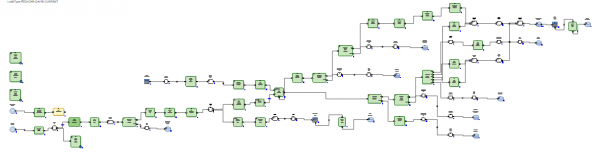
3) Graf mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset – genererad MDW graf för inkrementell uppdatering av vår tabell i 10 parallella flöden med användning av en portion färska inkommande data (delta), genererade av graf (1).
Vi kommer att utföra det nedanstående scenariot i NRT-läge:
- generera 6 000 000 testrader.
- utföra initierande laddning och sätta in 6 000 000 testrader i en tom tabell.
- upprepa inkrementell laddning 5 gånger.
- generera 6 000 000 testrader.
- utföra inkrementell insättning av 6 000 000 testrader i tabellen (vid detta tillfälle sätts gammal data med ett utgångsdatum valid_to_ts och mer färsk data med samma primära nyckel sätts in).
Detta scenario emulerar läget för verkligt arbete i ett affärssystem – en tillräckligt stor portion nya data dyker upp i realtid och flödar in i GreenPlum.
Nu ser vi loggen för scenariets arbete:
Starta Create_test_data.input.pset vid 2020-06-04 11:49:11.
Avsluta Create_test_data.input.pset vid 2020-06-04 11:49:37.
Starta mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset vid 2020-06-04 11:49:37.
Avsluta mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset vid 2020-06-04 11:50:42.
Starta Create_test_data.input.pset vid 2020-06-04 11:50:42.
Avsluta Create_test_data.input.pset vid 2020-06-04 11:51:06.
Starta mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset vid 2020-06-04 11:51:06.
Avsluta mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset vid 2020-06-04 11:53:41.
Starta Create_test_data.input.pset vid 2020-06-04 11:53:41.
Avsluta Create_test_data.input.pset vid 2020-06-04 11:54:04.
Starta mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset vid 2020-06-04 11:54:04.
Avsluta mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset vid 2020-06-04 11:56:51.
Starta Create_test_data.input.pset vid 2020-06-04 11:56:51.
Avsluta Create_test_data.input.pset vid 2020-06-04 11:57:14.
Starta mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset vid 2020-06-04 11:57:14.
Avsluta mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset vid 2020-06-04 11:59:55.
Starta Create_test_data.input.pset vid 2020-06-04 11:59:55.
Avsluta Create_test_data.input.pset vid 2020-06-04 12:00:23.
Starta mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset vid 2020-06-04 12:00:23.
Avsluta mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset vid 2020-06-04 12:03:23.
Starta Create_test_data.input.pset vid 2020-06-04 12:03:23.
Avsluta Create_test_data.input.pset vid 2020-06-04 12:03:49.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:03:49
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:06:46
Det ser ut så här:
Diagram
Starttid
Sluttid
Längd
Create_test_data.input.pset
04.06.2020 11:49:11
04.06.2020 11:49:37
00:00:26
mdw_load.day_one.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:49:37
04.06.2020 11:50:42
00:01:05
Create_test_data.input.pset
04.06.2020 11:50:42
04.06.2020 11:51:06
00:00:24
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:51:06
04.06.2020 11:53:41
00:02:35
Create_test_data.input.pset
04.06.2020 11:53:41
04.06.2020 11:54:04
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:54:04
04.06.2020 11:56:51
00:02:47
Create_test_data.input.pset
04.06.2020 11:56:51
04.06.2020 11:57:14
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:57:14
04.06.2020 11:59:55
00:02:41
Create_test_data.input.pset
04.06.2020 11:59:55
04.06.2020 12:00:23
00:00:28
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:00:23
04.06.2020 12:03:23
00:03:00
Create_test_data.input.pset
04.06.2020 12:03:23
04.06.2020 12:03:49
00:00:26
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:03:49
04.06.2020 12:06:46
00:02:57
Vi ser att 6 000 000 rader av inkrementet behandlas på 3 minuter, vilket är ganska snabbt.
Data i måltabellen har delats upp på följande sätt:
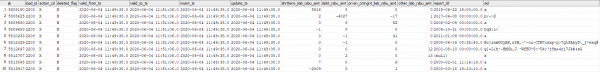
select valid_from_ts, valid_to_ts, count(1), min(sk), max(sk) from dev42_1_db_usl.TESTING_SUBJ_org_finval group by valid_from_ts, valid_to_ts order by 1,2; 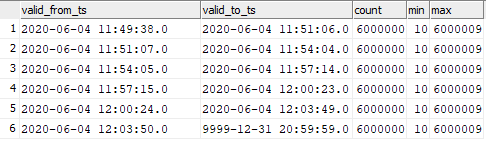
Man kan se överensstämmelsen mellan de insatta uppgifterna och tidpunkterna för grafstart.
Det innebär att man kan köra en inkrementell dataladdning i GreenPlum med Ab Initio med mycket hög frekvens och observera en hög hastighet på insättning av dessa data i GreenPlum. Självklart är det inte möjligt att köra varje sekund, eftersom Ab Initio, liksom alla ETL-verktyg, kräver tid för att "komma igång".
Slutsats
För närvarande används Ab Initio på Sberbank för att bygga en enhetlig semantisk datalager (ESL). Detta projekt innebär att skapa en enhetlig version av tillståndet för olika bankaffärsenheter. Informationen kommer från olika källor, vars repliker förbereds på Hadoop. Beroende på affärens behov förbereds en datamodell och datatransformationer beskrivs. Ab Initio laddar informationen i ESL och de laddade uppgifterna är inte bara av intresse för verksamheten i sig, utan fungerar också som källa för att bygga datavitriner. Samtidigt gör produktens funktionalitet det möjligt att använda olika system som mottagare (Hive, Greenplum, Teradata, Oracle), vilket möjliggör att förbereda data för verksamheten i olika önskade format utan större ansträngning.
Möjligheterna med Ab Initio är omfattande, till exempel ger det medföljande MDW-ramverket möjligheten att bygga teknisk och affärshistorik för data "ur lådan". För utvecklare ger Ab Initio möjligheten att "inte uppfinna hjulet", utan att använda många befintliga funktionella komponenter, som i grunden är bibliotek som behövs vid arbete med data.
Författaren är expert inom det professionella samfundet Sberbank SberProfi DWH/BigData. Det professionella SberProfi DWH/BigData-samhället ansvarar för utvecklingen av kompetenser inom områden som Hadoop-ekosystemet, Teradata, Oracle DB, GreenPlum samt BI-verktyg som Qlik, SAP BO, Tableau och andra.
Källa: habr.com
