

Jag skulle vilja berätta om en intressant mekanism för arbetet med konfigurationen av ett distribuerat system. Konfigurationen presenteras direkt i ett kompilert språk (Scala) med hjälp av säkra typer. I detta inlägg analyseras ett exempel på en sådan konfiguration och olika aspekter av att integrera kompilérbar konfiguration i den övergripande utvecklingsprocessen.
()
Introduktion
Att bygga ett pålitligt distribuerat system innebär att korrekt konfiguration används på alla noder, synkroniserad med andra noder. Vanligtvis används DevOps-teknologier (terraform, ansible eller liknande) för automatisk generering av konfigurationsfiler (ofta specifika för varje nod). Vi vill också vara säkra på att identiska protokoll används på alla interagerande noder (inklusive samma version). Annars kommer det att finnas inkompatibilitet i vårt distribuerade system. I JVM-världen är en konsekvens av detta krav att samma version av biblioteket som innehåller protokollmeddelanden måste användas överallt.
Vad sägs om testning av det distribuerade systemet? Självklart förutsätter vi att alla komponenter har enhetstester innan vi går vidare till integrationstester. (För att vi ska kunna extrapolera testresultaten till runtime måste vi också säkerställa att samma uppsättning bibliotek används i både test- och runtime.)
När vi arbetar med integrationstester är det ofta enklare att använda en enhetlig classpath på alla noder. Vi behöver bara se till att samma classpath används även i runtime. (Även om det är möjligt att köra olika noder med olika classpaths, leder det till en komplicerad konfiguration och svårigheter med distribution och integrationstester.) I detta inlägg utgår vi ifrån att samma classpath kommer att användas på alla noder.
Konfigurationen utvecklas tillsammans med applikationen. För att identifiera olika stadier i programmens utveckling använder vi versioner. Det verkar även logiskt att identifiera olika versioner av konfigurationer. Själva konfigurationen kan placeras i ett versionshanteringssystem. Om det i produktionen finns en enda konfiguration kan vi helt enkelt använda versionsnumret. Men om flera produktionsinstanser används behöver vi flera
konfigurationsgrenar och en extra märkning utöver versionen (till exempel grenens namn). På så sätt kan vi entydigt identifiera den exakta konfigurationen. Varje konfigurationsidentifierare motsvarar entydigt en viss kombination av distribuerade noder, portar, externa resurser och versioner av bibliotek. Inom ramen för detta inlägg utgår vi från att det bara finns en gren och att vi kan identifiera konfigurationen på vanligt sätt med tre siffror separerade med punkter (1.2.3).
I moderna miljöer skapas konfigurationsfiler manuellt ganska sällan. Oftare genereras de under distributionen och rörs knappt vid igen (för att ). Det uppstår en legitim fråga: varför använder vi fortfarande textformat för att lagra konfiguration? Ett helt livskraftigt alternativ ser ut att vara att använda vanlig kod för konfiguration och få fördelar genom kontroller vid kompilering.
I detta inlägg utforskar vi idén om att representera konfigurationen inuti det kompilerade artefaktet.
Kompilerad konfiguration
I detta avsnitt beskrivs ett exempel på statisk kompilerad konfiguration. Två enkla tjänster implementeras - en echo-tjänst och en klient för echo-tjänsten. Baserat på dessa två tjänster byggs två alternativ av systemet. I det ena alternativet ligger båda tjänsterna på en nod, i det andra alternativet - på olika noder.
En distribuerad tjänst innehåller vanligtvis flera noder. Noder kan identifieras med hjälp av värden av en viss typ NodeId:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
eller
case class NodeId(hostName: String)eller till och med
object Singleton
type NodeId = Singleton.type
Noder utför olika roller, tjänster körs på dem och TCP/HTTP-förbindelser kan etableras mellan dem.
För att beskriva TCP-anslutningen behöver vi åtminstone ett portnummer. Vi vill också återspegla den protokoll som stöds på denna port för att säkerställa att både klienten och servern använder samma protokoll. Vi kommer att beskriva anslutningen med hjälp av en sådan klass:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])w Port — bara ett heltal Int med angivande av ett intervall av tillåtna värden:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Förfinade typer
Se biblioteket och . Kort sagt, biblioteket gör det möjligt att lägga till begränsningar till typer, som kontrolleras vid kompileringen. I detta fall är de tillåtna värdena för portnumret hela 16-bitarsnummer. För den kompilerade konfigurationen är det inte obligatoriskt att använda biblioteket refined, men det förbättrar kompilatorns förmåga att kontrollera konfigurationen.
För HTTP (REST) protokoll, förutom portnumret kan vi också behöva sökvägen till tjänsten:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Fantomtyper
För att identifiera protokollet vid kompilering använder vi en typparameter som inte används inom klassen. Denna lösning beror på att vi inte använder en instans av protokollet vid runtime, men vi vill att kompilatorn ska kontrollera protokollens kompatibilitet. Genom att ange protokollet kan vi inte överföra en olämplig tjänst som ett beroende.
Ett av de vanligaste protokollen är REST API med JSON-serielisering:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]w RequestMessage — begärningstyp, ResponseMessage — svarstyp.
Självklart kan andra protokollbeskrivningar användas som ger den nödvändiga noggrannheten i beskrivningen.
För syftet av detta inlägg kommer vi att använda en förenklad version av protokollet:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Här representerar begäran en sträng som läggs till i URL:en, och svaret är den sträng som returneras i kroppen av HTTP-svaret.
Tjänstekonfigurationen beskrivs av tjänstens namn, portar och beroenden. Dessa element kan representeras i Scala på flera sätt (till exempel HList-ar, algebraiska datatyper). För syftet av detta inlägg kommer vi att använda Cake Pattern och representera moduler med hjälp av trait(Cake Pattern är inte en obligatorisk del av den beskrivna metoden. Det är bara en av de potentiella implementationerna.)
Beroenden mellan tjänster kan representeras som metoder som returnerar portar EndPointför andra noder:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
För att skapa en eko-tjänst krävs endast portnumret och angivelsen att denna port stöder eko-protokollet. Vi skulle kunna avstå från att ange en specifik port, eftersom traits tillåter oss att deklarera metoder utan implementation (abstrakta metoder). I så fall skulle kompilatorn kräva att vi tillhandahåller en implementation av den abstrakta metoden och ange portnumret i den specifika konfigurationen. Eftersom vi har implementerat metoden kan vi vid skapandet av den specifika konfigurationen avstå från att ange en annan port. Standardvärdet kommer att användas.
I klientkonfigurationen deklarerar vi beroendet av eko-tjänsten:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Beroendet har samma typ som den exporterade tjänsten echoService. Särskilt i eko-klienten kräver vi samma protokoll. Så vid sammankoppling av två tjänster kan vi vara säkra på att allt kommer att fungera korrekt.
Implementering av tjänster
För att starta och stoppa tjänsten krävs en funktion. (Möjligheten att stoppa tjänsten är avgörande för testning.) Återigen finns det flera alternativ för att implementera en sådan funktion (till exempel skulle vi kunna använda typklasser baserat på konfigurationstypen). För ändamålet med detta inlägg kommer vi att använda Cake Pattern. Vi kommer att representera tjänsten med hjälp av klassen cats.Resource, eftersom denna klass redan har medel för säker och garanterad frigöring av resurser vid problem. För att få resursen måste vi tillhandahålla konfigurationen och en färdig runtime-kontext. Funktionen för att starta tjänsten kan se ut på följande sätt:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
w
Konfigurera— konfigurationstyp för denna tjänstAddressResolver— runtime-objekt som möjliggör att ta reda på adresserna till andra noder (se nedan)
och andra typer från biblioteket cats:
F[_]— effektens typ (i enklaste fallF[A]kan vara en enkel funktion() => A. I detta inlägg kommer vi att användacats.IO.)Reader[A,B]— mer eller mindre en synonym för funktionenA => Bcats.Resource— en resurs som kan hämtas och frigörasTimer— timer (möjliggör att sova en viss tid och mäta tidsintervall)ContextShift— analogExecutionContextApplicative— effektens klass som möjliggör att kombinera individuella effekter (nästan en monad). I mer komplexa tillämpningar verkar det bättre att användaMonad/ConcurrentEffect.
Genom att använda denna funktionssignatur kan vi implementera flera tjänster. Till exempel en tjänst som inte gör något:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Se. , där andra tjänster implementeras — ,
och .)
En nod representerar ett objekt som kan starta flera tjänster (start av resurskedjan säkerställs genom Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Observera att vi anger den exakta konfigurationstypen som krävs för denna nod. Om vi glömmer att ange någon av de konfigurationstyper som krävs av en separat tjänst, kommer det att bli ett kompilationsfel. Vi kan inte heller starta noden om vi inte tillhandahåller något objekt med rätt typ och all nödvändig data.
Nodnamnsupplösning
För att ansluta till en fjärrnod behöver vi en faktisk IP-adress. Det är möjligt att adressen blir känd senare än de andra delarna av konfigurationen. Därför behöver vi en funktion som kartlägger nodens identifierare till en adress:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Det kan föreslås flera sätt att implementera en sådan funktion:
- Om adresserna blir kända för oss före distribution kan vi generera Scala-kod med
adresser och sedan köra bygget. Under detta kommer kompilering att ske och tester att utföras.
I så fall kommer funktionen att vara känd statiskt och kan representeras i koden i form av en avbildningMap[NodeId, NodeAddress]. - I vissa fall blir den verkliga adressen känd först efter att noden har startats.
I detta fall kan vi implementera en "upptäckstjänst" (discovery), som startas före de andra noderna och alla noder kommer att registrera sig i denna tjänst och begära adresser från andra noder. - Om vi kan modifiera
/etc/hosts, kan vi använda fördefinierade värdnamn (sommy-project-main-nodeochecho-backend) och helt enkelt koppla dessa namn
till IP-adresser under distributionen.
Inom ramen för detta inlägg kommer vi inte att diskutera dessa fall mer ingående. För vårt
leksaksexempel kommer alla noder att ha en IP-adress — 127.0.0.1.
Låt oss nu titta på två varianter av ett distribuerat system:
- Placera alla tjänster på en nod.
- Och placera echo-tjänsten och echo-klienten på olika noder.
Konfiguration för :
Konfiguration för en nod
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifier av den enda noden
  \/\/ konfiguration av server
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Typ-säker tjänstportsspecifikation. *\/
  override def portNumber: PortNumber = 8088

  \/\/ konfiguration av klient

  \/** Vi kommer att använda tjänsten från samma värd. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hej"

  def pollInterval: FiniteDuration = 1.second

  \/\/ livscykelkontrollerkonfiguration
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ ytterligare 0,5 sekunder så att det blir 10 förfrågningar, inte 9.
}
Objektet implementerar konfigurationen för både klient och server. Det används också en konfiguration för livslängd för att avsluta programmet efter intervallet lifetime programmet. (Ctrl-C fungerar också och frigör alla resurser korrekt.)
Samma uppsättning trait:er av konfiguration och implementation kan användas för att skapa ett system bestående av :
Konfiguration för två noder
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! beroendespecifikation
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ ytterligare 0,5 sekunder så att det blir 10 förfrågningar, inte 9.

    def testMessage: String = "dolly"
  }
Viktigt! Observera hur tjänster kopplas ihop. Vi anger en tjänst som implementeras av en nod som en implementation av metoden för beroende av en annan nod. Typen av beroende kontrolleras av kompilatorn, eftersom den innehåller typ av protokoll. Vid körning kommer beroendet att innehålla den korrekta identifieraren för mål-noden. Tack vare detta schema anger vi portnumret endast en gång och refererar alltid till rätt port.
Implementering av två noder i systemet
För denna konfiguration använder vi samma implementationer av tjänster utan ändringar. Den enda skillnaden är att vi nu har två objekt som implementerar olika uppsättningar av tjänster:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Den första noden implementerar servern och behöver endast serverkonfigurationen. Den andra noden implementerar klienten och använder en annan del av konfigurationen. Båda noderna behöver också livscykelhantering. Server-noden körs obegränsat länge tills den stoppas, medan klient-noden avslutas efter en viss tid. Se. SIGTERMatt klient-noden avslutas efter en viss tid. Se. .
Den övergripande utvecklingsprocessen
Låt oss se hur detta tillvägagångssätt för konfiguration påverkar den övergripande utvecklingsprocessen.
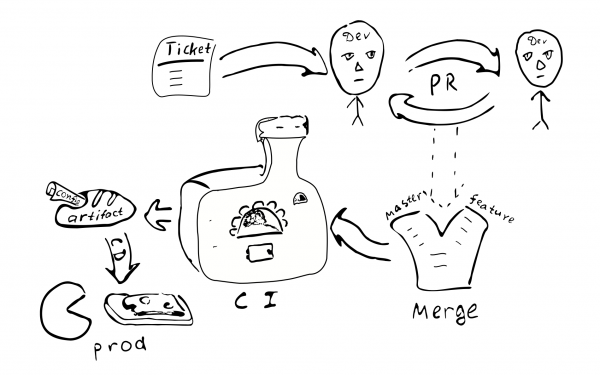
Konfigurationen kommer att kompileras tillsammans med resten av koden och en artifact (.jar) kommer att genereras. Det verkar meningsfullt att placera konfigurationen i en separat artifact. Detta beror på att vi kan ha många konfigurationer baserade på samma kod. Återigen kan vi generera artifacts som motsvarar olika konfigurationsgrenar. Tillsammans med konfigurationen sparas beroenden från specifika versioner av bibliotek, och dessa versioner sparas för alltid, oavsett när vi bestämmer oss för att distribuera denna version av konfigurationen.
Varje ändring av konfigurationen omvandlas till en ändring av koden. Därmed kommer varje sådan
ändring att omfattas av den vanliga kvalitetsprocessen:
En biljett i bugtrackern -> PR -> granskning -> sammanslagning med motsvarande grenar ->
integration -> distribution
De viktigaste följderna av att införa kompilerbar konfiguration:
Konfigurationen kommer att överenskommas på alla noder i det distribuerade systemet. Eftersom alla noder får samma konfiguration från en enhetlig källa.
Det är problematiskt att ändra konfigurationen endast på en av noderna. Därför är "konfigurationsavvikelse" (configuration drift) osannolik.
Det blir svårare att göra små ändringar i konfigurationen.
Majoriteten av ändringarna i konfigurationen kommer att ske inom ramen för den gemensamma utvecklingsprocessen och kommer att granskas.
Behövs det ett separat repository för att lagra produktionskonfigurationen? I en sådan konfiguration kan det finnas lösenord och annan hemlig information som vi skulle vilja begränsa åtkomsten till. Utifrån detta verkar det rimligt att lagra den slutliga konfigurationen i ett separat repository. Man kan dela upp konfigurationen i två delar — en som innehåller offentliga konfigurationsparametrar och en annan med begränsad åtkomst. Detta skulle låta de flesta utvecklare få tillgång till de offentliga parametrarna. Sådan uppdelning är inte svår att åstadkomma genom att använda mellanliggande traits som innehåller standardvärden.
Möjliga variationer
Låt oss försöka jämföra den kompilera konfigurationen med några vanliga alternativ:
- Textfil på den målmaskinen.
- Centraliserat nyckel-värde-lager (
i den motsvarande Docker-bilden/zookeeper). - Komponenter i processen som kan rekonfigureras/omstartas utan att processen behöver startas om.
- Lagring av konfiguration utanför artefakten och versionskontroll.
Textfiler ger betydande flexibilitet när det gäller små ändringar. Systemadministratören kan logga in på den fjärrnoden, göra ändringar i de relevanta filerna och starta om tjänsten. För större system kan dock sådan flexibilitet vara oönskad. Ändringarna lämnar inga spår i andra system. Ingen granskar ändringar. Det är svårt att fastställa vem som gjorde ändringarna och varför. Ändringarna testas inte. Om systemet är distribuerat kan administratören glömma att göra relevanta ändringar på andra noder.
(Det bör också noteras att användningen av en komplierad konfiguration inte stänger möjligheten att använda textfiler i framtiden. Det är tillräckligt att lägga till en parser och validerare som ger samma typ som utdata Konfigurera, och man kan använda textfiler. Därmed följer det direkt att komplexiteten i systemet med komplierad konfiguration är något mindre än komplexiteten i systemet som använder textfiler, eftersom textfiler kräver extra kod.)
Ett centraliserat nyckel-värde-lager är en bra mekanism för att distribuera meta-parametrar i en distribuerad applikation. Vi bör definiera vad som är konfigurationsparametrar och vad som bara är data. Låt oss ha en funktion C => A => B, där parametrarna C sällan ändras, och datan A ändras ofta. I det här fallet kan vi säga att C är konfigurationsparametrar, medan A är data. Det verkar som om konfigurationsparametrar skiljer sig från data genom att de i allmänhet ändras mindre ofta än data. Dessutom kommer data vanligtvis från en källa (från användaren), medan konfigurationsparametrar kommer från en annan (från systemadministratören).
Om sällan föränderliga parametrar behöver uppdateras utan att programmet startas om, kan detta ofta leda till en ökning av programmets komplexitet, eftersom vi på något sätt behöver överföra parametrar, lagra, parsa och validera samt hantera felaktiga värden. Därför, sett ur ett perspektiv av att minska programmets komplexitet, är det meningsfullt att minska antalet parametrar som kan förändras under programmets gång (eller helt enkelt inte stödja sådana parametrar).
Från perspektivet av detta inlägg kommer vi att särskilja mellan statiska och dynamiska parametrar. Om logiken för tjänstens arbete kräver att parametrarna ändras under programmets gång, kommer vi att kalla dessa parametrar dynamiska. I annat fall är parametrarna statiska och kan konfigureras med hjälp av en compilable-konfiguration. För dynamisk rekonfiguration kan vi behöva en mekanism för att starta om delar av programmet med nya parametrar, på ett sätt som liknar hur operativsystemets processer startas om. (Enligt vår mening är det önskvärt att undvika realtidsrekonfiguration, eftersom det ökar systemets komplexitet. Om möjligt, är det bättre att använda standardfunktionerna i operativsystemet för att starta om processer.)
En av de viktiga aspekterna av att använda statisk konfiguration, som får människor att överväga dynamisk rekonfiguration, är den tid som krävs för systemet att starta om efter en konfigurationsuppdatering (downtime). Faktum är att om vi behöver göra ändringar i den statiska konfigurationen, måste vi starta om systemet för att de nya värdena ska träda i kraft. Problemet med downtime har olika allvarlighetsgrad för olika system. I vissa fall kan omstart schemaläggas vid en tidpunkt när belastningen är minimal. Om det krävs att säkerställa kontinuerlig service kan vi implementera . När vi behöver starta om systemet, startar vi en parallell instans av systemet, växlar belastningsbalanseraren till den, och väntar tills de gamla anslutningarna avslutas. Efter att alla gamla anslutningar har avslutats, stänger vi av den gamla instansen av systemet.
Låt oss nu överväga frågan om konfigurationslagring antingen inom artefakten eller utanför den. Om vi lagrar konfigurationen inom artefakten har vi åtminstone möjlighet att bekräfta att konfigurationen är korrekt vid tidpunkten för artefaktens byggande. Om konfigurationen är utanför den kontrollerade artefakten är det svårt att spåra vem och varför som gjorde förändringar i den filen. Hur viktigt är detta? Enligt vår åsikt, för många produktionssystem är det viktigt att ha en stabil och högkvalitativ konfiguration.
Versionsartefakten gör det möjligt att fastställa när det skapades, vilka värden det innehåller, vilka funktioner som är aktiverade eller avaktiverade och vem som ansvarar för eventuella ändringar i konfigurationen. Självklart kräver lagring av konfigurationen inom artefakten vissa ansträngningar, så ett medvetet beslut måste fattas.
För och emot
Jag skulle vilja fokusera på fördelarna och nackdelarna med den föreslagna teknologin.
Fördelar
Nedan följer en lista över de viktigaste möjligheterna med den kompilera konfigurationen av det distribuerade systemet:
- Statisk konfigurationskontroll. Det gör det möjligt att vara säker på att
konfigurationen är korrekt. - Rikt språk för konfiguration. Vanligtvis är andra metoder för konfiguration begränsade till högst substitutionssträngar. Med Scala får vi tillgång till ett brett spektrum av språkets möjligheter för att förbättra konfigurationen. Till exempel kan vi använda
traits för standardvärden, använda objekt för att gruppera parametrar, och vi kan referera till val som deklarerats en gång (DRY) inom det övergripande synsvinkeln. Vi kan direkt instansiera alla klasser inuti konfigurationen (Seq,Karta, användardefinierade klasser). - DSL. I Scala finns det flera språkliga möjligheter som underlättar skapandet av DSL. Vi kan utnyttja dessa möjligheter och implementera ett konfigurationsspråk som skulle vara mer användarvänligt för målgruppen, så att konfigurationen skulle vara åtminstone läsbar för fackexperter. Experterna kan till exempel delta i processen för att granska konfigurationen.
- Integritet och synkronisering mellan noder. En av fördelarna med att hela den distribuerade systemkonfigurationen lagras på en enda plats är att alla värden deklareras exakt en gång och återanvänds där de behövs. Användning av fantomtyper för att deklarera portar gör det möjligt att säkerställa att alla korrekta konfigurationer av systemet använder kompatibla protokoll. Närvaron av tydliga nödvändiga beroenden mellan noder säkerställer att alla tjänster knyts ihop.
- Hög kvalitet på ändringar. Att göra ändringar i konfigurationen med hjälp av en gemensam utvecklingsprocess säkerställer att höga kvalitetsstandarder också gäller för konfigurationen.
- Samtidig uppdatering av konfigurationen. Automatisk distribution av systemet efter ändringar i konfigurationen garanterar att alla noder uppdateras.
- Förenkling av applikationen. Applikationen behöver inte parse, kontrollera konfigurationen eller hantera ogiltiga värden. Detta minskar kompleksiteten i applikationen. (Viss komplexitet i konfigurationen, som observeras i vårt exempel, är inte en egenskap hos den kompilerade konfigurationen, utan en medveten beslut som syftar till att säkerställa större typ-säkerhet.) Det är ganska enkelt att återgå till en vanlig konfiguration - man behöver bara implementera de saknade delarna. Därför kan man till exempel börja med en kompilerad konfiguration och skjuta upp implementeringen av överflödiga delar tills de verkligen behövs.
- Versionshantering av konfigurationen. Eftersom konfigurationsändringar följer det vanliga mönstret för alla andra ändringar får vi en artefakt med en unik version i utdata. Detta gör att vi till exempel kan återgå till en tidigare version av konfigurationen vid behov. Vi kan till och med använda en konfiguration från ett år sedan, och systemet kommer att fungera precis som tidigare. Stabil konfiguration förbättrar förutsägbarheten och tillförlitligheten i det distribuerade systemet. Eftersom konfigurationen är fastställd i kompileringen är den ganska svår att manipulera i produktion.
- Modularitet. Det föreslagna ramverket är modulärt, och moduler kan kombineras på olika sätt för att skapa olika system. Särskilt kan man konfigurera systemet för att köras på en nod i en variant och på flera noder i en annan. Man kan skapa flera konfigurationer för produktionsinstanser av systemet.
- Testning. Genom att ersätta enskilda tjänster med mock-objekt kan man få flera versioner av systemet som är bekväma för testning.
- Integreringstestning. En enhetlig konfiguration av hela det distribuerade systemet möjliggör körning av alla komponenter i en kontrollerad miljö inom ramen för integreringstestning. Det är lätt att emulera, till exempel en situation där vissa noder blir otillgängliga.
Nackdelar och begränsningar
Den kompilerade konfigurationen skiljer sig från andra metoder för konfiguration och kanske inte passar för vissa applikationer. Nedan följer några nackdelar:
- Statisk konfiguration. Ibland krävs en snabb ändring av konfigurationen i produktion, utan att gå igenom alla skyddsmekanismer. Inom ramen för denna metod kan det bli svårare. Åtminstone kommer kompilering och automatisk distribution fortfarande att behövas. Detta är både en användbar funktion och en nackdel i vissa fall.
- Konfigurationsgenerering. Om konfigurationsfilen genereras av ett automatiskt verktyg kan det krävas extra ansträngningar för att integrera byggskriptet.
- Verktyg. För närvarande bygger verktyg och metoder för att arbeta med konfiguration på textfiler. Inte alla sådana verktyg/metoder kommer att vara tillgängliga för kompilerad konfiguration.
- Ändrade perspektiv krävs. Utvecklare och DevOps är vana vid textfiler. Själva idén om att kompilera konfiguration kan vara något oväntad och ovanlig och väcka aversion.
- En högkvalitativ utvecklingsprocess behövs. För att bekvämt använda kompilerad konfiguration krävs full automatisering av bygg- och distributionsprocessen (CI/CD). Annars blir det ganska besvärligt.
Låt oss också titta på ett antal begränsningar i det granskade exemplet, som inte är relaterade till idén om kompilerad konfiguration:
- Om vi tillhandahåller överflödig konfigurationsinformation som inte används av noden kommer kompilatorn inte att hjälpa oss att upptäcka avsaknaden av implementering. Detta problem kan lösas genom att överge Cake-mönstret och använda striktare typer, till exempel
HListeller algebraiska datatyper (caseklasser) för att representera konfigurationen. - I konfigurationsfilen finns rader som inte relevanta för själva konfigurationen: (
paket,import, objektdeklarationer;override defFör parametrar med standardvärden kan detta delvis undvikas genom att implementera en egen DSL. Dessutom sätter andra typer av konfiguration (t.ex. XML) också vissa begränsningar på filens struktur. - I detta inlägg kommer vi inte att diskutera dynamisk rekonfiguration av kluster av liknande noder.
Slutsats
I detta inlägg har vi utforskat idén att representera konfigurationer i källkoden med hjälp av de avancerade funktionerna i Scala-typ systemet. Detta tillvägagångssätt kan tillämpas i olika applikationer som ett alternativ till traditionella konfigurationsmetoder baserade på XML- eller textfiler. Även om vårt exempel är implementerat i Scala kan samma idéer överföras till andra kompilérbara språk (som Kotlin, C#, Swift, ...). Detta tillvägagångssätt kan prövas i något av de kommande projekten, och om det inte fungerar, kan man återgå till textfiler och lägga till de saknade detaljerna.
Naturligtvis kräver kompilérbar konfiguration en högkvalitativ utvecklingsprocess. I gengäld säkerställs hög kvalitet och pålitlighet i konfigurationerna.
Det diskuterade tillvägagångssättet kan utvidgas:
- Makron kan användas för att utföra kontroller vid kompilering.
- En DSL kan realiseras för att representera konfigurationen i ett format som är tillgängligt för slutanvändare.
- Dynamisk resursadministration med automatisk justering av konfigurationen kan genomföras. Till exempel, vid förändringar av antalet noder i klustret krävs det att (1) varje nod får en något annorlunda konfiguration; (2) klusterhandlaren får information om nya noder.
Tack.
Jag vill tacka Andrey Saksonov, Pavel Popov och Anton Nekhaev för den konstruktiva kritiken av artikelutkastet.
Källa: habr.com
