

Så, låt oss föreställa oss. I rummet är 5 katter instängda, och för att kunna gå och väcka sin ägare måste de först komma överens stärker de tillsammans, eftersom de endast kan öppna dörren genom att trycka sig på den fem och fem. Om en av katterna är Schrödingers katt, och de andra katterna inte känner till hans beslut, uppstår frågan: "Hur kan de göra det?"
I den här artikeln kommer jag på ett enkelt språk att berätta om den teoretiska komponenten i världen av distribuerade system och principerna för deras funktion. Jag kommer också kortfattat att diskutera huvudidén som ligger till grund för Paxos.
När utvecklare använder molninfrastrukturer, olika databaser och arbetar i kluster med ett stort antal noder, är de säkra på att data kommer att vara intakta, säkra och alltid tillgängliga. Men var kommer garantierna ifrån?
I grunden är de garantier vi har – garantier från leverantören. De beskrivs i dokumentationen ungefär så här: "Denna tjänst är tillräckligt pålitlig, den har en angiven SLA, oroa dig inte, allt kommer att fungera distribuerat som du förväntar dig."
Vi tenderar att tro på det bästa, eftersom kloka män från stora företag har försäkrat oss om att allt kommer att gå bra. Vi ställer oss inte frågan: varför kan detta överhuvudtaget fungera? Finns det någon formell motivering till korrektheten i sådana system?
Nyligen besökte jag och blev väldigt inspirerad av detta ämne. Föreläsningarna i skolan liknade mer lektioner i matematisk analys än något som var relaterat till datorsystem. Men just så bevisades i sin tid de viktiga algoritmer som vi använder varje dag utan att vi ens är medvetna om det.
I de flesta moderna distribuerade system används konsensusalgoritmen Paxos och dess olika variationer. Det mest fantastiska är att bevisbarheten och i princip själva möjligheten av existensen av denna algoritm kan bevisas helt enkelt med hjälp av en penna och papper. Samtidigt tillämpas algoritmen i praktiken i stora system som arbetar på ett enormt antal noder i molnets miljö.
En lättfattlig illustration av vad som kommer att diskuteras härnäst: två generalers problemLåt oss för uppvärmning analysera .
Vi har två arméer – den röda och den vita. De vita trupperna är baserade i den belägrade staden. De röda trupperna, ledda av generalerna A1 och A2, är placerade på två sidor av staden. Målet för de röda är att attackera den vita staden och segra. Men varje röd generals armé är mindre än de vita.
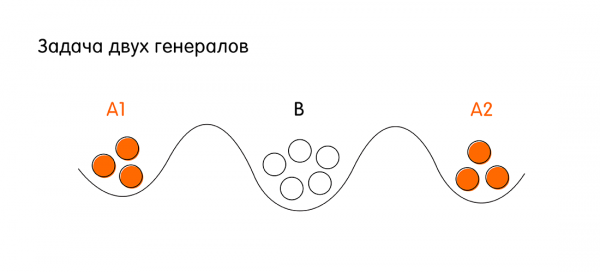
Villkoren för seger för de röda: båda generalerna måste attackera samtidigt för att ha ett numerärt överläge över de vita. För detta måste generalerna A1 och A2 enas med varandra. Om de attackerar var för sig, kommer de röda att förlora.
För att enas kan generalerna A1 och A2 skicka budbärare till varandra över den vita stadens territorium. Budbäraren kan nå sin allierade general eller bli fångad av fienden. Frågan är: finns det en sådan sekvens av kommunikation mellan de röda generalerna (sekvens av sändning av budbärare från A1 till A2 och vice versa från A2 till A1), där de garanterat kommer överens om att attackera klockan X. Här under garantier förstås att båda generalerna kommer att ha entydig bekräftelse på att den allierade (den andra generalen) verkligen attackerar på den bestämda tiden X.
Anta att A1 skickar en budbärare till A2 med meddelandet: "Låt oss attackera idag vid midnatt!" Generalen A1 kan inte attackera utan bekräftelse från general A2. Om budbäraren från A1 har nått fram, skickar general A2 en bekräftelse med meddelandet: "Ja, låt oss övermannar de vita idag." Men nu vet general A2 inte om hans budbärare har kommit fram eller inte, han har ingen garanti för att attacken blir simultan. Nu måste general A2 återigen få en bekräftelse.
Om vi fortsätter att beskriva deras kommunikation kommer vi att inse följande: hur många cykler av meddelandeutbyte som helst finns det inget sätt att garantera att båda generalerna får veta att deras meddelanden har mottagits (under förutsättning att någon av budbärarna kan fångas).
Problemet med de två generalerna är en utmärkt illustration av ett mycket enkelt distribuerat system, där det finns två noder med osäker kommunikation. Det innebär att vi inte har 100 % garanti för att de synkroniseras. Om liknande problem på en större skala fortsätter i artikeln.
Vi introducerar begreppet distribuerade system.
Ett distribuerat system är en grupp datorer (som vi kommer att kalla noder) som kan utbyta meddelanden. Varje enskild nod är en viss autonom enhet. En nod kan självständigt hantera uppgifter, men för att interagera med andra noder måste den skicka och ta emot meddelanden.
Hur meddelanden konkret implementeras, vilka protokoll som används — det är inte det som intresserar oss i detta sammanhang. Det viktiga är att noder i det distribuerade systemet kan utbyta data med varandra genom att skicka meddelanden.
Själva definitionen verkar inte särskilt komplicerad, men man måste beakta att ett distribuerat system har en rad attribut som kommer att vara viktiga för oss.
Attribut för distribuerade system
- Samtidighet – möjligheten till samtidiga eller konkurrerande händelser i systemet. Dessutom kommer vi att anta att händelser som inträffar på två olika noder potentiellt är konkurrerande så länge vi inte har någon tydlig ordning på händelserna. Och vanligtvis har vi ingen sådan ordning.
- Avsaknad av globala klockor. Vi har ingen tydlig ordning på händelserna på grund av avsaknaden av globala klockor. I den vanliga människovärlden är vi vana vid att ha klockor och en absolut tid. Allt förändras när det handlar om distribuerade system. Även de mest precisa atomklockorna har en driftskiftning, och det är möjligt att vi inte kan säga vilket av de två händelserna som inträffade först. Därför kan vi inte heller lita på tid.
- Oberoende fel i nodernas system. Det finns ännu ett problem: något kan gå fel helt enkelt eftersom våra noder inte är eviga. En hårddisk kan gå sönder, en virtuell maskin i molnet kan starta om, nätverket kan blinkar och meddelanden går förlorade. Dessutom är det möjligt att noderna fungerar, men samtidigt arbetar mot systemet. Den sista klassen av problem har till och med fått ett eget namn: problemet med . Det mest kända exemplet på ett distribuerat system som har detta problem är Blockchain. Men idag kommer vi inte att gå in på denna specifika klass av problem. Vi kommer att fokusera på situationer där en eller flera noder helt enkelt kan gå ner.
- Kommunikationsmodeller (meddelandeutbytesmodeller) mellan noder. Vi har redan konstaterat att noder kommunicerar genom att utbyta meddelanden. Det finns två kända modeller för meddelandeutbyte: synkront och asynkront.
Kommunikationsmodeller mellan noder i distribuerade system
Synkron modell – vi vet med säkerhet att det finns en slutlig känd tidsdelta, inom vilken ett meddelande garanterat når från en nod till en annan. Om denna tid har gått och meddelandet inte har kommit, kan vi utan tvekan säga att noden har slutat fungera. I en sådan modell har vi en förutsägbar väntetid.
Asynkron modell – i asynkrona modeller anser vi att väntetiden är ändlig, men det finns ingen tidsdelta efter vilken vi kan garantera att noden har slutat fungera. Det vill säga, väntetiden för ett meddelande från en nod kan vara hur lång som helst. Detta är en viktig definition och vi kommer att diskutera det vidare.
Begreppet konsensus i distribuerade system
Innan vi formellt definierar begreppet konsensus, låt oss överväga ett exempel på en situation där vi behöver det, nämligen – State Machine Replication.
Vi har en viss distribuerad logg. Vi skulle vilja att den är konsekvent och innehåller identiska data på alla noder i det distribuerade systemet. När någon av noderna får veta ett nytt värde som de tänker skriva till loggen, blir det deras uppgift att föreslå detta värde för alla andra noder, så att loggen uppdateras på alla noder, och systemet går in i ett nytt konsekvent tillstånd. Det är viktigt att noderna kommer överens med varandra: alla noder har enats om att det föreslagna nya värdet är korrekt, alla noder har accepterat detta värde, och först då kan alla skriva det nya värdet till loggen.
Med andra ord: ingen av noderna har invänt att de har mer aktuell information och att det föreslagna värdet är felaktigt. Överenskommelsen mellan noderna och enigheten om det enhetliga godtagna värdet är vad konsensus innebär i ett distribuerat system. Framöver kommer vi att diskutera algoritmer som gör det möjligt för det distribuerade systemet att garantera att konsensus nås.
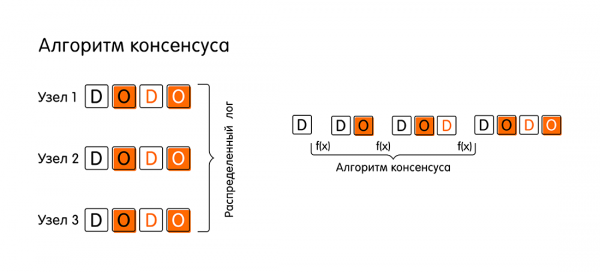
Mer formellt kan vi definiera algoritmen för att uppnå konsensus (eller helt enkelt konsensusalgoritm) som en viss funktion som förvandlar ett distribuerat system från tillstånd A till tillstånd B. Detta tillstånd måste accepteras av alla noder, och alla noder måste kunna bekräfta det. Som det visar sig är denna uppgift inte så trivial som den kan verka vid första anblick.
Egenskaper hos konsensusalgoritmen
Konsensusalgoritmen måste ha tre egenskaper för att systemet ska fortsätta existera och ha något framsteg i övergången mellan tillstånd:
- Överenskommelse – alla korrekt fungerande noder måste acceptera samma värde (i artiklar kallas denna egenskap också för safety property). Alla noder som för närvarande fungerar (inte har kraschat eller tappat kontakten med de andra) måste nå en överenskommelse och acceptera ett slutgiltigt gemensamt värde.
Här är det viktigt att förstå att noderna i det distribuerade systemet vi diskuterar strävar efter att komma överens. Det vill säga, vi pratar nu om system där något kan fungera fel (till exempel att en nod kraschar), men i detta system finns det absolut inga noder som avsiktligt arbetar emot andra (den byzantinska generalens problem). Tack vare denna egenskap förblir systemet konsistent.
- Integritet – om alla korrekt fungerande noder erbjuder samma värde v, måste varje korrekt fungerande nod acceptera detta värde v.
- Avslutning – alla korrekt fungerande noder kommer till slut att acceptera ett visst värde (liveness property), vilket gör det möjligt för algoritmen att ha framsteg i systemet. Varje enskild korrekt fungerande nod måste förr eller senare acceptera det slutgiltiga värdet och bekräfta detta: "För mig är detta värde sant, jag håller med hela systemet."
Exempel på konsensusalgoritmens funktion
Tills dessa egenskaper hos algoritmen är helt förståeliga, låt oss illustrera med ett exempel hur de enklaste konsensusalgoritmerna i ett system med en synkron modell för meddelandeutbyte fungerar, där alla noder fungerar som de ska, meddelanden inte går förlorade och inget går sönder (kan detta verkligen hända?).
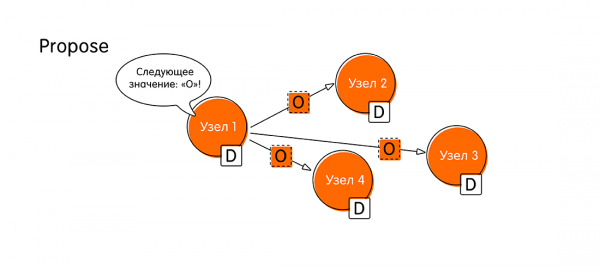
- Allt börjar med ett förslag om hand och hjärta (Propose). Anta att en klient har anslutit sig till noden kallad "Nod 1" och startat en transaktion genom att skicka ett nytt värde - O. Från och med nu kommer vi att kalla "Nod 1" proposer. Som proposer måste "Nod 1" nu meddela hela systemet att den har nya data, och den skickar meddelanden till alla andra noder: "Titta! Jag har fått värdet 'O', och jag vill att ni också ska bekräfta att ni kommer att skriva 'O' i er logg."

- Nästa steg är omröstning om det föreslagna värdet (Voting). Varför behövs det? Det kan hända att andra noder har fått mer aktuella uppgifter, och de kan ha information om samma transaktion.
När noden "Nod 1" skickar sitt förslag, kontrollerar de andra noderna sina loggar för uppgifter om denna händelse. Om det inte finns några motsägelser, förklarar noderna: "Ja, jag har ingen annan information om denna händelse. Värdet 'O' är den senaste information vi har fått."I annat fall kan noderna svara "Nod 1": "Lyssna! Jag har mer aktuell information om denna transaktion. Inte 'O', utan något bättre."
Under omröstningen kommer noderna fram till en lösning: antingen accepterar alla ett värde eller så röstar någon emot, och anger att de har mer aktuell information.
- Om omröstningen har genomförts framgångsrikt och alla var "för", går systemet vidare till ett nytt steg - acceptans av värdet (Accept). "Nod 1" samlar alla svar från andra noder och meddelar: "Alla har kommit överens om värdet 'O'! Nu förklarar jag officiellt att 'O' är vårt nya värde som gäller för alla! Skriv ner det i er bok, glöm inte. Skriv i er logg!"
- Övriga noder skickar en bekräftelse (Accepted) på att de har skrivit ner värdet 'O', inget nytt har kommit in under den tiden (en slags tvåfasesbekräftelse). Efter denna betydelsefulla händelse anser vi att den distribuerade transaktionen har genomförts.
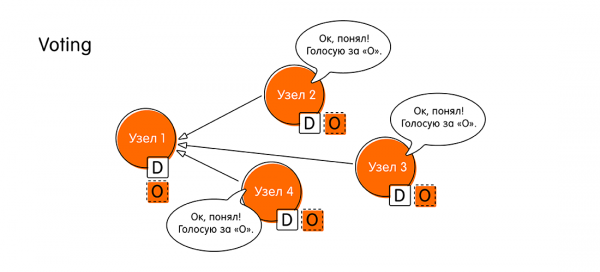
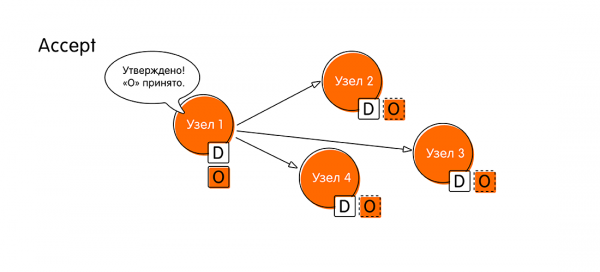
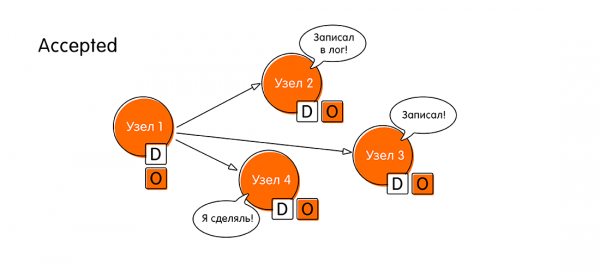
Således består konsensusalgoritmen i enkla fall av fyra steg: föreslå, omröstning (voting), acceptans (accept), bekräftelse av acceptans (accepted).
Om vi inte kan nå en överenskommelse i något steg, startar algoritmen om, med hänsyn till den information som noderna som vägrar att bekräfta det föreslagna värdet kommer att tillhandahålla.
Konsensusalgoritm i ett asynkront system
Tidigare har allt varit enkelt, eftersom vi har talat om en synkron kommunikationsmodell. Men vi vet ju att vi i den moderna världen är vana vid att göra allt asynkront. Hur fungerar då en liknande algoritm i ett system med en asynkron meddelandemodell, där vi anser att väntetiden för ett svar från en nod kan vara hur lång som helst (för att nämna ett exempel, en nod som går ner kan också ses som ett fall där noden kan svara hur länge som helst).
Nu när vi vet hur konsensusalgoritmen fungerar i princip, en fråga till de nyfikna läsarna som har kommit hit: hur många noder i ett system med N noder som har en asynkron meddelandemodell kan gå ner, så att systemet fortfarande kan nå konsensus?
Det rätta svaret och motiveringen finns under spoilern.Det rätta svaret: 0. Om även en nod i ett asynkront system går ner, kan systemet inte nå konsensus. Detta påstående bevisades i en välkänd sats inom vissa kretsar, FLP-teoremet (1985, Fischer, Lynch, Paterson, referens till originalet i slutet av artikeln): "Omöjligheten att nå distribuerad konsensus vid nedgång av minst en nod."
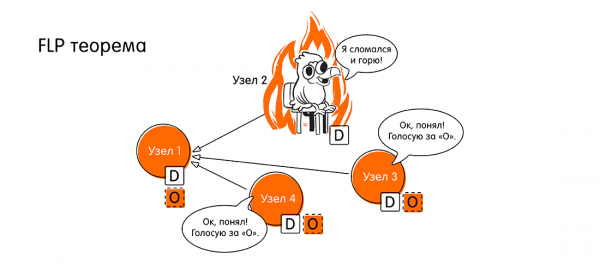
Grabbar, då har vi ett problem, vi är ju vana vid att allt är asynkront. Och här är det så. Hur ska vi gå vidare?
Vi har just pratat om teori, om matematik. Vad betyder "konsensus kan inte nås" när vi översätter från matematiskt språk till vårt – ingenjörsspråk? Det betyder att "det alltid kan finnas fall där konsensus inte kan nås". Vad är detta fall?
Det handlar just om brott mot liveness property som nämndes tidigare. Vi har ingen gemensam överenskommelse, och systemet kan inte göra framsteg (kan inte avslutas inom en begränsad tid) när vi inte har svar från alla noder. Eftersom vi i ett asynkront system inte har förutsägbart svarstid, kan vi inte veta om en nod har gått ner eller bara svarar långsamt.
Men i praktiken kan vi hitta en lösning. Låt vår algoritm kunna fungera länge vid fel (potentiellt kan den fungera oändligt). Men i de flesta situationer, när de flesta noder fungerar korrekt, kommer vi att ha framsteg i systemet.
I praktiken hanterar vi delvis synkrona kommunikationsmodeller. Delvis synkronitet förstås så att vi i allmänhet har en asynkron modell, men formellt introduceras en viss term "global stabilization time" för en viss tidpunkt.
Denna tidpunkt behöver inte infalla under en obestämd tid, men en dag måste den inträffa. En virtuell väckarklocka kommer att ringa, och från det ögonblicket kan vi förutsäga tidsdifferensen för att meddelandena ska nå fram. Från det ögonblicket omvandlas systemet från asynkront till synkront. I praktiken hanterar vi just sådana system.
Paxos-algoritmen löser konsensusproblem
är en familj algoritmer som löser konsensusproblemet för delvis synkrona system, under förutsättning att vissa noder kan gå ner. Författaren av Paxos är . Han föreslog ett formellt bevis på existensen och korrektheten av algoritmen 1989.
Men beviset visade sig vara långt ifrån trivialt. Den första publikationen släpptes först 1998 (33 sidor) med en beskrivning av algoritmen. Det visade sig att den var oerhört svår att förstå, och 2001 publicerades en förklaring till artikeln som tog 14 sidor. Omfånget av publikationerna anges för att visa att konsensusproblemet faktiskt är ganska komplicerat, och bakom sådana algoritmer ligger ett enormt arbete av de smartaste människorna.
Intressant nog påpekade Leslie Lamport själv i sin föreläsning att det i den andra förklarande artikeln finns ett påstående, en rad (han specificerade inte vilken), som kan tolkas på olika sätt. Och på grund av detta fungerar många moderna implementationer av Paxos inte helt korrekt.
En detaljerad genomgång av hur Paxos fungerar skulle kräva mer än en artikel, så jag ska försöka kortfattat förmedla huvudidén av algoritmen. I länkarna i slutet av min artikel hittar du material för vidare fördjupning i detta ämne.
Roller i Paxos
I Paxos-algoritmen finns begreppet roller. Vi ska titta på tre huvudroller (det finns modifieringar med ytterligare roller):
- Proposers (termer som ledare eller samordnare kan också förekomma). Dessa är killarna som får veta om ett nytt värde från användaren och tar på sig rollen som ledare. Deras uppgift är att starta en runda av erbjudanden om det nya värdet och koordinera de vidare åtgärderna av noderna. Paxos tillåter att det finns flera ledare i vissa situationer.
- Acceptorer (Röstare). Dessa är noder som röstar för att anta eller avvisa ett visst värde. Deras roll är mycket viktig, eftersom det är upp till dem att avgöra: vilket tillstånd systemet kommer att gå över till (eller inte gå över till) efter nästa steg av konsensusalgoritmen.
- Lärande noder. Noder som bara tar emot och registrerar det nya antagna värdet när systemets tillstånd har ändrats. De fattar inga beslut, utan får bara data och kan ge dem till slutanvändaren.
En nod kan kombinera flera roller i olika situationer.
Begreppet kvorum
Vi antar att vi har ett system av N noder. Och av dem kan högst F noder gå ner. Om F noder går ner, betyder det att vi i klustret måste ha minst 2F + 1 acceptornoder.
Detta är nödvändigt så att vi alltid, även i den sämsta situationen, har en majoritet av 'goda', korrekt fungerande noder. Det vill säga F + 1 goda noder som har enats, och det slutliga värdet kommer att antas. Annars kan det uppstå en situation där olika lokala grupper antagit olika värden och inte kan enas. Därför behöver vi en absolut majoritet för att vinna omröstningen.
Den allmänna idén bakom Paxos konsensusalgoritm
Paxos-algoritmen omfattar två stora faser, som i sin tur delas upp i två steg vardera:
- Fas 1a: Förbered. I förberedelseskedet meddelar ledaren (proposer) alla noder: "Vi inleder ett nytt röstningsskede. Vi har en ny omgång. Nummer på denna omgång är n. Nu börjar vi rösta." Just nu meddelar han bara början av en ny cykel, men han informerar inte om något nytt värde. Målet med detta steg är att initiera en ny omgång och att informera alla om dess unika nummer. Omgångsnumret är viktigt, det måste vara ett värde som är större än alla tidigare röstningsnummer från alla tidigare ledare. Eftersom det är tack vare omgångsnumret som andra noder i systemet kommer att förstå hur aktuella ledarens data är. Det är möjligt att andra noder redan har röstningsresultat från mycket senare omgångar och de kommer helt enkelt att berätta för ledaren att han har halkat efter.
- Fas 1b: Löfte. När acceptor-noderna har mottagit nummer för den nya röstningsomgången kan två utfall inträffa:
- Nummer n för den nya omröstningen är större än numret för någon tidigare omröstning där acceptorn deltog. Då skickar acceptorn ett löfte till ledaren om att han inte kommer att delta i några fler omröstningar med ett lägre nummer än n. Om acceptorn redan har röstat för något (d.v.s. han har redan accepterat ett värde i det andra steget), bifogar han det accepterade värdet och röstningsnumret för den omröstning han delade i.
- Å andra sidan, om acceptorn redan känner till en omröstning med ett större nummer, kan han helt enkelt ignorera förberedelsesteget och inte svara ledaren.
- Fas 2a: Acceptera. Ledaren behöver vänta på svar från en kvorum (majoriteten av noderna i systemet) och, om tillräckligt många svar har mottagits, har han två möjliga utfall:
- Vissa av acceptorerna har skickat värden som de redan har röstat för. I detta fall väljer ledaren värdet från omröstningen med det högsta numret. Låt oss kalla detta värde x, och han skickar ett meddelande till alla noder i formatet: "Accept (n, x)", där det första värdet är röstningsnumret från hans egen Propose-step, och det andra värdet är det som alla samlades för, det vill säga värdet som vi faktiskt röstar för.
- Om ingen av acceptorerna har skickat några värden och bara lovat att rösta i denna omgång, kan ledaren föreslå dem att rösta på sitt värde, det värde som gjorde att han överhuvudtaget blev ledare. Låt oss kalla det y. Han skickar ett meddelande till alla noder av typen: "Accept (n, y)", i analogi med det föregående utfallet.
- Fas 2b: GodkändVidare, acceptornoderna, när de får meddelandet "Accept(…)" från ledaren, godkänner det endast om de inte har lovat någon (annan) ledare att delta i omröstningar med nummer på omgången n’ > n, annars ignorerar de begäran om bekräftelse.
Om ledaren får svar från majoriteten av noderna, och alla har bekräftat det nya värdet, betraktas det nya värdet som antaget. Hurra! Om majoriteten inte nås eller det finns noder som vägrar att acceptera det nya värdet, börjar allt om.
Så här fungerar Paxos-algoritmen. Varje steg har många detaljer; vi har nästan inte berört olika typer av fel, problem med flera ledare och mycket mer, men syftet med denna artikel är bara att på hög nivå introducera läsaren till världen av distribuerade beräkningar.
Det är också värt att notera att Paxos inte är den enda av sitt slag, det finns andra algoritmer, till exempel , men det är en annan artikel.
Länkar till material för vidare studier
Nivå "nybörjare":
- , Preethi Kasireddy, bloggartikel på Medium
- , Adi Kancherla, bloggartikel på Medium
- , Ittai Abraham, blogg
- , Ittai Abraham, bloggartikel
Nivå "Leslie Lamport":
- , Fischer, Lynch och Paterson, forskningsartikel, 1985
- , Leslie Lamport, forskningsartikel, 1998
- , Leslie Lamport, forskningsartikel, 2001
Källa: habr.com
