

Kunder kommer allt oftare med förfrågningar som: "Vi vill ha något som Amazon RDS, men billigare"; "Vi vill ha något liknande RDS, men i alla infrastrukturer". För att implementera en sådan managed-lösning på Kubernetes har vi granskat tillståndet för de mest populära operatörerna för PostgreSQL (Stolon, operatörer från Crunchy Data och Zalando) och gjort vårt val.
Den här artikeln handlar om våra insikter, både från ett teoretiskt perspektiv (översikt över lösningar) och praktiskt (vad har valts och vad har vi åstadkommit). Men först, låt oss klargöra vilka krav som ställs på en potentiell ersättning för RDS...
Vad är RDS?
När människor pratar om RDS, så menar de, enligt vår erfarenhet, en hanterad (managed) databas tjänst som:
- är enkel att konfigurera;
- har möjlighet att arbeta med snapshots och kunna återställas från dem (helst med stöd för );
- möjlighet att skapa master-slave-topologier;
- har en rik lista av tillägg;
- erbjuder revision och hantering av användare/behörigheter.
Generellt kan tillvägagångssätten för att lösa den ställda uppgiften vara ganska olika, men vi drar oss för att använda Ansible. (En liknande slutsats gjorde också kollegorna från 2GIS efter att skapa "ett verktyg för snabb distribution av en felresistent Postgres-kluster.")
Operatörer är det allmänt accepterade tillvägagångssättet för att lösa sådana uppgifter inom Kubernetes-ekosystemet. Mer om dem i relation till databaser som körs inuti Kubernetes har teknisk direktör för "Flanta" redan berättat, , i .
NB: För att snabbt skapa enkla operatörer rekommenderar vi att titta på vårt Open Source-verktyg . Genom att använda det kan detta göras utan kunskaper i Go, på mer välbekanta sätt för systemadministratörer: i Bash, Python etc.
Det finns flera populära K8s-operatörer för PostgreSQL:
- Stolon;
- Crunchy Data PostgreSQL Operator;
- Zalando Postgres Operator.
Låt oss titta närmare på dem.
Val av operatör
Förutom de viktiga funktioner som redan nämnts förväntade vi oss också, som infrastrukturingenjörer inom Kubernetes, följande från operatörerna:
- deploy från Git och med ;
- stöder pod anti-affinity;
- installation av node affinity eller node selector;
- installation av tolerations;
- möjligheter till justering;
- förståeliga teknologier och till och med kommandon.
Utan att gå in på detaljer för varje punkt (fråga i kommentarerna om det finns frågor kvar efter att ha läst hela artikeln), kan jag generellt påpeka att dessa parametrar behövs för en mer detaljerad beskrivning av specialiseringen av klusternoderna för att beställa dem för specifika applikationer. På så sätt kan vi uppnå en optimal balans mellan prestanda och kostnad.
Nu – till själva PostgreSQL-operatörerna.
1. Stolon
från det italienska företaget Sorint.lab i betraktades som en typ av referens bland operatörer för databashanteringssystem. Det är ett ganska gammalt projekt: den första offentliga versionen släpptes redan i november 2015(!), och GitHub-repot kan skryta med nästan 3000 stjärnor och 40+ bidragsgivare.
Och faktiskt är Stolon ett utmärkt exempel på genomtänkt arkitektur:
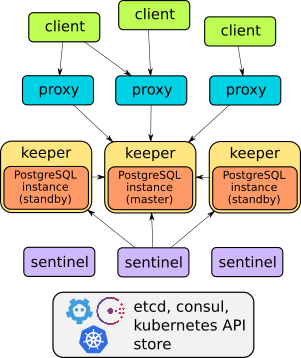
Om konstruktionen av denna operatör kan man läsa mer detaljerat i presentationen eller . I stort sett kan man säga att den klarar av allt som beskrivs: failover, proxy för transparent kundåtkomst, säkerhetskopior… Dessutom erbjuder proxyåtkomst genom en enda tjänst-endpoint – till skillnad från de två andra lösningarna som diskuterats senare (de har två tjänster för åtkomst till databasen).
Men Stolon , vilket gör att den inte kan distribueras så enkelt och snabbt – "som varma bakverk" – för att skapa instanser av databashanteringssystemet i Kubernetes. Hanteringen sker via verktyget stolonctl, distribution – via Helm-diagram, och användardefinierade anges i ConfigMap.
Å ena sidan verkar det som att operatören inte riktigt är en operatör (eftersom den inte använder CRD). Men å andra sidan – det är ett flexibelt system som låter dig konfigurera resurser i K8s på det sätt som du vill.
Sammanfattningsvis tyckte vi personligen att det inte var optimalt att ha ett separat diagram för varje databas. Så vi började leta efter alternativ.
2. Crunchy Data PostgreSQL Operator
, en ung amerikansk startup, verkade vara ett logiskt alternativ. Dess offentliga historia började med den första versionen i mars 2017, och sedan dess har GitHub-repot fått något mindre än 1300 stjärnor och 50+ bidragsgivare. Den senaste versionen från september testades för att fungera med Kubernetes 1.15–1.18, OpenShift 3.11+ och 4.4+, GKE och VMware Enterprise PKS 1.3+.
Arkitekturen för Crunchy Data PostgreSQL Operator uppfyller också de angivna kraven:
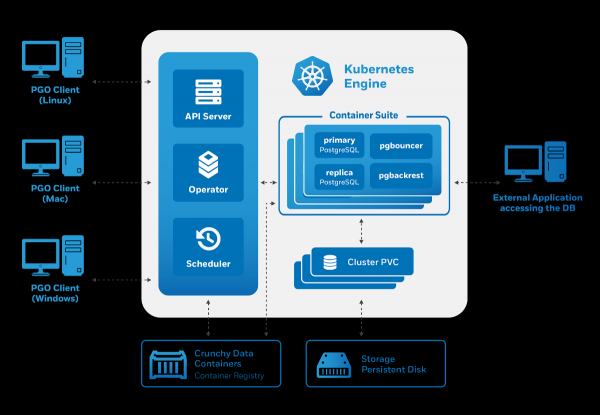
Hantera görs via ett verktyg pgo, men det genererar i sin tur Custom Resources för Kubernetes. Så som potentiella användare blev vi glatt överraskade av operatören:
- det finns hantering via CRD;
- användarvänlig hantering (även den via CRD);
- integration med andra komponenter — en specialiserad samling av containerbilder för PostgreSQL och verktyg för att arbeta med den (inklusive pgBackRest, pgAudit, tillägg från contrib osv.).
När vi dock försökte börja använda operatören från Crunchy Data uppstod några problem:
- Det fanns ingen möjlighet till toleranser — endast nodeSelector var tillgänglig.
- De skapade pod'arna var en del av Deployment, trots att vi distribuerade en stateful-applikation. Till skillnad från StatefulSet kan inte Deployment skapa diskar.
Den sista nackdelen leder till roliga situationer: i testmiljön lyckades vi köra 3 repliker med en disk lokal lagring, vilket gjorde att operatören rapporterade att 3 repliker fungerade (även om så inte var fallet).
En annan funktion hos denna operatör är dess färdiga integration med olika hjälpsystem. Till exempel, det är enkelt att installera pgAdmin och pgBounce, och i förhandsinställningen av Grafana och Prometheus övervägs. I den senaste noteras den förbättrade integrationen med projektet , vilket gör att operatören erbjuder en visuell presentation av PgSQL-metrics "out-of-the-box".
Ändå ledde det märkliga valet av genererade Kubernetes-resurser oss till att behöva hitta en alternativ lösning.
3. Zalando Postgres Operator
Zalando-produkter är vi välbekanta med: vi har erfarenhet av att använda Zalenium och självklart har vi provat — deras populära HA-lösning för PostgreSQL. Om företagets tillvägagångssätt för att skapa berättade en av dess författare — Alexey Klyukin — i sändningen av , och vi tyckte att den var intressant.
Detta är den yngsta lösningen bland de som behandlas i artikeln: den första versionen släpptes i augusti 2018. Trots det lilla antalet formella versioner har projektet gjort stora framsteg och redan överträffat lösningen från Crunchy Data med över 1300 stjärnor på GitHub och det högsta antalet bidragsgivare (70+).
"Under huven" för denna operatör används beprövade lösningar:
- Patroni och för hantering,
- — för säkerhetskopior,
- — som en anslutningspool.
Så här presenteras operatörens arkitektur från Zalando:
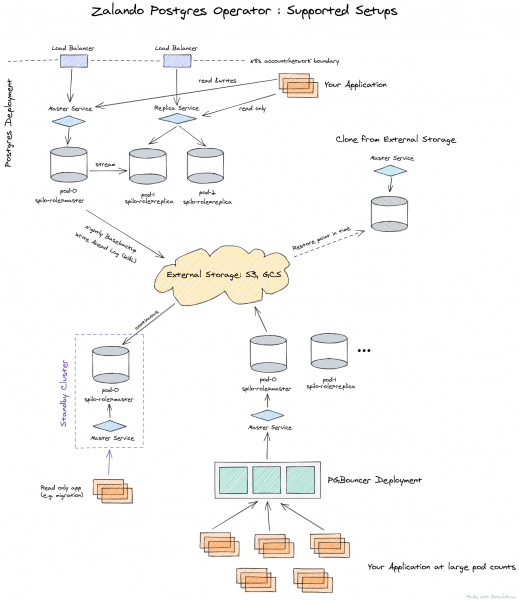
Operatören hanteras helt genom Custom Resources, skapar automatiskt en StatefulSet av containrar som sedan kan anpassas genom att lägga till olika sidecars i podden. Detta är en betydande fördel jämfört med operatören från Crunchy Data.
Eftersom det var lösningen från Zalando som vi valde bland tre övervägda alternativ, kommer en ytterligare beskrivning av dess funktioner att presenteras nedan, tillsammans med praktisk tillämpning.
Praktik med Postgres Operator från Zalando
Distributionen av operatören sker mycket enkelt: det räcker med att ladda ner den aktuella versionen från GitHub och tillämpa YAML-filerna från katalogen . Som ett alternativ kan man även använda .
Efter installationen bör man se till att konfigurera . Detta görs via ConfigMap postgres-operator i det namnutrymme där du installerade operatören. När lagringslösningarna är konfigurerade kan du distribuera din första PostgreSQL-kluster.
Till exempel ser vår standarddistribution ut som följer:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Denna manifest distribuerar en kluster med 3 instanser med sidecar i form av , varifrån vi hämtar applikationsmetrik. Som du ser är det väldigt enkelt, och om så önskas kan man skapa ett bokstavligt talat obegränsat antal kluster.
Det är värt att notera även webbpanelen för administration — . Den levereras tillsammans med operatören och gör det möjligt att skapa och ta bort kluster, samt arbeta med säkerhetskopior som operatören gör.
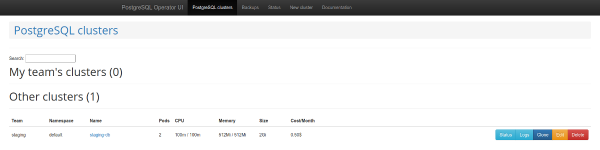
Lista över PostgreSQL-kluster
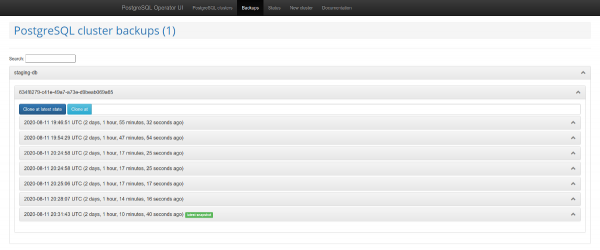
Hantera säkerhetskopior
En annan intressant funktion är stödet för . Denna mekanism skapar automatiskt roller i PostgreSQL, baserat på den mottagna listan över användarnamn. Därefter gör API:et det möjligt att returnera listan över användare för vilka roller skapas automatiskt.
Problem och lösningar
Men användningen av operatören avslöjade snart flera betydande nackdelar:
- brist på nodeSelector-stöd;
- oförmåga att stänga av säkerhetskopior;
- när funktionen för att skapa databaser används, tilldelas inga standardbehörigheter;
- ibland saknas dokumentation eller så är den inaktuell.
Lyckligtvis kan många av dessa problem lösas. Låt oss börja med slutet — problemen med dokumentationen.
Du kommer troligen att stöta på att det inte alltid är klart hur man ställer in en säkerhetskopia och hur man kopplar en säkerhetskopieringsbucket till Operator UI. Detta nämns kort i dokumentationen, men en detaljerad beskrivning finns i :
- du måste skapa en hemlighet;
- överföra den till operatören i parametern
pod_environment_secret_namei CRD med operatörens inställningar eller i ConfigMap (beroende på hur du valde att installera operatören).
Men som det visade sig är detta för närvarande omöjligt. Just därför har vi samlat med några extra tredjepartsanpassningar. Mer om den — se nedan.
Om du överför parametrar för säkerhetskopiering till operatören, nämligen — wal_s3_bucket och åtkomstnycklarna till AWS S3, kommer den att säkerhetskopiera allt: inte bara databaser i produktion, utan även staging. Det passade inte oss.
I beskrivningen av parametrarna för Spilo, vilket är en grundläggande Docker-wrapper för PgSQL vid användning av operatören, visade det sig: det går att överföra parametern WAL_S3_BUCKET som tom, vilket stänger av säkerhetskopior. Dessutom, till vår stora glädje hittade jag också en , som vi omedelbart accepterade i vår fork. Nu räcker det med att enkelt lägga till enableWALArchiving: false i resursen för PostgreSQL-klustret.
Ja, det fanns möjlighet att göra det annorlunda genom att starta 2 operatörer: en för staging (utan säkerhetskopior) och en för produktion. Men så kunde vi klara oss med en.
Okej, vi lärde oss att ge databaser åtkomst till S3 och säkerhetskopior började hamna i lagringen. Hur får man säkerhetskopiorna att fungera i Operator UI?
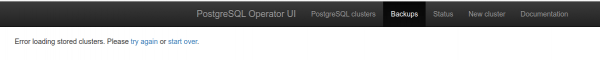
I Operator UI måste du lägga till 3 variabler:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Efter detta kommer hanteringen av säkerhetskopior att bli tillgänglig, vilket i vårt fall kommer att förenkla arbetet med staging, så att vi kan leverera snapshots från produktion utan extra skript.
Som en ytterligare fördel nämndes möjligheten att arbeta med Teams API och de stora möjligheterna att skapa databaser och roller med hjälp av operatören. Men de skapade rollerna hade inga standardbehörigheter. Därför kunde en användare med läsbehörighet inte läsa de nya tabellerna.
Varför är det så? Trots att det i koden nödvändiga GRANT, de tillämpas långt ifrån alltid. Det finns 2 metoder: syncPreparedDatabases och syncDatabases. I syncPreparedDatabases — trots att det i avsnittet preparedDatabases finns ett villkor defaultRoles och defaultUsers för att skapa roller, — tillämpas inte behörigheterna som standard. Vi är i färd med att förbereda en patch så att dessa rättigheter automatiskt tillämpas.
Och den sista punkten bland de aktuella förbättringarna — , som lägger till Node Affinity i den skapade StatefulSet. Våra kunder föredrar ofta att minska kostnaderna genom att använda spot-instanser, och det är uppenbart inte lämpligt att placera databastjänster på dem. Denna fråga skulle också kunna lösas med tolerans, men att ha Node Affinity ger större säkerhet.
Vad blev resultatet?
Som resultat av att lösa de nämnda problemen har vi forkat Postgres Operator från Zalando till , där den byggs med så användbara patchar. Och för att öka bekvämligheten har vi också .
Lista över PR:er som tagits emot i forken:
- ;
- ;
- ;
- .
Det vore fantastiskt om gemenskapen kunde stödja dessa PR:er så att de kom med i upstream med nästa version av operatören (1.6).
Bonus! Framhävt projekt med migrering av produktion
Om du använder Patroni kan du migrera en livsproduktion med minimal nedtid till operatören.
Spilo möjliggör att skapa standby-kluster via S3-lagringar med , där den binära loggen för PgSQL först sparas i S3 och sedan hämtas av replik. Men vad gör man om du inte använder Wal-E i en gammal infrastruktur? Lösningen på detta problem har redan på Habré.
Logisk replikering av PostgreSQL kommer till hjälp. Men vi ska inte gå in på detaljer om hur man skapar pub-likningar och prenumerationer, eftersom… vår plan misslyckades.
Problemet är att databasen hade flera tunga tabeller med miljontals rader, som dessutom hela tiden fylldes på och togs bort. med copy_data, när en ny replik kopierar allt innehåll från mästaren, hängde helt enkelt inte med mästaren. Innehållskopieringen fungerade i en vecka men nådde aldrig mästaren. Till slut hjälpte det att få klarhet i problemet genom kollegor från Avito: man kan flytta data med hjälp av pg_dump. Jag kommer att beskriva vår (lite modifierade) version av denna algoritm.
Idén är att skapa en inaktiv prenumeration kopplad till en specifik replikationsslot och sedan korrigera transaktionsnumret. Det fanns repliker tillgängliga för produktionsarbetet. Detta är viktigt eftersom repliken kommer att skapa en konsekvent dump och fortsätta ta emot ändringar från master.
I de följande kommandona som beskriver migrationsprocessen kommer följande beteckningar att användas för värdarna:
- master — ursprunglig server;
- replica1 — strömrepliken på den gamla produktionen;
- replica2 — ny logisk replik.
Migrationsplan
1. Skapa en prenumeration för alla tabeller i schemat public av databasen dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Skapa en replikationsslot på master:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Stoppa replikationen på den gamla repliken:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Hämta transaktionsnumret från master:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Ta en dump från den gamla repliken. Vi kommer att göra detta med flera trådar, vilket kommer att påskynda processen:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Ladda upp dumpen till den nya servern:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. Efter att dumpen har laddats kan replikationen startas på strömrepliken:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. Skapa en prenumeration på den nya logiska repliken:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. Hämta oid prenumerationen:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Anta att vi har fått oid=1000. Tillämpa transaktionsnumret på prenumerationen:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
10. Starta replikationen:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. Kontrollera statusen för prenumerationen, replikationen bör fungera:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. Efter att replikationen har startat och databaserna har synkroniserats kan omkopplingen göras.
13. Efter att replikationen har stängts av är det nödvändigt att korrigera sekvenserna. Detta är väl beskrivna .
Tack vare denna plan blev omkopplingen av med minimal fördröjning.
Slutsats
Kubernetes-operatörer gör det möjligt att förenkla olika åtgärder genom att reducera dem till att skapa K8s-resurser. Men när man uppnår fantastisk automatisering med deras hjälp, bör man komma ihåg att det också kan medföra vissa oväntade nuanser, så var noga med att smart välja operatörer.
Efter att ha granskat tre av de mest populära Kubernetes-operatörerna för PostgreSQL, valde vi projektet från Zalando. Vi stötte dock på vissa svårigheter, men resultatet överraskade verkligen positivt, så vi planerar att utvidga denna erfarenhet till andra PgSQL-installationer. Om du har erfarenhet av liknande lösningar – vi ser fram emot att läsa dina detaljer i kommentarerna!
P.S.
Läs även i vår blogg:
- «»;
- «»;
- «».
Källa: habr.com
