

Hej igen! Artikelns rubrik talar för sig själv. I förberedelse inför kursstart erbjuder vi en grundlig genomgång av vad dataingenjörer faktiskt är. I artikeln finns många användbara länkar. Trevlig läsning.
En enkel guide om hur man fångar vågen av data engineering och inte låter den dra ner en i avgrunden.
Det känns som att alla idag vill bli data scientist. Men hur är det med data engineering? I grunden är det en slags hybrid mellan dataanalytiker och data scientist; en dataingenjör ansvarar vanligtvis för hantering av arbetsflöden, processlinjer och ETL-processer.Med tanke på viktigheten av dessa funktioner är detta för närvarande ännu ett populärt professionellt buzzword som aktivt växer.
Hög lön och enorm efterfrågan är bara en del av vad som gör detta jobb oerhört attraktivt! Om du vill gå med i hjältarnas skara är det aldrig för sent att börja lära sig. I detta inlägg har jag samlat all nödvändig information för att hjälpa dig att ta de första stegen.
Så, låt oss börja!
Vad är data engineering?
Ärligt talat finns det ingen bättre förklaring än detta:
“En forskare kan upptäcka en ny stjärna, men kan inte skapa den. Han måste be en ingenjör göra det åt honom.”
–Gordon Lindsay Glegg
Därmed är rollen som dataingenjör ganska betydelsefull.
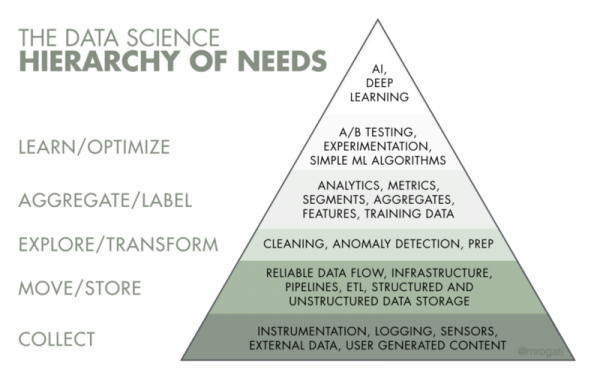
Av namnet framgår att data engineering handlar om data, nämligen om deras leverans, lagring och bearbetning. Huvuduppgiften för ingenjörerna är att säkerställa en pålitlig infrastruktur för data. Om vi ser på AI-hierarkin över behov, ligger data engineering i de första 2–3 stegen: insamling, flytt och lagring, datatillagning.
Vad gör en dataingenjör?
Med framväxten av stordata har ansvarsområdena förändrats drastiskt. Tidigare skrev dessa experter stora SQL-frågor och flyttade data med hjälp av verktyg som Informatica ETL, Pentaho ETL, Talend, men nu har kraven på dataingenjörer ökat.
De flesta företag med lediga tjänster för dataingenjörer ställer följande krav:
- Utmärkt kunskap i SQL och Python.
- Erfarenhet av molnplattformar, särskilt Amazon Web Services.
- Det är en fördel med kunskap i Java/Scala.
- God förståelse för SQL- och NoSQL-databaser (datamodellering, datalagring).
Tänk på att detta bara är det mest nödvändiga. Från denna lista kan man anta att dataingenjörer är specialister inom mjukvaruutveckling och backend.
Till exempel, om ett företag börjar generera stora mängder data från olika källor, är din uppgift som dataingenjör att organisera insamlingen av information, dess bearbetning och lagring.
Listan över verktyg som används i det här fallet kan variera, allt beror på mängden data, hastigheten på deras inkommande och heterogeniteten. De flesta företag ställs överhuvudtaget inte inför stora data, så för ett centralt lagringsutrymme, det så kallade datalagret, kan en SQL-databas (PostgreSQL, MySQL etc.) användas med ett litet antal skript som dirigerar data till lagret.
IT-jättar som Google, Amazon, Facebook eller Dropbox ställer högre krav: kunskap om Python, Java eller Scala.
- Erfarenhet av stora datamängder: Hadoop, Spark, Kafka.
- Kunskap om algoritmer och datastrukturer.
- Förståelse för grunderna i distribuerade system.
- Erfarenhet av datavisualiseringsverktyg, såsom Tableau eller ElasticSearch, är en stor fördel.
Det finns alltså en tydlig förskjutning mot stora data, särskilt i deras bearbetning under hög belastning. Dessa företag har höga krav på systemets fel tolerance.
Dataingenjörer Vs. dataforskare
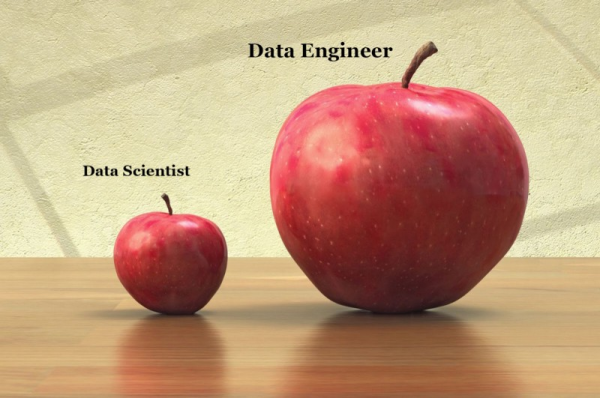
Okej, det här var en enkel och rolig jämförelse (inget personligt), men i verkligheten är det mycket mer komplicerat.
För det första måste du veta att det finns en hel del oklarhet kring skillnaderna mellan rollerna och färdigheterna hos dataforskare och dataingenjörer. Det vill säga, du kan lätt bli förvirrad över vilka färdigheter som verkligen behövs för att bli en framgångsrik dataingenjör. Självklart finns det vissa färdigheter som överlappar mellan båda rollerna. Men det finns också en rad diametralt motsatta färdigheter.
Data science är en seriös affär, men vi går mot en värld med funktionell data science, där praktiker är kapabla att göra sin egen analys. För att aktivera datarörledningar och integrerade datakonstruktioner behövs dataingenjörer snarare än forskare.
Är dataingenjörer mer eftertraktade än dataforskare?
— Ja, för innan du kan baka en morotskaka måste du först samla, rengöra och förse dig med morötter!
En dataingenjör har bättre kunskaper i programmering än någon data scientist, men när det kommer till statistik är allt precis tvärtom.
Men här är fördelen med en dataingenjör:
utan honom/henne strävar värdet av prototypmodellen, som oftast består av en del av dålig kod i en Python-fil, erhållen från data scientist och som på något sätt ger ett resultat, mot noll.
Utan dataingenjören kommer den här koden aldrig att bli ett projekt, och inget affärsproblem kommer att lösas effektivt. Dataingenjören försöker omvandla allt detta till en produkt.
Grunderna som varje dataingenjör bör känna till
Så om detta jobb väcker liv i dig och du är full av entusiasm — du kan lära dig detta, du kan behärska alla nödvändiga färdigheter och bli en riktig rockstjärna inom datateknik. Och ja, du kan åstadkomma detta även utan programmeringsfärdigheter eller annan teknisk kunskap. Det är svårt, men möjligt!
Vad är första stegen?
Du måste ha en allmän uppfattning om vad som är vad.
Först och främst handlar dataengineering om datavetenskap. Specifikt — du måste förstå effektiva algoritmer och datastrukturer. För det andra, eftersom dataingenjörer arbetar med data, måste det finnas en förståelse för principerna bakom databaser och de strukturer som ligger till grund för dem.
Till exempel, vanliga B-tree SQL-databaser baseras på datastrukturen B-Tree, och i moderna distribuerade förråd, LSM-Tree och andra varianter av hash-tabeller.
* Dessa steg baseras på en fantastisk artikel . Så om du kan ryska, stöd denna författare och läs .
1. Algoritmer och datastrukturer
Att använda rätt datastruktur kan avsevärt förbättra algoritmens prestanda. Idealiskt sett bör vi alla studera datastrukturer och algoritmer i våra skolor, men det är sällan som det lyfts fram. I vilket fall som helst är det aldrig för sent att bekanta sig.
Så här är mina favoritgratiskurser för att lära sig datastrukturer och algoritmer:
Och glöm inte den klassiska boken om algoritmer av Thomas Cormen — . Det är den perfekta referensen när du behöver fräscha upp ditt minne.
- För att förbättra dina färdigheter, använd .
Du kan också dyka ner i databashanteringens värld med fantastiska videor från Carnegie Mellon University på Youtube:
- .
- .
2. Lär dig SQL
Hela vårt liv handlar om data. Och för att extrahera dessa data från en databas måste du "prata" med dem på samma språk.
SQL (Structured Query Language — strukturerat frågespråk) är kommunikationsspråket inom datavärlden. Oavsett vad någon säger, SQL har funnits, finns fortfarande och kommer att finnas länge framöver.
Om du har varit inom utveckling under en längre tid har du förmodligen lagt märke till att rykten om SQL:s snara död dyker upp då och då. Språket skapades i början av 70-talet och är fortfarande oerhört populärt bland analytiker, utvecklare och helt enkelt entusiaster.
Utan kunskap om SQL har du inget att göra inom datateknik, eftersom du oundvikligen kommer att behöva skapa frågor för att extrahera data. Alla moderna stora datalager stödjer SQL:
- Amazon Redshift
- HP Vertica
- Oracle
- SQL Server
… och många fler.
För att analysera stora datamängder lagrade i distribuerade system som HDFS, har SQL-mekanismer uppfunnits: Apache Hive, Impala osv. Ser du, det är inte på väg att försvinna.
Hur lär man sig SQL? Gör det genom praktik.
För detta skulle jag rekommendera att ta en titt på en utmärkt bok som för övrigt är gratis, av .
En utmärkande funktion hos dessa kurser är den interaktiva miljön där du kan skriva och köra SQL-frågor direkt i webbläsaren. Resursen kommer att vara användbar. Och du kan tillämpa dessa kunskaper i i databassektionen.
3. Programmering i Python och Java/Scala
Varför du bör lära dig programmeringsspråket Python har jag redan skrivit i artikeln . När det gäller Java och Scala är de flesta verktyg för lagring och bearbetning av stora datamängder skrivna på dessa språk. Till exempel:
- Apache Kafka (Scala)
- Hadoop, HDFS (Java)
- Apache Spark (Scala)
- Apache Cassandra (Java)
- HBase (Java)
- Apache Hive (Java)
För att förstå hur dessa verktyg fungerar behöver du veta vilka språk de är skrivna i. Den funktionella ansatsen i Scala gör det möjligt att effektivt lösa problem med parallell databehandling. Tyvärr kan Python inte skryta med samma hastighet och parallell bearbetning. Överlag påverkar kunskapen om flera språk och programmeringsparadigm positivt bredden på tillvägagångssätten för att lösa problem.
För att dyka ner i språket Scala kan du läsa av språkets skapare. Företaget Twitter har också publicerat en bra introduktion — .
När det gäller Python anser jag att är den bästa boken på medelnivå.
4. Verktyg för arbete med stora data
Här är en lista över de mest populära verktygen inom stora data:
- Apache Spark
- Apache Kafka
- Apache Hadoop (HDFS, HBase, Hive)
- Apache Cassandra
Mer information om hur man bygger stora datamängder kan du hitta i denna fantastiska . De mest populära verktygen är Spark och Kafka. De är definitivt värda att studera, och det är bra att förstå hur de fungerar inifrån. Jay Kreps (medförfattare till Kafka) publicerade 2013 ett monumentalt arbete , för övrigt användes de grundläggande idéerna från denna text för att skapa Apache Kafka.
- En introduktion till Hadoop kan vara .
- Det mest omfattande guiden till Apache Spark för mig är — .
5. Molnplattformar
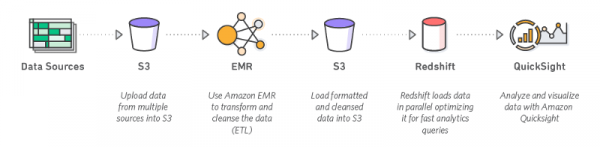
Att ha kunskap om minst en molnplattform är en grundläggande krav för kandidater till positionen som dataingenjör. Arbetsgivare föredrar Amazon Web Services, följt av Googles molnplattform och på tredje plats Microsoft Azure.
Du bör ha god kännedom om Amazon EC2, AWS Lambda, Amazon S3, DynamoDB.
6. Distribuerade system
Arbete med stora data innebär att man har kluster av självständigt fungerande datorer, vars kommunikation sker över nätverket. Ju större klustret är, desto större är risken för att vissa noder misslyckas. För att bli en duktig expert inom data behöver du förstå problemen och de befintliga lösningarna för distribuerade system. Detta område är gammalt och komplext.
Andrew Tanenbaum anses vara en pionjär inom detta område. För dem som inte är rädda för teori rekommenderar jag hans bok , för nybörjare kan den verka svår, men den kommer verkligen att hjälpa dig att finslipa dina färdigheter.
Jag anser vara den bästa introduktionsboken. För övrigt har Martin en fantastisk . Hans arbete kommer att hjälpa till att systematisera kunskapen om att bygga modern infrastruktur för lagring och bearbetning av stora data.
För dem som gillar att titta på videor finns det en kurs på Youtube .
7. Datapipelines
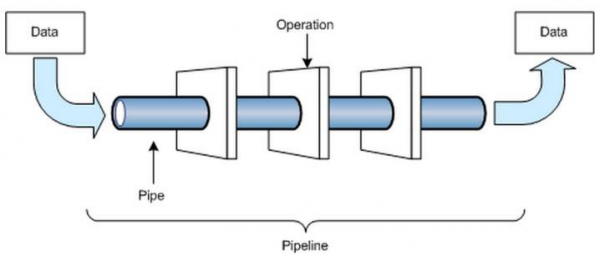
Datapipelines är något du inte kan leva utan som dataingenjör.
Stor del av tiden bygger dataingenjören så kallade datarörledningar, det vill säga skapar en process för att leverera data från en plats till en annan. Det kan vara användarscenarier som går till en API från en extern tjänst eller gör SQL-frågor, kompletterar data och placerar dem i ett centraliserat datalager (databas) eller ett lager av ostrukturerade data (data lakes).
Sammanfattningsvis: den grundläggande checklistan för en dataingenjör
Låt oss sammanfatta — det krävs en god förståelse för följande:
- Informationssystem;
- Programvaruutveckling (Agile, DevOps, Designtekniker, SOA);
- Distribuerade system och parallellprogrammering;
- Grunderna i databaser — planering, design, drift och felsökning;
- Experimentdesign — A/B-tester för att bevisa koncept, bestämma pålitlighet, systemprestanda, samt för att utveckla tillförlitliga vägar för operationell leverans av bra lösningar.
Detta är bara några krav för att bli dataingenjör, så studera och förstå datorsystem, informationssystem, kontinuerlig leverans/deployment/integration, programmeringsspråk och andra ämnen inom datavetenskap (inte inom alla ämnesområden).
Och, slutligen, det senaste, men mycket viktiga jag vill säga.
Vägen till att bli Data Engineer är inte så enkel som det kan verka. Den förlåter inte, frustrerar, och du måste vara beredd på detta. Vissa ögonblick på denna resa kan få dig att vilja ge upp. Men detta är verkligt arbete och en lärandeprocess.
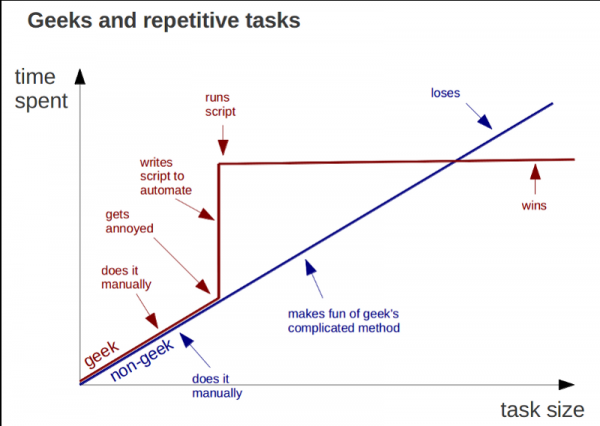
Snygga inte till det från början. Hela poängen med resan är att lära sig så mycket som möjligt och vara redo för nya utmaningar.
Här är en fantastisk bild som jag stötte på, som illustrerar denna punkt väl:
Och ja, glöm inte att undvika utbrändhet och ta pauser. Det är också mycket viktigt. Lycka till!
Vad tyckte ni om artikeln, vänner? Vi välkomnar er till , som äger rum idag klockan 20.00. Under webbinariet kommer vi att diskutera hur man bygger ett effektivt och skalbart system för databehandling för ett litet företag eller start-up med minimala kostnader. Som praktisk övning kommer vi att bekanta oss med verktyg för databehandling i Google Cloud. Vi ses!
Källa: habr.com
