

Obs. övers.: Dailymotion — en av världens största videohotellstjänster och en framträdande användare av Kubernetes. I detta material delar systemarkitekten David Donchez med sig av resultaten från företagets produktion plattform som skapades på K8s, vilken började som en molninstallation i GKE och avslutades som en hybridlösning, vilket möjliggjorde bättre svarstider och minskade infrastrukuturskostnader.
När vi beslutade oss för att bygga om huvud-API:et för tre år sedan, ville vi utveckla ett mer effektivt sätt att distribuera applikationer och förenkla För detta ändamål valde vi att använda en containerorkestreringsplattform och valde naturligtvis Kubernetes.
Varför skapa en egen plattform baserad på Kubernetes?
Produktion-API på kort tid med hjälp av Google Cloud
Sommaren 2016
Tre år sedan, direkt efter köpet av Dailymotion av , fokuserade våra ingenjörsteam på ett enda globalt mål: att skapa en helt ny produkt för Dailymotion.
Efter att ha analyserat containrar, orkestreringslösningar och vår tidigare erfarenhet var vi övertygade om att Kubernetes var rätt val. En del av våra utvecklare hade redan förståelse för de grundläggande koncepten och visste hur man använder det, vilket var en stor fördel för den infrastrukturella transformationen.
Från infrastrukturen sett krävdes ett kraftfullt och flexibelt system för att köra nya typer av molnbaserade applikationer. Vi valde att stanna kvar i molnet i början av vår resa för att snabbt bygga en så pålitlig lokal plattform som möjligt. Vi bestämde oss för att distribuera våra applikationer med Google Kubernetes Engine, även om vi visste att vi förr eller senare skulle flytta till våra egna datacenter och tillämpa en hybridstrategi.
Varför valde vi GKE?
Vi gjorde detta val främst av tekniska skäl. Dessutom krävdes det att vi snabbt skulle kunna tillhandahålla infrastruktur som svarade mot företagets behov. Vi hade vissa krav på applikationsdisposition, såsom geografisk spridning, skalbarhet och felresistens.
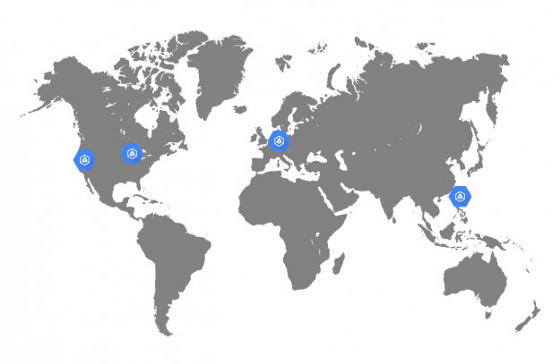
GKE-kluster på Dailymotion
Eftersom Dailymotion är en videoplattform tillgänglig över hela världen ville vi verkligen förbättra servicen genom att minska väntetiderna. (latency). Tidigare var tillgänglig endast i Paris, vilket var suboptimalt. Det skulle vara bra att kunna placera applikationer inte bara i Europa utan även i Asien och USA.
Denna känslighet för fördröjningar innebar att vi var tvungna att arbeta hårt med plattformens nätverksarkitektur. Medan de flesta molntjänster krävde att man skapade sitt eget nätverk i varje region och sedan kopplade ihop dem via VPN eller en sådan hanterad tjänst, tillät Google Cloud att skapa ett helt routbart enhetligt nätverk som täcker alla Google-regioner. Detta är en stor fördel när det gäller driftsättning och systemets effektivitet.
Dessutom fungerar nätverkstjänster och lastbalanserare från Google Cloud utmärkt. De låter helt enkelt använda valfria offentliga IP-adresser från varje region, och den fantastiska BGP-protokoll ser efter allt annat (d.v.s. dirigerar användare till närmaste kluster). Det är uppenbart att vid ett fel kommer trafiken automatiskt att flöda till en annan region utan mänsklig inblandning.
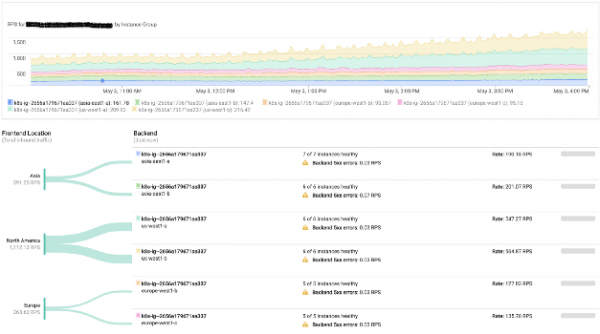
Övervakning av lastbalansering i Google
Vår plattform använder också grafiska processorer aktivt. Google Cloud möjliggör en mycket effektiv användning av dem direkt i Kubernetes-kluster.
Under tiden koncentrerade sig infrastrukturteamet huvudsakligen på den gamla stacken som var distribuerad på fysiska servrar. Det var därför användandet av hanterade tjänster (inklusive Kubernetes-mästarkomponenterna) uppfyllde våra krav och gjorde det möjligt att utbilda teamen i att arbeta med lokala kluster.
Som ett resultat kunde vi börja ta emot produktions trafik på Google Clouds infrastruktur bara sex månader efter att arbetet inleddes.
Men trots en rad fördelar är arbetet med en molnleverantör förenat med vissa kostnader som kan öka beroende på belastningen. Det är därför vi noga analyserade varje hanterad tjänst vi använde, med avsikt att i framtiden implementera dem lokalt. Faktum är att implementeringen av lokala kluster började i slutet av 2016, och en hybridstrategi initierades vid samma tidpunkt.
Lansering av Dailymotions lokala plattform för containerorkestrering
Hösten 2016
Under de omständigheter när hela stacken var redo för produktion och arbetet med API:n , det var en tid för att fokusera på regionala kluster.
Vid den tiden visade användarna varje månad mer än 3 miljarder videor. Självklart hade vi redan haft ett omfattande Content Delivery Network i drift i flera år. Vi ville utnyttja detta och rulla ut Kubernetes-kluster i de befintliga datacenter.
Dailymotion-infrastrukturen bestod av mer än 2 500 servrar i sex datacenter. Alla konfigureras med Saltstack. Vi började förbereda alla nödvändiga recept för att skapa master- och worker-noder, samt etcd-kluster.
Nätverksdel
Vårt nätverk är helt routbart. Varje server annonserar sin IP i nätverket med hjälp av Exabgp. Vi jämförde flera nätverksplugin och det enda som uppfyllde alla krav (på grund av den använda L3-approachen) var . Den passade perfekt in i den befintliga nätverksmodellen för infrastrukturen.
Eftersom vi ville använda alla befintliga element i infrastrukturen var det först och främst viktigt att förstå vårt egenutvecklade nätverksverktyg (använt på alla servrar): att använda det för att annonsera IP-adressområden i nätverket med Kubernetes-noder. Vi tillät Calico att tilldela IP-adresser till pods, men använde det inte och använder fortfarande inte för BGP-sessioner på nätverksutrustningen. Faktum är att routingen hanteras av Exabgp, som annonserar de subnät som används av Calico. Detta gör att vi kan nå varje pod från det interna nätverket (och särskilt från lastbalanserarna).
Hur vi hanterar ingress-trafik
För att omdirigera inkommande förfrågningar till rätt tjänst beslutades det att använda Ingress Controller på grund av dess integrering med ingress-resurser i Kubernetes.
För tre år sedan var nginx-ingress-controller den mest mogna kontrollern: Nginx hade använts länge och var känt för sin stabilitet och prestanda.
I vårt system har vi valt att placera kontrollerarna på dedikerade 10-gigabit blade-servrar. Varje kontroller kopplades till endpointen kube-apiserver i den aktuella klustret. På dessa servrar användes även Exabgp för att annonsera offentliga eller privata IP-adresser. Topologin i vårt nätverk möjliggör användning av BGP från dessa kontrollerare för att dirigera all trafik direkt till poddar utan att använda tjänster som NodePort. Denna strategi hjälper till att undvika horisontell trafik mellan noder och ökar effektiviteten.
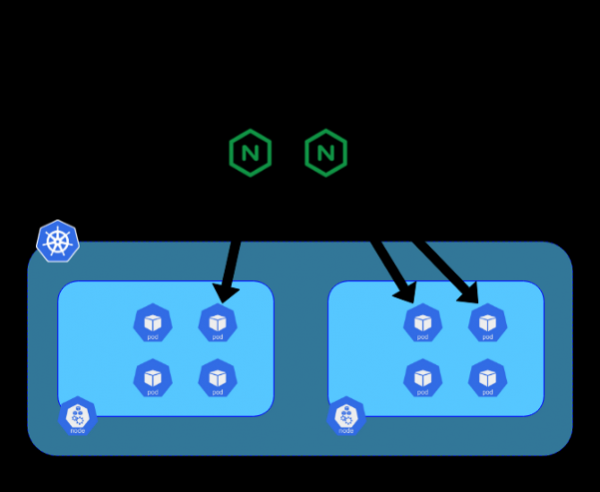
Trafikflödet från internet till poddar
Nu när vi har förstått vår hybridplattform kan vi fördjupa oss i själva trafikmigreringsprocessen.
Trafikmigration från Google Cloud till Dailymotion-infrastrukturen
Hösten 2018
Efter nästan två års skapande, testande och konfigurering har vi äntligen fått en fullständig Kubernetes-stack redo att ta emot en del av trafiken.
Den nuvarande routingstrategin är ganska enkel, men tillfredsställer fullt ut behoven. Förutom offentliga IP-adresser (i Google Cloud och Dailymotion) används AWS Route 53 för att definiera policyer och omdirigera användarna till klustret vi väljer.
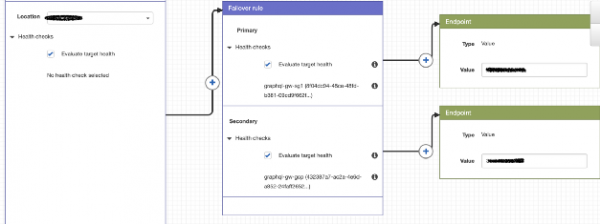
Exempel på routingpolicy med Route 53
Från Google Cloud är det enkelt, eftersom vi använder en enhetlig IP för alla kluster, och användaren omdirigeras till det närmaste GKE-klustret. För våra kluster är teknologin annorlunda, eftersom deras IP-adresser skiljer sig.
Under migreringen strävade vi efter att omdirigera regionala förfrågningar till motsvarande kluster och värderade fördelarna med detta tillvägagångssätt.
Eftersom våra GKE-kluster är konfigurerade för automatisk skalning med hjälp av Custom Metrics, ökar/minskar de kapaciteten beroende på inkommande trafik.
I normalläge dirigeras all regional trafik till det lokala klustret, medan GKE fungerar som reserv om det uppstår problem (hälsokontroller görs av Route 53).
…
I framtiden vill vi helt automatisera routingpolitiken för att uppnå en autonom hybridstrategi som ständigt förbättrar tillgängligheten för användarna. Fördelarna är att kostnaderna för molnet har minskat avsevärt och vi har även lyckats korta ner API-responstiderna. Vi litar på den resulterande molnplattformen och är redo att vid behov omdirigera mer trafik till den.
P.S. från översättaren
Kanske är du också intresserad av en annan nyligen publicerad artikel på Dailymotion om Kubernetes. Den handlar om att distribuera applikationer med Helm på flera Kubernetes-kluster och för ungefär en månad sedan.
Läs även i vår blogg:
- «».
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «».
Källa: habr.com
