

Källa:
Linear regression är en av de grundläggande algoritmerna för många områden kopplade till dataanalys. Anledningen till detta är uppenbar. Det är en mycket enkel och lättförståelig algoritm, vilket bidrar till dess breda tillämpning under många decennier, om inte hundratals år. Idén är att vi antar ett linjärt förhållande mellan en variabel och en uppsättning andra variabler, och sedan försöker vi återställa detta förhållande.
Men i denna artikel kommer vi inte att fokusera på tillämpningen av linjär regression för att lösa praktiska problem. Vi kommer istället att titta på intressanta egenskaper hos implementeringen av distribuerade algoritmer för dess återställande, som vi stötte på när vi skrev en modul för maskininlärning i . Lite grundläggande matematik, maskininlärningens och distribuerade beräkningars grundprinciper kan hjälpa oss att förstå hur man återställer linjär regression, även om data är spridda över tusentals noder.
Vad handlar det om?
Vi står inför uppgiften att återställa den linjära relationen. Som ingångsuppgifter ges en mängd vektorer av antas oberoende variabler, där varje enskild knyts till ett visst värde av den beroende variabeln. Dessa data kan representeras i form av två matriser:

Nu, eftersom vi antar att det finns ett beroende, och dessutom ett linjärt, kan vi skriva vår hypotes i form av en produkt av matriser (för att förenkla skrivningen antas här och framöver att den konstanta termen i ekvationen döljs bakom  , och den sista kolumnen i matrisen
 innehåller ettor):

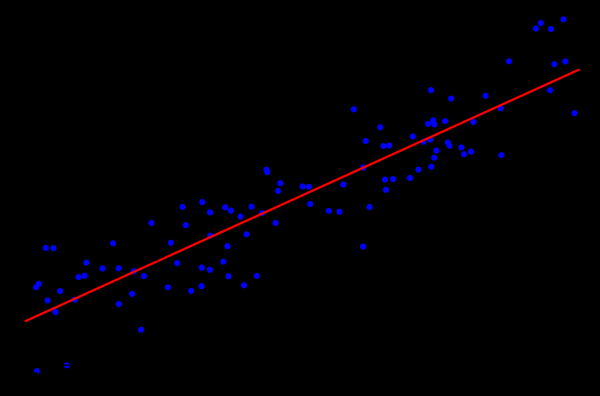
Det liknar mycket ett system av linjära ekvationer, eller hur? Det ser ut så, men den här typen av ekvationssystem har förmodligen inga lösningar. Anledningen till detta är det brus som nästan alltid finns i verkliga data. En annan orsak kan vara avsaknaden av ett linjärt beroende, vilket vi kan försöka övervinna genom att införa ytterligare variabler som icke-linjärt beror på de ursprungliga. Låt oss titta på följande exempel:
Källa:
Detta är ett enkelt exempel på linjär regression som visar beroendet av en variabel (på axeln  ) från en annan variabel (på axeln
 ). För att det linjära ekvationssystemet som motsvarar detta exempel ska ha en lösning, måste alla punkter ligga exakt på en och samma linje. Men så är det inte. De ligger inte på en linje just på grund av störningar (eller för att antagandet om en linjär beroende var felaktigt). Därför krävs det ofta att man gör ytterligare ett antagande för att återställa den linjära beroende med verkliga data: indata innehåller störningar och dessa störningar har . Man kan göra antaganden om andra typer av störningar, men i överväldigande majoriteten av fallen överväger man just normalfördelning, vilket kommer att diskuteras vidare.
Metoden för maximalt sannolikhet
Så vi har antagit att det finns en slumpmässig normalt fördelad störning. Hur ska vi då agera i en sådan situation? För detta finns det inom matematik en metod som är allmänt använd . I korthet handlar det om att välja och senare maximera den.
Vi återkommer till att återställa den linjära beroende med data som innehåller normal störning. Observera att den antagna linjära beroende är det matematiska förväntade värdet  av den aktuella normala fördelningen. Samtidigt är sannolikheten att
 ta ett visst värde givet att det finns observerade
 , ser ut som följande:

Nu sätter vi istället in  och
 de variabler vi behöver:

Det återstår bara att hitta vektorn  , där denna sannolikhet är maximal. För att maximera en sådan funktion är det praktiskt att först logaritmera den (logaritmen av funktionen når sitt maxima vid samma punkt som själva funktionen):

Detta leder i sin tur till att minimera följande funktion:

För övrigt kallas detta metoden . Ofta utelämnas alla ovanstående resonemang och denna metod används helt enkelt.
QR-faktorisering
Minimumpunkten för den angivna funktionen kan hittas genom att finna punkten där gradienten av denna funktion är noll. Gradient kommer att skrivas på följande sätt:

är en matrismetod för att lösa minimiseringsproblemet som används i metoden för minsta kvadrat. I denna mån omformulerar vi ekvationen i matrisform:

Så vi faktoriserar matrisen  till matriser
 och
 och utför en rad transformationer (själva QR-faktoriseringen kommer inte att diskuteras här, endast dess användning i förhållande till den uppställda uppgiften):

Matrisen  är ortogonal. Detta gör att vi kan bli av med produkten
 :

Om vi istället byter ut  till
 får vi
 . Med tanke på att
 är en övre triangulär matris, ser detta ut så här:

Detta kan lösas med substitutionsmetoden. Elementet  beräknas som
 , det föregående elementet
 beräknas som
 och hämta bilder från dab.semrush.com
Här är det värt att notera att den resulterande algoritmens komplexitet på grund av användningen av QR-faktorisering är  . Trots att matrismultiplikation kan parallelliseras väl, är det inte möjligt att skriva en effektiv distribuerad version av denna algoritm.
Gradientnedstigning
När man talar om att minimera en viss funktion är det alltid värt att nämna (stochastisk) gradientnedstigning. Detta är en enkel och effektiv metod för att minimera, baserat på iterativ beräkning av gradienten för funktionen vid en punkt och därefter förflyttning i riktningen motsatt gradienten. Varje sådant steg närmar lösningen till minimum. Gradientet ser fortfarande likadant ut:

Denna metod kan också parallelliseras och distribueras tack vare de linjära egenskaperna hos gradientoperatorn. Observera att i formeln ovan under summatecknet finns oberoende termer. Med andra ord kan vi beräkna gradienten oberoende för alla index  från den första till
 , samtidigt som vi beräknar gradienten för indexen från
 till
 . Därefter adderar vi de erhållna gradienterna. Resultatet av additionen kommer att vara detsamma som om vi direkt beräknade gradienten för indexen från den första till
 . Således, om data är distribuerade över flera datadelar, kan gradienten beräknas oberoende på varje del och resultaten av dessa beräkningar kan sedan summeras för att få det slutgiltiga resultatet:

Ur ett implementationsperspektiv passar detta in i paradigm . Vid varje steg av gradientnedstigningen skickas en uppgift att beräkna gradienten till varje datanod, sedan samlas de beräknade gradienterna ihop, och resultatet av deras summering används för att förbättra resultatet.
Trots den enkla implementeringen och möjligheten att utföra i MapReduce-paradigmen har gradientnedstigning sina brister. Särskilt antalet steg som krävs för att nå konvergens är betydligt större jämfört med andra mer specialiserade metoder.
LSQR
är en annan metod för att lösa det aktuella problemet som passar både för att återställa linjär regression och för att lösa system av linjära ekvationer. Dess huvudsakliga egenskap är att den kombinerar fördelarna med matrismetoder och iterativa tillvägagångssätt. Implementationer av denna metod kan hittas i biblioteken .ts . En beskrivning av denna metod kommer inte att ges här (den kan hittas i artikeln ). Istället kommer en metod att demonstreras som anpassar LSQR för att utföras i en distribuerad miljö.
Kärnan i LSQR-metoden är . Det är en iterativ procedur där varje iteration består av följande steg:
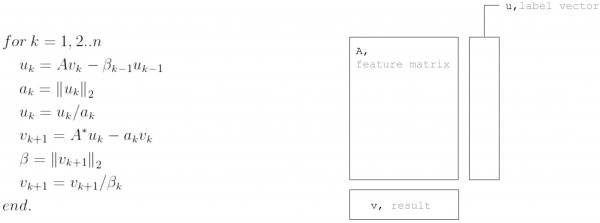
Men om vi utgår ifrån att matrisen  är horisontellt partitionerad kan varje iteration representeras i form av två MapReduce-steg. På så sätt minimeras datatransfereringen under varje iteration (bara vektorer med en längd som motsvarar antalet okända):
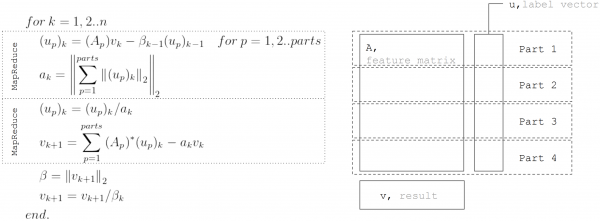
Just denna metod används vid implementeringen av linjär regression i .
Slutsats
Det finns många algoritmer för att återställa linjär regression, men inte alla av dem kan tillämpas under alla förhållanden. QR-zerlegung är utmärkt för exakta lösningar på små datamängder. Gradientnedstigning implementeras enkelt och tillåter snabbt att hitta en approximativ lösning. LSQR kombinerar de bästa egenskaperna från de två föregående algoritmerna, eftersom den kan distribueras, konvergerar snabbare jämfört med gradientnedstigning, och möjliggör tidig avstängning av algoritmen till skillnad från QR-zerlegung för att söka approximativa lösningar.
Källa: habr.com
