

Tolkning av Ilja Kosmodemjanskijs föreläsning från 2015 "Linux-justering för att förbättra PostgreSQL-prestanda"
Ansvarsfriskrivning: Jag vill påpeka att denna föreläsning är daterad till november 2015 – över 4 år har passerat och mycket har förändrats. Den version av PostgreSQL som diskuteras, 9.4, stöds inte längre. Under de senaste 4 åren har 5 nya versioner av PostgreSQL släppts och 15 nya versioner av Linux-kärnan. Om vi skulle skriva om dessa delar skulle vi i slutändan få en annan föreläsning. Men här behandlas grundläggande tuning av Linux för PostgreSQL som fortfarande är relevant idag.
Jag heter Ilja Kosmodemjanskij. Jag arbetar på företaget PostgreSQL-Consulting. Nu kommer jag att berätta lite om vad man ska göra med Linux med avseende på databaser i allmänhet och PostgreSQL i synnerhet, eftersom principerna är ganska lika.
Vad kommer vi att diskutera? Om du arbetar med PostgreSQL måste du till viss del vara en UNIX-administratör. Vad betyder det? Om vi jämför Oracle och PostgreSQL, så måste du i Oracle vara 80 % DBA och 20 % Linux-administratör.
Med PostgreSQL är det lite mer komplicerat. Med PostgreSQL behöver du ha en mycket bättre förståelse för hur Linux fungerar. Dessutom måste man lite snabbt hänga med i utvecklingen, eftersom allt uppdateras ganska kraftigt nu. Nya kärnor släpps, nya funktioner introduceras, prestandan förbättras osv.
Varför pratar vi om Linux? Inte för att vi är på Linux-konferensen i Sankt Petersburg, utan för att i moderna förhållanden är en av de mest lämpliga operativsystemen för användning med databaser överhuvudtaget och med PostgreSQL i synnerhet – det är Linux. För tyvärr utvecklas FreeBSD i en mycket konstig riktning. Och det kommer att bli problem både med prestanda och med många andra saker. PostgreSQL:s prestanda på Windows är en helt egen tuff fråga, vilket beror på att Windows inte har samma delade minne som UNIX, och PostgreSQL är helt beroende av detta eftersom det är ett flervalsystem.
Och exotiska system som Solaris, tror jag, intresserar en mindre grupp, så låt oss köra.
En modern Linux-distribution har mer än 1 000 syctl-parametrar, beroende på hur kärnan har byggts. Dessutom, om vi ser på andra inställningar, finns det många sätt att justera ytterligare. Det finns parametrar för filsystem, hur man ska montera. Om det finns frågor om hur man startar: vad man ska aktivera i BIOS, hur man konfigurerar hårdvaran osv.
Detta är en mycket stor mängd information som kan diskuteras i flera dagar, snarare än under en kort presentation, men jag kommer nu att fokusera på viktiga saker för att undvika de fallgropar som garanterat kommer att hindra er från att effektivt använda databasen på Linux om ni inte åtgärdar dem. Dessutom är det viktigt att många parametrar som standard inte är inställda på sådana inställningar som är korrekta för databasen. Med andra ord kommer den att fungera dåligt som standard eller kanske inte alls.
Vilka traditionella tuning-targets finns det i Linux? Jag tror att eftersom ni alla har att göra med Linux-administration, behöver jag inte förklara vad targets är.
Det går att tunna:
- CPU.
- Minne.
- Lagring.
- Övrigt. Det kommer vi att diskutera i slutet som en dessert. Till och med sådana parametrar som energisparpolicy kan påverka prestandan på ett mycket oförutsägbart och obehagligt sätt.
Vad är förhållandena för PostgreSQL och för databasen i allmänhet? Problemet är att man inte kan tunna någon enskild inställning och se att prestandan förbättras avsevärt.
Ja, sådana inställningar finns, men databasen är en komplex enhet. Den interagerar med alla resurser som finns på servern och föredrar att interagera maximalt. Om ni ser på moderna rekommendationer från Oracle om hur man använder värd-operativsystemet, så blir det som i skämtet om den mongoliska kosmonauten – ge hunden mat och rör inte vid något. Låt databasen ha alla resurser, databasen klarar av att hantera allt själv.
I princip är situationen med PostgreSQL exakt den samma, till viss del. Skillnaden är att databasen ännu inte kan ta alla resurser själv, det vill säga att ibland måste man hantera det hela på Linux-nivå.
Huvudidén är inte att välja en specifik target och börja optimera saker som minne, CPU eller något liknande, utan att analysera arbetsbelastningen och försöka förbättra genomströmningen maximalt så att den belastning som våra duktiga programmerare har skapat, inklusive våra användare, effektivt kan passera genom vår databas.
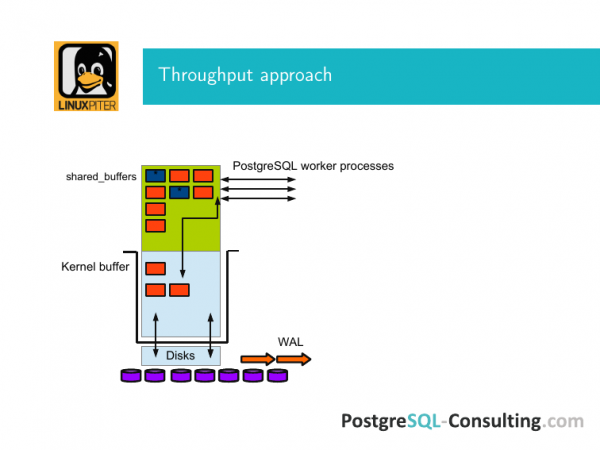
Här är en bild för att förklara vad det handlar om. Det finns en buffert för OS Linux, det finns delat minne och delade buffertar för PostgreSQL. Till skillnad från Oracle arbetar PostgreSQL direkt genom kärnbufferten, det vill säga, för att en sida från disken ska komma in i dess delade minne måste den passera genom kernelbufferten, och exakt samma situation är aktuell.
Under detta system finns diskarna. Jag har ritat det som diskar. I verkligheten kan det finnas en RAID-kontroller och så vidare.
Och den här in- och utmatningen sker på ett eller annat sätt genom detta.
PostgreSQL är en klassisk databas. Där inne finns sidor. All in- och utmatning sker via sidor. Vi lyfter blocken till minnet med sidor. Och om inget har hänt, om vi bara har läst dem, så sjunker de gradvis från denna cache, från de delade buffertarna och hamnar tillbaka på disken.
Om vi har bytt något, så markeras hela sidan som smutsig. Jag har markerat dem med blått här. Och detta betyder att denna sida måste synkroniseras med blocklagringen. När vi gjorde den smutsig gör vi en skrivning i WAL. Och vid något fantastiskt ögonblick inträffar ett fenomen som kallas checkpoint. Information om att den kommit in skrivs in i den loggen. Detta betyder att alla smutsiga sidor som fanns i dessa delade buffertar vid den tidpunkten synkroniserades med lagringsdisken via fsync genom kernelbufferten.
Varför görs detta? Om vi förlorar strömmen får vi inte en situation där all data försvinner. Den persistenta minnet som alla talar om är fortfarande i teorin för databaser – det är en ljus framtid som vi naturligtvis strävar efter och som vi gillar, men hittills lever de fortfarande i minus 20 år. Och självklart måste man hålla ögonen på allt detta.
Och uppgiften att maximera bandbredden är att justera i alla dessa steg så att data skickas fram och tillbaka snabbt. Dela minnet – det är främst en sidcache. I PostgreSQL skickade vi en select-fråga för något, och den hämtade dessa data från disken. De hamnade i de delade buffrarna. Därför, för att detta ska fungera bättre, bör det finnas mycket minne.
För att allt detta ska fungera bra och snabbt måste operativsystemet ställas in korrekt i alla steg. Och välja balanserad hårdvara, för om det finns obalans någonstans kan ni ha mycket minne, men det kommer att servas med otillräcklig hastighet.
Och vi kommer att gå igenom varje punkt.
För att dessa sidor ska transporteras fram och tillbaka snabbare behöver vi nå följande:
- För det första måste vi arbeta mer effektivt med minnet.
- För det andra måste denna övergång, när sidor från minnet går till disken, vara effektivare.
- Och för det tredje måste vi ha bra diskar.
Om ni har 512 GB RAM i servern och allt detta slutligen kommer till en SATA-hårddisk utan något cache, så blir hela databasservern inte bara en pumpa, utan en pumpa med SATA-gränssnitt. Ni kommer att stöta på detta direkt. Och inget kommer att rädda er.
Vad gäller den första punkten om minnet så finns det tre saker som kan göra livet mycket svårare.
Den första är NUMA. NUMA är något som skapades för att förbättra prestanda. Beroende på arbetsbelastningen kan olika saker optimeras. I sin nuvarande form är den inte särskilt bra för sådana applikationer som databaser, som intensivt använder sidcache och delade buffrar.
Kort sagt. Hur förstår man att något är fel med NUMA? Ni har något obehagligt knakande, plötsligt visar sig någon CPU vara överbelastad. Under tiden analyserar ni frågorna i PostgreSQL och ser att det inte finns något som liknar det. Dessa frågor bör inte konsumera CPU så intensivt. Det kan ta tid att fånga detta. Det är enklare att från början använda rätt rekommendationer för hur man ställer in NUMA för PostgreSQL.
Vad händer egentligen? NUMA står för Non-Uniform Memory Access. Vad handlar det om? Ni har en CPU, och bredvid den finns dess lokala minne. Och detta minnet kan interconnecta och dra minne från andra CPU:er.
Om ni kör numactl --hardware, så får du ett stort dokument. Bland annat kommer det att finnas ett fält för avstånd. Det kommer att finnas siffror – 10-20, något i den stilen. Dessa siffror är inget annat än antalet hopp för att koppla på detta avlägsna minne och använda det lokalt. I princip en bra idé. Det förbättrar prestandan vid viss belastning.
Tänk dig nu att du har en CPU som först försöker använda sitt lokala minne, sedan försöker dra in annat minne via interconnecten för något. Och hela din page cache för PostgreSQL hamnar på den här CPU:n – allt, flera gigabyte. Du får alltid det värsta fallet, eftersom det vanligtvis finns lite minne direkt tillgängligt i denna minnesmodul. Och allt minne som används passerar genom dessa interconnects. Det blir långsamt och sorgligt. Och din processor som hanterar denna nod är ständigt överbelastad. Och åtkomsttiden för detta minne är dålig, långsam. Det är den situationen du inte vill ha om du använder detta för en databas.
Därför är den mer korrekta lösningen för databasen att operativsystemet Linux överhuvudtaget inte ska veta vad som pågår där. Så att det kan adressera minnet som det gör.
Varför är det så? Det verkar som att det borde vara tvärtom. Det beror på en enkel anledning, att vi behöver mycket minne för page cache – tiotals, hundratals gigabyte.
Och om vi har allokart detta och cachat våra data där, så kommer vinsten av att använda cachen att vara avsevärt större än vinsten av denna snikna minneshantering. Och på så sätt kommer vi att tjäna oproportionerligt mycket i jämförelse med att effektivare komma åt minnet med hjälp av NUMA.
Därför finns det två tillvägagångssätt för tillfället, tills en ljus framtid kommer och databasen kan förstå på vilka CPU:er den arbetar och varifrån den behöver dra något.
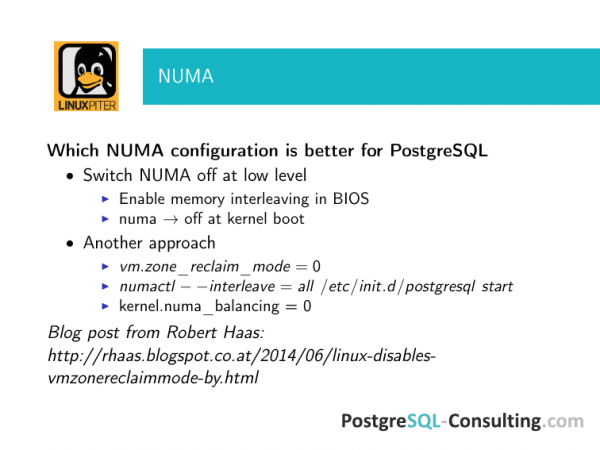
Därför är rätt tillvägagångssätt att helt stänga av NUMA, till exempel vid omstart. I de flesta fall är vinsterna så stora att frågan hur man ska göra det bättre överhuvudtaget inte uppstår.
Det finns ett annat alternativ. Vi använder det oftare än det första, eftersom när en kund kommer till oss för support, så är en serveromstart en stor sak för dem. De har sin verksamhet igång. Och de upplever problem med NUMA. Därför försöker vi stänga av det på mindre påträngande sätt än genom omstart, men här måste ni vara försiktiga och kontrollera att det verkligen har stängts av. För som erfarenheten visar, det som vi stänger av i förälderprocessen PostgreSQL NUMA fungerar bra, men det är inte nödvändigtvis så att det alltid funkar. Det är viktigt att kontrollera och se till att det verkligen har stängts av.
Det finns ett bra inlägg av Robert Haas. Han är en av committerna för PostgreSQL. En av huvudutvecklarna av all låg nivå teknik. Och om man följer länkarna i detta inlägg, så beskrivs det några färgstarka historier om hur NUMA har komplicerat livet för folk. Ta en titt, gå igenom checklisten för systemadministratörer, vad som behöver konfigureras på servern så att vår databas fungerar bra. Dessa inställningar måste noteras och kontrolleras, för annars blir det inte så bra.
Jag påpekar att detta gäller alla inställningar som jag kommer att prata om. Men vanligtvis samlar databaser ihop i master-slave för redundans. Glöm inte att göra dessa inställningar på slaven, för vid något tillfälle kommer ni att få en krasch, och ni kommer att växla till slaven, och den kommer att bli master.
I en nödsituation, när allt är mycket illa, ringer telefonen ständigt och chefen springer in med en stor käpp, då kommer ni inte att ha tid att tänka på att kontrollera. Och resultaten kan bli sorgliga.
Den nästa punkten är huge pages. Huge pages är svåra att testa separat, och det finns inte mycket mening med det, även om det finns benchmarker som kan göra det. De är lätta att googla.
Vad är meningen? Ni har en inte särskilt dyr server med mycket RAM, exempelvis mer än 30 GB. Ni använder inte huge pages. Detta betyder att ni definitivt har overhead när det gäller minnesanvändning. Och den overheaden är långt ifrån trevlig.
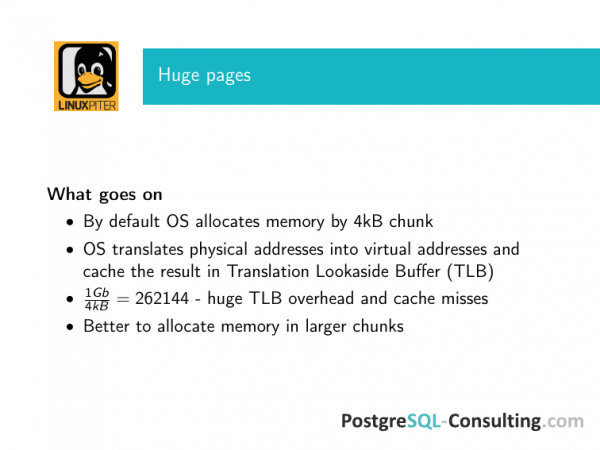
Varför är det så? Och vad händer? Operativsystemet delar upp minnet i små bitar. Det är praktiskt så, och det har alltid varit så. Går man in på detaljer, så måste operativsystemet översätta virtuella adresser till fysiska. Och det är en ganska komplicerad process, därför lagrar operativsystemet resultatet av denna operation i Translation Lookaside Buffer (TLB).
Och eftersom TLB är en cache, uppstår alla de problem som är förknippade med cachen i denna situation. För det första, om du har väldigt mycket RAM och det är helt uppdelat i små bitar, så blir denna buffer mycket stor. Och om cachen är stor, tar det längre tid att söka i den. Det finns en stor overhead som i sig upptar utrymme, vilket innebär att RAM förbrukar något olämpligt. Det är punkt ett.
För det andra – ju mer cachen växer i denna situation, desto större är risken att du får cache misses. Effektiviteten hos denna cache sjunker kraftigt med ökad storlek. Därför har man i operativsystemen utvecklat en enkel lösning. I Linux har det använts länge. I FreeBSD har det nyligen införts. Men vi pratar om Linux. Det handlar om huge pages.
Det bör noteras att huge pages, som idé, ursprungligen förespråkades av samhällen som inkluderade Oracle och IBM, det vill säga, databasproducenter tänkte verkligen att detta skulle vara användbart, även för databaser.
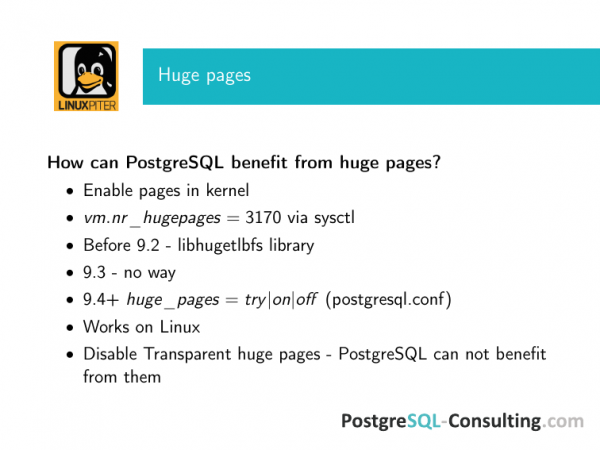
Och hur kan man integrera detta med PostgreSQL? För det första måste huge pages vara aktiverade i Linux-kärnan.
För det andra måste de anges tydligt som en sysctl-parameter – hur många av dem. Dessa siffror kommer från en gammal server. Du kan beräkna hur många shared buffers du ungefär har, så att huge pages får plats där.
Och om hela servern är tillägnad PostgreSQL, då är en bra utgångspunkt att antingen ge 25 % av RAM till shared buffers, eller 75 %, om du är säker på att din databas får plats i dessa 75 %. Det första utgångsvärdet. Och räkna, om du har 256 GB RAM, så får du alltså 64 GB som shared buffers. Räkna ungefär med ett visst överskott – vilket värde detta ska ställas in på.
Före version 9.2 (om jag minns rätt, från version 8.2) var det möjligt att använda ett tredjepartsbibliotek för att ansluta PostgreSQL med huge pages. Och det är alltid nödvändigt att göra. För det första behöver du att kärnan kan allokera huge pages på rätt sätt. För det andra måste applikationen som arbetar med dem kunna använda dem. Den kan inte bara använda dem utan vidare. Eftersom PostgreSQL allokerade minne med system 5-stilen, kunde detta göras med hjälp av libhugetlbfs – det fullständiga namnet på biblioteket.
I 9.3 förbättrades PostgreSQL:s prestanda när det gällde minneshantering och de övergav system 5-metoden för minnesallokering. Alla blev mycket glada, för annars försöker du starta två PostgreSQL-instanser på en maskin, och den säger att den har brist på delat minne. Och den säger att du måste justera sysctl. Och där är sysctl så att du också måste starta om och så vidare. Sammanfattningsvis blev alla glada. Men minnesallokeringen med mmap bröt användningen av huge pages. De flesta av våra kunder använder stora delade buffrar. Och vi rekommenderade starkt att inte uppgradera till 9.3, eftersom overheadet började räkna i goda procent.
Men gemenskapen uppmärksammade detta problem, och i 9.4 förbättrades detta avsevärt. I 9.4 kom en parameter i postgresql.conf, där man kan aktivera try, on eller off.
Try är den säkraste parametern. När PostgreSQL startar och allokerar delat minne, försöker den ta minnet från huge pages. Om det inte lyckas, faller den tillbaka på vanlig allokering. Om du har FreeBSD eller Solaris kan du sätta try, det är alltid säkert.
Om on är aktivt startar den helt enkelt inte om den inte kan allokera från huge pages. Här handlar det verkligen om vad som passar bäst för er. Men om du har try, kontrollera att det verkligen har allokerats det som behövs, för det finns mycket utrymme för fel. För tillfället fungerar denna funktionalitet endast på Linux.
Ett litet ytterligare påpekande innan vi går vidare. Transparent huge pages handlar inte om PostgreSQL just nu. Den kan inte dra nytta av dem på ett bra sätt. När det kommer till transparent huge pages för sådana arbetsbelastningar där en stor del av det delade minnet krävs, så börjar fördelarna uppträda först vid mycket stora mängder. Om ni har terabyte av minne kan det spela roll. Om vi pratar om mer vardagliga tillämpningar, där ni har 32, 64, 128 eller 256 GB minne på maskinen, så är vanliga huge pages okej, medan transparent bara stängs av.
Och den sista punkten kring minne, som inte är direkt kopplad till genomströmningen, kan verkligen förstöra livet. Hela bandbredden lider kraftigt av att servern ständigt växlar.
Och detta kommer att vara väldigt obehagligt i många situationer. Den största besväret ligger i att beteendet hos moderna kärnor avviker lite från äldre Linux-kärnor. Och detta är något man helst vill undvika, för när vi pratar om att arbeta med swap så slutar det inte med en snabb Ankomst av OOM-killer. Och OOM-killer som inte kom i tid och stängde ner PostgreSQL är obehagligt. Detta kommer alla att märka, det vill säga ända till den sista användaren.
Vad händer? Ni har en stor mängd RAM, allt fungerar bra. Men av någon anledning hänger servern i swap och fördröjer på grund av detta. Det kan tyckas som om ni har mycket minne, men ändå händer det.
Tidigare rekommenderade vi att sätta vm.swappiness till noll, det vill säga stänga av swap. Det verkade tidigare som om 32 GB RAM och motsvarande delade buffrar var en enorm mängd. Huvudsyftet med swap är att ha en plats att lägga en kärna på, om vi skulle falla. Och det fyller inte riktigt sin funktion längre. Och vad ska man göra med den kärnan sedan? Det är en sådan uppgift där det inte är så tydligt varför swap behövs, särskilt i så stora mängder.
Men i de mer moderna, dvs. i tredje versionerna av kärnan, har beteendet förändrats. Och om du sätter swap till noll, dvs. stänger av det, så kommer OOM-killer att dyka upp förr eller senare, även med en viss mängd ledigt arbetsminne, för att döda de mest resurskrävande processerna. Det för att den kommer att anta att vi har lite kvar och att vi kan överbelasta, dvs. att den inte kommer att döda systemprocessen, utan något mindre viktigt. Denna mindre viktiga process kan vara en intensiv konsument av delat minne, nämligen postmaster. Och efter det är det bra om databasen inte behöver återställas.
Därför rekommenderar jag att de flesta distributioner nu som standard är någonstans runt 6, dvs. vid vilken punkt man bör börja använda swap beroende på hur mycket minne som är kvar. Vi råder nu att sätta vm.swappiness = 1, eftersom detta praktiskt taget stänger av det, men inte ger sådana effekter som med den oväntat anländande OOM-killern som dödar allt det här.
Vad händer härnäst? När vi pratar om databasprestanda och gradvis närmar oss diskar, så börjar alla att bli stressade. För sanningen är att diskar är långsamma och minnet är snabbt, detta är något som alla känner till. Och alla vet att det kommer att uppstå problem med diskprestanda i databasen.
Huvudproblemet med PostgreSQL:s prestanda, kopplat till checkpoints spikes, uppstår inte för att disken är långsam. Det handlar snarare om att kapaciteten hos minnet och disken inte är balanserad. De kan vara obalanserade på olika sätt. PostgreSQL är inte konfigurerat, operativsystemet är inte konfigurerat, hårdvaran är inte rätt inställd. Och detta problem uppstår inte om allt fungerar som det ska, dvs. antingen finns det ingen belastning, eller så är inställningarna och hårdvaran väl avpassade.
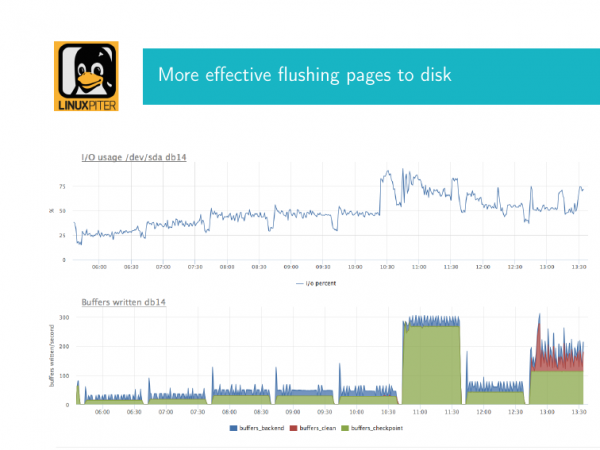
Vad är det och hur ser det ut? Vanligtvis har personer som arbetar med PostgreSQL stött på detta problem flera gånger. Jag ska förklara. Som jag nämnde gör PostgreSQL periodiskt checkpoints för att dumpa smutsiga sidor från delat minne till disken. Om vi har ett stort antal sidor i det delade minnet börjar checkpointen att belasta disken intensivt, eftersom den dumpas med fsync. Den går till kernel-buffer och skrivs till diskarna med hjälp av fsync. Och om volymen av detta är stor kan vi observera en otrevlig effekt, nämligen en mycket hög diskutilization.
Här har jag två bilder. Jag ska nu förklara vad detta är. Det är två tidskorrelerade diagram. Det första diagrammet – det som visar diskutilization. Här når den nästan upp till 90 % vid denna tidpunkt. Om du upplever databasen mot fysiska diskar, med RAID-kontroller, och diskutilization ligger omkring 90 %, är det dåliga nyheter. Det betyder att om det fortsätter så här, närmar vi oss 100 och in- och utströmmen kommer att stanna.
Om du har en diskarray, är historien lite annorlunda. Det beror på hur den är konfigurerad, vilken typ av array det handlar om, osv.
Samtidigt är här konfigurerad en graf från en intern PostgreSQL-vy, som visar hur checkpointen fungerar. Och med grön färg visas antalet buffrar, de smutsiga sidorna som kommit in i denna checkpoint för synkronisering. Detta är det viktigaste att känna till här. Vi ser att många sidor har kommit in och vid en viss tidpunkt har vi kört fast, dvs. vi har skrivit och skrivit, och diskens system är uppenbarligen mycket belastat. Vår checkpoint påverkar disken kraftigt. I ett idealiskt fall borde situationen se ut så här, dvs. att vi hade skrivit mindre. Och vi kan justera inställningarna för att se till att det fortsätter så. Dvs. liten utnyttjande, men vi skriver ändå något här.
Vad behöver göras för att lösa detta problem? Om IO har stannat upp under databasen, betyder det att alla användare som kommit för att utföra sina förfrågningar kommer att få vänta.
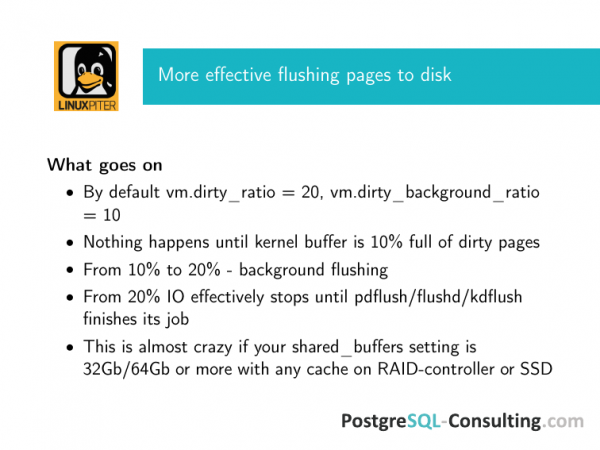
Om man ser på det ur ett Linux-perspektiv, om man har bra hårdvara, har konfigurerat den korrekt och normala inställningar för PostgreSQL för att minska antalet checkpoints och sprida ut dem över tid, så hamnar man i standardinställningarna för Debian. För de flesta Linux-distributioner ser bilden ut så här: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Vad betyder detta? Från kärnan 2.6 har en demon för flushing introducerats. Pdglush, beroende på vilken man använder, ansvarar för bakgrundsvisning av smutsiga sidor från kernel buffer och för att frigöra dessa sidor när det är absolut nödvändigt, även när bakgrundsfrisläppandet inte räcker till.
När inträffar bakgrunden? När 10 % av allt RAM-minne på servern används av smutsiga sidor i kernel buffer, aktiveras en särskild funktion för bakgrundsvisning. Varför är den bakgrunds? Den tar emot som parameter hur många sidor som ska frigöras. Om den till exempel frigör N sidor. Och under en tid går den i viloläge. Sedan kommer den tillbaka och frigör ytterligare ett visst antal sidor.
Detta är en mycket enkel historia. Det är som med en bassäng, när det rinner ut genom en slang och fylls upp genom en annan. Vi har en checkpoint och om den har skickat få smutsiga sidor för visning, så kommer pgflush att gradvis lösa upp allt detta försiktigt från kernel buffer.
Om dessa smutsiga sidor fortsätter att ackumuleras, når de 20 %, och därefter prioriterar OS att frigöra dem till disken för att undvika dataförlust vid strömavbrott, vilket kan leda till att vi förlorar dessa data.
Vad är tricket? Tricket är att dessa parametrar, 20 och 10 % av allt RAM-minne i maskinen, är helt oacceptabla med avseende på prestanda för vilket disk system som helst.
Tänk dig att du har 128 GB RAM. 12,8 GB når ditt disksystem. Och vilket cacheminne eller array du än har där, de kommer inte att klara av så mycket.
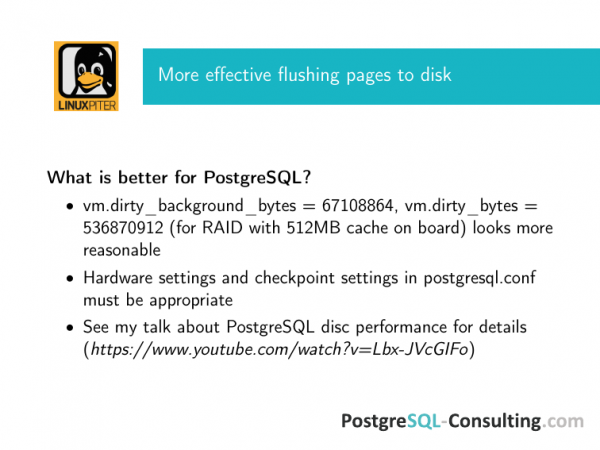
Därför rekommenderar vi att justera dessa siffror baserat på ditt RAID-kontrollers kapabiliteter. Här är en rekommendation för en kontroller med 512 MB cache.
Det anses vara ganska enkelt. Man kan ställa in vm.dirty_background i byte. Och dessa inställningar avbryter de tidigare två. Antingen ratio som standard, eller om de som använder byte är aktiverade, kommer de att fungera. Men eftersom jag är en DBA-konsult och arbetar med olika kunder försöker jag varna för eventuella problem, så om det är i byte, så är det i byte. Ingen har gett någon garanti för att en god administratör inte slänger in mer minne till servern, eller startar om den, medan siffran förblir densamma. Beräkna bara dessa siffror för att säkerställa att allt får plats.
Vad händer om du inte får plats? Jag har skrivit att alla flushing effektivt stoppas, men det är egentligen en talfigur. Operativsystemet har ett stort problem – det finns många smutsiga sidor, så effektivt stoppas den IO som skapas av dina klienter, det vill säga när en applikation skickar en SQL-fråga till databasen, den väntar. All IO till den har lägsta prioritet, eftersom databasen är upptagen med checkpoint. Och när den avslutar det är helt oklart. Och när du når ett inte bakgrunds- eller inte bakgrundsflushing, betyder det att all din IO är upptagen med detta. Och så länge det inte är klart, kan du inte göra något.
Det finns ytterligare två viktiga punkter som ligger utanför denna rapport. Dessa inställningar bör matcha inställningarna i postgresql.conf, det vill säga inställningarna för checkpoints. Och ditt lagringssystem måste vara korrekt konfigurerat. Om du har en cache på RAID, måste det finnas ett batteri på den. Folk köper RAID med bra cache utan batteri. Om du har SSD i RAID, så måste de vara serverklassade, där måste det finnas kondensatorer. Här är en utförlig checklista. Genom den här länken finns min presentation om hur man konfigurerar diskprestanda i PostgreSQL. Där finns alla dessa checklistor.
Vad kan dessutom komplicera livet avsevärt? Det är två parametrar. De är relativt nya. De kan som standard vara aktiverade i olika applikationer. Och de kan försvåra livet inte mindre om de aktiveras felaktigt.
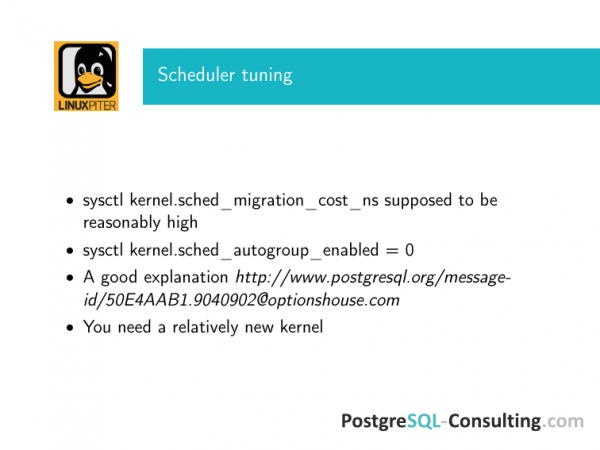
Det finns två relativt nya funktioner. De har redan dykt upp i tredje kärnor. Det handlar om sched_migration_cost i nanosekunder och sched_autogroup_enabled, som som standard är aktiv.
Och hur förstör de livet? Vad är sched_migration_cost? I Linux kan schemaläggaren migrera en process från en CPU till en annan. För PostgreSQL, som utför förfrågningar, är det helt oklart varför migration till en annan CPU skulle behövas. Ur ett operativsystemsperspektiv, när du växlar fönster mellan OpenOffice och terminalen, kan detta vara bra, men för databasen – detta är mycket dåligt. Därför är en rimlig policy att sätta migration_cost till något stort värde, åtminstone flera tusen nanosekunder.
Vad kommer detta att innebära för schemaläggaren? Den kommer att tro att processen fortfarande är "het" under denna tid. Det vill säga, om du har en lång transaktion som sysslar med något, kommer schemaläggaren att förstå detta. Den kommer att anse att så länge denna timeout inte har passerat, behöver inte migration av denna process ske. Om processen gör något kommer den inte att migreras, utan avsluta sitt arbete på den CPU som den tilldelats. Resultatet blir utmärkt.
En annan aspekt är autogroup. Det finns en bra idé för specifika arbetsbelastningar som inte har något att göra med moderna databaser – att gruppera processer efter den virtuella terminal som de körs ifrån. Detta är praktiskt för vissa uppgifter. I praktiken är PostgreSQL ett multiprocessystem med prefork, som startas från en terminal. Du har lock writer, checkpoint och alla dina klientförfrågningar kommer att grupperas på en schemaläggare, på en CPU. De kommer att vänta där tillsammans tills den blir ledig, för att inte störa varandra och ta längre tid av den. Denna situation är helt onödig under sådana belastningar och därför behöver den stängas av.
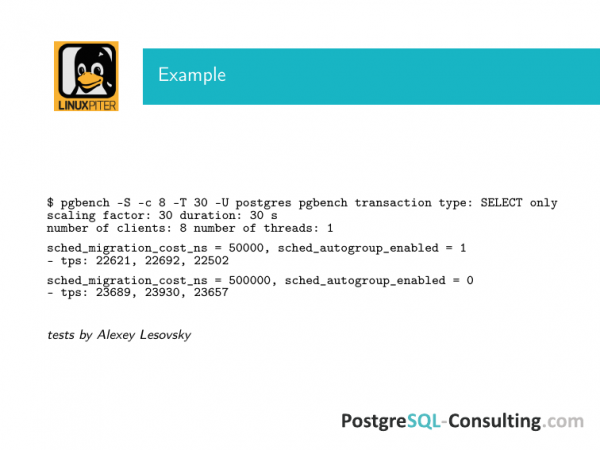
Min kollega Alexey Lesovsky genomförde tester med en enkel pgbench där han ökade migration_cost med en ordning och stängde av autogroup. Resultatet på dålig hårdvara var nästan 10 %.Det finns en diskussion i PostgreSQL:s mailinglista där folk visar resultat på hur sådana förändringar påverkat frågehastigheten med 50 %.Det finns många sådana exempel.
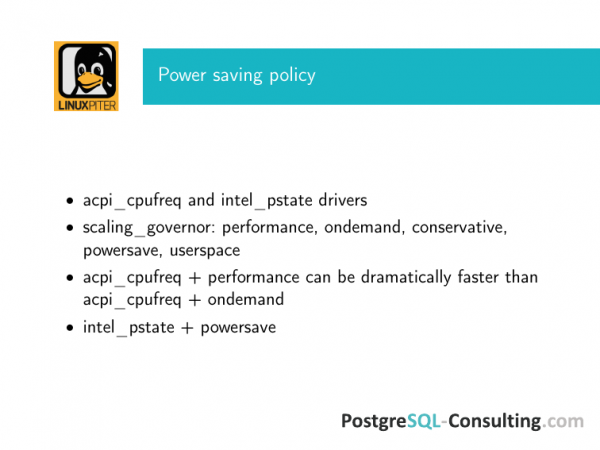
Och slutligen, om strömsparande policy. Det är bra att Linux nu kan användas på bärbara datorer. Och det kommer att påstås vara bra för batteriförbrukningen. Men plötsligt visar det sig att detta också kan hända på servrar.
Mer än så, om du hyr servrar från en hostingleverantör kan "snälla" hostingtjänster de oro ingen har något fokus på att förbättra din prestanda. Deras uppgift är att se till att deras hårdvara utnyttjas så effektivt som möjligt. Därför kan de som standard aktivera energibesparande läge på operativsystemet.
Om du använder en server med en databas under intensiv belastning, är ditt val acpi_cpufreq + performance. Även med ondemand kommer det att uppstå problem.
Intel_pstate är en något annan drivrutin. Nu föredras denna, eftersom den är nyare och fungerar bättre.
Och därför är guvernören endast performance. Ondemand, powersave och allt annat är inte för dig.
Resultaten från explain analyze PostgreSQL kan skilja sig åt med flera ordningar om du aktiverar powersave, eftersom CPU:n kommer att schemaläggas på ett helt oförutsägbart sätt under databasen.
Dessa inställningar kan vara aktiverade som standard. Titta noga för att se om de är aktiverade. Detta kan verkligen vara ett stort problem.
Och till sist vill jag tacka killarna i vårt DBA-team PosgreSQL-Consulting, särskilt Max Boguk och Alexey Lesovsky, som varje dag stöter på problemen. Vi försöker göra vårt bästa för våra kunder så att allt fungerar bra. Här är det som med flygplanssäkerhetsinstruktioner. Allt här är skrivet med blod. Varje skruv upptäcktes när ett problem uppstod. Jag delar gärna med mig av dem till er.
Frågor:
Tack! Om ett företag till exempel vill spara pengar och köra en databas och applikationslogik på samma server, eller om företaget följer den trendiga riktningen av mikrotjänstarkitekturer där PostgreSQL körs i en container. Vad är grejen? Sysctl påverkar globalt hela kärnan. Jag har inte hört talas om att sysctl på något sätt virtualiseras så att de fungerar separat i containern. Det finns bara cgroup och där finns kontrollen bara för en del. Hur kan man leva med det? Eller om du vill ha prestanda, kör PostgreSQL på en separat fysisk server och optimera den?
Vi har svarat på din fråga på ungefär tre sätt. Om det inte handlar om en dedikerad server som du kan optimera och så vidare, kan du slappna av – det kommer att fungera bra utan dessa inställningar. Om du har en sådan belastning att du behöver göra dessa inställningar kommer du att behöva en dedikerad server tidigare än du når dessa inställningar.
Vad är problemet? Om det är en virtuell maskin kommer du troligen att ha många problem, till exempel att det är mycket inkonsekvent latens på diskarna i de flesta virtuella maskiner. Även om diskarna har bra bandbredd kan en misslyckad I/O-transaktion, som inte påverkar den genomsnittliga bandbredden mycket, hända under en checkpoint eller vid skrivning till WAL, och databasen kommer att lida av det. Och du kommer att märka det tidigare än du hamnar i dessa problem.
Om du har NGINX på samma server kommer du att ha samma problem. Den kommer att slåss om det delade minnet. Och du kommer inte att nå de problem som beskrivs här.
Men å andra sidan kommer vissa av dessa parametrar fortfarande att vara relevanta för dig. Till exempel, med sysctl kan du ställa in dirty_ratio så att den inte är så galen – det kommer att hjälpa på något sätt. Hur som helst kommer du att ha interaktion med disken. Och det kommer att vara felaktigt. Det är faktiskt standarden för de parametrar som jag visade. Och det är bättre att ändra dem oavsett.
Det kan finnas problem med NUMA. VmWare fungerar till exempel bra med NUMA med helt motsatt inställning. Här måste du välja – dedikerad server eller inte.
Jag har en fråga relaterad till Amazon AWS. De har förinställda bilder. En av dem kallas Amazon RDS. Finns det några anpassade inställningar för deras operativsystem?
Det finns inställningar, men det är andra inställningar. Här konfigurerar vi operativsystemet utifrån hur databasen kommer att använda det. Och där finns det parametrar som bestämmer vart vi ska gå nu, så mycket shaping. Det vill säga, vi behöver så mycket resurser, och vi kommer att utnyttja dem nu. Efter det kopplar Amazon RDS dessa resurser, och prestandan faller. Det finns separata berättelser om hur folk börjar experimentera med detta. Ibland ganska framgångsrikt. Men det har inget att göra med operativsystemets inställningar. Det handlar mer om att hacka molnet. Det är en annan historia.
Varför ger Transparent huge pages ingen effekt jämfört med Huge TLB?
Det gör de inte. Detta kan förklaras på många sätt. Men faktum är att de helt enkelt inte bidrar. Vad är historien med PostgreSQL? Vid start reserverar den en stor del av det delade minnet. Oavsett om de är transparenta eller inte — det spelar ingen roll. Faktumet att de allokeras vid start förklarar allt. Om det finns mycket minne och det behöver omstruktureras, då blir Transparent huge pages aktuellt. I PostgreSQL allokeras det helt enkelt en stor del från början och sedan händer det inget särskilt längre. Man kan självklart använda det, men det finns en risk att få korrupt delat minne när det omallokerar något. PostgreSQL vet ju inte om detta.
Källa: habr.com
