

År 2019 hade vi fortfarande ingen standardlösning för aggregering av loggar i Kubernetes. I den här artikeln vill vi, med exempel från verklig praktik, dela med oss av våra sökningar, mötta problem och deras lösningar.
Men först bör jag nämna att olika kunder har mycket olika uppfattningar om vad logginsamlingsprocessen innebär:
- några vill se säkerhets- och revisionsloggar;
- några vill ha centraliserad loggning av hela infrastrukturen;
- och vissa nöjer sig med att enbart samla in applikationsloggar, medan de exempelvis exkluderar belastningsutjämnare.
Om hur vi implementerade olika "önskemål" och vilka svårigheter vi stötte på – läs vidare.
Teori: om verktyg för loggar
Bakgrund om komponenterna i loggningssystemet
Loggning har genomgått en lång resa, vilket har lett till att metoder för insamling och analys av loggar har utvecklats, och dessa tillämpas idag. Redan på 1950-talet dök det upp en motsvarighet till standard strömmar för in- och utmatning i Fortran, som hjälpte programmerare med felsökning av sina program. Det var de första datorloggarna som underlättade livet för programmerarna och på den tiden. Idag ser vi den första komponenten i loggningssystemet – källan eller "producenten" (producer) av loggar.
Datavetenskapen har inte stått stilla: datanätverk, de första klustren... Komplexa system bestående av flera datorer började arbeta. Nu var systemadministratörer tvungna att samla in loggar från flera maskiner, och i särskilda fall kunde de även inkludera meddelanden från operativsystemets kärna ifall det skulle behövas för att undersöka systemfel. För att beskriva system för centraliserad logginsamling publicerades i början av 2000-talet , vilket standardiserade remote_syslog. Så en annan viktig komponent dök upp: loggkollektorn och deras lagring.
Med ökningen av loggvolymer och den allmänna implementeringen av webteknologier, blev frågan om hur loggarna skulle visas för användare aktuell. Istället för enkla konsolverktyg (awk/sed/grep) kom mer avancerade loggvisare – den tredje komponenten.
Med det ökade loggvolymen stod det klart att loggar är nödvändiga, men inte alla. Dessutom kräver olika loggar olika nivåer av bevarande: vissa kan förloras efter en dag, medan andra måste förvaras i fem år. Så en filtrerings- och dataroutingkomponent lades till loggsystemet — låt oss kalla den filtern.
Lagringslösningarna har också gjort ett stort steg: från vanliga filer till relationsdatabaser och sedan till dokumentorienterade lagringslösningar (t.ex. Elasticsearch). Så lagringen separerades från insamlaren.
I slutändan har själva begreppet logg vidgats till någon form av abstrakt ström av händelser som vi vill bevara för historiken. Mer specifikt — för det fall det behövs att genomföra en utredning eller sammanställa en analysrapport...
Som ett resultat har insamling av loggar på relativt kort tid utvecklats till ett viktigt delsystem som med rätta kan kallas en av underavdelningarna inom Big Data.
Om vanliga printar en gång kunde vara tillräckligt för ett "loggsystem", så har situationen nu förändrats avsevärt.
Kubernetes och loggar
När Kubernetes kom in i infrastrukturen påverkades inte den befintliga logginsamlingen, utan situationen blev faktiskt mer komplex: hanteringen av infrastrukturplattformen blev både förenklad och komplicerad. Många gamla tjänster började migrera till mikrotjänstbaserat arbete. I loggsammanhang ledde detta till ett växande antal loggkällor, deras särskilda livscykel och behovet av att spåra relationerna mellan alla systemkomponenter genom loggar...
För att gå framåt kan jag konstatera att det tyvärr inte finns någon standardiserad loggningslösning för Kubernetes som särskilt skiljer sig från alla andra. De mest populära scheman i gemenskapen kan sammanfattas som följer:
- någon distribuerar en stack EFK (Elasticsearch, Fluentd, Kibana);
- någon — försöker den nyligen släppta eller använder ;
- vi (och kanske inte bara vi? ..) i stor utsträckning är nöjda med vår egen utveckling — …
Som regel använder vi sådana kombinationer i K8s-kluster (för självhostade lösningar):
- ;
- .
Men jag kommer inte att stanna vid instruktionerna för installation och konfiguration. Istället kommer jag att fokusera på deras nackdelar och mer övergripande slutsatser om loggsituationen i helhet.
Praktik med loggar i K8s
"Vardagliga loggar", hur många av er finns det?..
Centraliserad insamling av loggar från en tillräckligt stor infrastruktur kräver betydande resurser som går åt till insamling, lagring och bearbetning av loggar. Under driften av olika projekt har vi stött på olika krav och de problem som uppstått till följd av detta.
Låt oss prova ClickHouse
Låt oss titta på ett centraliserat förråd i ett projekt med en applikation som genererar loggar ganska aktivt: mer än 5000 rader per sekund. Vi börjar arbeta med dess loggar genom att lagra dem i ClickHouse.
Så snart max realtid krävs, kommer en 4-kärnig server med ClickHouse redan att vara överbelastad på disksystemet:
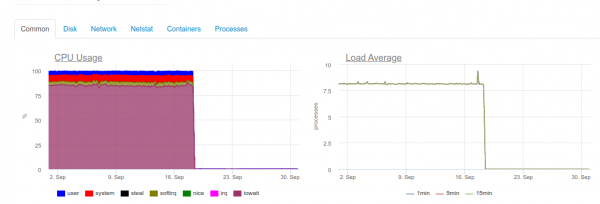
Denna typ av belastning är kopplad till att vi försöker skriva så snabbt som möjligt till ClickHouse. Och databasen reagerar på detta med ökad diskbelastning, vilket kan leda till följande fel:
DB::Exception: För många delar (300). Sammanfogningar bearbetas mycket långsammare än insättningar
Det handlar om att i ClickHouse (som innehåller loggdata) har sina egna svårigheter vid skrivoperationer. De insatta uppgifterna genererar en temporär partition som sedan slås samman med huvudtabellen. Som ett resultat blir inskrivningen mycket krävande för disken, och det finns även en begränsning, vars meddelande vi fick tidigare: inte fler än 300 subpartitioner kan slås samman per sekund (detta motsvarar faktiskt 300 insättningar per sekund).
För att undvika ett sådant beteende, i så stora block som möjligt och inte oftare än 1 gång var 2:a sekund. Men att skriva i stora block innebär att vi måste skriva mer sällan till ClickHouse. Detta, i sin tur, kan leda till att bufferten fylls och loggar går förlorade. Lösningen är att öka bufferten för Fluentd, men då ökar också minnesanvändningen.
Anmärkning: En annan problematisk aspekt av vår lösning med ClickHouse var kopplad till att partitioneringen i vårt fall (loghouse) genomfördes via externa tabeller som är kopplade . Detta leder till att när man hämtar stora tidsintervall krävs det för mycket RAM-minne, eftersom metadatabasen genomsöker alla partitioner — även de som uppenbarligen inte innehåller nödvändiga data. Men nu kan man tryggt kalla denna metod för föråldrad för de aktuella versionerna av ClickHouse (c ).
Som ett resultat blir det tydligt att resurserna för realtidsloggning i ClickHouse inte är tillräckliga för alla projekt (närmare bestämt, deras fördelning är inte rimlig). Dessutom krävs det att man använder en mellanlagring, vilket vi återkommer till. Det beskrivna fallet är verkligt. Och vid den tidpunkten kunde vi inte erbjuda en pålitlig och stabil lösning som skulle tillfredsställa kunden och möjliggöra insamling av loggar med minimal fördröjning…
Och Elasticsearch?
Det är känt att Elasticsearch klarar av stora belastningar. Låt oss prova det i samma projekt. Nu ser belastningen ut på följande sätt:
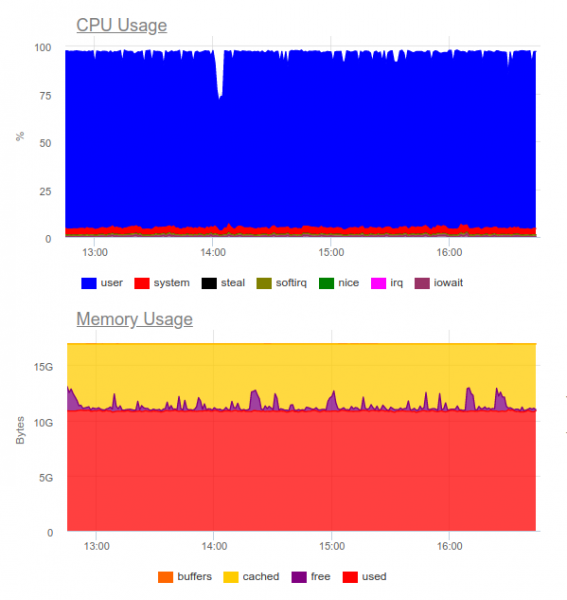
Elasticsearch kunde bearbeta datastreamen, men att skriva sådana volymer till det använder mycket CPU. Detta löses genom att organisera en kluster. Rent tekniskt är detta inget problem, men det visar sig att bara för att loggsystemet ska fungera använder vi redan cirka 8 kärnor och har en ytterligare högbelastad komponent i systemet…
Slutsats: en sådan variant kan vara berättigad, men endast om projektet är stort och dess ledning är beredd att spendera betydande resurser på ett system för centraliserad loggning.
Då uppstår en rimlig fråga:
Vilka loggar är faktiskt nödvändiga?
 Låt oss försöka ändra själva tillvägagångssättet: loggarna bör vara både informativa och inte täcka varje händelse i systemet.
Anta att vi har en framgångsrik e-handelsbutik. Vilka loggar är viktiga? Att samla in maximal information, till exempel från betalningsgatewayen — en utmärkt idé. Men för tjänsten som beskär bilder i produktkatalogen är vi inte intresserade av alla loggar: det räcker med fel och utökad övervakning (till exempel procentandelen 500-fel som denna komponent genererar).
Här har vi kommit fram till att centraliserad loggning är inte alltid berättigad. Mycket ofta vill kunden samla alla loggar på ett ställe, även om det i verkligheten bara krävs omkring 5 % av meddelandena från hela loggen, som är kritiska för verksamheten:
- Ibland räcker det med att ställa in, låt oss säga, bara storleken på loggen för containern och felhanteraren (till exempel Sentry).
- För incidentutredningar kan det ofta räcka med felmeddelanden och själva den stora lokala loggen.
- Vi har haft projekt som helt och hållet klarade sig med enbart funktionella tester och system för insamling av fel. Utvecklaren behövde inte loggar som sådana - de såg allt genom felspåren.
En illustration från verkligheten
Ett bra exempel kan vara en annan historia. Vi fick en förfrågan från säkerhetsteamet hos en av våra kunder, som redan använde en kommersiell lösning som utvecklades långt före implementeringen av Kubernetes.
Det krävdes att "vänja" det centrala logginsamlingssystemet med företagets sensor för problemidentifiering - QRadar. Detta system kan ta emot loggar via syslog-protokollet och hämta via FTP. Emellertid gick det inte att integrera det med remote_syslog-plugin för fluentd direkt. (som det visade sig, )). Problem med inställningen av QRadar visade sig på kundens säkerhetsteams sida.
Som ett resultat exporterades en del loggar som var kritiska för verksamheten till FTP QRadar, medan en annan del dirigerades direkt från noderna via remote syslog. För detta skrev vi till och med en — kanske det hjälper någon att lösa ett liknande problem... Tack vare den skapade schemat fick kunden tag på och analyserade kritiska loggar (med hjälp av sitt favoritverktyg), medan vi kunde sänka kostnaderna för loggningssystemet genom att endast behålla den senaste månaden.
Ett annat exempel är ganska talande för hur man inte bör göra. En av våra kunder åstadkom att hantera varje händelser från användaren genom att göra en fler-radig ostrukturerad utskrift av information i loggen. Som man lätt kan gissa, var sådana loggar extremt svåra att läsa och lagra.
Kriterier för loggar
Sådana exempel leder fram till slutsatsen att förutom valet av logginsamlingssystem måste man även utforma loggarna själva! Vilka krav finns här?
- Loggarna måste vara i maskinläsbart format (till exempel, JSON).
- Loggarna måste vara kompakta och kunna ändra loggningsgraden för att debugga eventuella problem. Dessutom bör system köra med en loggningsnivå som Varning eller Error.
- Loggar måste vara normaliserade, vilket innebär att i loggobjektet ska alla rader ha samma fälttyp.
Ostrukturerade loggar kan leda till problem med att ladda loggar till lagring och kan fullständigt stoppa deras behandling. Här är ett exempel med felkod 400, som många säkert har stött på i fluentd-loggar:
2019-10-29 13:10:43 +0000 [warn]: dump a error event: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError error="400 - Rejected by Elasticsearch"
Felet innebär att du skickar ett fält till indexet med en färdig mapping vars typ är instabil. Det enklaste exemplet är ett fält i nginx-loggen med en variabel $upstream_status. I det kan det vara både ett nummer och en sträng. Till exempel:
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "\/staffs\/265.png", "protocol": "HTTP\/1.1", "status": "200", "body_size": "906", "referrer": "https:\/\/example.com\/staff", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "\/staff", "protocol": "HTTP\/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
I loggarna syns det att servern 10.100.0.10 svarade med felkod 404 och att begäran gick till ett annat lagringsutrymme. Resultatet blev att värdet i loggarna såg ut så här:
"upstream_response_time": "0.001, 0.007"
Denna situation är så vanlig att den till och med fått ett eget .
Och hur är det med tillförlitlighet?
Det finns fall då alla loggar utan undantag är livsviktiga. Och det är här de typiska loggsamlingsscheman för K8s, som nämndes tidigare, har problem.
Till exempel kan fluentd inte samla loggar från kortlivade containrar. I ett av våra projekt levde containern för databasflyttningar i mindre än 4 sekunder och raderades sedan – enligt den motsvarande anteckningen:
"helm.sh/hook-delete-policy": hook-succeeded
Därför hamnade inte loggen för flyttningen i lagringen. I det här fallet kan policyn before-hook-creation.
Ett annat exempel är loggrotation i Docker. Anta att det finns en applikation som aktivt skriver loggar. Under normala förhållanden lyckas vi bearbeta alla loggar, men så snart ett problem uppstår – som den obenämnda med felaktigt format – stoppas bearbetningen och Docker roterar filen. Resultatet blir att kritiska loggar för verksamheten kan gå förlorade.
Det är därför det är viktigt att separera loggströmmar, genom att integrera sändning av de mest värdefulla loggarna direkt i applikationen för att säkerställa deras bevarande. Dessutom kan det vara bra att skapa en sorts »ackumulator« för loggar, som kan överleva kortvarig otillgänglighet av lagringen samtidigt som kritiska meddelanden bevaras.
Till sist får man inte glömma att det är viktigt att noggrant övervaka varje subsystem. Annars är det lätt att hamna i en situation där fluentd befinner sig i tillståndet CrashLoopBackOff och inte skickar något, vilket kan leda till förlust av viktig information.
Slutsatser
I den här artikeln diskuterar vi inte SaaS-lösningar som Datadog. Många av de problem som beskrivs här har redan lösts av kommersiella företag som specialiserar sig på att samla loggar, men alla kan inte använda SaaS av olika skäl (de huvudsakliga är kostnad och efterlevnad av 152-FZ).
Centraliserad logginsamling verkar först som en enkel uppgift, men så är det inte. Det är viktigt att komma ihåg att:
- Det är värt att detaljerat logga endast kritiska komponenter, medan över andra system kan övervakning och felinsamling konfigureras.
- Loggar i produktion bör hållas minimala för att inte ge onödig belastning.
- Loggar ska vara maskinläsbara, normaliserade och ha ett strikt format.
- Verkligt kritiska loggar bör skickas i en separat ström, som ska vara åtskild från de huvudsakliga.
- Det är värt att tänka på en loggackumulator som kan rädda från toppar av hög belastning och göra belastningen på lagringen mer jämn.
Dessa enkla regler, om de tillämpas överallt, skulle möjliggöra att de ovan beskrivna scheman fungerar – även om det saknas viktiga komponenter (ackumulator). Om man inte följer sådana principer kan uppgiften enkelt leda dig och infrastrukturen till en annan högbelastad (och samtidigt ineffektiv) systemkomponent.
P.S.
Läs även i vår blogg:
- «»;
- «»;
- «».
Källa: habr.com
