

Övervakning har blivit en mycket viktig komponent av växande molnlösningar i takt med ökande komplexitet i distribuerade system. Det är nödvändigt för att förstå deras beteende. Det behövs skalbara verktyg som kan samla data från alla tjänster — och ge specialister ett gemensamt gränssnitt för prestandaanalys, felvisning, tillgänglighet och loggar.
Dessa verktyg bör vara effektiva och presterande. I denna artikel kommer vi att titta på två populära teknikstackar: EFK (Elasticsearch) och PLG (Loki) och gå igenom deras arkitekturer och skillnader.
EFK-stacken
Du har kanske redan hört talas om den populära ELK eller EFK. Stacken består av flera separata delar: Elasticsearch (objektrepository), Logstash eller FluentD (insamling och aggregering av loggar) och Kibana för visualisering.
Ett typiskt arbetsflöde ser ut så här:
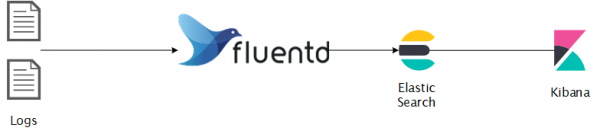
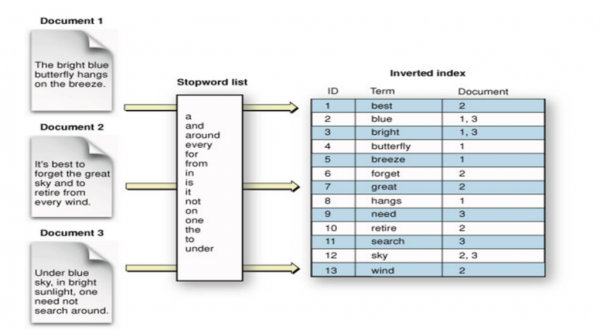
Elasticsearch — ett distribuerat objektrepository med sökning och analys i realtid. En utmärkt lösning för delvis strukturerad data, som loggar. Informationen lagras som JSON-dokument, indexeras i realtid och sprids över klustrets noder. En omvänd index används, som innehåller alla unika ord och relaterade dokument för fulltextssökning, som i sin tur bygger på sökmotorn Apache Lucene.
FluentD — är en datainsamlare som utför datastandardisering vid insamling och konsumtion. Den strävar efter att strukturera data i JSON så långt som möjligt. Dess arkitektur är utbyggbar, det finns mer än , som stöds av gemenskapen, för alla situationer.
Kibana — ett verktyg för datavisualisering för Elasticsearch med olika extra funktioner, som analys av tidsserier, grafer, maskininlärning och mer.
Elasticsearch-arkitektur
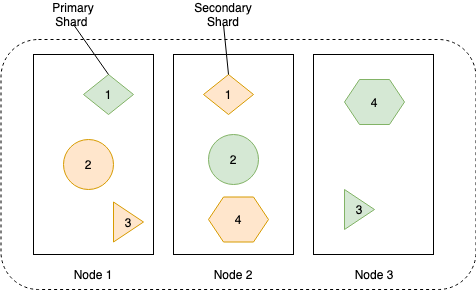
Data i Elasticsearch-klustret lagras utspritt över alla dess noder. Klustret består av flera noder för att förbättra tillgänglighet och motståndskraft. Vilken nod som helst kan utföra alla klustrets roller, men i stora skalbara installationer tilldelas noder vanligtvis specifika uppgifter.
Typer av klusternoder:
- master node — hanterar klustret, minst tre behövs, en är alltid aktiv;
- data node — lagrar indexerade data och utför olika uppgifter med dem;
- ingest node — organiserar pipeliner för datatransformation före indexering;
- coordinating node — routar förfrågningar, minskar sökprocessens bearbetningsfas, koordinerar massindeksering;
- alerting node — initierar varningsuppgifter;
- machine learning node — hanterar maskininlärningsuppgifter.
Diagrammet nedan visar hur data sparas och replikeras över noder för att uppnå högre datatillgänglighet.
Data för varje replik lagras i en inverterad index, schemat nedan visar hur detta går till:
Installation
Detaljer kan ses , jag kommer att använda helm chart:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsPLG-stacken
Det är inte så konstigt om du inte hittar denna akronym, eftersom den bättre är känd som Grafana Loki. Oavsett så blir denna stack mer populär eftersom den tillämpar genomtänkta tekniska lösningar. Du har kanske redan hört talas om Grafana, det populära visualiseringsverktyget. Dess skapare, inspirerade av Prometheus, utvecklade Loki, ett horisontalt skalbart högpresterande system för loggaggregation. Loki indexerar endast metadata, inte själva loggarna, denna tekniska lösning har gjort det enkelt att använda och kostnadseffektivt.
Promtail — agent för att skicka loggar från operativsystemet till Loki-klustret. Grafana — visualiseringsverktyg baserat på data från Loki.
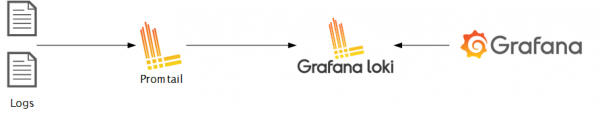
Loki bygger på samma principer som Prometheus, vilket gör att det passar bra för lagring och analys av Kubernetes-loggar.
Arkitektur för Loki
Loki kan köras både som en enda process och som flera processer, vilket möjliggör horisontell skalning.
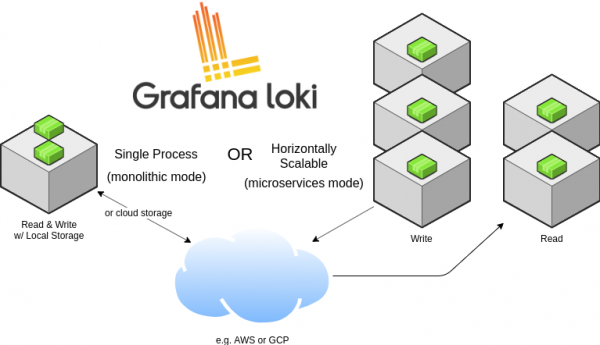
Den kan också fungera antingen som en monolitisk applikation eller som en mikrotjänst. Att köra som en enda process kan vara användbart för lokal utveckling eller för liten övervakning. För industriell implementering och skalbar belastning rekommenderas den mikrotjänstvariant. Skriv- och läsvägarna för data är separerade, så det kan justeras och skalas tydligt efter behov.
Låt oss titta på arkitekturen för systemet för loggsamling utan att gå in på detaljer:
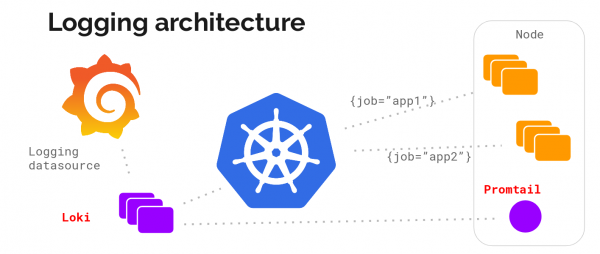
Och här är beskrivningen (mikrotjänstarkitektur):
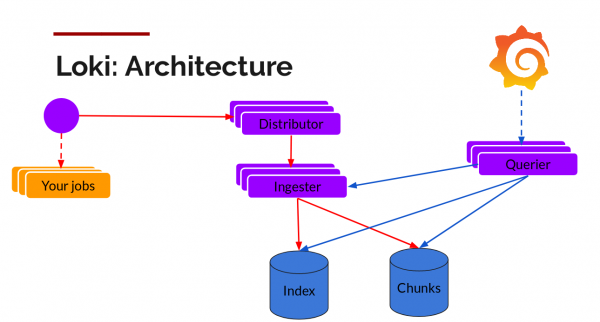
Beståndsdelar:
Promtail — en agent som installeras på noder (i form av en uppsättning tjänster), som tar bort loggar från uppgifter och ansluter till Kubernetes API för att hämta metadata som loggarna ska märkas med. Den skickar sedan loggen till huvudtjänsten Loki. För att mappa metadata stöds samma regler för märkning som i Prometheus.
Distributör — en distribuerande tjänst som fungerar som en buffert. För att hantera miljontals poster paketerar den de inkommande data genom att komprimera dem i block i takt med att de kommer in. Flera datamottagare arbetar samtidigt, men loggar som tillhör en ingångsdatainström måste hamna endast i en av dem för alla dess block. Detta organiseras som en ring av mottagare och sekventiell hashning. För att säkerställa redundans görs detta n gånger (3 om det inte konfigureras).
Ingester — en datamottagartjänst. Data block kommer som komprimerade med tillagda loggar. Så snart ett block är tillräckligt stort, görs en dump av blocket till databasen. Metadata går till indexet och data från loggblocket hamnar i Chunks (vanligtvis ett objektlager). Efter dumpning skapar mottagaren ett nytt block dit nya poster kommer att läggas till.
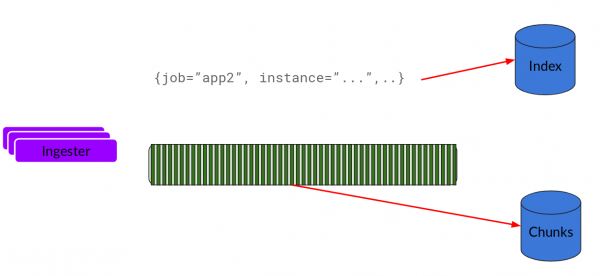
Index — en databas, DynamoDB, Cassandra, Google BigTable och liknande.
Chunks — loggblock i komprimerad form, vanligtvis lagrade i objektlager, exempelvis S3.
Frågare — en läsväg som gör allt det tunga arbetet. Den tittar på tidsintervallet och etiketter, efter vilket den kollar indexet för att hitta matchningar. Sedan läser den datablok och filtrerar dem för att få fram resultatet.
Låt oss nu titta på allt i aktion.
Installation
För att installera i Kubernetes är det enklast att använda helm. Vi förutsätter att du redan har installerat och konfigurerat den ( översättarens anm.)
Lägg till förrådet och installera stacken.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
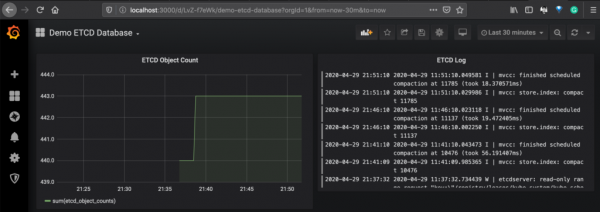
Nedan visas ett exempel på en instrumentpanel som visar data från Prometheus för Etcd-metrik och Loki för loggar från Etcd-pods.
Låt oss nu diskutera arkitekturen för båda systemen och jämföra deras funktioner med varandra.
Jämförelse
Frågespråk
I Elasticsearch används Query DSL och Lucene query language, som möjliggör fulltextsökning. Det är en beprövad kraftfull sökmotor med bred support för operatorer. Med den kan man söka inom kontext och sortera efter relevans.
På andra sidan ringen finns LogQL, som används i Loki, en efterföljare till PromQL (Prometheus query language). Den använder loggtaggar för att filtrera och hämta loggdata. Det finns möjlighet att använda vissa operatorer och aritmetik, som beskrivs , men när det gäller funktionaliteter ligger det efter Elastic language.
Eftersom förfrågningar i Loki är kopplade till taggar — de är lätta att förena med metrik, vilket gör att de är enklare att organisera för operationell övervakning.
Skalbarhet
Båda stackarna är horisontellt skalbara, men med Loki är det enklare eftersom den har separerade läs- och skrivvägar för data samt en mikrotjänstarkitektur. Loki kan anpassas efter dina behov och kan användas för mycket stora volymer av loggdata.
Multitenancy
Multitenancy av klustret är ett gemensamt tema för att minska OPEX, båda stackarna erbjuder multitenancy. För Elasticsearch finns det flera för att separera klienter: enskild index för varje klient, klientbaserad routning, unika klientfält, sökfilter. I Loki finns det i form av HTTP-huvudet X-Scope-OrgID.
Kostnad
Loki är ekonomiskt effektivt eftersom det inte indexerar data, utan endast metadata. På så sätt uppnås och minne (cache), eftersom objektlagring är billigare än blocklagring, som används i Elasticsearch-kluster.
Slutsats
EFK-stacken kan användas för olika ändamål, vilket ger maximal flexibilitet och en mångsidig Kibana-gränssnitt för analys, visualisering och förfrågningar. Den kan ytterligare förbättras med maskininlärningsmöjligheter.
Loki-stacken är användbar i Kubernetes-ekosystemet på grund av dess mekanism för metadataupptäckte. Det är enkelt att matcha data för övervakning baserat på tidsserier i Grafana och loggar.
När det kommer till kostnad och långtidslagring av loggar är Loki ett utmärkt val för att komma in i molnlösningar.
Det finns fler alternativ på marknaden — några kan vara bättre för dig. Till exempel har GKE integration med Stackdriver, som erbjuder en utmärkt lösning för övervakning. Vi inkluderade dem inte i vår analys i denna artikel.
Länkar:
Artikeln har översatts och förberetts för Habr av medarbetare — intensiver, videokurser och företagsutbildning från praktiker (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Källa: habr.com
