

TL;DR
- För att uppnå hög observabilitet av containrar och mikrotjänster, loggar och primära metrik räcker det inte med bara detta.
- För snabbare återställning och ökad motståndskraft bör applikationer tillämpa Hög Observabilitetsprincip (HOP, High Observability Principle).
- På applikationsnivå för HOP krävs: adekvat loggning, noggrann övervakning, tillståndskontroller och prestanda/trafikspårning.
- Som en del av HOP, använd kontroller. beredskapskontroll och livenessProbe Kubernetes.
Vad är en tillståndskontrollmall?
När du designar en kritisk och hög tillgänglig applikation är det viktigt att tänka på aspekten av motståndskraft. En applikation anses vara motståndskraftig om den snabbt återhämtar sig efter ett fel. En typisk molnapplikation använder en mikrotjänstarkitektur – där varje komponent placeras i en separat container. För att säkerställa att applikationen på k8s är hög tillgänglig, måste du följa vissa mallar när du designar klustret. Bland dem finns Tillståndskontrollmallen. Den definierar hur applikationen informerar k8s om sin tillgänglighet. Detta är inte bara information om huruvida podden fungerar, utan också om hur den tar emot och svarar på förfrågningar. Ju mer Kubernetes vet om poddens tillgänglighet, desto smartare beslut tar den om trafikdirigering och belastningsbalansering. På så sätt svarar Hög Observabilitetsprincip applikationen i tid på förfrågningar.
Hög Observabilitetsprincip (HOP)
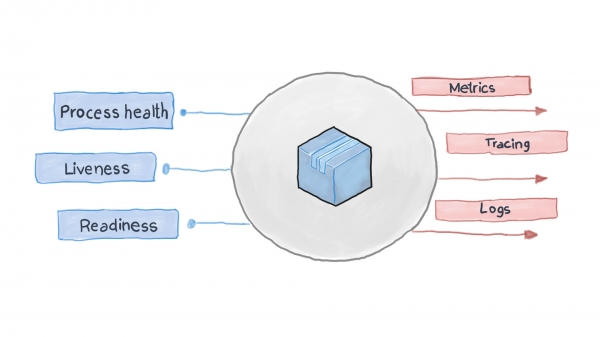
Hög Observabilitetsprincip är en av . I mikroservicesarkitektur är tjänsterna oberoende av hur deras förfrågan behandlas (vilket är korrekt), men det viktiga är hur man får svar från mottagande tjänster. Till exempel, för autentisering av användaren skickar en container en HTTP-förfrågan till en annan och väntar på svar i ett visst format – och det är allt. Förfrågan kan hanteras av PythonJS, och svaret kan ges av Python Flask. Containrar är för varandra som svarta lådor med dold information. Men principen för hälsa (NOR) kräver att varje tjänst avslöjar flera API-slutpunkter som visar hur fungerande den är, samt dess beredskaps- och redundansstatus. Dessa parametrar begärs av Kubernetes för att planera nästa steg för routing och belastningsbalansering.
Ett väl utformat molnapplikation loggar sina viktiga händelser med hjälp av standard I/O-strömmarna STDERR och STDOUT. Därefter körs en hjälptjänst, som filebeat, logstash eller fluentd, som levererar loggarna till ett centraliserat övervakningssystem (t.ex. Prometheus) och ett loggsamling-system (ELK-stack). Diagrammet nedan visar hur molnapplikationen fungerar enligt Hälsokontrollmönstret och Principen för hög observabilitet.
Hur tillämpar man Hälsokontrollmönstret i Kubernetes?
K8s övervakar poddarnas status direkt med hjälp av en av kontrollerarna (, , , och så vidare). Om en pod av någon anledning kraschar försöker kontrollern att starta om den eller schemalägga den på en annan nod. Men en pod kan rapportera att den är igång och fungerar, när den i själva verket inte gör det. Låt oss ge ett exempel: din applikation använder Apache som webserver och du har installerat komponenten på flera pods i klustret. Eftersom biblioteket var felkonfigurerat svarar alla förfrågningar till applikationen med kod 500 (intern serverfel). Vid kontroll av leveransen ger poddarnas status kontroller ett positivt resultat, men kunderna tycker annorlunda. Denna oönskade situation kan vi beskriva på följande sätt:
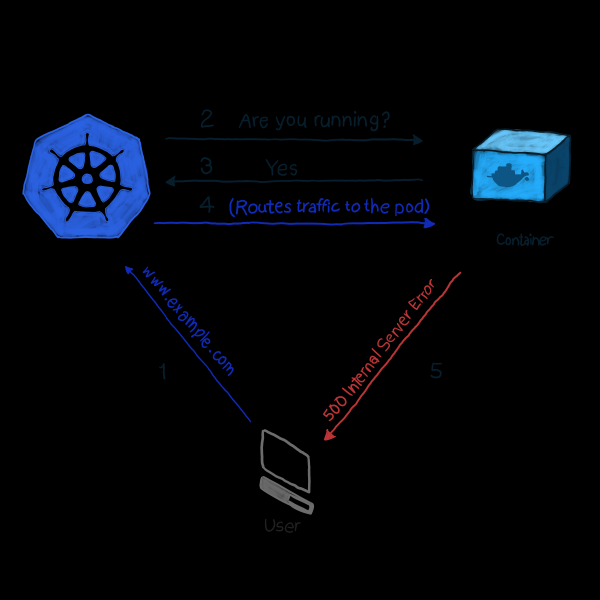
I vårt exempel utför k8s hälsokontrollen. I denna typ av kontroll övervakar kubelet ständigt tillståndet för processen i containern. Så snart den inser att processen har stannat, startar den om den. Om felet kan lösas med en enkel omstart av applikationen, och programmet är utformat för att koppla bort vid varje fel, då är det tillräckligt med en kontroll av processens livslängd enligt NORM och Liveness-prototypen. Det är bara synd att inte alla fel kan åtgärdas med en omstart. För sådana fall erbjuder k8s två mer djupgående metoder för att identifiera problem med podden: och .
LivenessProbe
Under tiden livenessProbe kubelet genomför tre typer av kontroller: den undersöker inte bara om podden fungerar, utan också om den är redo att ta emot och korrekt svara på förfrågningar:
- Ställ in en HTTP-förfrågan till podden. Svaret ska innehålla en HTTP-statuskod mellan 200 och 399. På så sätt signalerar 5xx och 4xx koder att podden har problem, även om processen fungerar.
- För att kontrollera poddar med icke-HTTP-tjänster (till exempel e-postservern Postfix) måste en TCP-anslutning upprättas.
- Exekvering av ett godtyckligt kommando för podden (inuti). Kontroll är framgångsrik om kommandots avslutningskod är 0.
Ett exempel på hur detta fungerar. Definitionen av följande podd innehåller en NodeJS-applikation som ger ett 500-fel på HTTP-förfrågningar. För att säkerställa att containern startas om när ett sådant fel inträffar, använder vi parametern livenessProbe:
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
Detta skiljer sig inte från någon annan pod-definition, men vi lägger till objektet .spec.containers.livenessProbe. Parametern httpGet anger sökvägen för HTTP GET-förfrågan (i vårt exempel är detta /, men i verkliga scenarier kan det vara något som /api/v1/status). LivenessProbe tar också parametern initialDelaySeconds, som ålägger kontrolloperationen att vänta angivna antal sekunder. Fördröjningen behövs eftersom containern behöver tid för att starta, och efter en omstart kommer den att vara otillgänglig under en period.
För att tillämpa denna inställning på klustret, använd:
kubectl apply -f pod.yamlEfter några sekunder kan innehållet i podden kontrolleras med följande kommando:
kubectl describe pods node500Sök efter .
Som ni ser initierade livenessProbe en HTTP GET-begäran, containern gav ett fel 500 (som den var programmerad att göra), kubelet startade om den.
Om du är intresserad av hur NideJS-applikationen programmerades, här är filerna app.js och Dockerfile som användes:
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("Vi har stött på ett feln");
});

server.listen(3000, function() {
    console.log('Server körs på 3000')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node","/app.js" ]
Det är viktigt att notera följande: livenessProbe startar om containern endast vid fel. Om omstarten inte åtgärdar problemet som hindrar containern från att fungera, kan kubelet inte vidta åtgärder för att lösa felet.
beredskapskontroll
readinessProbe fungerar på liknande sätt som livenessProbes (GET-begäran, TCP-anslutningar och kommandokörning), med undantag för åtgärder för att lösa fel. En container som har registrerat ett fel startas inte om, utan isoleras från inkommande trafik. Föreställ dig att en av containrarna utför många beräkningar eller utsätts för tung belastning, vilket ökar svarstiden för begärningar. I fall av livenessProbe aktiveras tillgänglighetskontrollen (via timeoutSeconds-parametern), varefter kubelet startar om containern. När containern startas, börjar den utföra resurskrävande uppgifter och den startas om igen. Detta kan vara kritiskt för applikationer där svarstiden är viktig. Till exempel, om en maskin är på väg och väntar på ett svar från servern, om svaret dröjer kan maskinen krascha.
Låt oss skriva en definition för readinessProbe som ställer in svarstiden på GET-begäran till högst två sekunder, medan applikationen svarar på GET-begäran efter 5 sekunder. Filen pod.yaml ska se ut på följande sätt:
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: /
         port: 3000
       timeoutSeconds: 2
Låt oss distribuera pod med kubectl:
kubectl apply -f pod.yamlVänta ett par sekunder och titta sedan på hur readinessProbe svarade:
kubectl describe pods nodedelayedI slutet av utskriften kan du se att en del av evenemangen är lika med .
Som ni ser valde kubectl att inte starta om pod när kontrolltiden överskred 2 sekunder. Istället avbröt den begäran. Inkommande anslutningar omdirigeras till andra, fungerande poddar.
Observera: nu, när den onödiga belastningen har tagits bort från pod'en, riktar kubectl återigen sina förfrågningar till den: svaren på GET-förfrågningar dröjer inte längre.
För jämförelse: här är den ändrade filen app.js:
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hello\n");
   })
});

server.listen(3000, function() {
   console.log('Servern körs på 3000')
})
TL;DR
Före lanseringen av molnapplikationer var loggar huvudverktyget för övervakning och tillståndskontroll av applikationer. Det fanns dock inga medel för att vidta åtgärder för att åtgärda problem. Loggar är fortfarande användbara idag, de bör samlas in och skickas till logghanteringssystemet för analys av nödsituationer och beslutsfattande. [detta var allt möjligt att göra utan molnapplikationer med hjälp av monit, till exempel, men med k8s har det blivit mycket enklare 🙂 – red. anm. ]
Idag måste ändringar göras nästan i realtid, så applikationer får inte längre vara svarta lådor. Nej, de måste visa slutpunkter som gör det möjligt för övervakningssystem att begära och samla in värdefulla data om processernas tillstånd, så att man snabbt kan reagera om det behövs. Detta kallas designmönster för hälsoundersökning, som följer principen om hög observabilitet (HOP).
Kubernetes erbjuder som standard 2 typer av hälsoundersökningar: readinessProbe och livenessProbe. Båda använder samma typer av kontroller (HTTP GET-förfrågningar, TCP-anslutningar och kommandokörning). De skiljer sig åt i vilka åtgärder som vidtas som svar på problem i pod'ar. livenessProbe startar om containern i hopp om att felet inte upprepas, medan readinessProbe isolerar pod'en från inkommande trafik – tills problemet är löst.
Korrekt applikationsdesign bör inkludera båda typer av kontroller, och de bör samla tillräckligt med data, särskilt när en extraordinär situation har uppstått. Den bör också visa nödvändiga API-slutpunkter som överför viktiga driftsstatusmetrik till övervakningssystemet (samma Prometheus).
Källa: habr.com
