

Hej, Habr! Vi bjuder in Data Engineers och Machine Learning-specialister till en gratis demo-lektion . Vi publicerar också en artikel av Luca Monno – Head of Financial Analytics på CDP SpA.
En av de mest användbara och enkla metoderna inom maskininlärning är Ensemble Learning. Ensemble Learning är en metod som ligger till grund för XGBoost, Bagging, Random Forest och många andra algoritmer.
På Towards Data Science finns det många intressanta artiklar, men jag valde två historier ( och ), som jag gillade mest. Så varför skriva ytterligare en artikel om EL? För att jag vill visa dig, hur det fungerar i ett enkelt exempel, som fick mig att förstå att det inte finns något mystiskt med detta.
När jag först såg EL i aktion (i en uppgift med flera mycket enkla regressionsmodeller) kunde jag inte tro mina ögon, och jag minns fortfarande professorn som lärde mig denna metod.
Jag hade två olika modeller (två svaga inlärningsalgoritmer) med out-of-sample R²-värden lika med 0,90 och 0,93 respektive. Innan jag såg resultatet trodde jag att jag skulle få R² någonstans mellan de två ursprungliga värdena. Med andra ord trodde jag att EL kunde användas för att få modellen att fungera inte så dåligt som den sämsta, men inte så bra som den bästa modellen skulle kunna prestera. Till min största överraskning gav resultaten av den enkla genomsnittliga förutsägelsen R² på 0,95.
Först började jag leta efter fel, men sedan tänkte jag att det kanske döljer sig någon slags magi här!
Vad är Ensemble Learning
Med hjälp av EL kan man kombinera förutsägelser från två eller flera modeller för att få en mer tillförlitlig och effektiv modell. Det finns många metodologier för att arbeta med ensembles av modeller. Här kommer jag att beröra två av de mest användbara för att ge en övergripande förståelse.
regression
Med hjälp av man kan ta genomsnitt av befintliga modellresultat. klassificering
Med hjälp av man kan låta modellerna välja etiketter. Etiketten som valdes oftast – är den som den nya modellen kommer att välja. Varför fungerar EL bättre
Varför EL fungerar bättre
Huvudorsaken till att EL fungerar bättre är att varje prediktion har ett fel (detta vet vi från sannolikhetsteorin). Att kombinera två prediktioner kan hjälpa till att minska felet och därmed förbättra prestandan (RMSE, R², osv.).
I nästa diagram kan vi se hur två svaga algoritmer arbetar med en datamängd. Den första algoritmen har en brantare lutning än nödvändigt, medan den andra nästan är lika med noll (kanske på grund av överanpassning). Men ensemble visar ett betydligt bättre resultat.
Om vi ser på R²-värdet, kommer det för den första och andra inlärningsalgoritmen att vara -0,01¹ och 0,22, respektive, medan ensemblen ger 0,73.
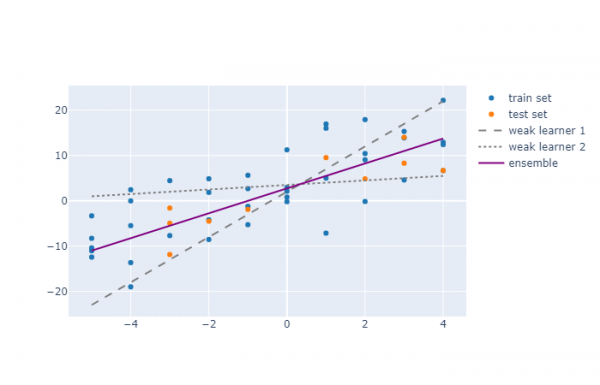
Det finns många anledningar till att en algoritm kan visa sig vara en dålig modell även i ett så grundläggande exempel som detta: kanske har du valt att använda regularisering för att undvika överanpassning, eller valt att inte utesluta vissa anomalier, eller kanske har du använt polynomisk regression och valt fel grad (till exempel använt ett polynom av andra graden, medan det i testdata är uppenbar asymmetri där tredje graden skulle passa bättre).
När EL fungerar bättre
Låt oss titta på två inlärningsalgoritmer som arbetar med samma data.
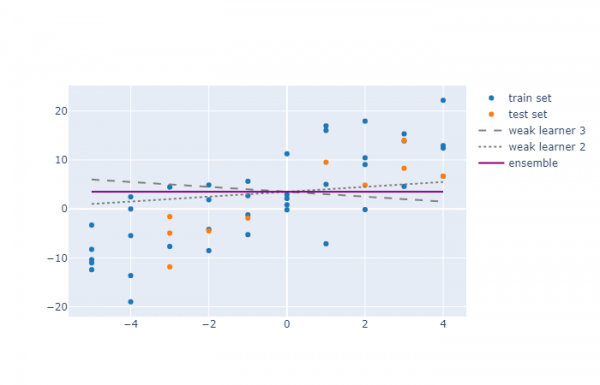
Här kan vi se att kombinationen av två modeller inte förbättrade prestandan särskilt mycket. Ursprungligen hade de två inlärningsalgoritmerna R²-värden på -0,37 respektive 0,22, medan ensemblen resulterade i -0,04. Det vill säga att EL-modellen fick ett medelvärde av värdena.
Men det finns en stor skillnad mellan dessa två exempel: i det första exemplet var modellernas fel negativt korrelerade, medan de i det andra var positivt korrelerade (koefficienterna för de tre modellerna utvärderades inte utan valdes bara av författaren som exempel).
Därför kan ensemble learning användas för att förbättra balansen mellan bias/varians i alla fall, men när modellernas fel inte är positivt korrelerade, kan användningen av EL leda till ökad prestanda..
Homogena och heterogena modeller
Ensemble Learning används ofta på homogena modeller (som i detta exempel eller i en random forest), men i verkligheten kan du kombinera olika modeller (linjär regression + neuronnät + XGBoost) med olika uppsättningar av förklarande variabler. Detta kommer sannolikt att leda till okorrelerade fel och ökad prestanda.
Jämförelse med portföljdiversifiering
Ensemble Learning fungerar på samma sätt som diversifiering i portföljteori, vilket är bra för oss.
Vid diversifiering försöker du minska spridningen av dina resultat genom att investera i okorrelerade aktier. En väl diversifierad aktieportfölj kommer att ge en avkastning som är bättre än den sämsta enskilda aktien, men aldrig bättre än den bästa.
Citerar Warren Buffett:
„Diversifiering är en skyddsmekanism mot okunnighet; för den som inte vet vad han gör, har det [diversifiering] mycket lite mening.”
Inom maskininlärning hjälper Ensemble Learning till att minska spridningen av din modell, men det kan leda till en modell som har en övergripande prestanda som är bättre än den bästa ursprungliga modellen.
Sammanfattningsvis
Att kombinera flera modeller till en är en relativt enkel metod som kan hjälpa till att lösa problemet med bias-spridning och öka prestandan.
Om du har två eller fler modeller som fungerar bra, välj inte mellan dem: använd dem alla (men med försiktighet)!
Är du intresserad av att utvecklas inom detta område? Anmäl dig till en gratis demo-lektion och delta i — Machine Learning Engineer på Mail.ru Group.
Källa: habr.com
