

Dataklassificering baseret på indhold er en åben opgave. Traditionelle systemer til forebyggelse af datatab (DLP) løser dette problem ved at tage fingeraftryk af relevante data og overvåge slutpunkter for at indsamle fingeraftryk. Givet det store antal konstant skiftende datakilder på Facebook er denne tilgang ikke kun ikke skalerbar, men også ineffektiv til at bestemme, hvor dataene befinder sig. Denne artikel handler om et gennemgående system, der er bygget til at opdage følsomme semantiske typer på Facebook i stor skala og automatisk sikre datalagring samt adgangskontrol.
Den tilgang, der er beskrevet her, er vores første gennemgående system til privatliv, som forsøger at løse dette problem ved at inkludere datasignaler, maskinlæring og traditionelle metoder til fingeraftryk for at kortlægge og klassificere alle data på Facebook. Det beskrevne system drives i et produktionsmiljø og opnår en gennemsnitlig F2-score på 0,9+ på tværs af forskellige privatlivsklasser, mens det behandler store mængder dataressourcer i dusinvis af lagre. Vi præsenterer en oversættelse af Facebooks publikation på ArXiv om skalerbar dataklassificering til sikring af sikkerhed og privatliv baseret på maskinlæring.
Introduktion
Idag samlar och lagrar organisationer stora mängder data i olika format och platser [1], och dessa data används på många ställen, ibland kopieras eller cachas flera gånger, vilket resulterar i att värdefull och konfidentiell affärsinformation sprids över många företags datalager. När en organisation krävs att uppfylla vissa lagliga eller regulatoriska krav, såsom att följa regler under civilrättsliga förfaranden, uppstår behovet av att samla in data om var de nödvändiga uppgifterna finns. När det står i ett sekretessbeslut att en organisation måste maskera alla personnummer (SSN) vid överföring av personlig information till obehöriga parter, är det naturliga första steget att söka efter alla SSN i hela organisationens datalager. Under sådana omständigheter blir dataklassificering avgörande [1]. Ett klassificeringssystem kommer att möjliggöra för organisationer att automatiskt säkerställa efterlevnad av sekretess och säkerhetspolicyer, såsom införande av åtkomsthanteringspolicyer och datalagring. Facebook presenterar ett system som vi har byggt inom Facebook, som utnyttjar många datatecken, skalbar systemarkitektur och maskininlärning för att upptäcka känsliga semantiska datatyper.
Upptäckte och klassificerade data innebär att de söks och märks på ett sätt så att relevant information snabbt och effektivt kan hämtas när så behövs. Den nuvarande processen är mer manuell och består av att studera relevanta lagar eller regler, fastställa vilka typer av information som bör betraktas som känsliga och vad de olika nivåerna av känslighet är, för att sedan konstruera klasser och klassificeringspolicyer i enlighet därmed [1]. Efter system för dataläckageskydd (DLP) tar man avtryck av data och spårar slutpunkter nedströms för att få avtrycken. När man arbetar med ett lager med ett stort antal tillgångar och petabyte av data skalar helt enkelt inte denna metod.
Vårt mål är att bygga ett dataklassificeringssystem som kan skalas för både stabila och instabila användardata, utan några ytterligare begränsningar på datatyp eller format. Detta är ett djärvt mål och, naturligtvis, medföljer det utmaningar. En datainspelning kan vara tusentals tecken lång.
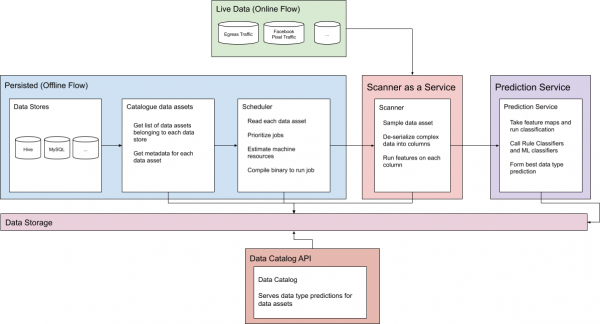
Figur 1. Flöden av online och offline prognoser
Därför måste vi effektivt representera det, med en gemensam uppsättning funktioner som kan kombineras och enkelt flyttas. Dessa funktioner bör inte bara säkerställa noggrann klassificering, utan också ge flexibilitet och utvidgbarhet för att lätt kunna lägga till och upptäcka nya datatyper i framtiden. För det andra, måste vi hantera stora autonoma tabeller. Stabila data kan lagras i tabeller som är flera petabyte stora. Detta kan leda till minskad scanninghastighet. För det tredje, måste vi följa strikta SLA-klassificeringar för instabila data. Detta tvingar systemet att vara högpresterande, snabbt och exakt. Slutligen måste vi säkerställa dataklassificering med låg latens för instabila data, för att utföra klassificering i realtid, såväl som för användningsfall på nätet.
Denna artikel beskriver hur vi hanterade ovanstående problem och presenterar ett snabbt och skalbart klassificeringssystem som klassificerar dataelement av alla typer, format och källor baserat på en gemensam uppsättning funktioner. Vi har utvidgat systemarkitekturen och skapat en specialiserad maskininlärningsmodell för snabb klassificering av offline- och onlinedata. Artikeln är organiserad på följande sätt: avsnitt 2 presenterar den övergripande systemdesignen. Avsnitt 3 diskuterar delarna av maskininlärningssystemet. I avsnitt 4 och 5 diskuteras relaterat arbete och framtida riktningar.
Arkitektur
För att hantera problemen med stabila data och online-data i Facebooks skala, har klassificeringssystemet två separata flöden som vi kommer att diskutera i detalj.
Stabila data
Först måste systemet samla in information om många informationsresurser på Facebook. För varje datalager samlas viss grundläggande information, såsom datacenter som innehåller dessa data, systemet med dessa data och tillgångar som finns i det specifika datalagret. Detta skapar en katalog över metadata som gör att systemet kan extrahera data effektivt utan att överbelasta kunder och resurser som används av andra ingenjörer.
Denna metadata-katalog ger en pålitlig källa för alla skannade tillgångar och möjliggör spårning av olika tillgångars status. Med hjälp av denna information fastställs prioritet för planering baserat på insamlade data och intern information från systemet, såsom tidpunkten för den senaste framgångsrika skanningen av tillgången och dess skapelse, samt tidigare krav på minne och processor för denna tillgång, om den har skannats tidigare. Sedan för varje datakälla (i takt med att resurser blir tillgängliga) kallas uppgiften för den faktiska skanningen av resursen.
Varje uppgift är en kompilera binär fil som utför Bernoulli-urval på de senaste data som är tillgängliga för varje tillgång. Tillgången delas upp i separata kolumner, där klassificeringsresultatet för varje kolumn bearbetas oberoende. Dessutom skannar systemet alla mättade data i kolumnerna. JSON, arrayer, kodade strukturer, URL-adresser, serialiserade data i base 64 och mycket mer — allt detta skannas. Detta kan avsevärt öka tiden för skanningen, eftersom en tabell kan innehålla tusentals inbäddade kolumner i ett stort binärt objekt. json.
För varje rad som väljs i datatillgången extraherar klassificeringssystemet flytande och textobjekt från innehållet och kopplar varje objekt tillbaka till den kolumn det hämtades ifrån. Resultatet av objektutvinningssteget är en karta över alla objekt för varje kolumn som hittats i datatillgången.
Vad är syftet med egenskaper?
Begreppet egenskaper är en nyckelpunkt. Istället för egenskaper som float och text kan vi överföra rå dataexempel, som direkt extraheras från varje datakälla. Dessutom kan maskininlärningsmodeller tränas direkt på varje urval, istället för att baseras på hundratals beräkningar av egenskaper som endast försöker approximera urvalet. Det finns flera anledningar till detta:
- Integritet är av största vikt: det viktigaste är att begreppet egenskaper gör att vi endast lagrar de exempel som vi extraherar. Detta garanterar att vi lagrar exempel för ett enda syfte och aldrig loggar dem genom våra egna insatser. Detta är särskilt viktigt för osäkra data, eftersom tjänsten måste upprätthålla ett visst klassificeringstillstånd innan den tillhandahåller prognoser.
- Minneshantering: vissa prover kan vara tusentals tecken långa. Att lagra sådan data och överföra den till olika delar av systemet utan behov förbrukar många extra byte. Två faktorer kan kombinera över tid, med tanke på att det finns många datakällor med tusentals kolumner.
- Aggregering av egenskaper: genom att använda egenskaper representeras resultaten av varje skanning tydligt, vilket gör att systemet kan kombinera resultaten av tidigare skanningar av samma datakälla på ett bekvämt sätt. Detta kan vara användbart för att aggregera resultaten av skanningar av en datakälla under flera körningar.
Därefter skickas egenskaperna till prognosservicen, där vi använder regelbaserad klassificering och maskininlärning för att förutsäga datamärkena för varje kolumn. Tjänsten förlitar sig både på regelklassificerare och maskininlärning och väljer den bästa prognosen som ges av varje prognosobjekt.
Regelklassificerare är manuella heuristik, som använder beräkningar och koefficienter för att normalisera objektet i intervallet 0 till 100. Så snart en sådan initial poäng genereras för varje typ av data och kolumnnamnet kopplat till dessa data, och inte hamnar på några "svartlistor", väljer regelklassificeraren den högsta normaliserade poängen bland alla datatyper.
På grund av svårigheter med klassificering leder enbart manuella heuristik till låg klassificeringsnoggrannhet, särskilt för ostrukturerade data. Därför har vi utvecklat ett system för maskininlärning för att hantera klassificering av ostrukturerade data, såsom användarinnehåll och adresser. Maskininlärning har möjliggjort en övergång från manuella heuristik till att tillämpa ytterligare datakällor (t.ex. kolumnnamn, datakälla), vilket avsevärt ökar noggrannheten i upptäckten. Vi kommer att gå djupare in på vår maskininlärningsarkitektur senare.
Prognostjänsten lagrar resultaten för varje kolumn tillsammans med metadata relaterade till tid och skanningsstatus. Eventuella konsumenter och efterföljande processer som är beroende av dessa data kan läsa dem från det dagliga publicerade datasetet. Detta dataset aggregerar resultaten från alla dessa skanningsuppdrag, eller realtids-API:t för datakatalogen. De publicerade prognoserna är grunden för automatiskt tillämpande av sekretess- och säkerhetspolicyn.
Slutligen, efter att prognostjänsten har registrerat all data och alla prognoser har sparats, kan vårt datakatalog-API returnera alla prognoser för datatyper för resursen i realtid. Varje dag publicerar systemet ett dataset som innehåller de senaste prognoserna för varje tillgång.
Ostabila data
Även om processen som beskrivs ovan är avsedd för sparade tillgångar, betraktas ostrukturerad trafik också som en del av organisationens data och kan vara viktig. Därför tillhandahåller systemet ett online-API för generering av realtidsprognoser för klassificering av eventuell ostabil trafik. Real-time prognossystem används i stor utsträckning vid klassificering av utgående trafik, inkommande trafik i maskininlärningsmodeller och annonsördata.
Här tar API emot två huvudargument: grupperingens nyckel och de rådata som ska förutsägas. Tjänsten utför samma objektextraktion som beskrivits ovan och grupperar objekten tillsammans för samma nyckel. Dessa funktioner stöds också i den sparade cachen för återställning efter fel. För varje grupperingens nyckel säkerställer tjänsten att den har sett tillräckligt med urval innan den anropar förutsägelse-tjänsten enligt processen som beskrivits ovan.
Optimering
För scanning av vissa lagringsområden använder vi bibliotek och metoder för att optimera läsning från het lagring [2] och garanterar att det inte uppstår några avbrott från andra användare som får åtkomst till samma lagringsområde.
För extremt stora tabeller (50+ petabyte), trots alla optimeringar och minneseffektivitet, arbetar systemet med att skanna och beräkna allt innan minnet tar slut. Slutligen beräknas skanningen helt i minnet och sparas inte under skanningen. Om stora tabeller innehåller tusentals kolumner med ostrukturerade datamängder kan uppdraget misslyckas på grund av brist på minnesresurser när förutsägelser görs för hela tabellen. Detta kommer att leda till minskad täckning. För att bekämpa detta har vi optimerat systemet för att använda skanningshastighet som en mellanhand för hur bra systemet hanterar den aktuella belastningen. Vi använder hastighet som en prognosmekanism för att se minnesproblem och vid proaktiv beräkning av objektskartor. I detta sammanhang använder vi mindre data än vanligt.
Datasignaler
Klassificeringssystemet är bara så bra som signalerna från datan. Här kommer vi att titta på alla signaler som används i klassificeringssystemet.
- Baserat på innehållet: självklart, den första och viktigaste signalen är innehållet. En Bernoulli-sampling utförs för varje datatillgång som vi skannar och extraherar funktioner baserade på datainnehållet. Många funktioner härstammar från innehållet. Det kan finnas vilken mängd flytande objekt som helst som representerar beräkningar av hur många gånger en viss typ av mönster har observerats. Till exempel kan vi ha rotmärken för antalet e-postmeddelanden som setts i urvalet, eller indikatorer för hur många emojis som har observerats i urvalet. Dessa funktionsberäkningar kan normaliseras och aggregeras över olika scanningar.
- Ursprung av data: en viktig signal som kan hjälpa när innehållet har ändrats från föräldratabellen. Ett vanligt exempel är hashade data. När data i dottertabellen hashats kommer de ofta från föräldratabellen, där de förblir i klartext. Data om ursprung hjälper till att klassificera vissa typer av data när de inte läses tydligt eller har konverterats från tabellen uppströms.
- Annotationer: ytterligare en högkvalitativ signal som hjälper till med identifieringen av ostrukturerade data. Faktiskt kan annotationer och ursprungsdata arbeta tillsammans för att sprida attribut mellan olika datatillgångar. Annotationer hjälper till att identifiera källan till ostrukturerade data, medan ursprungsdata kan hjälpa till att spåra flödet av dessa data genom hela lagringen.
- Data-injektion är en metod där specifika, oläsliga tecken medvetet införs i kända källor med kända datatyper. Sedan, varje gång vi skannar innehållet med samma oläsliga sekvens av tecken, kan vi dra slutsatsen att innehållet härstammar från denna kända datatyp. Detta är ytterligare en kvalitativ datasksignal, liknande annotationer. Med undantag för att innehållsbaserad upptäckning hjälper till att upptäcka injicerad data.
Mätning av metrik
En viktig komponent är en strikt metodologi för mätning av metrik. De grundläggande metrikerna för iterativ förbättring av klassificeringen är precision och återkallande av varje etikett, där F2-mätningen är den mest betydelsefulla.
För att beräkna dessa mått behövs en oberoende metodologi för märkning av datatillgångar, som inte är beroende av själva systemet men som kan användas för att göra direkt jämförelser med det. Nedan kommer vi att beskriva hur vi samlar in den grundläggande sanningen från Facebook och använder den för att träna vårt klassificeringssystem.
Insamling av tillförlitliga data
Vi samlar in tillförlitliga data från varje källa som listas nedan, i sin egen tabell. Varje tabell ansvarar för att aggregera de senaste observerade värdena från denna specifika källa. Varje källa har en kvalitetskontroll av data för att säkerställa att de observerade värdena för varje källa är av hög kvalitet och innehåller de senaste typerna av datamärkningar.
- Konfigurationer av loggplattformer: specifika fält i tabellerna fylls med data som är kopplade till en viss typ. Användningen och spridningen av dessa data utgör en pålitlig källa till tillförlitliga data.
- Manuell märkning: utvecklare som stöder systemet samt externa märkare är utbildade för att märka kolumner. Detta fungerar vanligtvis bra för alla typer av data i lagret och kan vara en primär källa till tillförlitlighet för vissa ostrukturerade data, såsom meddelandedata eller användargenererat innehåll.
- Kolumner från förälderstabeller kan märkas eller annoteras som innehållande viss data, och vi kan spåra dessa data i underrapporter.
- Urval av utförandestreamar: utförandestreamar i Facebook bär data av en viss typ. Genom att använda vår skanner som tjänstearkitektur kan vi välja streamar med kända datatyper och skicka dem genom systemet. Systemet lovar att inte lagra dessa data.
- Urvalstabeller: stora tabeller som kallas som är kända för att innehålla hela datakorpuset kan också användas som träningsdata och skickas genom skannern som en tjänst. Detta är utmärkt för tabeller med ett komplett spektrum av datatyper, så att urval av en kolumn slumpmässigt är ekvivalent med urval av hela mängden av den datatypen.
- Syntetiska data: vi kan till och med använda bibliotek som genererar data i realtid. Detta fungerar bra för enkla, offentliga datatyper som adresser eller GPS.
- Data stewardar: program för sekretess använder vanligtvis data stewardar för att manuellt koppla politik till delar av data. Detta tjänar som en högprecisionskälla för trovärdighet.
Vi sammanför varje huvudkälla till pålitliga data i en enda corpus med all denna information. Det största problemet med trovärdighet är att säkerställa att den är representativ för datalagret. Annars kan klassificeringsmotorer övertränas. För att motverka detta används alla ovanstående källor för att säkerställa balans vid träning av modeller eller beräkning av metrik. Dessutom plockar människor jämnt ut olika kolumner i lagret och märker data i enlighet med detta, så att insamlingen av pålitliga värden förblir opartisk.
Kontinuerlig integration
För att säkerställa snabb iteration och förbättring är det viktigt att alltid mäta systemets prestanda i realtid. Vi kan mäta varje förbättring i klassificeringen jämfört med systemet idag, så vi strategiskt kan fokusera på data i framtida förbättringar. Här ser vi hur systemet fullbordar en återkopplingscykel som säkerställs av pålitliga data.
När planeringssystemet stöter på en tillgång som har en etikett från en pålitlig källa planerar vi två uppgifter. Den första använder vår produktionsskanner och därmed våra produktionsmöjligheter. Den andra uppgiften använder skannern från den senaste versionen med de senaste funktionerna. Varje uppgift skriver sin utdata i sin egen tabell och märker versionerna tillsammans med klassificeringsresultaten.
Så jämför vi klassificeringsresultaten för releasekandidaten och produktionsmodellen i realtid.
Medan dataset-gränssnittet jämför RC- och PROD-attribut loggas många variationer av ML-klassificeringsmotorn för prognostjänsten. Den senaste byggda maskininlärningsmodellen, den nuvarande modellen i produktion och eventuella experimentella modeller. Samma metod gör det möjligt för oss att "skära" olika versioner av modellen (agnostiska regler för våra klassificerare) och jämföra metrik i realtid. Det är enkelt att avgöra när ML-experimentet är redo att implementeras i produktion.
Varje natt skickas RC-attributen som beräknades för den dagen till ML-träningslinjen där modellen tränas på de senaste RC-attributen och utvärderar sin prestation i förhållande till en pålitlig dataset.
Varje morgon slutför modellen träningen och publiceras automatiskt som experimentell. Den aktiveras automatiskt i listan över experimentella.
Några resultat
Över 100 olika typer av data märks med hög precision. Välstrukturerade typer, såsom e-post och telefonnummer, klassificeras med F2-betyg över 0,95. Fria datatyper, såsom användarinnehåll och namn, fungerar också mycket bra med F2-betyg över 0,85.
En stor mängd separata kolumner av stabil och instabil data klassificeras dagligen i alla datalager. Över 500 terabyte skannas varje dag i mer än 10 datalager. Täckningen av de flesta av dessa lager är över 98%.
Över tid har klassificeringen blivit mycket effektiv, som klassificeringsuppdrag inom det kvarhållna autonoma flödet i genomsnitt tar 35 sekunder från skanning av aktiva till att beräkna prognoser för varje kolumn.
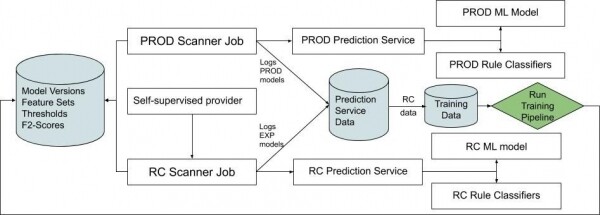
Fig. 2. Diagram som beskriver det kontinuerliga integrationsflödet för att förstå hur RC-objekten genereras och skickas till modellen.
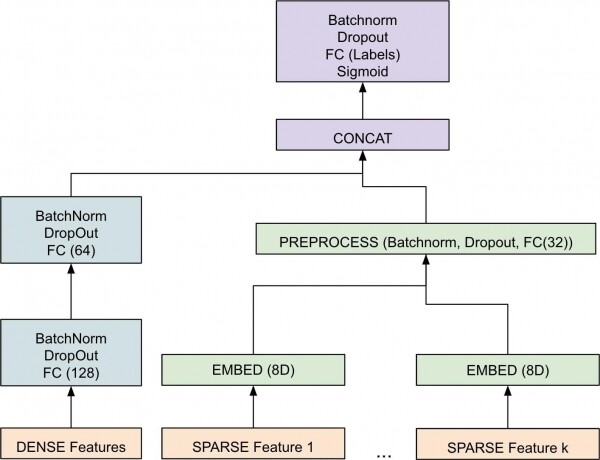
Figur 3. Övergripande diagram över maskininlärningskomponenten.
Komponent i maskininlärningssystemet
I föregående avsnitt dyker vi djupt ner i arkitekturen för hela systemet, och lyfter fram skalan, optimeringen och datalänen både i autonom och online-läge. I detta avsnitt kommer vi att se på prognostjänsten och beskriva maskininlärningssystemet som driver prognostjänsten.
Med mer än 100 datatyper och viss ostrukturerad information, såsom meddelandedata och användargenererat innehåll, leder enbart användning av manuell heuristik till suboptimal klassificeringsnoggrannhet, särskilt för ostrukturerade data. Av denna anledning har vi också utvecklat ett maskininlärningssystem för att hantera komplexiteten hos ostrukturerade data. Användningen av maskininlärning gör det möjligt att börja avvika från manuell heuristik och arbeta med funktioner och ytterligare datatecken (t.ex. kolumnnamn, datakällor) för att öka noggrannheten.
Den implementerade modellen studerar vektorrepresentationer [3] av täta och glesa objekt separat. Dessa kombineras sedan för att bilda en vektor som går igenom en serie steg för batchnormalisering [4] och icke-linjäritet för att få det slutgiltiga resultatet. Det slutgiltiga resultatet är ett flyttal mellan [0-1] för varje etikett, vilket indikerar sannolikheten för att exemplet tillhör den aktuella känslighetsklassen. Användningen av PyTorch för modellen har gjort det möjligt för oss att gå snabbare, vilket ger utvecklarna utanför teamet möjlighet att snabbt göra och testa ändringar.
Vid utformning av arkitekturen var det viktigt att modellera glesa (t.ex. text) och täta (t.ex. numeriska) objekt separat på grund av deras interna skillnader. För den slutgiltiga arkitekturen var det också viktigt att utföra parameterutveckling för att hitta optimala värden för inlärningshastighet, batchstorlek och andra hyperparametrar. Valet av optimerare var också en viktig hyperparameter. Vi upptäckte att den populära optimeraren Adamofta leder till överanpassning, medan modellen med SGD stabilare. Det fanns ytterligare detaljer som vi behövde inkludera direkt i modellen. Till exempel, statiska regler som garanterade att modellen gör en deterministisk prognos när en funktion har ett visst värde. Dessa statiska regler definieras av våra kunder. Vi upptäckte att inkluderingen av dem direkt i modellen resulterade i en mer självförsörjande och pålitlig arkitektur, i motsats till att implementera ett efterbearbetningssteg för att hantera dessa speciella gränsfall. Observera också att dessa regler stängs av under träningen för att inte störa gradientnedstigningsprocessen.
Problem
Ett av problemen var insamlingen av högkvalitativa och tillförlitliga data. Modellen behöver tillförlitlighet för varje klass så att den kan lära sig associationer mellan objekt och etiketter. I det föregående avsnittet diskuterade vi metoder för datainsamling både för systemmätning och för att träna modeller. Analysen visade att sådana dataklasser som kreditkortsnummer och bankkontonummer inte är särskilt vanliga i vårt förråd. Detta gör det svårt att samla stora mängder tillförlitliga data för att träna modeller. För att lösa detta problem utvecklade vi processer för att erhålla syntetiska tillförlitliga data för dessa klasser. Vi genererar sådana data för känsliga typer, inklusive SSN, kreditkortsnummer och IBAN-nummer för vilka modellen inte kunde göra prognoser tidigare. Detta tillvägagångssätt möjliggör behandling av känsliga datatyper utan den sekretessrisk som är kopplad till att dölja verkliga känsliga data.
Utöver problemen med pålitliga data finns det öppna arkitekturproblem som vi arbetar med, såsom isolerade förändringar och tidig stoppning. Isolering av förändringar är viktig för att effekterna av olika ändringar i olika delar av nätverket ska isoleras från specifika klasser och inte påverka den övergripande prognosprestandan. Förbättring av kriterierna för tidig stopp är också avgörande för att vi ska kunna stoppa träningen vid en stabil punkt för alla klasser, istället för vid en punkt där vissa klasser överanpassas medan andra inte gör det.
Funktionens betydelse
När en ny funktion införs i modellen vill vi veta dess totala påverkan på modellen. Vi vill också säkerställa att prognoserna är mänskligt tolkningsbara så att vi exakt kan förstå vilka funktioner som används för varje datatyp. För detta har vi utvecklat och introducerat klassvis betydelse för modellen PyTorch. Observera att detta skiljer sig från den totala betydelsen av funktionen, som vanligtvis stöds, eftersom den inte berättar för oss vilka funktioner som är viktiga för en specifik klass. Vi mäter betydelsen av en funktion genom att beräkna ökningen av prognosfelet efter att funktionen har omarrangerats. En funktion är 'viktig' när omarrangeringen av värdena ökar modellens fel, eftersom modellen i så fall litade på funktionen i sin prognos. En funktion är 'oviktig' när omarrangeringen av dess värden lämnar modellens fel oförändrat, eftersom modellen i detta fall ignorerade den.
Funktionens betydelse för varje klass gör modellen tolkbar så att vi kan se vad modellen fokuserar på när den prognostiserar etiketten. Till exempel, när vi analyserar ADDR, säkerställer vi att den relaterade adressfunktionen, såsom AddressLinesCount, rankas högt på listan över viktiga funktioner för varje klass, så att vår mänskliga intuition stämmer väl överens med vad modellen lärt sig.
Utvärdering
Det är viktigt att definiera en enhetlig framgångsmått. Vi har valt F2 — en balans mellan återkoppling och noggrannhet (med stödjustering något högre). Återkopplingen är viktigare för användningsfallet av sekretess än noggrannhet, eftersom det är avgörande för teamet att inte missa några känsliga data (samtidigt som man säkerställer rimlig noggrannhet). De faktiska dataresultaten av F2-mätningen av vår modell går utöver denna artikel. Men med noggrann justering kan vi nå en hög (0,9+) F2-poäng för de mest känsliga klasserna.
Relaterat arbete
Det finns många algoritmer för automatisk klassificering av ostrukturerade dokument som använder olika metoder, såsom mönstermatchning, dokumentlikhetsanalys och olika maskininlärningsmetoder (bayesiska, beslutsträd, k närmaste grannar och många fler) [6]. Någon av dessa kan användas som en del av klassificeringen. Problemet ligger dock i skalbarheten. Klassificeringsmetoden som beskrivs i denna artikel lutar åt flexibilitet och prestanda. Detta gör att vi kan stödja nya klasser i framtiden och hålla låg latens.
Det finns också många studier om fingeravtryck på data. Till exempel beskriver författarna i [7] en lösning som fokuserar på problemet med att fånga läckage av känsliga data. Den grundläggande antagandet är möjligheten att ta fingeravtryck av data för att matcha det med en uppsättning kända känsliga data. Författarna i [8] beskriver ett liknande problem med sekretessläckage, men deras lösning bygger på en specifik Android-arkitektur och klassificeras endast om användarens åtgärder har lett till att personlig information har skickats eller om det har skett en läcka av användardata i den underliggande applikationen. Situationen här är något annorlunda eftersom användardata också kan vara kraftigt ostrukturerade. Därför behöver vi en mer avancerad teknik än fingeravtryck.
Till slut, för att hantera bristen på data för vissa typer av konfidentiell information, har vi infört syntetiska data. Det finns mycket litteratur om augmentering av data, till exempel har författarna i [9] undersökt rollen av brusinsprutning under träning och observerat positiva resultat inom kontrollerad inlärning. Vårt tillvägagångssätt för integritet är annorlunda eftersom insprutningen av brusig data kan vara kontraproduktiv, och istället fokuserar vi på högkvalitativa syntetiska data.
Slutsats
I denna artikel presenterade vi ett system som kan klassificera datasegment. Detta gör att vi kan skapa system för att säkerställa efterlevnad av integritets- och säkerhetspolicyer. Vi har visat att skalbar infrastruktur, kontinuerlig integration, maskininlärning och högkvalitativa data om datavärdighet spelar en nyckelroll i framgången för många av våra initiativ inom integritet.
Det finns många riktningar för framtida arbete. Det kan inkludera att säkerställa stöd för oschema- tiserade data (filer), klassificering av inte bara datatyp utan också känslighetsnivå, samt att använda självövervakande inlärning direkt under träningen genom att generera exakta syntetiska exempel. Dessa kommer i sin tur att hjälpa modellen att minska förlusterna i större utsträckning. Framtida arbete kan också koncentrera sig på utredningsarbetsflödet, där vi går bortom upptäckten och erbjuder analys av grundorsaker till olika brott mot integriteten. Detta skulle vara till hjälp i fall som känslighetsanalys (dvs. är konfidentialiteten för datatypen hög (t.ex. användarens IP) eller låg (t.ex. Facebooks interna IP)).
Bibliografi
- David Ben-David, Tamar Domany, och Abigail Tarem. Klassificering av företagsdata med hjälp av semantiska webbteknologier. I Peter F.Ï Patel-Schneider, Yue Pan, Pascal Hitzler, Peter Mika, Lei Zhang, Jeff Z. Pan, Ian Horrocks, och Birte Glimm, redaktörer, Det semantiska webbet – ISWC 2010, sidor 66–81, Berlin, Heidelberg, 2010. Springer Berlin Heidelberg.
- Subramanian Muralidhar, Wyatt Lloyd, Sabyasachi Roy, Cory Hill, Ernest Lin, Weiwen Liu, Satadru Pan, Shiva Shankar, Viswanath Sivakumar, Linpeng Tang, och Sanjeev Kumar. f4: Facebooks varma BLOB-lagringssystem. I 11e USENIX Symposium on Operating Systems Design and Implementation (OSDI 14), sidor 383–398, Broomfield, CO, oktober 2014. USENIX Association.
- Tomas Mikolov, Ilya Sutskever, Kai Chen, Greg S Corrado, och Jeff Dean. Distribuerade representationer av ord och fraser och deras sammansättning. I C. J. C. Burges, L. Bottou, M. Welling, Z. Ghahramani, och K. Q. Weinberger, redaktörer, Framsteg inom neurala informationsbearbetningssystem 26, sidor 3111–3119. Curran Associates, Inc., 2013.
- Sergey Ioffe och Christian Szegedy. Batchnormalisering: Påskynda träning av djupa nätverk genom att minska intern variabelförskjutning. I Francis Bach och David Blei, redaktörer, Proceedings of the 32nd International Conference on Machine Learning, volym 37 av Proceedings of Machine Learning Research, sidor 448–456, Lille, Frankrike, 07–09 Jul 2015. PMLR.
- Leo Breiman. Slumparter. Mach. Lär., 45(1):5–32, oktober 2001.
- Thair Nu Phyu. Översikt av klassificeringstekniker inom datamining.
- X. Shu, D. Yao, och E. Bertino. Integritetskännande upptäckter av känslig dataexponering. IEEE Transactions on Information Forensics and Security, 10(5):1092–1103, 2015.
- Zhemin Yang, Min Yang, Yuan Zhang, Guofei Gu, Peng Ning, och Xiaoyang Wang. Appintent: Analys av känslig datatransmission i Android för att upptäcka integritetsläckor. sidor 1043–1054, 11 2013.
- Qizhe Xie, Zihang Dai, Eduard H. Hovy, Minh-Thang Luong, och Quoc V. Le. Oövervakad dataförstärkning.
Ta reda på mer om hur du får en eftertraktad profession från grunden eller nivåhöjer dina färdigheter och lön genom att gå onlinekurser på SkillFactory:
- (12 månader)
- (12 veckor)
- (20 veckor)
- (20 veckor)
Fler kurser
- (9 månader)
- (8 månader)
- (9 månader)
- (12 månader)
- (18 månader)
- (12 månader)
- (9 månader)
- (7 månader)
Källa: habr.com
