

Rapportet presenterar vissa angreppssätt som gör det möjligt att övervaka prestandan för SQL-frågor, när det handlar om miljoner per dag, och kontrollerade PostgreSQL-servrar — hundratals.
Vilka tekniska lösningar gör det möjligt för oss att effektivt hantera sådan volym information, och hur underlättar detta livet för vanliga utvecklare.
För vem är analys av specifika problem och olika optimeringstekniker av SQL-frågor och lösningar på typiska DBA-uppgifter i PostgreSQL - kan också om detta ämne.
Jag heter Kirill Borovikov och representerar Specifikt specialiserar jag mig på arbete med databaser i vårt företag.
Idag ska jag berätta för er hur vi arbetar med optimering av frågor, när ni inte behöver "gräva" i prestandan hos en enda fråga, utan lösa problemet massivt. När det handlar om miljoner frågor och ni behöver hitta några angreppssätt för att lösa detta stora problem.
Generellt sett är "Tensor" för våra en miljon kunder ett företags sociala nätverk, lösningar för videokommunikation, för intern och extern dokumenthantering, redovisningssystem för bokföring och lagring,… Så det är en sådan "megakombinering" för komplett affärshantering med mer än 100 olika interna projekt.
För att allt ska fungera normalt och utvecklas har vi 10 utvecklingscenter runt om i landet, med mer än 1000 utvecklare..
Vi har arbetat med PostgreSQL sedan 2008 och samlat på oss en stor mängd information som vi hanterar - detta inkluderar kunddata, statistiska, analytiska och data från externa informationssystem - mer än 400 TB.Bara i "produktion" är det cirka 250 servrar, och totalt har vi runt 1000 DB-servrar som vi övervakar.
SQL är ett deklarativt språk. Du beskriver inte "hur" något ska fungera, utan "vad" du vill få.
DB-systemet vet bättre hur man gör JOIN - hur man kopplar samman dina tabeller, vilka villkor man ska tillämpa, vad som går genom indexet och vad som inte gör det…
Men trots att PostgreSQL inte tillåter extern hantering, ger det en utmärkt möjlighet att se vad som händer internt, när du utför din förfrågan, och var problemen uppstår.
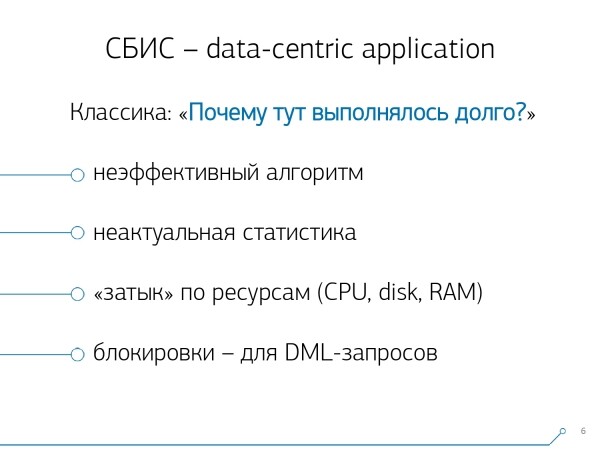
Generellt sett, vilka klassiska problem stöter utvecklaren [mot DBA] vanligtvis på? "Vi har utfört en förfrågan, och det är väldigt långsamt, allt hänger, något pågår... Vilken katastrof!"
Orsakerna är nästan alltid de samma:
- ineffektiv förfrågningsalgoritm
Utvecklaren: "Nu har jag i SQL 10 tabeller genom JOIN..." — och förväntar sig att villkoren på mirakulöst sätt ska lösas effektivt, så att han får det snabbt. Men underverk förekommer inte, och vilket system som helst med sådan variabilitet (10 tabeller i ett FROM) ger alltid en viss felmarginal. [] - ointressant statistik
Detta ögonblick är särskilt relevant för PostgreSQL, när du har laddat en stor dataset på servern, gör en förfrågan — men den "sekspelar" i tabellen. Eftersom den igår hade 10 poster, men idag 10 miljoner, men PostgreSQL vet fortfarande inte om det, och du behöver påminna den om det. [] - "flaskhals" på resurser
Du har installerat en stor och tung databas på en svag server, som saknar diskutrymme, minne, och processorkraft. Och allt... Det finns en gräns för prestanda, över vilken du inte kan hoppa. - låser
Detta är en komplicerad fråga, men den är mest relevant för olika modifierande förfrågningar (INSERT, UPDATE, DELETE) — ett separat stort ämne.
Att få en plan
… Och för allt annat behöver vi en plan! Vi behöver se vad som händer inuti servern.
Exekveringsplanen för en förfrågan i PostgreSQL är ett träd av algoritmer i textformat. Det är just den algoritm som analysatorn har funnit vara mest effektiv vid planering.
Varje nod i trädet är en operation: hämta data från tabellen eller indexet, bygga en bitkarta, förena två tabeller, kombinera, korsa eller exkludera urval. Exekveringen av förfrågan innebär en genomgång av dessa noders träd.
För att få förfrågningsplanen är det enklaste sättet att köra kommandot EXPLAIN. För att få med alla verkliga attribut, det vill säga att faktiskt exekvera förfrågan på databasen — EXPLAIN (ANALYZE, BUFFERS) SELECT ....
Dålig situation: när du utför den sker det "här och nu", så det passar bara för lokal felsökning. Om du tar en högbelastad server som står under ett starkt flöde av datämnen, och ser: "Aj! Här har vi en långsam fråga.Det var för en halvtimme, en timme sedan — medan du sprang och hämtade den här frågan från loggarna, förde den tillbaka till servern, så har hela ditt dataset och statistik förändrats. Du utför den för att felsöka — och den körs snabbt! Och du kan inte förstå varför, varför den är långsam. var För att förstå vad som hände exakt i det ögonblicket när frågan kördes på servern, har smarta människor skrivit
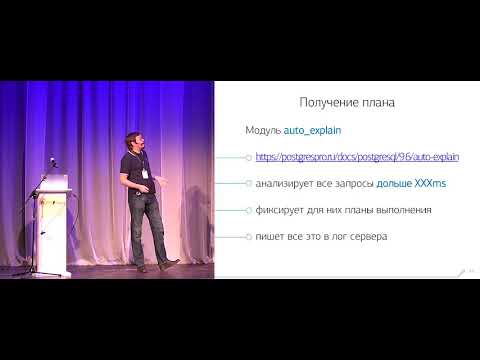
modulen auto_explain. Om den förstår att en fråga körs längre än den gräns du angav, tar den en
"snapshot" av planen för denna fråga och skriver dem tillsammans i loggen. Det ser ut som allt är bra, vi går in i loggen och ser där… [portions text]. Men vi kan inte säga något om det, förutom att det är en utmärkt plan eftersom det kördes på 11 ms..
Det verkar som allt är bra — men inget är klart, vad som faktiskt hände. Förutom den totala tiden ser vi inte mycket mer. För att titta på en sådan "platta" med ren text är helt ogenomskinligt.
Men även om det är ogenomskinligt, låt säga obekvämt, så finns det mer grundläggande problem:
I noden anges
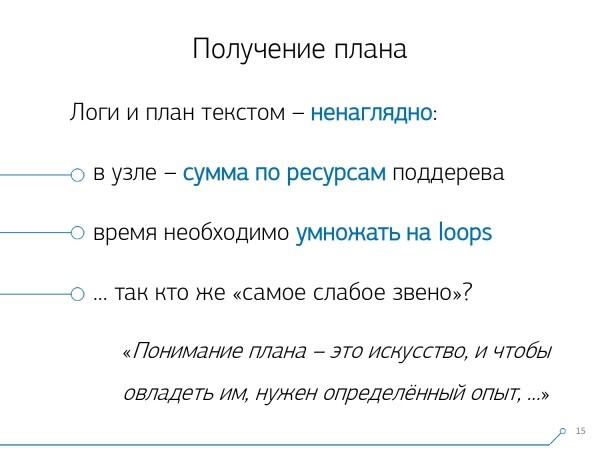
- summan av resurserna för hela underträdet under den. Således kan vi inte enkelt ta reda på hur mycket tid som spenderades på detta specifika Index Scan — om det finns något inbäddat villkor under det. Vi måste dynamiskt se om det finns några "barn" och villkorsvariabler, CTE — och räkna ut allt detta "i huvudet". Den andra punkten: tiden som anges i noden är
- tiden för en engångsutförande av noden. Om denna nod kördes som ett resultat av till exempel en loop över rader i tabellen flera gånger, ökar antalet loops — iterationer av denna nod i planen. Men själva tiden för atomär utförande förblir den samma i planen. Så för att förstå hur länge denna nod faktiskt kördes totalt, måste man multiplicera det ena med det andra — återigen "i huvudet".. Om denna nod har körts som ett resultat av, till exempel, en loop genom tabellposter flera gånger, ökar antalet loops för denna nod i planen. Men själva tiden för atomär körning förblir oförändrad i planen. Det innebär att för att förstå hur länge denna nod faktiskt har körts totalt, måste man multiplicera ena med den andra — återigen "i huvudet".
Under these circumstances, understanding 'Who is the weakest link?' is practically impossible. Therefore, even the developers themselves state in the 'manual' that ‘Understanding the plan is an art that needs to be learned, experience…’.
But we have 1000 developers, and you can't pass this experience into each of their minds. I, you, he — know, but someone over there — does not. Maybe he'll learn, maybe he won't, but he needs to work right now — so where can he gain this experience?
Visualization of the plan
So we realized — to tackle these problems, we need good visualization of the plan.
We initially went 'to the market' — let's search the internet for what exists.
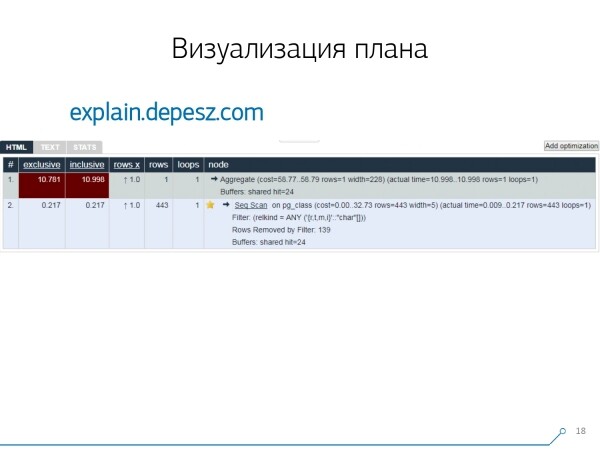
But it turned out that regarding 'live' solutions that are somewhat developed, there are very few — literally, one: by Hubert Lubaczewski. You input a textual representation of the plan, and it shows you a table with the parsed data:
- the node’s own execution time
- the total time across the entire subtree
- the number of entries that were retrieved, and what was statistically expected
- the body of the node itself
This service also has the ability to share a link archive. You upload your plan there and say: 'Hey, Vasya, here’s the link, something is off there.'
But there are some minor issues.
Firstly, a huge amount of 'copy-paste'. You take a piece of the log, stick it there, and again, and again.
Secondly, there is no analysis of the amount of data read — those same buffers that output EXPLAIN (ANALYZE, BUFFERS), we do not see here. It simply can't parse, understand, and work with them. When you read a lot of data and realize that you might be incorrectly 'laying out' on disk and memory cache, this information is very important.
The third negative point — very weak development of this project. Commits are very minor, good if they happen once every six months, and the code is in Perl.
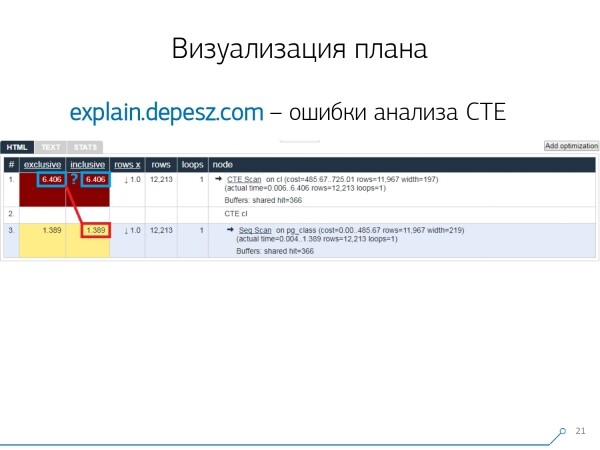
But that’s all 'lyric', we could somehow live with that, but there's one thing that strongly turned us away from this service. It’s the errors in the analysis of Common Table Expressions (CTE) and various dynamic nodes like InitPlan/SubPlan.
If we believe this image, the total execution time of each individual node is greater than the total execution time of the entire query. It's simple — the time for the CTE Scan node did not deduct the time taken to generate this CTEDärför vet vi inte längre det rätta svaret på hur länge själva CTE-skanningen tog.
Här insåg vi att det var dags att skriva vårt eget – hurra! Varje utvecklare säger: "Nu ska vi skriva vårt eget, det kommer att bli superenkelt!"
Vi tog en typisk stack för webbtjänster: kärna på Node.js + Express, lade till Bootstrap och för de fina diagrammen – D3.js. Och våra förväntningar uppfylldes helt – vi fick den första prototypen på 2 veckor:
- egen parser för planen
Det vill säga att vi nu kan bryta ner vilken som helst av de planer som genereras av PostgreSQL. - korrekt analys av dynamiska noder – CTE Scan, InitPlan, SubPlan
- analys av bufferdistribution – var datorsidorna läses från minnet, var de läses från lokal cache, var de läses från disk
- vi fick överskådlighet
För att inte behöva "gräva" i loggarna, utan se det "svagaste länken" direkt på bilden.
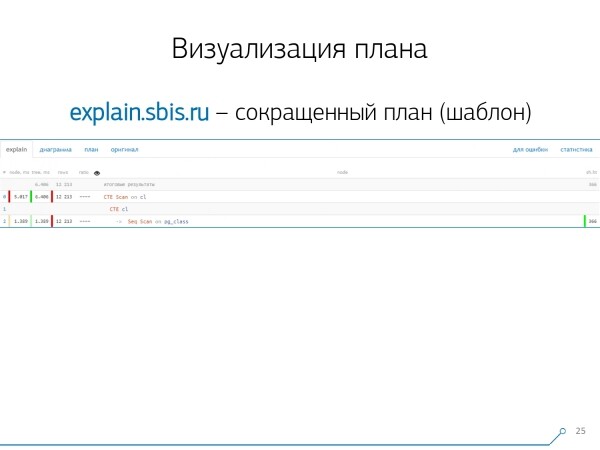
Vi fick ungefär en sådan bild – direkt med syntaktisk markering. Men vanligtvis arbetar våra utvecklare inte med hela planen, utan med en kortare version. Vi har redan parsat alla siffror och kastat dem åt sidan, och kvar mitt i har vi bara den första raden som beskriver noden: CTE Scan, CTE-generering eller Seq Scan från någon tabell.
Den här förkortade presentationen kallar vi mall för planen.
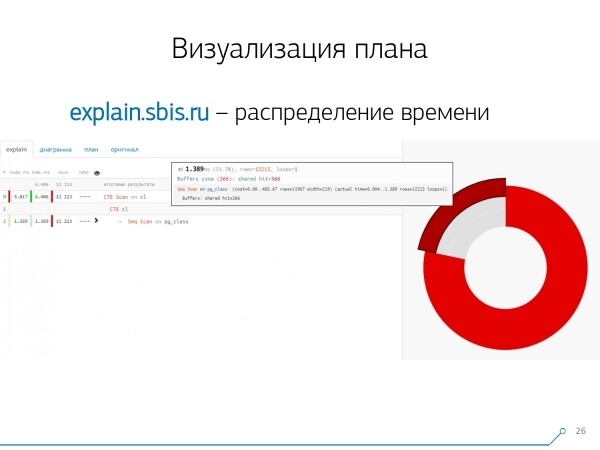
Vad skulle ytterligare vara bra? Det skulle vara bra att se vilken andel av den totala tiden som fördelas på varje nod – och helt enkelt "klistra" det på sidan tårtdiagram.
Vi hovrar över noden och ser – det visar sig att Seq Scan tog mindre än en fjärdedel av all tid, medan de återstående 3/4 utgjordes av CTE Scan. Ousch! Detta lilla påpekande handlar om "hastigheten" hos CTE Scan, om du använder dem aktivt i dina förfrågningar. De är inte särskilt snabba - de förlorar till och med mot vanlig tabellskanning.
Men vanligtvis är sådana diagram mer intressanta och mer komplexa, när vi hoverar över segmentet, och ser till exempel att mer än hälften av all tid "åt" en viss Seq Scan. Dessutom fanns det ett Filter där inne, mängder av poster kastades bort… Den här bilden kan man helt enkelt ge till utvecklaren och säga: "Vanya, du har verkligen problem här! Ta reda på vad som är fel!"
Självklart kom vi inte undan "fallgropar".
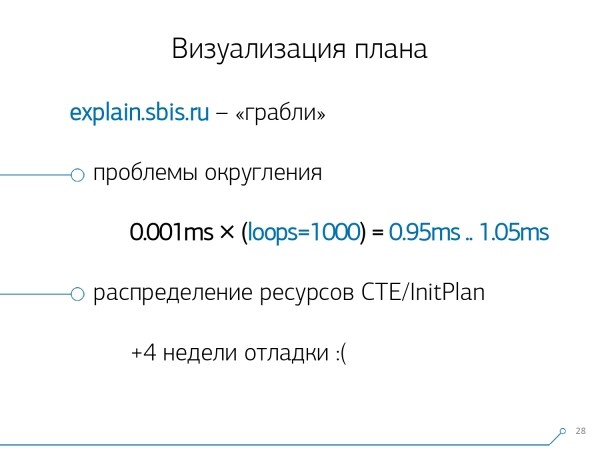
Det första vi stötte på var avrundningsproblemet. Tiden för varje nod i planen anges med noggrannhet upp till 1μs. När antalet cykler för noden överskrider, till exempel, 1000 — efter att PostgreSQL har delat "med noggrannhet upp till", får vi en total tid "någonstans mellan 0,95 ms och 1,05 ms". När det handlar om mikrosekunder är det okej, men när vi kommer upp i [millisekunder] måste vi beakta den informationen när vi "avvecklar" resurserna per nod i planen "vem som använde vad".
Den andra punkten, som är mer komplex, är fördelningen av resurser (de där buffrarna) över dynamiska noder. Detta kostade oss ytterligare 4 veckor under de första 2 veckorna med prototypen.
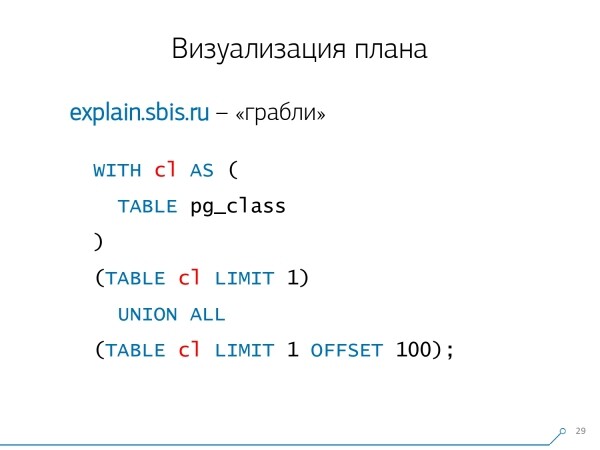
Det är ganska enkelt att få sådana problem — vi skapar en CTE och läser på något sätt från den. I verkligheten är PostgreSQL "smart" och kommer inte att läsa något direkt där. Sedan tar vi den första posten från den och går tillbaka till den hundra första från samma CTE.
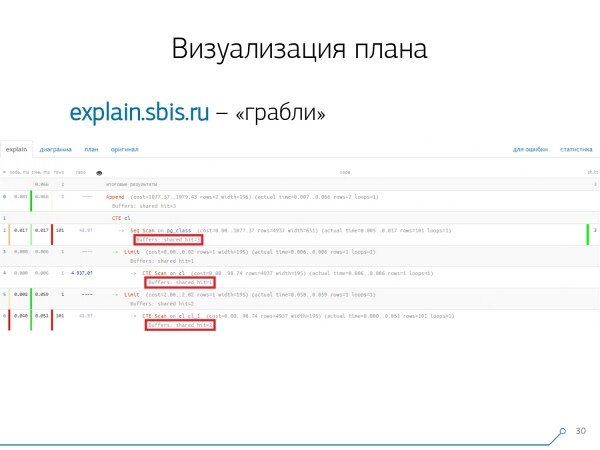
Vi tittar på planen och inser — konstigt, vi hade 3 buffrar (datablock) som "användes" i Seq Scan, ytterligare 1 i CTE Scan, och 2 till i den andra CTE Scan. Så om vi bara summerar får vi 6, men från tabellen läste vi bara 3! CTE Scan läser ju ingenting, utan arbetar direkt med processens minne. Så här är det uppenbart någonting som inte stämmer!
I själva verket visar det sig att de 3 datablock som begärdes från Seq Scan först bad 1:a CTE Scan, och sedan 2:a, och han fick ytterligare 2. Så totalt lästes 3 datablock, inte 6.
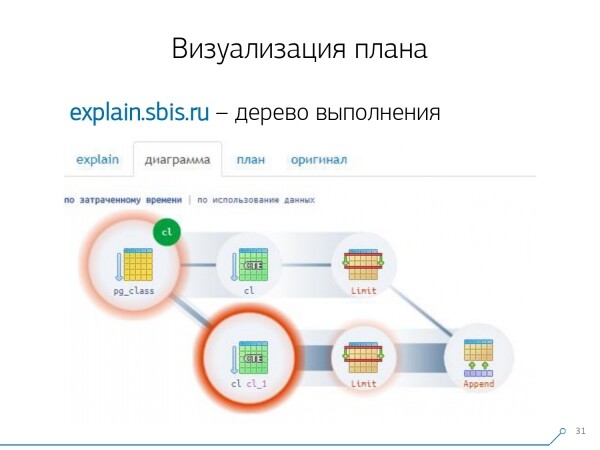
Och den bilden ledde oss till förståelsen av att exekveringen av planen inte längre är ett träd, utan helt enkelt en akyklisk graf. Och vi fick en sådan schematisk bild för att förstå "vad som kom från var". Här skapade vi en CTE från pg_class och bad om den två gånger, och nästan all vår tid gick åt till att fråga den en andra gång. Det är uppenbart att det är mycket dyrare att läsa den hundra första posten än den första från tabellen.

Vi andades ut ett tag. Vi sa: "Nu, Neo, du vet kung fu! Nu finns vår erfarenhet direkt på din skärm. Nu kan du använda den."
Konsolidering av loggar
Våra 1000 utvecklare andades lättat ut. Men vi förstod att vi bara hade hundratals "aktiva" servrar, och all denna "copy-paste" från utvecklarna var verkligen inte praktiskt. Vi insåg att vi var tvungna att samla detta själva.
Det finns faktiskt en standardmodul som kan samla statistik, men den behöver också aktiveras i konfigurationen — det är . Men den passade inte för oss.
För det första tilldelar den olika QueryId för samma förfrågningar på olika scheman inom samma databas. olika QueryId. Det betyder att om man först gör SET search_path = '01'; SELECT * FROM user LIMIT 1;, och sedan SET search_path = '02'; och en liknande förfrågan, så kommer det att finnas olika poster i statistiken för denna modul, och jag kan inte samla sammanlagd statistik just för den här förfrågningsprofilen, utan att ta hänsyn till scheman.
Den andra punkten som hindrade oss från att använda den är bristen på planer. Alltså finns det ingen plan — bara själva förfrågan. Vi ser vad som orsakade bromsen, men förstår inte varför. Och här kommer vi tillbaka till problemet med en snabbt förändrad datasets.
Och den sista punkten — bristen på "fakta". Det går alltså inte att adressera en specifik instans av en förfrågan — den finns inte, endast aggregerad statistik. Med det kan man även arbeta, men det är mycket svårt.
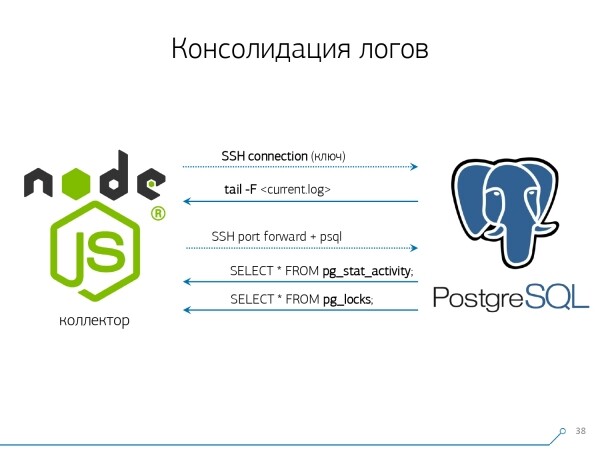
Därför bestämde vi oss för att kämpa emot "copy-paste" och började skriva en kollektortjänst..
Kollektorn ansluter via SSH, "upprättar" en säker förbindelse till servern med databasen med hjälp av ett certifikat och tail -F "ansluter" sig till loggfilen. På så sätt får vi en fullständig "spegel" av hela loggfilen , som servern genererar. Belastningen på servern är minimal eftersom vi inte parserar något där, utan bara speglar trafiken.Eftersom vi redan började skriva ett gränssnitt i Node.js, fortsatte vi att skriva kollektorn på samma plattform. Och den här teknologin har visat sig vara effektiv, eftersom det är mycket praktiskt att använda JavaScript för att arbeta med svagt formaterade textdata, som loggar. Själv infrastrukturen i Node.js som backend-plattform gör det enkelt och smidigt att arbeta med nätverksanslutningar och generellt med datastreams.
Eftersom vi redan har börjat skriva gränssnittet på Node.js, fortsatte vi även att skriva samlaren på den. Och denna teknologi har visat sig vara effektiv, eftersom det är mycket bekvämt att arbeta med svagt strukturerade textdata, som loggar, med JavaScript. Själva infrastrukturen Node.js som backend-plattform gör det enkelt och smidigt att hantera nätverksanslutningar och överhuvudtaget med olika datastreams.
Därför "drar" vi två anslutningar: en för att "lyssna" på själva loggen och hämta den, och en annan för att regelbundet fråga databasen. "Det kom ett meddelande i loggen att tabellen med oid 123 är blockerat", men för utvecklaren säger detta ingenting, och det skulle vara bra att fråga databasen "Vad innebär egentligen OID = 123?" Så vi frågar regelbundet databasen om sådant vi fortfarande inte känner till.
"Det finns en sak du inte beaktade, det finns en typ av elefantliknande bin!" Vi började utveckla detta system när vi ville övervaka 10 servrar. De mest kritiska enligt vår uppfattning, där problem uppstod som var svåra att hantera. Men under det första kvartalet fick vi övervaka hundra — för systemet "funkade", alla ville ha det, alla tyckte det var praktiskt.
Allt detta behöver samlas, datamängden är stor och aktiv. Egentligen monitorerar vi det vi kan hantera — det är vad vi använder. Vi använder också PostgreSQL som datalager. Det finns inget snabbare sätt att "fyll i" data till det än operatören COPY det finns inte än.
Men bara att "fyll i" data är inte riktigt vår teknik. För om du har hundra servrar som hanterar ungefär 50k förfrågningar per sekund, genererar det 100-150GB loggar per dag. Därför var vi tvungna att noggrant "bearbeta" databasen.
För det första gjorde vi partitionering per dag, för i stort sett är ingen intresserad av korrelationen mellan dagarna. Vad spelar det för roll vad du hade igår om du på natten släppte en ny version av applikationen — och det finns redan ny statistik.
För det andra lärde vi oss (vi var tvungna) att skriva mycket, mycket snabbt med hjälp av COPY. Så det handlar inte bara om COPY, för det är snabbare än INSÄTT, utan ännu snabbare.
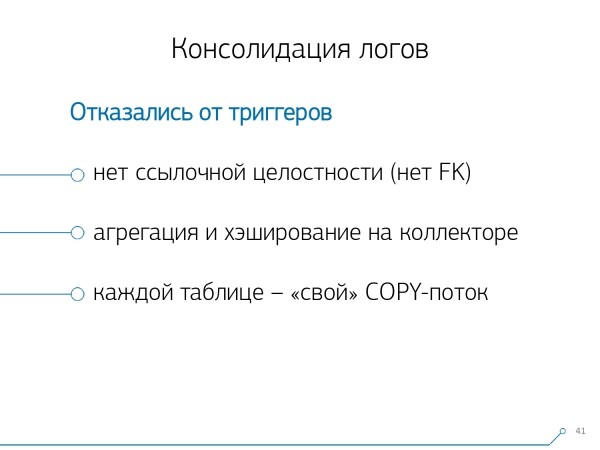
Tredje punkten — vi blev tvungna att avstå från triggers och därmed från Foreign Keys. Så vi har ingen referensintegritet alls. För om du har en tabell med ett par FK, och du säger i databasstrukturen att "den här posten i loggen refererar via FK, till exempel till en grupp poster", så har PostgreSQL inget annat kvar än att ärligt utföra SELECT 1 FROM master_fk1_table WHERE ... med det identifierare som du försöker infoga — bara för att kontrollera att den posten finns där, så att du inte "bryter" denna Foreign Key med din insättning.
Vi får istället för en post i mål-tabellen och dess index, dessutom läsningar från alla tabeller den refererar till. Det behöver vi inte alls – vår uppgift är att skriva så mycket som möjligt och så snabbt som möjligt med minsta möjliga belastning. Så bort med FK!
Nästa punkt – aggregering och hashning. Ursprungligen hade vi det implementerat i databasen – det är ju praktiskt när en post kommer in att direkt göra det i någon tabell. «plus ett» direkt i triggarna. Bra, praktiskt, men dåligt av samma anledning – du lägger in en post och tvingas läsa och skriva något från en annan tabell. Dessutom, inte bara läsa och skriva – du måste göra det varje gång.
Och tänk nu er att ni har en tabell där ni helt enkelt räknar antalet förfrågningar som passerat en specifik värd: +1, +1, +1, ..., +1. Men det behöver ni i princip inte – allt detta kan summeras i minnet på samlaren och skickas till databasen på en gång. +10.
Ja, om det skulle uppstå något problem kan er logiska integritet "kollapsa", men det är nästan ett omöjligt scenario – för ni har en fungerande server, med ett batteri i kontrollern, en transaktionslogg, en logg på filsystemet… Generellt, det är inte värt det. Den prestandaförlust ni får som följd av att använda triggar/FK, de kostnader ni ådrar er, är inte värt det.
Detsamma gäller hashning. En förfrågan kommer till er, ni beräknar ett identifierare i databasen, skriver till databasen och säger sedan det till alla. Allt är bra, så länge ingen annan mer vill skriva samma sak precis i det ögonblicket – och då får ni en blockering, vilket är dåligt. Så om ni kan flytta genereringen av vissa ID:n till klienten (relativt databasen), gör hellre det.
Det passade oss perfekt att använda MD5 av texten – förfrågan, planen, mallen,… Vi beräknar den på samlarens sida och skriver redan det färdiga ID:t till databasen. Längden på MD5 och daglig partitionering gör att vi inte behöver oroa oss för möjliga kollisioner.
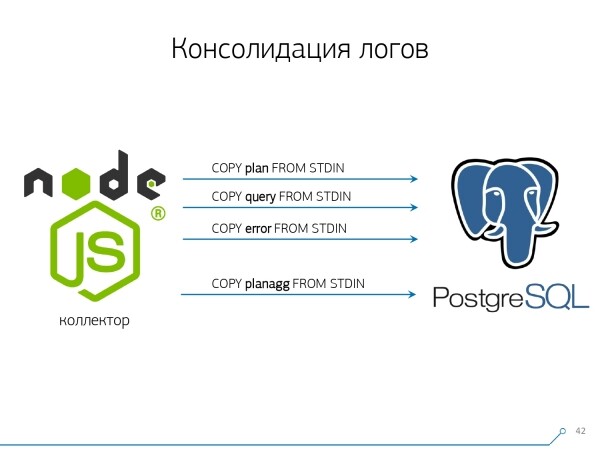
Men för att skriva allt detta snabbt behövde vi modifiera själva skrivproceduren.
Hur skriver man vanligtvis data? Vi har en dataset, som vi delar upp i flera tabeller, och sedan gör vi COPY – först till den första, sedan den andra, den tredje… Det är omständligt, eftersom vi tycks skriva en datastream i tre steg i följd. Inte så bra. Kan vi göra det snabbare? Ja!
För att göra det räcker det att dela upp dessa strömmar parallellt med varandra. Det innebär att vi har fel, förfrågningar, mallar, lås… som flyger i separata strömmar, och vi skriver allt parallellt. För detta behöver vi bara ha en COPY-kanal öppet hela tiden för varje separat mål-tabell..
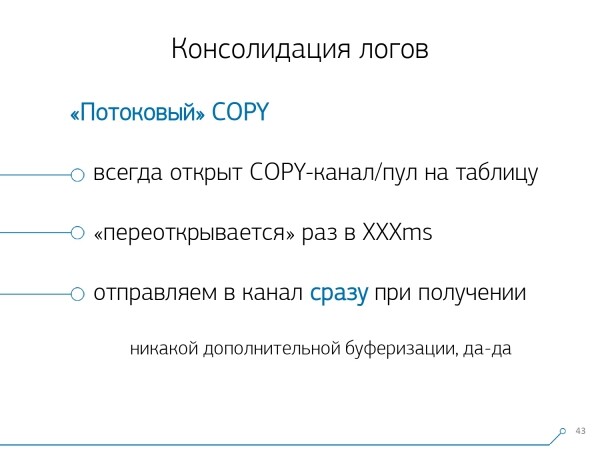
Det betyder att insamlaren alltid har en ström, dit jag kan skriva de nödvändiga data. Men för att databasen ska kunna se dessa data, och för att ingen ska fastna i lås, och vänta på att data ska skrivas, måste COPY avbrytas med viss periodicitet. För oss visade sig en period på cirka 100 ms vara den mest effektiva – vi stänger och öppnar direkt igen på samma tabell. Och om vi inte har tillräckligt med strömmar under vissa toppar, då gör vi polling upp till en viss gräns.
Dessutom har vi kommit fram till att för en sådan belastningsprofil är varje aggregation, när poster samlas i paket – ett ont. Klassisk ondska är INSERT ... VALUES och vidare 1000 poster. För i det ögonblicket uppstår en skrivtopp på lagringsmediet, och alla andra som försöker skriva till disken kommer att vänta.
För att bli av med sådana anomalier, aggregera ingenting, använd ingen buffring alls. Och om buffring till disk ändå uppstår (lyckligtvis tillåter Stream API i Node.js oss att ta reda på detta) – skjuta upp den anslutningen. När händelsen kommer att den är fri igen – skriv då från den ackumulerade kön. Och så länge den är upptagen – ta nästa tillgängliga från poolen och skriv till den.
Innan vi implementerade detta sätt att skriva data hade vi cirka 4K write ops, och på detta sätt minskade vi belastningen med 4 gånger. Nu har vi ökat ytterligare 6 gånger tack vare nya observerade databaser – upp till 100MB/s. Och nu sparar vi loggar för de senaste 3 månaderna i en volym av cirka 10-15TB, i hopp om att en utvecklare kan lösa något problem under tre månader.
Vi förstår problemen
Men att bara samla alla dessa data är bra, användbart och relevant, men otillräckligt - de måste förstås. För det handlar om miljontals olika planer per dag.
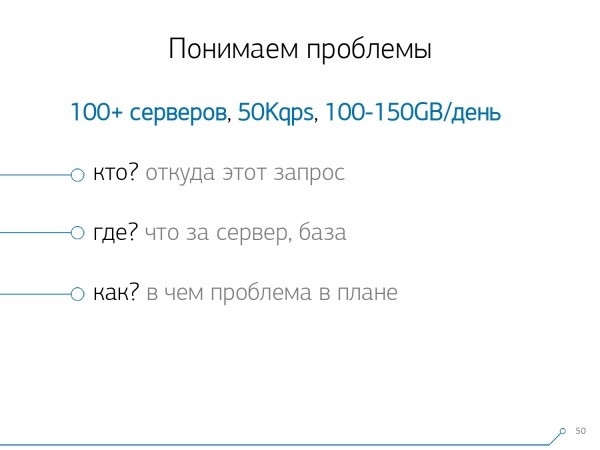
Men miljontals är okontrollerat, man måste först göra "mindre". Och främst måste man avgöra hur detta "mindre" ska organiseras.
Vi har identifierat tre nyckelpunkter:
- vem skickade denna begäran
Det vill säga från vilken applikation den "kommit": webgränssnitt, backend, betalningssystem eller något annat. - w det inträffade
På vilken specifik server. För om du har flera servrar för en applikation, och plötsligt en "hackar" (för att "disken har kraschat", "minnet läcker", någon annan olycka), måste man konkret adressera sig till servern. - som problemet faktiskt uppträdde i den eller den planen
För att förstå "vem" som skickade oss begäran, använder vi ett standardverktyg - att ställa in en sessionsvariabel: SET application_name = '{bl-host}:{bl-method}'; — vi registrerar namnet på värden av affärslogik, från vilket begäran kommer, och namnet på metoden eller applikationen som initierade den.
Efter att vi har överfört "värdena" av begäran, måste de loggas - för detta konfigurerar vi variabeln log_line_prefix = ' %m [%p:%v] [%d] %r %a'. Den som är intresserad kan , vad allt detta betyder. Så vi ser i loggen:
- tid
- process- och transaktionsidentifierare
- databasnamn
- IP för den som skickade denna begäran
- och metodnamn
Vidare insåg vi att det inte är särskilt intressant att se korrelationen från en begäran mellan olika servrar. Det är sällan en situation där en applikation misslyckas på exakt samma sätt här och där. Men även om det är likadant - titta på någon av dessa servrar.
Så det skärningen "en server - en dag" visade sig vara tillräcklig för varje analys.
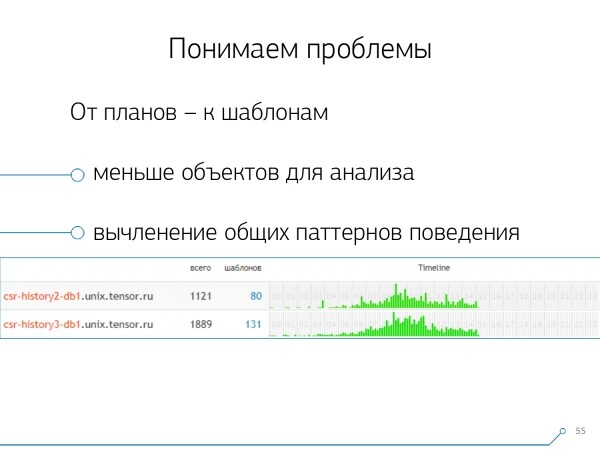
Det första analytiska snittet - är just den "mall" – en förkortad form av att presentera planen, rensad från alla numeriska indikatorer. Den andra skärningen - applikationen eller metoden, och den tredje - är den specifika noden av planen som orsakade oss problem.
När vi gick från specifika instanser till mallar, fick vi genast två fördelar:
- en betydande minskning av antalet objekt för analys
Behövs inte analysera problem utifrån tusentals begärningar eller planer, utan från tiotals mallar. - tidslinje
Så, genom att sammanfatta "fakta" inom ett visst perspektiv kan man visa deras förekomst under dagen. Här kan du förstå att om ett visst mönster inträffar, till exempel en gång i timmen när det borde vara en gång per dag, så bör du fundera på vad som har gått fel — vem som har anropat det och varför, kanske det inte ens ska finnas här. Detta är ytterligare ett icke-numeriskt, rent visuellt sätt att analysera.
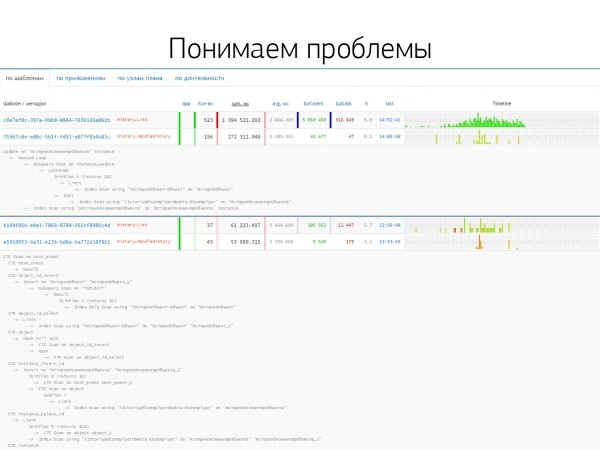
De andra sätten baseras på de indikatorer som vi extraherar från planen: hur många gånger ett visst mönster har inträffat, den totala och genomsnittliga tiden, hur mycket data som har lästs från disken, och hur mycket från minnet...
För när du till exempel går till sidan för analys av värden, ser du — någonting har börjat läsa för mycket från disken. Disken på servern klarar inte av det — men vem läser från den?
Och du kan sortera efter vilken kolumn som helst och bestämma vad du direkt ska agera på — belastningen på CPU:n eller disken, eller det totala antalet förfrågningar... Sorterat, tittat på "topparna", fixat — rullat ut en ny version av applikationen.
Och plötsligt kan du se olika applikationer som använder samma mönster från en förfrågan av typen SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, processering... Och du börjar fundera på varför processeringen skulle läsa användaren om den inte interagerar med den.
Den omvända metoden — direkt se vad applikationen gör. Till exempel, frontend — det här, det här, och det här, och dessutom det här en gång i timmen (som tidslinjen hjälper till med). Och plötsligt uppstår frågan — det verkar ju inte vara frontens roll att göra något en gång i timmen...
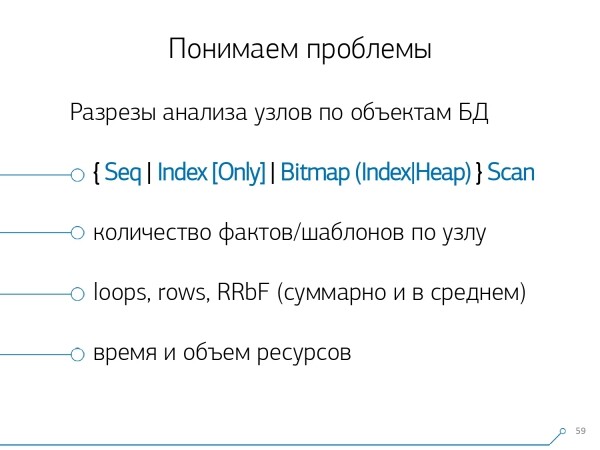
Efter en tid insåg vi att vi saknade aggregerad statistik ur perspektivet av planeknoden. Vi isolerade endast de noder från planerna som gör något med data i själva tabellerna (läser/skriver dem baserat på index eller inte). I princip läggs endast ett aspekt till den tidigare bilden — hur många poster denna nod har gett oss, och hur många den har avvisat (Rows Removed by Filter).
Du har inget lämpligt index på tabellen, du gör en förfrågan till den, den flyger förbi indexet, faller ner i Seq Scan... du filtrerar bort alla poster utom en. Varför skulle du ha 100 miljoner filtrerade poster på ett dygn, är det inte bättre att skapa ett index?
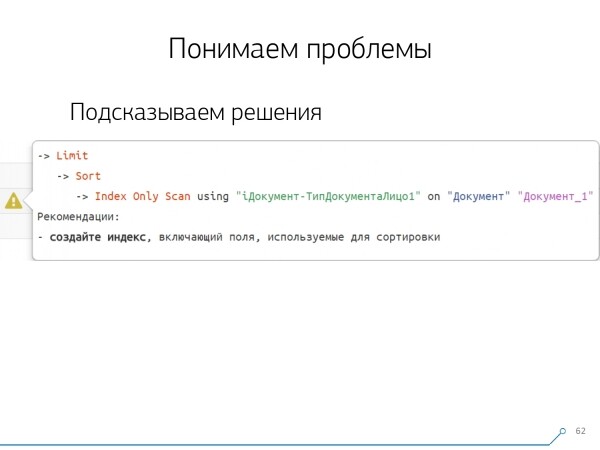
Genom att analysera alla planer för noder, insåg vi att det finns vissa typiska strukturer i planerna som med stor sannolikhet verkar misstänksamma. Det skulle vara bra om utvecklaren fick en uppmaning: "Kompis, här börjar du med att läsa via indexet, sedan sorterar du, och till sist beskär du" – som regel finns det bara en post där.
Alla som har gjort förfrågningar med ett sådant mönster har säkerligen stött på följande: "Ge mig den senaste beställningen från Vasa, datumet." Och om du inte har ett index på datumet, eller i det använda indexet inte finns något datum, så kommer du att snubbla just på sådana "attraplattor."
Men vi vet ju att det är "attraplattor" — så varför inte direkt ge utvecklaren en hint om vad han bör göra? Därför, när vår utvecklare nu öppnar planen, ser han direkt en vacker bild med tips där han får veta: "Du har problem här och här, och de kan lösas så här och så här."
Som ett resultat har mängden erfarenhet som var nödvändig för att lösa problem i början och nu minskat avsevärt. Så här har vi fått fram ett sådant verktyg.
Källa: habr.com
