

Hej.
Jag ville dela med mig av min upptäckte — resultatet av reflektioner, prövningar och misstag.
I stora drag: det här är förstås ingen upptäckte, allt detta borde vara välkänt för dem som arbetar med tillämpad dataanalys och optimering av system, inte nödvändigtvis bara databashanteringssystem.
Och: ja, det finns de som vet, som skriver intressanta artiklar om sina forskningar, (UPD.: i kommentarerna nämnde de ett mycket intressant projekt: )
Å andra sidan: jag kan inte spontant se en bred användning eller spridning av detta tillvägagångssätt på nätet bland IT-specialister and DBA:er.
Så, till saken.
Låt oss anta att vi har följande uppgift: ställa in ett viss tjänstesystem för att hantera ett specifikt arbete.
Om detta arbete är känt: hur det är, hur kvaliteten på detta arbete mäts och vilket kriterium som används för att mäta denna kvalitet.
Låt oss också anta att det mer eller mindre är klart hur arbetet genomförs i (eller med) detta tjänstesystem.
"Mer eller mindre" betyder att det finns möjlighet att förbereda (eller hämta) ett verktyg, en nytta, en tjänst som kan syntetisera och ge systemet en testbelastning som är tillräckligt lik den som kommer i produktion, under förhållanden som är rimliga för arbete i produktion.
Och antag att uppsättningen av justerbara parametrar för detta tjänstesystem är kända, som kan ställa in systemet med avseende på dess produktivitet.
Och vad är problemet — det finns inte tillräcklig fullständig förståelse för detta tjänstesystem, så mycket att man kan expertstärka inställningarna för detta system, för den framtida belastningen, på denna plattform och få den nödvändiga produktiviteten.
Nåväl. Sånt händer nästan alltid.
Vad kan göras här.
Det första som kommer i åtanke: kolla dokumentationen för detta system. Förstå — vilka är de tillåtna intervallen för värdena på de justerbara parametrarna. Och, till exempel, med hjälp av metoden med koordinatsänkning, finjustera värdena för systemets parametrar i tester.
Det vill säga, ge systemet en viss konfiguration, i form av ett specifikt värdeset för dess inställningsparametrar.
Tillhandahålla en testbelastning med detta verktyg, utility, lastgenerator.
Och se på storleken — svarstiden, eller något mått på kvaliteten på systemets arbete.
En annan tanke kan vara slutsatsen att — detta tar väldigt lång tid.
Det vill säga: om det finns många inställningsparametrar, om de värden de kan anta är stora, om varje enskild belastningstest pågår under lång tid, då: ja, allt det här kan ta oacceptabelt lång tid.
Och här kan man förstå och minnas vad som helst.
Man kan få reda på i uppsättningen av inställningsparametrar för tjänstesystemet — en vektor, som en sekvens av vissa värden.
Varje sådan vektor, under lika förutsättningar (under förutsättning att denna vektor inte påverkas), motsvarar ett ganska specifikt värde av en metrik — kvalitetsmått för systemets arbete under testbelastning.
Det vill säga.
Låt oss beteckna vektorn av systemkonfigurationen som  , där
 ; där
 — antalet konfigurationsparametrar för systemet, hur många av dessa parameter finns det.
Och värdet av metrik som motsvarar denna  betecknar vi som
 , så får vi en funktion:

Och då: allt reduceras omedelbart till, i mitt fall: nästan bortglömda från studietiden, algoritmer för att söka extremalpunkter för en funktion.
Bra, men här uppstår en organisatorisk tillämpningsfråga: vilken specifik algoritm ska man använda.
- Med andra ord — för att man själv ska behöva koda så lite som möjligt.
- Och att det ska fungera, det vill säga hitta extremvärdet (om det finns), åtminstone — snabbare än koordinatnedstigning.
Den första punkten antyder att man bör titta på någon typ av miljö där sådana algoritmer redan är implementerade, och finns i något format, redo att användas i koden.
Nåväl, jag känner till python och cran-r
Den andra punkten innebär att man behöver läsa om själva algoritmerna, vilka som finns, vilka krav har de, vilka egenskaper har de i arbetet.
Och vad de ger, eventuella användbara sidoeffekter-resultat, direkt från själva algoritmen.
Eller så kan de erhållas från resultaten av algoritmens arbete.
Här beror mycket på ingångsvillkoren.
Till exempel, om man av någon anledning behöver få resultatet snabbare, så bör man titta på algoritmer för gradientnedstigning, välja någon av dem.
Eller, om tiden inte är så viktig, kan man till exempel använda metoder för stokastisk optimering, som genetiska algoritmer.
Jag föreslår att vi överväger att arbeta med en sådan metod för att anpassa systemkonfigurationen, med hjälp av en genetisk algoritm, på nästa, så att säga: laboratoriearbete.
Utgångspunkter:
- Låt oss ha som en serviceplattform:
oracle xe 18c - Låt oss säga att den hanterar transaktionsaktiviteten och målet: att uppnå en så hög genomströmningskapacitet av databashanteraren som möjligt, i transaktioner/sek.
- Transaktioner kan vara mycket olika, beroende på hur de arbetar med data och kontexten i arbetet.
Vi förutsätter att detta är transaktioner som inte bearbetar stora mängder tabulär data.
I den meningen att de inte genererar mer undo-data än redo och inte bearbetar stora procentandelar av rader i stora tabeller.
Det är transaktioner som ändrar en rad i en mer eller mindre stor tabell, med ett litet antal index över denna tabell.
I ett sådant scenario kommer databashanterarens produktivitet för bearbetning av transaktioner, med förbehåll, att bestämmas av kvaliteten på behandlingen av redo-data.
Förbehållet – om vi pratar specifikt om inställningarna för databashanteraren.
För i allmänhet kan det finnas, till exempel, transaktionslåsningar mellan SQL-sessioner, på grund av designen av användarens arbete med tabulär data och/eller tabellmodellen.
Som självklart skulle påverka tps-metriken negativt, och detta skulle vara en exogen, i förhållande till databashanteraren, faktor: så här designades tabellmodellen och arbetet med data att det uppstår låsningar.
Därför, för experimentets renhet, kommer vi att utesluta den faktorn, jag kommer senare att förtydliga hur exakt.
- Låt oss anta, för tydlighetens skull, att 100% av de SQL-kommandon som ges till databashanteraren: är DML-kommandon.
Låt oss säga att karakteristika för användarens arbete med databashanteraren: är desamma i testerna.
Det handlar om: antalet SQL-sessioner, tabulär data, hur SQL-sessionerna interagerar med dessa. - Databashanteraren arbetar i
FORCE LOGGING,ARCHIVELOGlägen. Flashback-databasen är avstängd, på databashanterarnivå. - Redo-loggar: är belägna i ett separat filsystem, på en separat "disk";
Hela den övriga delen av den fysiska komponenten av databas: är i ett annat, separat FS, på en separat "disk":
Mer om konstruktionen av den fysiska komponenten av den laboratoriebaserade databasen
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "\/db\/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Inledningsvis ville jag använda en databas för transaktionerna under dessa belastningsförhållanden
Den har en fantastisk egenskap som jag vill citera författaren:
Kärnan i SLOB är "SLOB-metoden". SLOB-metoden syftar till att testa plattformar
utan applikationskonkurrens. Man kan inte nå maximal hårdvaruprestanda
med applikationskod som till exempel är begränsad av applikationslåsning eller ens
delning av Oracle-databasblock. Det stämmer—det finns overhead vid delning av data
i datablok! Men SLOB—i sin standardinstallation—är immun mot sådan konkurrens.
Denna deklaration: är det som det är.
Det är praktiskt att justera graden av parallellism för SLOB-sessioner, detta är nyckeln -t att starta verktyget runit.sh från SLOB-satsen
Den reglerar procentandelen DML-kommandon i det antal SQL-frågor som varje SQL-session skickar till databasen, parametern UPDATE_PCT
Separat och mycket praktiskt: SLOB själv, före och efter belastningssessionen—förbereder statspaket eller AWR-snapshots (vad som har beordrats att förberedas).
Det visade sig dock att SLOB inte stödjer SQL-sessioner som varar mindre än 30 sekunder.
Därför skrev jag först min egen, arbetarklassversion av belastaren, och sedan blev det kvar i användning.
Låt mig förtydliga belastaren—vad den gör och hur, för tydlighetens skull.
I grund och botten ser belastaren ut så här:
Arbetarkod
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotracе/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT ((SYSDATE - DATE '1970-01-01') * 86400) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT ((SYSDATE - DATE '1970-01-01') * 86400) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Arbetare startas på följande sätt:
Starta arbetarna
echo "startar test, varaktighet: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "väntar..." >> "$v_logfile"
wait
Och tabellerna för arbetarna förbereds så här:
Skapande av tabeller
function createtable() {
source "/home/oracle/testingredotrace/config.conf"
$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
/

create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
Det vill säga, för varje arbetare (praktiskt taget: en separat SQL-session i databasen) skapas en separat tabell, som arbetaren arbetar med.
Detta uppnår avsaknaden av transaktionslåsningar mellan SQL-sessionerna för arbetarna.
Varje arbetare gör samma sak med sin tabell, tabellerna är alla desamma.
Arbetarna utför alla sitt arbete under samma mängd tid.
Och tillräckligt lång tid för att till exempel klart ha skett, och inte en gång logg-switching.
Och motsvarande kostnader och effekter uppstod.
I mitt fall har jag konfigurerat arbetarnas varaktighet till 8 minuter.
Ett stycke från ett statspak-rapporter, som beskriver databassystemets arbete under belastning.
Databas    DB Id    Instans     Inst Num  Starttid   Release     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 07-Sep-20 23:12 18.0.0.0.0  NEJ

Värdnamn             Plattform                CPU: Cores Sockets   Minne (G)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64-bit           2     2       1         15.6

Snapshot       Snap Id     Snap Tid      Sessioner Curs/Sess Kommentar
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Börja Snapshot:       1630 07-Sep-20 23:12:27       55        .7
  Sluta Snapshot:       1631 07-Sep-20 23:20:29       62        .6
   Förlopp:       8.03 (min) Genomsnittlig Aktiv Session:       8.4
   DB tid:      67.31 (min)      DB CPU:      15.01 (min)

Cache-storlekar            Börja        Sluta
~~~~~~~~~~~       ---------- ----------
    Buffert Cache:     1,392M              Std Blockstorlek:         8K
     Delad Pool:       288M                  Logg Buffert:   103,424K

Lastprofil              Per Sekund    Per Transaktion    Per Utförande    Per Anrop
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      DB tid(s):                8.4                0.0        0.00        0.20
       DB CPU(s):                1.9                0.0        0.00        0.04
       Redo-storlek:        7,685,765.6              978.4
   Logiska läsningar:           60,447.0                7.7
   Blockändringar:           47,167.3                6.0
  Fysiska läsningar:                8.3                0.0
 Fysiska skrivningar:              253.4                0.0
      Användar-anrop:               42.6                0.0
          Parser:               23.2                0.0
     Hårda parser:                1.2                0.0
W/A MB bearbetat:                1.0                0.0
          Inloggningar:                0.5                0.0
        Utförningar:           15,756.5                2.0
       Återställningar:                0.0                0.0
    Transaktioner:            7,855.1
Återkommande till uppdraget för laborationen.
Vi kommer, under lika förutsättningar, att variera värdena för sådana parametrar i den laborativa databasen:
- Storlek på databasens loggrupper. värdeintervall: [32, 1024] MB;
- Antal loggrupper i databasen. värdeintervall: [2,32];
log_archive_max_processesvärdeintervall: [1,8];commit_loggingtvå värden tillåts:batch|immediate;commit_waittvå värden tillåts:wait|nowait;log_buffervärdeintervall: [2,128] MB.log_checkpoint_timeoutvärdeintervall: [60,1200] sekunderdb_writer_processesvärdeintervall: [1,4]undo_retentionvärdeintervall: [30;300] sekundertransactions_per_rollback_segmentvärdeintervall: [1,8]disk_asynch_iotvå värden tillåts:true|false;filesystemio_optionstillåtna värden är:none|setall|directIO|asynch;db_block_checkingtillåtna värden är:OFF|LOW|MEDIUM|FULL;db_block_checksumtillåtna värden är:OFF|TYPICAL|FULL;
En person med erfarenhet av att underhålla oracle-databaser kan utan tvekan nu säga — vad och vilka värden som behöver ställas in, av de angivna parametrarna och deras tillåtna värden, för att uppnå större produktivitet av databasen, för det databehandling som anges, av programkoden, här, ovan.
Men.
Syftet med laborationen är att visa att optimeringsalgoritmen, i sig själv och relativt snabbt, kommer att klargöra detta för oss.
För oss kvarstår endast att kolla in dokumentationen för det konfigurerbara systemet, precis så mycket som behövs för att ta reda på: vilka parametrar och inom vilka intervall som ska ändras.
Och dessutom: koda koden som kommer att implementera arbetet med det konfigurerbara systemet av den valda optimeringsalgoritmen.
Så, nu om koden.
Jag nämnde tidigare om cran-r, dvs.: alla manipuleringar med det konfigurerbara systemet styrs i form av ett R-skript.
Egentligen är uppgiften, analysen, valet baserat på metriska värden, tillståndsvektorer av systemet: det är paketet GA ()
Paketet, i det här fallet, passar inte särskilt bra, eftersom det förväntar sig att få vektorer (kromosomer, om man använder paketets terminologi) i form av en sekvens av heltal med decimaler.
Och min vektor, bestående av värdena för inställningsparametrarna: det är 14 storheter – hela tal och strängvärden.
Problemet kan självklart enkelt hanteras genom att tilldela strängvärden specifika heltal.
Så, i slutändan ser huvuddelen av R-skriptet ut så här:
Anrop av GA::ga
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat( "GA-session is done" , file=v_logfile, sep="n", append=T)
gam@solution
Här, med hjälp av lower och upper attributen i underprogrammet ga anges egentligen området för sökrymd, inom vilket sökningen efter en sådan vektor (eller vektorer) kommer att genomföras för att uppnå maximalt värde på fitness-funktionen.
ga-underprogrammet genomför sökningen för att maximera fitness-funktionen.
Så, det verkar som att i det här fallet behöver fitness-funktionen, vilket förstår vektorn som en uppsättning av värden för bestämda parametrar i databashanteringssystemet, få metrik från databashanteringssystemet.
Det vill säga: hur många transaktioner per sekund databashanteringssystemet hanterar med den specifika konfigurationen och belastningen på databashanteringssystemet.
Det vill säga, för att klargöra, måste det inuti fitness-funktionen utföras en så kallad multi-step process:
- Bearbetning av den inmatade vektorn av tal – omvandling av den till värden för parametrarna i databashanteringssystemet.
- Försök att skapa ett angivet antal redo-grupper i angiven storlek. Notera att försöket: kan misslyckas.
De redan befintliga loggrupperna i databasen, i vilket antal och storlek som helst, måste för experimentets renhet tas bort. - Vid framgång med föregående punkt: att tilldela värdegrunden för konfigurationsparametrarna (återigen: det kan uppstå ett fel)
- Vid framgång med föregående punkt: stoppa databasen, starta databasen så att de nyligen angivna parameterstatusarna träder i kraft. (återigen: det kan uppstå ett fel)
- Vid framgång med föregående punkt: utföra belastningstestet. erhålla metrik från databasen.
- Återställa databasen till ursprungligt tillstånd, dvs ta bort ytterligare loggrupper, återföra den ursprungliga databaskonfigurationen.
Koden för fitnessfunktionen
evaluate=function(p_par) {
v_module="evaluate"
v_metric=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vector=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_module," try to evaluate vector: ", v_vector,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_module,"make_additional_rgroups failed",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metric=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
return (v_metric)
}
Så allt arbete: utförs i fitnessfunktionen.
ga-underprogrammet, utför bearbetning av vektorer, eller mer korrekt sagt — kromosomer.
Där vi framför allt är intresserade av: selektion av kromosomer med sådana gener, där fitnessfunktionen ger stora värden.
Detta är i själva verket processen att söka efter den optimala uppsättningen kromosomer i ett N-dimensionellt sökområde.
Mycket tydlig, detaljerad , med exempel på R-kod, för arbetet med genetiska algoritmer.
Jag vill särskilt framhäva två tekniska punkter.
Hjälpkallningar, från funktionen evaluate, till exempel stänga-starta, ställa in värdet av databaspärameter, utförs baserat på cran-r funktionen system2
Genom vilken: som kallar på någon bash-script, eller kommando.
Till exempel:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotracе/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," failed with: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
Den andra punkten — raden, evaluate funktionen, med bevarande av det specifika värdet av metrik och den motsvarande inställningsvektorn, i loggfilen:
cat( paste("resultat: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)Detta är viktigt, eftersom från denna datamängd kan ytterligare information erhållas om vilken av komponenterna i inställningsvektorn som har större eller mindre påverkan på metrikens värde.
Det vill säga: en analys av attributens betydelse kan genomföras.
Så, vad kan komma ut.
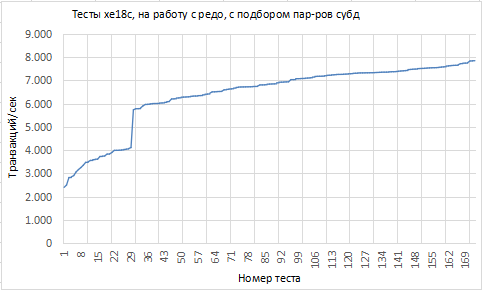
I form av ett diagram, om testerna ordnas efter stigande metrik, ser bilden ut så här:
Några data som motsvarar extrema värden på metrik:
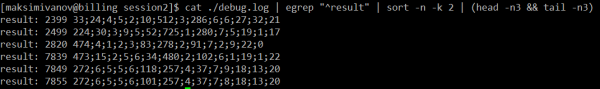
Här, på skärmdumparna med resultaten, påpekar jag: värdena på inställningsvektorn är angivna i termer av koden för fitnessfunktionen, inte i termer av nummerlistan för parametrar/värdenas intervall, som angavs tidigare i texten.
Nåväl. Är detta mycket eller lite, ~8 tusen tps: frågan är separat.
Inom ramen för laboratoriearbetet — är detta nummer, hur som helst, oviktigt, den viktiga dynamiken, hur detta värde förändras.
Dynamiken här är bra.
Det är uppenbart att, minst en faktor, som signifikant påverkar metrikens värde, ga-algoritmen, med att iterera genom vektor-kromosomer: täcker.
Baserat på en ganska livlig dynamik i kurvans värden finns det minst en faktor som, även om den är betydligt mindre, ändå påverkar.
Här behövs attribute-importance analys för att förstå vilka attribut (i det här fallet komponenter av justeringsvektorn) som påverkar värdet på metrik och hur starkt.
Och från denna information: förstå vilka faktorer som påverkades av förändringar i de betydande attributen.
Utför attribute-importance kan göras på olika sätt.
För dessa ändamål gillar jag algoritmen randomForest av samma namn R-paketet ()
randomForest, som jag förstår hur det fungerar generellt och dess metod för att bedöma attributens vikt specifikt, bygger en modell av beroende mellan svarsvariabeln och attributen.
I vårt fall är svarsvariabeln den metrik som erhålls från databaser, i belastningstester: tps;
Och attributen är komponenterna av justeringsvektorn.
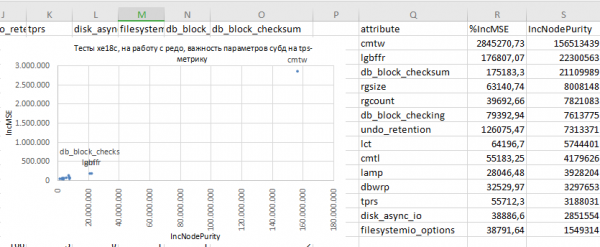
Så bedömer den randomForest vikten av varje attribut i modellen med två siffror: %IncMSE — hur närvaron/absensen av detta attribut i modellen förändrar MSE-kvaliteten för denna modell (Mean Squared Error);
Och IncNodePurity — det är ett nummer som visar hur bra det går att separera datasetet med observationer baserat på värdena av detta attribut, så att en del innehåller data med ett visst värde av den förklarade metrik, medan den andra har ett annat värde av metrik.
Alltså: hur mycket detta är ett klassificerande attribut (det mest tydliga, ryska förklaringen jag har sett om random forest) ).
Arbetar-bonde R-kod för att bearbeta datasetet med resultaten av belastningstester:
x=NULL
v_data_file=paste('\/tmp\/data1.dat',sep="")
x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE)
colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')

idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7))
idxNotTrain=which(! 1:nrow(x) %in% idxTrain )
TrainDS=x[idxTrain,]
ValidateDS=x[idxNotTrain,]

library(randomForest)
#mtry=as.integer( sqrt(dim(x)[2]-1) )
rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F)
ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response")
sum((ValidateDS$metric-ValidateDS$predicted)^2)
rf$importance
Man kan direkt justera hyperparametrarna för algoritmen och, med tanke på modellkvaliteten, välja en mer exakt modell för att göra förutsägelser på valideringsdatasetet.
Man kan skriva en funktion för detta arbete (för övrigt — återigen, med något optimeringsalgoritm).
Man kan använda R-paketet caret, det spelar ingen roll.
I slutändan får vi i det här fallet ett resultat för bedömningen av attributens betydelse:
Nåväl. Således kan vi påbörja de globala övervägandena:
- Det visar sig att det mest signifikanta, under dessa testförhållanden, var parameter
commit_wait
Tekniskt sett anger den läget för inskrivning av redo-data från loggbufferten i nuvarande journalgrupp: synkront eller asynkront.
Värdenowaitvilket ger en nästan vertikal, multiplicerad ökning av tps-metriken: det är aktiveringen av asynkron io-läge i redo-grupper.
En separat fråga är om detta bör göras i produktionsdatabasen. Här nöjer jag mig med att konstatera: det är en betydande faktor. - Det är logiskt att storleken på loggbufferten är en betydande faktor.
Ju mindre storleken på loggbufferten är, desto mindre buffertkapacitet har den, desto oftare inträffar överfyllningar och/eller kan inte utrymme avsättas för en portion nya redo-data.
Och det betyder: förseningar relaterade till allokeringen av utrymme i loggbufferten och/eller avskrivning av redo-data från den till redo-grupper.
Dessa förseningar bör självklart påverka databasens transaktionskapacitet. - Parameter
db_block_checksum: ja, det är också ganska klart - behandlingen av transaktioner leder till bildandet av dirty blocks i databasens buffertcache.
Som, med aktiverad checksum-kontroll för datablokkar, databasen måste hantera - beräkna dessa checksummer från datablokkroppen, jämföra dem med vad som är skrivet i datablokkhuvudet: stämmer/inte stämmer.
Ett sådant arbete kan i sin tur inte undvika att försena databehandlingen, och därmed framstår parametern och mekanismen som ställer in den parametern - som betydelsefulla.
Därför erbjuder leverantören i dokumentationen för denna parameter olika värden (för parametern) och påpekar att - ja, det kommer att finnas påverkan, men, här är olika värden, ända till "av" och olika påverkan, ni kan välja.
Och den övergripande slutsatsen.
Tillvägagångssättet visar sig vara fullt fungerande.
Det möjliggör helt, i de tidiga skedena av belastningstestning av ett service-system, att välja dess (systemets) optimala konfiguration för belastning utan att behöva djupt förstå systemets inställningar för belastning.
Men det utesluter inte helt - åtminstone på förståelsenivå: "justeringshandtag" och tillåtna rotationsområden för dessa handtag måste systemet känna till.
Dessutom kan tillvägagångssättet relativt snabbt hitta en optimal systemkonfiguration.
Och man kan, efter testerna, få information om förhållandet mellan kvalitetsmått på systemets arbete och värdena för systemets justeringsparametrar.
Detta bör naturligtvis bidra till att skapa en djupare förståelse för systemet och dess funktion, åtminstone under denna belastning.
Praktiskt innebär detta: kostnaden för att sätta sig in i det justerbara systemet jämfört med kostnaderna för att förbereda en sådan systemtestning.
Jag vill särskilt påpeka: i detta tillvägagångssätt är graden av adekvat systemtestning kritiskt viktig i förhållande till de driftsförhållanden som det kommer att ha i produktionsmiljö.
Tack för er uppmärksamhet och tid.
Källa: habr.com
