

Att lansera en ny version av projektet till produktion kräver noggrant avvägande mellan hastigheten på distributionen och tillförlitligheten hos lösningen. På Slack värderar man snabba iterationer, korta feedbackcykler och snabb respons på användarfrågor. Dessutom finns det hundratals programmerare i företaget som strävar efter maximal produktivitet.
Författarna till materialet, vars översättning vi publicerar idag, säger att ett företag som strävar efter att upprätthålla sådana värderingar och samtidigt växer, ständigt måste förbättra sitt system för distribution av projekt. Företaget måste investera i transparens och tillförlitlighet i arbetsprocesserna för att dessa processer ska motsvara projektets omfattning. Här handlar det om de arbetsprocesser som har utvecklats på Slack och om några lösningar som har lett företaget till att använda det befintliga systemet för distribution av projekt.
Hur distributionsprocesserna för projekt fungerar idag
Varje PR (pull request) i Slack måste obligatoriskt genomgå kodgranskning och måste framgångsrikt klara alla tester. Först efter att dessa villkor har uppfyllts kan programmeraren slå samman sin kod med master-grenen i projektet. Dock utförs distribution av sådan kod endast under arbetstid enligt nordamerikansk tid. Som en följd är vi, eftersom våra anställda är på sina arbetsplatser, helt redo för att hantera eventuella oväntade problem.
Varje dag genomför vi runt 12 planerade distributioner. Vid varje distribution är den programmerare som är utsedd som huvudansvarig för distributionen ansvarig för att lansera den nya versionen i produktion. Detta är en flertrinsprocess som säkerställer en smidig övergång av byggnaden till drift. Tack vare denna metod kan vi upptäcka fel innan de påverkar alla våra användare. Om det skulle uppstå för många fel kan distributionen av versionen återställas. Om dock ett enskilt problem upptäcks efter lanseringen kan en fix enkelt släppas för det.
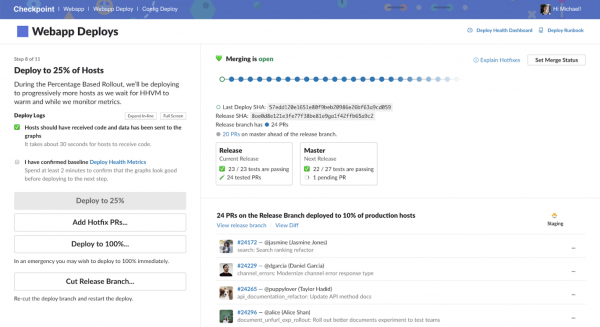
Gränssnittet för Checkpoint-systemet som används på Slack för distribution av projekt
Processen för att distribuera en ny version i produktion kan beskrivas som bestående av fyra steg.
▍1. Skapa en releasegren
Varje release börjar med en ny releasegren, som markerar en punkt i vår Git-historia. Detta möjliggör att vi kan tilldela taggar till releasen och ger en plats för att göra akuta korrigeringar för fel som upptäckts under förberedelserna för att släppa den i produktion.
▍2. Utrullning i staging-miljö
Nästa steg är att rulla ut bygget på staging-servrar och köra automatiserade tester för att kontrollera den övergripande funktionaliteten hos projektet (smoke test). Staging-miljön är en produktion-miljö där extern trafik inte når. I denna miljö utför vi ytterligare manuell testning. Detta ger oss extra trygghet i att det ändrade projektet fungerar korrekt. Endast automatiserade tester är inte tillräckliga för att uppnå samma nivå av säkerhet.
▍3. Utrullning i dogfood- och canary-miljöer
Utrullningen i produktionen börjar med dogfood-miljön, som består av en uppsättning värdar som hanterar våra interna arbetsytor i Slack. Eftersom vi är mycket aktiva användare av Slack har denna metod hjälpt oss att upptäcka många fel i ett tidigt skede av utrullningen. När vi har säkerställt att systemets grundläggande funktionalitet inte har påverkats, utför vi utrullningen av bygget i canary-miljön. Denna miljö representerar system som får ungefär 2% av produktionstrafiken.
▍4. Gradvis övergång till produktion
Om övervakningsmätningarna för den nya releasen visar sig vara stabila, och om vi inte har fått några klagomål efter att projektet rullats ut i canary-miljön, fortsätter vi den gradvisa övergången av produktionsservrarna till den nya releasen. Utrullningsprocessen är uppdelad i följande steg: 10%, 25%, 50%, 75% och 100%. Detta gör att vi långsamt kan dirigera produktionstrafiken till den nya releasen av systemet. Under tiden har vi tid att undersöka situationen ifall vi upptäcker några anomalier.
▍Vad ska man göra om något går fel under utrullningen?
Att göra ändringar i koden innebär alltid en risk. Men vi hanterar detta tack vare våra välutbildade 'deploy-chefer' som leder processen för att få ut nya versioner i produktion, övervakar övervakningsdata och koordinerar programmerarnas arbete med kodutgåvor.
Om något faktiskt går fel försöker vi upptäcka problemet så tidigt som möjligt. Vi undersöker problemet, hittar PR som orsakar fel, rullar tillbaka det, analyserar noggrant och skapar en ny byggnad. Ibland kan problemet dock förbli oupptäckt fram till projektet går i produktion. I sådana situationer är det viktigast att återupprätta tjänsten. Därför rullar vi tillbaka till den senaste fungerande byggnaden innan vi påbörjar problemet.
Byggstenarna i vårt distributionssystem
Låt oss titta på teknologierna som ligger till grund för vårt projektdistributionssystem.
▍Snabba distributioner
Arbetsprocessen som beskrivits ovan kan i efterhand verka helt självklart. Men vårt distributionssystem blev inte så direkt.
När företaget var betydligt mindre kunde hela vår applikation köras på 10 Amazon EC2-instansar. Distribution av projektet i en sådan situation innebar att använda rsync för snabb synkronisering av alla servrar. Tidigare skilde det bara ett steg, representerat av en mellanliggande miljö, den nya koden från produktion. Byggnader skapades och testades i en sådan miljö och gick sedan direkt till produktion. Det var mycket enkelt att förstå ett sådant system, det gjorde det möjligt för vilken programmerare som helst att när som helst distribuera den kod de skrivit.
Men i takt med att antalet kunder ökade, växte också omfattningen av infrastrukturen som behövdes för att stödja projektets drift. Snart, med den kontinuerliga tillväxten av systemet, slutade vår distributionsmodell, som var baserad på att skicka ny kod till servrar, att fungera. Varje ny server som lades till innebar en ökning av den tid som krävdes för distribution. Även strategier som baserades på parallella rsync-tillämpningar har sina begränsningar.
Som ett resultat beslutade vi att lösa detta problem genom att övergå till ett helt parallellt distributionssystem, som är uppbyggt på ett annat sätt än det gamla systemet. Nämligen, nu skickade vi inte koden till servrarna med hjälp av ett synkroniseringsskript. Nu laddade varje server ner den nya versionen själv, genom att ta reda på att detta behövdes genom att observera förändringen av Consul-nyckeln. Servrarna laddade ner koden parallellt. Detta gjorde att vi kunde upprätthålla en hög distributionshastighet även i en miljö med ständig systemtillväxt.
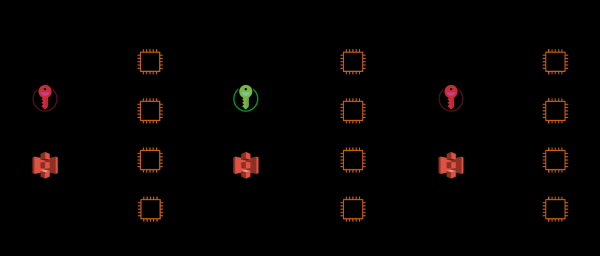
1. Produktionsservrarna övervakar Consul-nyckeln. 2. Nyckeln ändras, vilket meddelar servrarna att de ska börja ladda ner ny kod. 3. Servrarna laddar ner tarball-filer med applikationskoden.
▍Atomära distributioner
En annan lösning som hjälpte oss att nå ett flerlagers distributionssystem var atomär distribution.
Innan vi använde atomära distributioner kunde varje distribution leda till en stor mängd felmeddelanden. Det berodde på att processen med att kopiera nya filer till produktionsservrarna inte var atomär. Detta ledde till att det fanns en kort tidsperiod då koden som gav tillgång till nya funktioner var tillgänglig innan dessa funktioner själva var aktiverade. När sådan kod anropades ledde det till interna fel. Det visade sig i misslyckade API-anrop och 'trasiga' webbsidor.
Teamet som arbetade med detta problem löste det genom att införa begreppen 'heta' (hot) och 'kalla' (cold) kataloger. Koden i den 'heta' katalogen ansvarar för behandlingen av produktionstrafik. I de 'kalla' katalogerna förbereds koden under systemets drift för användning. Under distributionen kopieras den nya koden till en oanvänd 'kall' katalog. Sedan, när det inte finns några aktiva processer på servern, görs en omedelbar växling av katalogerna.
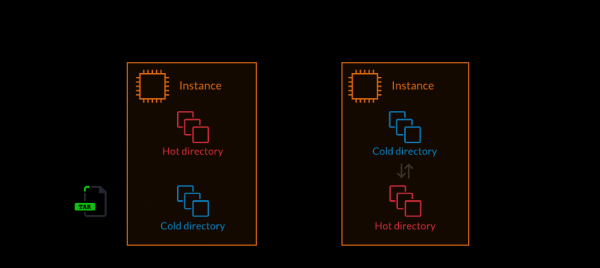
1. Packa upp applikationskoden i den 'kalla' katalogen. 2. Växla systemet till den 'kalla' katalogen, som blir 'het' (atomär operation)
Sammanfattning: Förflyttning av fokus mot tillförlitlighet
Under 2018 nådde projektet en storlek där snabb distribution började skada produktens stabilitet. Vi hade ett ganska avancerat distributionssystem, där vi nedlagt mycket tid och kraft. Vi behövde bara omorganisera och förbättra distributionsprocesserna. Vi hade blivit ett tillräckligt stort företag, vars lösningar användes världen över för att säkerställa oavbruten kommunikation och lösa viktiga problem. Därför blev tillförlitlighet vårt fokus.
Vi behövde göra processen för att distribuera nya Slack-versioner säkrare. Detta behov ledde oss till att förbättra vårt distributionssystem. Som vi nämnde tidigare diskuterade vi just detta förbättrade system. Inom systemet fortsätter vi att använda teknologier för snabb och atomär distribution. Det har förändrat sättet på vilket distributionen utförs. Vårt nya system är utformat för att gradvis distribuera ny kod på olika nivåer och i olika miljöer. Vi använder nu mer avancerade verktyg och övervakningsmedel än tidigare. Detta ger oss möjlighet att fånga och åtgärda fel långt innan de får chans att nå slutanvändaren.
Men vi tänker inte stanna här. Vi förbättrar ständigt detta system genom att tillämpa mer avancerade hjälpverktyg och automatiseringsmedel.
Kära läsare! Hur fungerar processen för distribution av nya projektversioner på din arbetsplats?
Källa: habr.com
