

Med databasen Apache Cassandra och behovet av att driva den inom en infrastruktur baserad på Kubernetes stöter vi regelbundet på utmaningar. I detta material delar vi med oss av vår syn på nödvändiga steg, kriterier och befintliga lösningar (inklusive en översikt av operatörer) för migrering av Cassandra till K8s.
«Den som kan styra en kvinna kan också styra en stat»
Vem är egentligen Cassandra? Det är ett distribuerat lagringssystem som är avsett för att hantera stora datamängder och som samtidigt säkerställer hög tillgänglighet utan en enda punkt av fel. Projektet behöver knappast någon lång introduktion, så jag kommer att nämna bara de grundläggande kännetecknen hos Cassandra som är relevanta för denna specifika artikel:
- Cassandra är skriven i Java.
- Cassandra-topologin inkluderar flera nivåer:
- Nod — en distribuerad instans av Cassandra;
- Rack — en grupp av Cassandra-instanser som är förenade av någon egenskap och befinner sig inom samma datacenter;
- Datacenter — en samling av alla grupper av Cassandra-instanser som är belägna inom ett datacenter;
- Kluster — en samling av alla datacenter.
- För att identifiera en nod använder Cassandra IP-adressen.
- För att snabba upp skriv- och läsoperationer lagrar Cassandra en del av data i det operativa minnet.
Nu går vi till den potentiella flytten till Kubernetes.
Checklista för migration
När vi pratar om migreringen av Cassandra till Kubernetes hoppas vi att det blir mer bekvämt att hantera den efter flytten. Vad krävs för detta och vad kan hjälpa i processen?
1. Lagring för data
Som nämnts tidigare lagrar Cassandra en del av data i det operativa minnet — i Memtable. Men det finns också en annan del av data som sparas på disken — i form av SSTable. Till dessa data läggs en enhet som kallas Commit Log — poster om alla transaktioner som också sparas på disken.
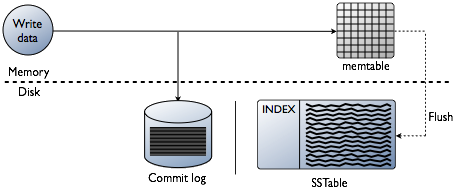
Schema för skrivtransaktioner i Cassandra
I Kubernetes kan vi använda PersistentVolume för att lagra data. Tack vare beprövade mekanismer blir det enklare att arbeta med data i Kubernetes varje år.
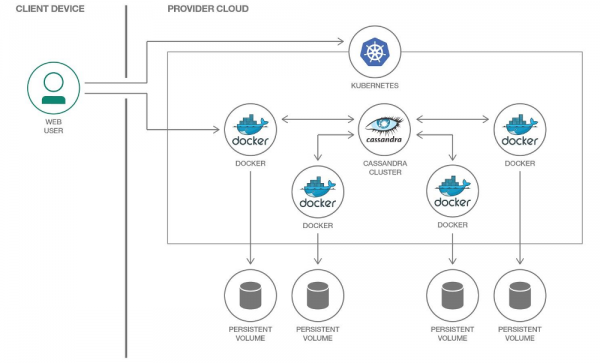
Vi tilldelar varje pod med Cassandra sitt eget PersistentVolume
Det är viktigt att notera att Cassandra i sig själv innebär datareplication och erbjuder inbyggda mekanismer för detta. Så om du bygger en Cassandra-kluster med många noder, finns det ingen anledning att använda distribuerade system som Ceph eller GlusterFS för lagring av data. I detta fall är det logiskt att lagra data på nodens disk med hjälp av eller montering hostPath.
En annan fråga är om du vill skapa en separat miljö för utvecklare för varje funktion-branch. I det här fallet är en korrekt metod att sätta upp en Cassandra-nod och lagra data i en distribuerad lagringslösning, vilket innebär att nämnda Ceph och GlusterFS blir ett alternativ. Då kan utvecklaren vara säker på att de inte förlorar testdata även vid förlust av en av noderna i Kubernetes-klustret.
2. Övervakning
Nästan det enda alternativet för att implementera övervakning i Kubernetes är Prometheus (vi har pratat om detta i detalj i ). Hur är läget med Cassandra när det kommer till exporter för metrik för Prometheus? Och, vad som är ännu viktigare, med lämpliga dashboards för Grafana?
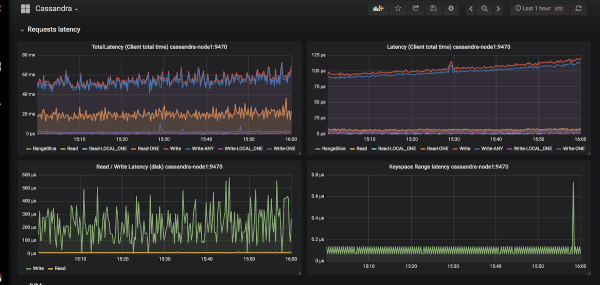
Exempel på utseende av grafer i Grafana för Cassandra
Det finns totalt två exporters: och .
Vi valde den första, eftersom:
- JMX Exporter växer och utvecklas, medan Cassandra Exporter inte har fått tillräckligt med stöd från gemenskapen. Cassandra Exporter stöder fortfarande inte de flesta versioner av Cassandra.
- Det går att köra den som javaagent genom att lägga till flaggan
-javaagent:<plugin-dir-name>/cassandra-exporter.jar=--listen=:9180. - För den finns det , som är inkompatibel med Cassandra Exporter.
3. Val av Kubernetes-primitiver
Enligt den ovanstående strukturen av Cassandra-klustret, låt oss försöka översätta allt som beskrivs där till Kubernetes-terminologi:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → en pool av StatefulSets
- Cassandra Cluster → ???
Det visar sig att det saknas en extra entitet för att hantera hela Cassandra-klustret samtidigt. Men om något saknas kan vi skapa det! I Kubernetes finns mekanismen för att definiera egna resurser avsedd för detta — .
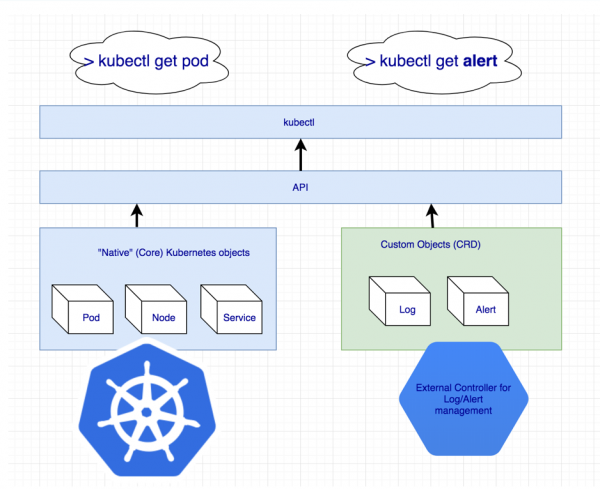
Deklaration av ytterligare resurser för loggar och aviseringar
Men en egen resurs betyder ingenting i sig: det behövs ju en kontroller. Kanske behöver vi hjälp av …
4. Identifiering av poddar
Enligt ovanstående punkt kom vi överens om att en nod i Cassandra motsvarar en pod i Kubernetes. Men IP-adresserna för poddar kommer att vara olika varje gång. Identifieringen av noden i Cassandra sker just baserat på IP-adressen… Det innebär att efter varje borttagning av en pod kommer Cassandra-klustret att lägga till en ny nod.
Det finns lösningar, och inte bara en:
- Vi kan hålla reda på värdidentifierare (UUID:er som entydigt identifierar Cassandra-instans) eller på IP-adresser och spara allt detta i vissa strukturer/tabeller. Metoden har två huvudsakliga nackdelar:
- Risk för en kapplöpningstillstånd om två noder faller ner samtidigt. När noderna startas kommer Cassandra-noderna att försöka begära en IP-adress från tabellen samtidigt och konkurrera om samma resurs.
- Om en Cassandra-nod har förlorat sina data kan vi inte längre identifiera den.
- Den andra lösningen verkar vara en liten hack, men trots det: vi kan skapa Service med ClusterIP för varje Cassandra-nod. Problemet med denna implementation:
- Om det finns många noder i Cassandra-klustret måste vi skapa väldigt många Service:er.
- Möjligheten till ClusterIP implementeras via iptables. Detta kan bli ett problem om det finns många (1000… eller till och med 100?) noder i Cassandra-klustret. Trots allt lösa detta problem.
- Den tredje lösningen är att använda klusternoder för Cassandra-noder istället för en dedikerad pod-nätverk genom att aktivera inställningen
hostNetwork: true. Denna metod medför vissa begränsningar:- Vid byte av noder. Den nya noden måste ha samma IP-adress som den tidigare (i moln som AWS, GCP är detta praktiskt taget omöjligt);
- Genom att använda klusternätverket börjar vi konkurrera om nätverksresurser. Därför blir det problematiskt att ha mer än en pod med Cassandra på samma klusternod.
5. Säkerhetskopior
Vi vill spara en fullständig version av datan för en Cassandra-nod enligt schema. Kubernetes erbjuder en bekväm möjlighet med hjälp av , men här stöter vi på hinder på grund av själva Cassandra.
Jag vill påminna att en del av datan i Cassandra lagras i minnet. För att göra en fullständig säkerhetskopia måste data från minnet (Memtables) överföras till disk (SSTables). Vid detta ögonblick slutar Cassandra-noden ta emot anslutningar och faller helt ur klustrets drift.
Därefter tas en säkerhetskopia (snapshot) och schemat sparas (keyspace). Här visar det sig att enbart en säkerhetskopiering inte ger oss något: vi behöver spara identifierarna för de data som noden Cassandra ansvarade för — dessa är speciella token.
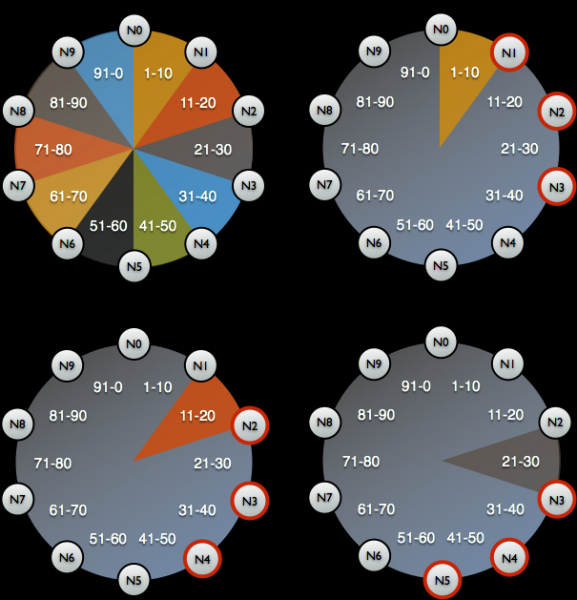
Tokenfördelning för att identifiera vilka data som Cassandra-noder ansvarar för.
Ett exempel på skript för att ta säkerhetskopior från Cassandra via Google i Kubernetes kan hittas på . Den enda punkten som skriptet inte tar hänsyn till är återställning av data på noden innan en snapshot tas. Det vill säga, säkerhetskopieringen utförs inte för det aktuella tillståndet utan för ett tidigare tillstånd. Men detta hjälper till att hålla noden i drift, vilket verkar väldigt logiskt.
set -eu

if [[ -z "$1" ]]; then
  info "Vänligen ange ett keyspace"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Fel vid skapande av snapshot"
  exit 1
fi

timestamp=$(echo "$result" | awk '/Snapshot directory: / { print $3 }')

mkdir -p /tmp/backup

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir /tmp/backup/$table
  mv $path /tmp/backup/$table
done


tar -zcf /tmp/backup.tar.gz -C /tmp/backup .

nodetool clearsnapshot "${KEYSPACE}"
Ett exempel på bash-skript för att ta en säkerhetskopia från en Cassandra-nod.
Färdiga lösningar för Cassandra i Kubernetes.
Vilka lösningar används för att köra Cassandra i Kubernetes just nu, och vilken av dem passar bäst för de uppsatta kraven?
1. Lösningar baserade på StatefulSet eller Helm-charts.
Att använda grundläggande funktioner i StatefulSets för att starta en Cassandra-kluster är ett bra alternativ. Med hjälp av en Helm-chart och Go-mallar kan användaren erbjudas ett flexibelt gränssnitt för att implementera Cassandra.
Oftast fungerar det bra… tills något oväntat inträffar — till exempel när en nod går sönder. De standardverktyg som Kubernetes tillhandahåller kan helt enkelt inte ta hänsyn till alla ovan nämnda särskildheter. Dessutom är denna metod mycket begränsad i hur den kan skalas för mer komplex användning: byte av noder, säkerhetskopiering, återställning, övervakning, etc.
Representanter:
- ;
- .
Båda chartsen är lika bra, men är ändå mottagliga för de problem som beskrivits ovan.
2. Lösningar baserade på Kubernetes Operator.
Dessa alternativ är mer intressanta, eftersom de erbjuder omfattande möjligheter för klusterhantering. För att designa en Cassandra-operator, liksom alla andra databaser, ser en bra mönster ut som Sidecar Controller CRD:
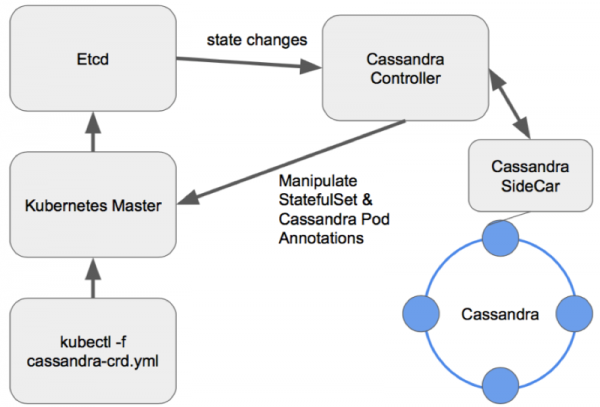
Schema för nodhantering i en korrekt designad Cassandra-operator.
Låt oss titta på befintliga operators.
1. Cassandra-operator från Instaclustr
- Status: Alpha
- Licens: Apache 2.0
- Implementerad på: Java
Detta är verkligen ett mycket lovande och aktivt växande projekt från ett företag som erbjuder hanterade distributioner av Cassandra. Det använder, som nämnts ovan, en sidecar-container som tar emot kommandon via HTTP. Skrivet i Java, så ibland saknar det mer avancerad funktionalitet från biblioteket client-go. Dessutom stöder inte operatören olika Racks för ett och samma Datacenter.
Men operatören har fördelar som stöd för övervakning, högre nivåhantering av kluster via CRD och till och med dokumentation för att ta säkerhetskopior.
2. Navigator från Jetstack
- Status: Alpha
- Licens: Apache 2.0
- Implementerad på: Golang
Operatören är avsedd för distribution av DB-as-a-Service. För närvarande stöder den två databaser: Elasticsearch och Cassandra. Den innehåller intressanta lösningar som databaskontroll via RBAC (för detta startas en separat navigator-apiserver). Ett intressant projekt som är värt att titta närmare på, men den senaste committen gjordes för ett och ett halvt år sedan, vilket uppenbart minskar dess potential.
3. Cassandra-operator från vgkowski
- Status: Alpha
- Licens: Apache 2.0
- Implementerad på: Golang
Vi valde att inte ta den "på allvar" eftersom den senaste committen till repositoryn gjordes för mer än ett år sedan. Utvecklingen av operatören har övergetts: den senaste versionen av Kubernetes, som anges som stödd, är 1.9.
4. Cassandra-operator från Rook
- Status: Alpha
- Licens: Apache 2.0
- Implementerad på: Golang
Operatören utvecklas inte så snabbt som vi skulle vilja. Den har en genomtänkt CRD-struktur för klusterhantering, löser problemet med identifikation av noder genom att använda Service med ClusterIP (den berömda "hacken")... men än så länge är det allt. Ingen övervakning eller säkerhetskopior finns standard just nu (förresten, vi ). Intressant nog kan man också distribuera ScyllaDB med hjälp av denna operatör.
NB: Denna operatör användes med några små modifieringar i ett av våra projekt. Inga problem med operatörens funktion över hela tiden (~4 månaders drift) har observerats.
5. CassKop från Orange
- Status: Alpha
- Licens: Apache 2.0
- Implementerad på: Golang
Den yngsta operatören på listan: den första committen gjordes den 23 maj 2019. Redan nu har den ett stort antal funktioner från vår lista, vilka kan utforskas mer ingående i projektets repository. Operatören byggs på den populära operator-sdk. Den stöder övervakning "ur lådan". Huvudskillnaden från andra operatörer är användningen av , implementerat i Python och används för kommunikation mellan Cassandra-noder.
Slutsatser
Antalet metoder och möjliga alternativ för att migrera Cassandra till Kubernetes talar för sig själv: ämnet är efterfrågat.
Vid det här laget kan du prova något av det ovanstående på egen risk: ingen av utvecklarna garanterar 100% drift av sina lösningar i produktionsmiljö. Men redan nu ser många produkter lovande ut för att kunna använda dem i utvecklingsmiljöer.
Jag tror att i framtiden kommer denna kvinna på skeppet att vara på sin plats!
P.S.
Läs även i vår blogg:
- «»;
- «»;
- «»;
- «».
Källa: habr.com
