

Mikhail Salosin (härefter – MS): – Hej alla! Jag heter Mikhail. Jag arbetar som backend-utvecklare på företaget MC2 Software, och jag kommer att berätta om användningen av Go i backend för mobilapplikationen "Smotri+".
Är det någon här som älskar hockey?
Då är den här appen för dig. Den finns för Android och iOS och används för att titta på sändningar av olika sportevenemang online och i efterhand. I appen finns även olika statistik, textbaserade sändningar, tabeller för konferenser, turneringar och annan information som är användbar för fans.
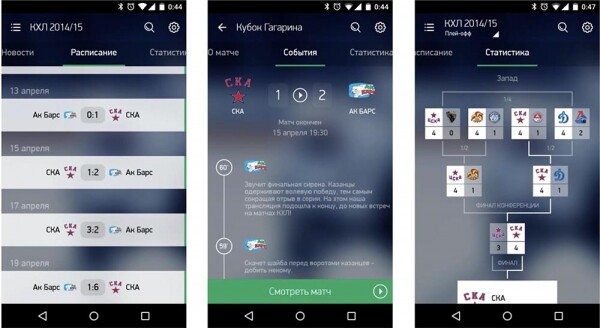
Appen har också en funktion som kallas videomoments, vilket innebär att man kan se höjdpunkter från matcherna (mål, slagsmål, straffar osv.). Om du inte vill se hela sändningen kan du bara titta på det mest intressanta.
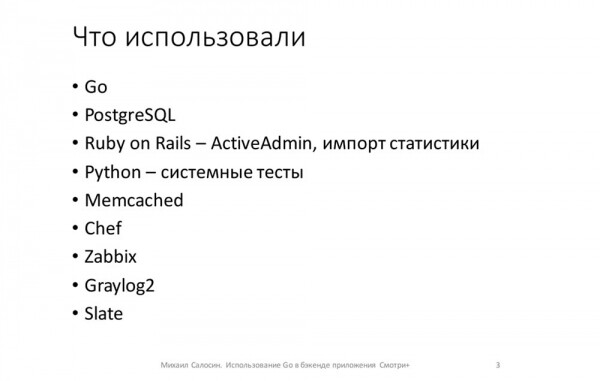
Vad använde vi i utvecklingen?
Största delen var skriven i Go. Den API som mobilklienterna kommunicerade med var skriven i Go. Även tjänsten för att skicka push-notifikationer till mobiler var skriven i Go. Dessutom var vi tvungna att skriva vår egen ORM, som vi kanske berättar mer om någon gång. Och vissa mindre tjänster har skrivits i Go: resizing och uppladdning av bilder för redaktörernas sida…
För databasen använde vi PostgreSQL. Gränssnittet för redaktörerna var skrivet i Ruby on Rails med hjälp av gemet (gem) ActiveAdmin. Statistikimporten från statistikleverantören var också skriven i Ruby.
För systemtester av API:n använde vi Python's unittest. Memcached används för att throttla API-betalningar, Chef för konfigurationshantering, Zabbix för insamling och övervakning av interna statistiska data i systemet. Graylog2 används för att samla loggar, och Slate är API-dokumentationen för kunder.
Val av protokoll
Det första problemet vi stötte på: vi behövde välja ett protokoll för interaktionen mellan backend och mobilklienterna, baserat på följande punkter…
- Det viktigaste kravet: data på klienterna måste uppdateras i realtid. Det vill säga alla som just nu tittar på sändningen ska få uppdateringar nästan omedelbart.
- För enkelhetens skull antog vi att de data som synkroniseras med klienterna inte tas bort utan döljs med hjälp av speciella flaggor.
- Sällsynta förfrågningar (som statistik, laguppställningar, lagstatistik) görs genom vanliga GET-förfrågningar.
- Dessutom skulle systemet kunna hantera 100 000 användare samtidigt utan problem.
Baserat på detta hade vi två protokollalternativ:
- Websockets. Men vi behövde inga kanaler från klienten till servern. Vi behövde bara skicka uppdateringar från servern till klienten, så websockets var överflödiga.
- Server-Sent Events (SSE) passade perfekt! Det är tillräckligt enkelt och uppfyller i princip allt vi behöver.
Server-Sent Events
Några ord om hur denna sak fungerar...
Den fungerar över http-anslutningen. Klienten skickar en förfrågan, servern svarar med Content-Type: text/event-stream och stänger inte anslutningen till klienten, utan fortsätter att skriva data i anslutningen:
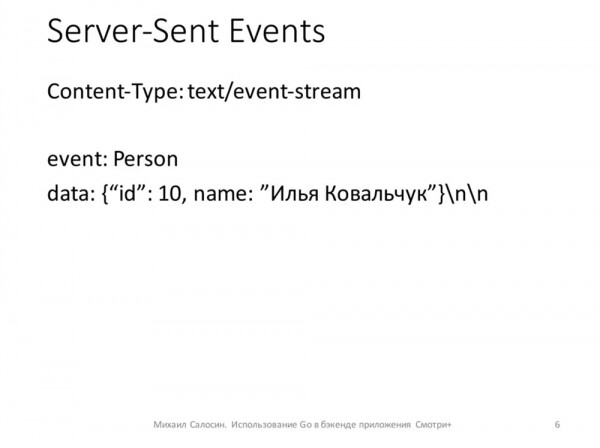
Data kan skickas i det format som överenskommits med klienterna. I vårt fall skickade vi i följande form: i fältet event angavs namnet på den ändrade strukturen (person, spelare), och i data-fältet – JSON med de nya, ändrade fälten för spelaren.
Nu om hur själva interaktionen fungerar.
- Först och främst fastställer klienten när den senast synkroniserade med tjänsten: den tittar i sin lokala databas och bestämmer datumet för den senaste ändringen som registrerades hos den.
- Den skickar en förfrågan med detta datum.
- Som svar skickar vi all uppdatering som har skett efter detta datum.
- Därefter upprättar den en anslutning till live-kanalen och stänger den inte förrän den inte längre behöver dessa uppdateringar:
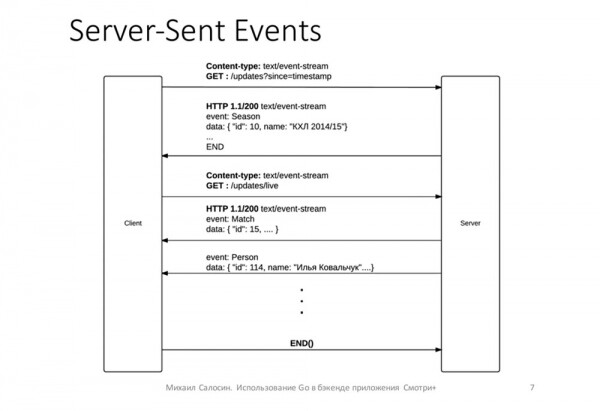
Vi skickar en lista över förändringar: om någon gör mål förändrar vi matchresultatet, om någon skadar sig – det skickas också i realtid. På så sätt får klienterna omedelbart aktuella data i matchens händelseflöde. Periodiskt, för att klienten ska förstå att servern inte har kraschat och att ingenting har hänt med den, skickar vi varje 15:e sekund en tidsstämpel – så att den vet att allt är okej och att det inte behövs någon återanslutning.
Hur underhålls live-anslutningen?
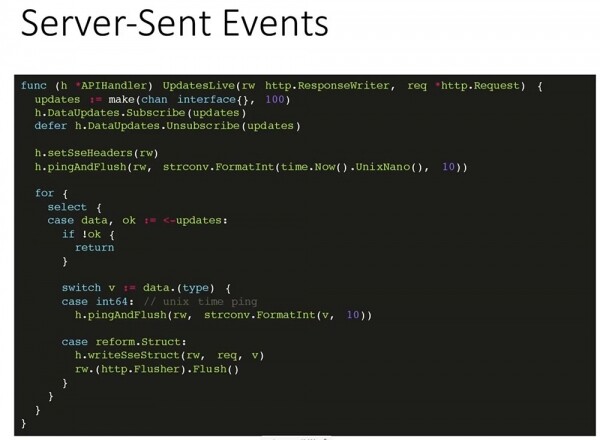
- Först skapar vi en kanal som kommer att ta emot uppdateringar med en buffert.
- Efter det registrerar vi denna kanal för att ta emot uppdateringar.
- Vi sätter rätt rubrik så att klienten vet att allt är ok.
- Vi skickar den första ping. Vi skriver helt enkelt ned den aktuella tidsstämpeln för anslutningen.
- Efter detta läser vi i en loop från kanalen så länge uppdateringskanalen inte är stängd. Det kommer periodiskt antingen en aktuell tidsstämpel eller förändringar som vi redan skriver till öppna anslutningar.
Det första problemet vi stötte på var följande: för varje öppen anslutning med en klient skapade vi en timer som tickade var 15:e sekund – vilket innebär att om vi hade 6000 anslutningar till en maskin (med en API-server) skapades 6000 timers. Detta ledde till att maskinen inte höll den nödvändiga belastningen. Problemet var inte så uppenbart för oss, men vi fick lite hjälp och löste det.
I slutändan kommer nu pinget från samma kanal som uppdateringen kommer ifrån.
Därmed finns det bara en timer som tickar var 15:e sekund.
Här finns några hjälpfunktioner – att skicka header, ping och själva strukturen. Det vill säga, här skickas namnet på tabellen (person, match, säsong) och själva informationen om denna post:

Mekanismen för att skicka uppdateringar
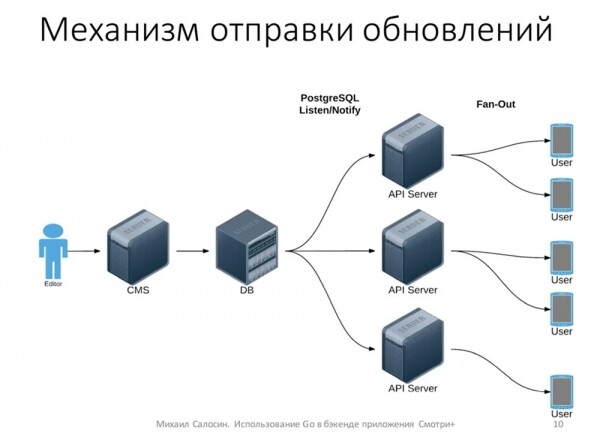
Nu lite om var förändringarna kommer ifrån. Vi har flera personer, redaktörer, som i realtid ser på sändningen. De skapar alla händelser: någon har blivit utvisad, någon har skadat sig, något byte…
Genom CMS går datan in i databasen. Efter det meddelar databasen via mekanismen Listen/Notify API-servrarna om detta. API-servrarna skickar sedan denna information till klienterna. På så sätt är det i praktiken bara några servrar som är anslutna till databasen och det finns ingen särskild belastning på databasen eftersom klienten på inget sätt interagerar direkt med databasen:
PostgreSQL: Listen/Notify
Mekanismen Listen/Notify i "Postgres" gör det möjligt att informera prenumeranter om händelser om att någon händelse har förändrats – det har skapats en post i databasen. För detta skrev vi en enkel trigger och funktion:
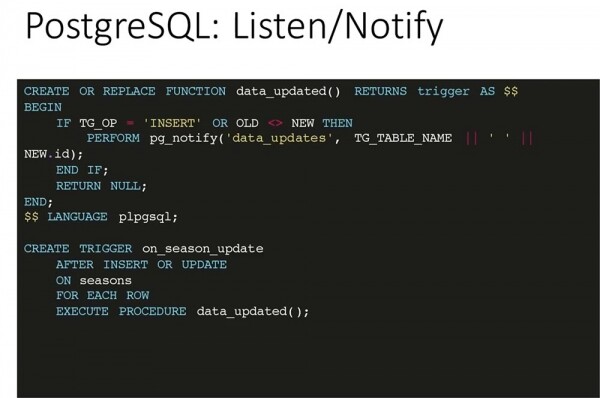
Vid insert eller ändring av en post anropar vi funktionen notify på kanalen data_updates, dit vi skickar namnet på tabellen och identifieraren för den post som har ändrats eller lagts till.
För alla tabeller som ska synkroniseras med klienten definierar vi en trigger som efter förändring/uppdatering av posten anropar funktionen som anges på bilden nedan.
Hur prenumererar API:t på dessa förändringar?
En fanout-mekanism skapas – den distribuerar meddelanden till kunder. Den samlar alla kundkanaler och skickar de uppdateringar som den fått genom dessa kanaler:
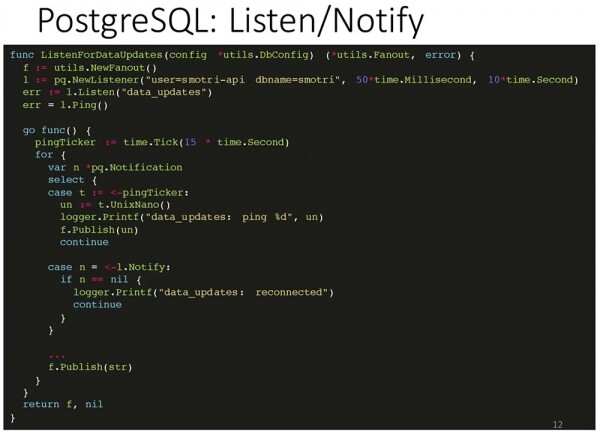
Här är standardbiblioteket pq, som ansluter till databasen och säger att den vill lyssna på kanalen (data_updates), kontrollerar att anslutningen är öppen och att allt fungerar. Jag hoppar över felkontrollen för att spara utrymme (att inte kontrollera är riskabelt).
Sedan ställer vi in en Ticker asynkront, som skickar ping var 15:e sekund, och börjar lyssna på kanalen som vi prenumererat på. Om vi får en ping, publicerar vi den pinget. Om vi får någon post, publicerar vi denna post till alla prenumeranter av denna Fanout.
Hur fungerar Fan-out?
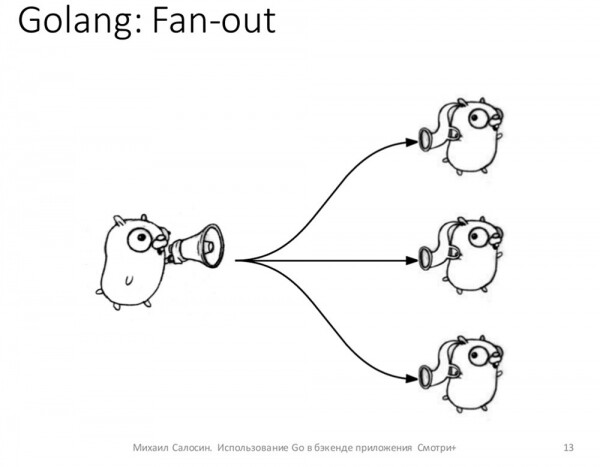
På svenska översätts det som "förgrenare". Vi har ett objekt som registrerar prenumeranter som vill få några uppdateringar. Så snart en uppdatering till detta objekt kommer, distribuerar det denna uppdatering till alla sina prenumeranter. Ganska enkelt:
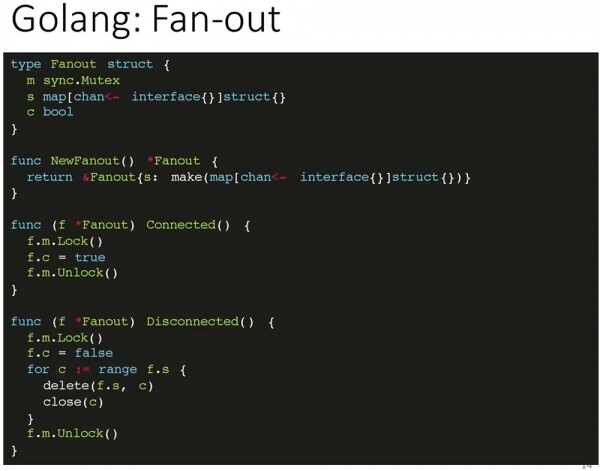
Hur detta implementeras i Go:
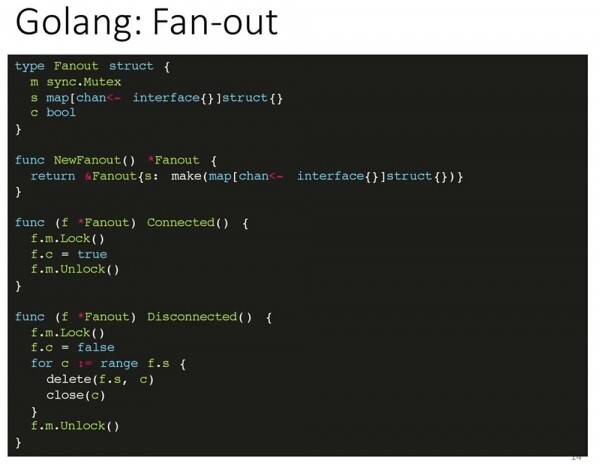
Det finns en struktur som synkroniseras med hjälp av Mutexar. Den har ett fält som sparar anslutningens tillstånd mellan Fanout och databasen, dvs. just nu lyssnar den och kommer att ta emot uppdateringar, samt en lista över alla befintliga kanaler – en map, där nyckeln är kanalen och struct i form av värden (egentligen används den inte på något sätt).
Två metoder – Connected och Disconnected – gör att Fanout vet att vi har en anslutning till databasen, den har skapats och att anslutningen till databasen har brutits. I det andra fallet behöver alla klienter kopplas bort och meddelas att de inte längre kan lyssna och att de bör återansluta, eftersom anslutningen till dem har stängts.
Det finns också en metod Subscribe som lägger till en kanal i "lyssnare":
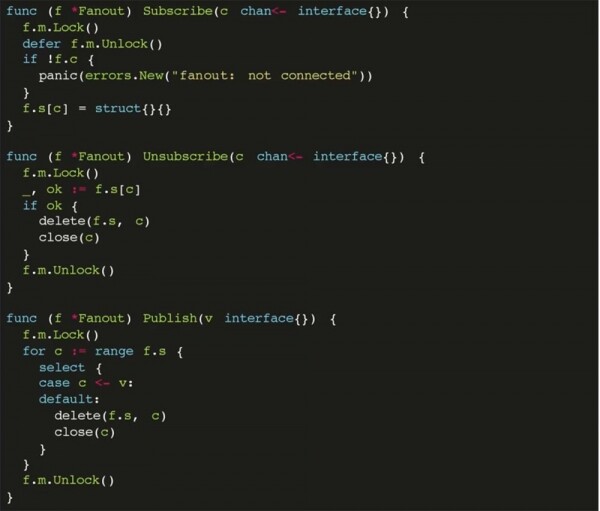
Det finns en metod Unsubscribe som tar bort kanalen från de lyssnande, om klienten har kopplat bort sig, samt en metod Publish som gör att meddelanden kan skickas till alla prenumeranter.
Fråga: – Vad överförs via denna kanal?
MS: – En modell som har ändrats eller en ping (egentligen bara ett nummer, heltal).
MS: – Man kan skicka vad som helst, vilken struktur som helst, publicera – den omvandlas helt enkelt till JSON och det är allt.
MS: – Vi får en notifiering från "Postgres" – den innehåller namnet på tabellen och identifieraren. Genom tabellens namn får vi den registrering vi behöver via identifieraren, och denna struktur skickar vi för publicering.
Infrastruktur
Hur ser det ut ur ett infrastruktursynpunkt? Vi har 7 hårdvaruserverar: en av dem är helt dedikerad för databasen, på de andra sex körs virtuella maskiner. Det finns 6 kopior av API:et: varje virtuell maskin med API körs på en separat hårdvaruserver – detta för pålitlighet.
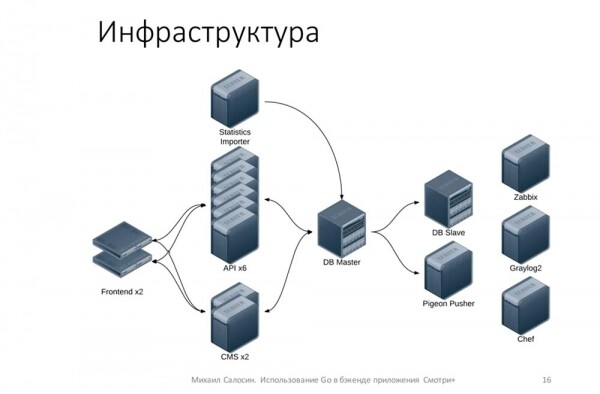
Vi har två frontend, på vilka Keepalived är installerat för att förbättra tillgängligheten, så att i händelse av något kan en frontend ersätta den andra. Dessutom finns det två kopior av CMS.
Det finns också en statistikimportör. Det finns en DB Slave, från vilken säkerhetskopior görs periodiskt. Det finns Pigeon Pusher – den applikationen som skickar push-notiser till kunderna, samt infrastrukturella saker: Zabbix, Graylog2 och Chef.
Denna infrastruktur är faktiskt överflödig, eftersom man kan hantera 100 000 med färre servrar. Men vi hade hårdvaran – vi använde den (vi fick höra att det var okej – varför inte).
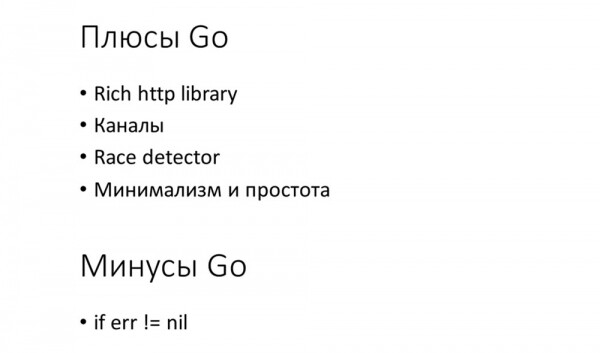
Fördelar med Go
Efter att vi har arbetat med denna applikation har dessa uppenbara fördelar med Go framträtt.
- En fantastisk http-bibliotek. Med hjälp av det kan man skapa ganska mycket direkt "ur lådan".
- Dessutom kanaler som gjorde det mycket enkelt för oss att implementera mekanismen för att skicka notifieringar till kunder.
- Det underbara verktyget Race detector gjorde att vi kunde undanröja flera kritiska buggar (staging-infrastrukturen). Allt som fungerar på staging körs och kompileras med Race-nyckeln; och vi kan därmed se på staging-infrastrukturen vilka potentiella problem vi har.
- Minimalism och enkelhet i språket.
Vi söker utvecklare! Om någon är intresserad – vänligen hör av er.
Frågor
Fråga från publiken (vidare – F): – Jag verkar ha missat en viktig punkt angående Fan-out. Förstår jag rätt att när ni skickar svar till kunden, blockeras ni om kunden inte vill läsa?
MS: – Nej, vi blockerar oss inte. För det första är allt detta bakom nginx, vilket innebär att vi inte har några problem med långsamma kunder. För det andra har kunden en buffertkanal – i princip kan vi lägga upp till hundra uppdateringar där... Om vi inte kan skriva till kanalen, så tar den bort den. Om vi ser att kanalen har blockerat, stänger vi helt enkelt kanalen, och allt – kunden kommer att återansluta om det uppstår något problem. Därför uppstår det i princip inga blockeringar här.
L: – Kunde vi inte skicka en Listen/Notify-post direkt, istället för identifikatorn för tabellen?
MS: – Listen/Notify har en begränsning på 8 000 byte på preload som den skickar. I princip skulle vi kunna skicka det om vi hade att göra med en liten mängd data, men jag tycker att det är helt enkelt mer pålitligt att göra som vi gör. Begränsningarna ligger i själva "PostgreSQL".
L: – Får kunderna uppdateringar om matcher som de inte är intresserade av?
MS: – I allmänhet, ja. Som regel sker det 2-3 matcher parallellt, och det är ganska sällsynt. Om kunden tittar på något, är det vanligtvis den matchen som pågår just nu. Dessutom har kunden en lokal databas där alla dessa uppdateringar lagras, och även utan internetanslutning kan kunden se alla passerade matcher som han har uppdateringar för. I princip synkroniserar vi vår databas på servern med kundens lokala databas så att han kan arbeta offline.
L: – Varför gjorde ni er egen ORM?
Alexey (en av utvecklarna av "Smotri+"): – Vid den tiden (det var för ett år sedan) fanns det färre ORM:er än det finns nu, när det finns ganska många. Av de flesta existerande ORM:er gillar jag mest att de flesta av dem arbetar med tomma gränssnitt. Det betyder att metoderna i dessa ORM:er är redo att ta emot vad som helst: en struktur, en strukturpekare, ett nummer, något helt orelaterat...
Vår ORM genererar strukturer baserat på datamodellen. Själv. Så alla metoder är specifika och använder inte reflektion osv. De tar emot strukturer och förväntar sig att använda de strukturer som tas emot.
L: – Hur många personer deltog?
MS: – I det inledande skedet deltog två personer. Någon gång i juni började vi, i augusti var den största delen klar (den första versionen). I september var det release.
L: – Där du beskriver SSE, använder du ingen timeout. Varför så?
MS: – Om vi talar klart och tydligt, så är SSE ändå ett html5-protokoll: standarden för SSE är avsedd för kommunikation med webbläsare, såvitt jag förstår. Den har ytterligare funktioner för att webbläsare ska kunna återansluta (och så vidare), men vi behöver dem inte, eftersom vi hade kunder som kunde implementera vilken anslutningslogik som helst och hämta information. Vi gjorde snarare något som liknar SSE än själva protokollet.
Det fanns ingen anledning. Såvitt jag förstår implementerade kunderna anslutningsmekanismen praktiskt taget från början. Det spelade i princip ingen roll för dem.
L: – Vilka ytterligare verktyg använde ni?
MS: – Vi använde mest aktivt govet och golint för att stilen skulle vara enhetlig, samt gofmt. Inga andra verktyg användes.
L: – Hur genomförde ni felsökning?
MS: – Felsökningen skedde i stort sett med hjälp av tester. Vi använde ingen debugger och inget GOP.
L: – Kan du återvända till den bild där funktionen Publish är implementerad? Stör dig inte på variabler med enstaviga namn?
MS: – Nej. De har en ganska "snäv" synlighetsområde. De används ingen annanstans än här (förutom inuti denna klass), och den är mycket kompakt – bara 7 rader lång.
L: – Det känns ändå inte intuitivt...
MS: – Nej, nej, det här är verklig kod! Det handlar inte om stil. Det är helt enkelt en sån utilitaristisk, mycket liten klass – bara 3 fält inuti klassen...
MS: – I stort sett ändras alla de data som synkroniseras med kunderna (säsongsmatcher, spelare) inte. Grovt sagt, om vi ska göra någon annan sport där vi behöver ändra matchen, så tar vi bara hänsyn till det i den nya versionen av klienten, och de gamla versionerna av klienten kommer att blockeras.
L: – Finns det några externa paket för att hantera beroenden?
MS: – Vi använde go dep.
L: – I föredragets ämne fanns det något om video, men det finns inget om video i föredraget.
MS: – Nej, jag har inget om video i mitt ämne. Det heter "Svet +" – så heter appen.
L: – Du sa att det strömmas till kunderna?..
MS: – Vi sysslade inte med strömmande video. Det gjorde helt och hållet "MegaFon". Ja, jag nämnde inte att appen är från MegaFon.
MS: – Go – för att skicka all data – om kontot, om matchhändelser, statistik… Go – det är helt backend för applikationen. Klienten måste någonstans få veta vilken länk som ska användas för spelaren så att användaren kan se matchen. Vi har länkar till videor och strömmar som är förberedda.
Lite reklam 🙂
Tack för att ni stannar kvar hos oss. Gillar ni våra artiklar? Vill ni se fler intressanta material? Stöd oss genom att göra en beställning eller rekommendera oss till era vänner, , en unik motsvarighet till entry-level servrar som vi har skapat för er: (alternativ med RAID1 och RAID10 finns tillgängliga, upp till 24 kärnor och upp till 40GB DDR4).
Dell R730xd är två gånger billigare i datacentret Equinix Tier IV i Amsterdam? Bara hos oss i Nederländerna! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — från $99! Läs om
Källa: habr.com
