

Hej alla! Jag är CV-utvecklare på KROK. Under de senaste tre åren har vi genomfört projekt inom CV. Under denna tid har vi gjort många saker, till exempel: övervakat förare för att säkerställa att de inte dricker, röker, pratar i telefon, och att de tittar på vägen istället för att drömma eller titta på molnen; registrerat dem som gillar att köra i specifika filer och ocjera flera parkeringsplatser; såg till att arbetare bär hjälmar, handskar och så vidare; identifierat anställda som vill gå in på området; räknat allt som går att räkna.
Vad är poängen med detta?
Under genomförandet av projekten har vi stött på många hinder, en del av problemen känner ni kanske till, eller kommer att få känna igen i framtiden.
Låt oss modellera en situation
Föreställ dig att vi börjar på ett ungt företag "N", vars verksamhet är kopplad till ML. Vi arbetar med ett ML (DL, CV) projekt, och av någon anledning går vi över till ett annat jobb, tar en paus, och återvänder till vårt eller någon annans neurala nätverk.
- Det är dags för sanningen, vi måste på något sätt komma ihåg var vi slutade, vilka hyperparametrar vi testade och, viktigast av allt, vilka resultat de gav. Det kan finnas många sätt att spara information om alla körningar: i huvudet, i konfigurationer, i anteckningsböcker, i arbetsmiljön i molnet. Jag har sett en lösning där hyperparametrar sparades som kommenterade rader i koden, en riktig fantasi. Tänk nu att du inte återvänder till ditt eget projekt, utan till ett projekt av en person som lämnat företaget, och du har fått koden och modellen som heter model_1.pb. För att ge en fullständig bild och överföra all smärta, föreställ dig att du dessutom är en nybörjare.
- Vi går vidare. För att köra koden behöver vi, och alla som ska arbeta med den, skapa en miljö. Det händer ofta att vi också av någon anledning inte har fått den i arv. Detta kan också bli en icke-trivsam uppgift. Man vill ju inte spendera tid på det här steget, eller hur?
- Tränar modellen (till exempel, en bil-detektor). Vi når en punkt där den blir ganska bra — det är dags att spara resultatet. Vi kallar den car_detection_v1.pb. Sedan tränar vi en till — car_detection_v2.pb. En tid senare tränar våra kollegor, eller vi själva, fler och fler, med olika arkitekturer. Slutligen samlas en hel del artefakter, vars information vi behöver noggrant samla in (men det får vi ta senare, vi har ju mer prioriterade saker just nu).
- Och där har vi det! Vi har en modell! Vi kan börja träna nästa modell, utveckla en arkitektur för att lösa ett nytt problem, eller ska vi gå och ta en kopp te? Men vem ska deploya den?
Identifiera problem
Arbete med projekt eller produkter är resultatet av många människors insatser. Med tiden går människor, och nya kommer, projekten ökar i antal, och projekten blir mer komplexa. Så eller så, situationer från stegen ovan (och inte bara) kommer att dyka upp i olika kombinationer från iteration till iteration. Allt detta resulterar i tidsförlust, förvirring, stress, och kanske missnöje från kunden, vilket i slutändan kan leda till förlorade pengar. Även om vi oftast trampar i samma gamla fällor, tror jag ingen vill uppleva dessa situationer om och om igen.
Så, vi har genomgått ett utvecklingscykel och ser att det finns problem som behöver lösas. För detta behöver vi:
- en bekväm lagring för arbetsresultat;
- göra det enkelt att involvera nya anställda;
- förenkla processen för att sätta upp utvecklingsmiljöer;
- ställa in processer för versionshantering av modeller;
- ha en enkel metod för validering av modeller;
- hitta ett verktyg för att hantera modellens tillstånd;
- hitta sätt att leverera modeller till produktion.
Det verkar nödvändigt att skapa ett arbetsflöde som gör det enkelt att hantera denna livscykel? En sådan praxis kallas MLOps.
MLOps, eller DevOps för maskininlärning, gör det möjligt för team av databehandlare, analytiker och IT-specialister att samarbeta och öka hastigheten på utvecklingen och distributionen av modeller genom övervakning, verifiering och hanteringssystem för maskininlärningsmodeller.
Du kan , vad grabbarna på Google tycker om allt detta. I artikeln framgår det att MLOps är ganska omfattande.
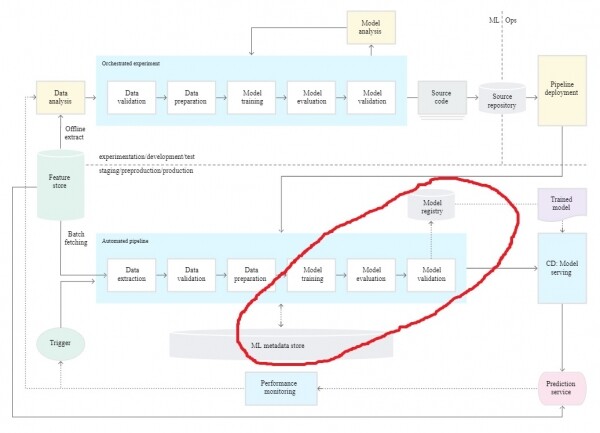
I nästa del av min artikel kommer jag att beskriva endast en del av processen. För implementeringen kommer jag att använda verktyget MLflow, eftersom det är ett open-source projekt, och för att koppla upp det behövs en relativt liten mängd kod samt integration med populära ML-ramverk. Du kan söka på internet efter andra verktyg, som Kubeflow, SageMaker, Trains, etc., och kanske hitta ett som passar dina behov bättre.
"Bygger" MLOps med hjälp av verktyget MLFlow
MLFlow är en plattform med öppen källkod för hantering av livscykeln för ML-modeller ().
MLflow omfattar fyra komponenter:
- MLflow Tracking – hanterar frågor kring registrering av resultat och parametrar som ledde till det resultatet;
- MLflow Project – låter dig paketera kod och reproducera den på vilken plattform som helst;
- MLflow Models – ansvarar för driftsättning av modeller i produktion;
- MLflow Registry – låter dig lagra modeller och hantera deras tillstånd i ett centraliserat förråd.
MLflow arbetar med två enheter:
- en körning – det är en fullständig cykel av träning, parametrar och metoder som vi vill registrera;
- ett experiment – det är ett "ämne" som förenar körningar.
Alla steg i exemplet är implementerade på operativsystemet Ubuntu 18.04.
1. Sätter upp servern
För att vi enkelt ska kunna hantera vårt projekt och få all nödvändig information, ska vi sätta upp en server. MLflow tracking server består av två huvudkomponenter:
- backend store – ansvarar för att lagra information om registrerade modeller (stödjer 4 databashanterare: mysql, mssql, sqlite och postgresql);
- artifact store – ansvarar för att lagra artefakter (stödjer 7 lagringsalternativ: Amazon S3, Azure Blob Storage, Google Cloud Storage, FTP-server, SFTP-server, NFS, HDFS).
Som artifact store för enkelhetens skull tar vi en sftp-server.
- skapar en grupp
$ sudo groupadd sftpg - lägger till en användare och ställer in ett lösenord
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - justerar några inställningar för åtkomst
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - lägger till några rader i /etc/ssh/sshd_config
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - startar om tjänsten
$ sudo systemctl restart sshd
Som backend store vi tar postgresql.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Skapa ny användare: mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Ange namn på rollen som ska läggas till: mlflow_user
Ange lösenord för ny roll: mlflow
Skriv in det igen: mlflow
Ska den nya rollen vara superanvändare? (j/n) n
Ska den nya rollen få skapa databaser? (j/n) n
Ska den nya rollen få skapa fler nya roller? (j/n) n
# Skapa databas mlflow_bd ägd av mlflow_user
$ createdb -O mlflow_user mlflow_db
För att starta servern måste följande python-paket installeras (jag rekommenderar att skapa en separat virtuell miljö):
pip install mlflow
pip install pysftp
Vi startar vår server
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Lägga till spårning
För att se till att resultaten av våra träningar inte går förlorade, att framtida generationer av utvecklare förstår vad som faktiskt hände, och att äldre kollegor och du själva kan analysera utbildningsprocessen, måste vi lägga till spårning. Med spårning menas att spara parametrar, metrik, artefakter och all annan ytterligare information om utbildningskörningarna, i vårt fall, på servern.
Som exempel har jag skapat ett litet med Keras för segmentering av allt som finns i . För att lägga till spårning har jag skapat filen mlflow_training.py.
Här är raderna där den verkliga handlingen sker:
def run(self, epochs, lr, experiment_name):
        # får id för experimentet, skapar ett experiment om det saknas
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # skapar en "run" och får dess id
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # ange att vi vill spara resultaten på en fjärrserver
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Här är self.remote_server ett litet wrapper runt metoderna mlflow.tracking. MlflowClient (gjorde jag för bekvämlighet), med hjälp av vilka jag skapar ett experiment och en körning på servern. Sedan anger jag var resultaten från körningen ska sparas (mlflow.set_tracking_uri(self.tracking_uri)). Jag aktiverar automatisk loggning mlflow.keras.autolog(). För tillfället stöder MLflow Tracking automatisk loggning för TensorFlow, Keras, Gluon XGBoost, LightGBM, Spark. Om du inte hittar ditt ramverk eller bibliotek kan du alltid logga explicit. Vi startar utbildningen. Vi registrerar taggar och inparametrar på den fjärrservern.
Några rader och du, precis som alla som är intresserade, har tillgång till information om alla körningar. Coolt?
3. Skapa projektet
Nu ska vi göra det enklare att starta projektet. För detta lägger vi till en fil MLproject och conda.yaml i projektets rot.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'lista över kategorier från coco-dataset'}
        epochs: {type: int, help: 'antal epoker i träningen'}

        lr: {type: float, default: 0.001, help: 'inlärningshastighet'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'exempel resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'serveradress'}
        experiment_name: {type: str, default: 'My_experiment', help: 'namn på fjärr- och lokalt experiment'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
MLflow Project har flera egenskaper:
- Name — namnet på ditt projekt;
- Environment — i mitt fall anger conda_env att Anaconda används för körningen och att beskrivningen av beroenden finns i filen conda.yaml;
- Entry Points — anger vilka filer och med vilka parametrar vi kan starta (alla parametrar vid start av träningen loggas automatiskt)
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Som körmiljö kan du använda docker, för mer information se .
4. Vi startar träningen
Klonar projektet och går till projektkatalogen:
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
För att starta behöver du installera biblioteken
pip install mlflow
pip install pysftp
Eftersom jag använder conda_env i exemplet måste Anaconda vara installerat på din dator (men detta kan också kringgås genom att installera alla nödvändiga paket själv och experimentera med körparametrarna).
Alla förberedande steg är avklarade och vi kan börja med att starta träningen. Från projektroten:
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .Efter att kommandot har angetts skapas automatiskt en conda-miljö och träningen startar.
I exemplet ovan har jag angett antalet epoker för träning, kategorierna som vi vill segmentera (en fullständig lista kan ses ) och adressen till vår fjärrserver.
En fullständig lista över möjliga parametrar kan ses i filen MLproject.
5. Utvärdera träningsresultaten
Efter att träningen är avslutad kan vi öppna vår serveradress i webbläsaren
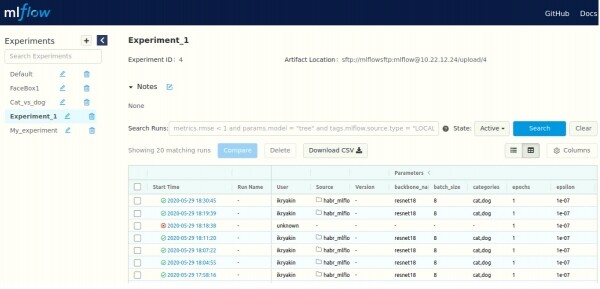
Här ser vi en lista över alla experiment (i det övre vänstra hörnet), samt information om körningarna (i mitten). Vi kan se mer detaljerad information (parametrar, metrik, artefakter och viss extra information) om varje körning.
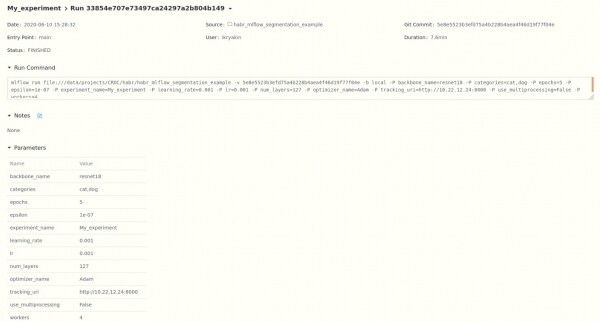
För varje metrisk kan vi observera historiken av förändringar.
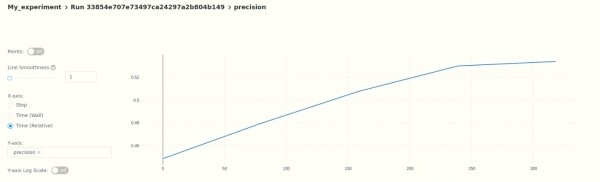
Det vill säga, just nu kan vi analysera resultaten manuellt, och du kan också ställa in automatisk validering med hjälp av MLflow API.
6. Registrera modellen
Efter att vi har analyserat vår modell och bestämt oss för att den är redo för produktion, går vi vidare med att registrera den. För detta väljer vi den körning vi behöver (som visats i föregående punkt) och scrollar ner.
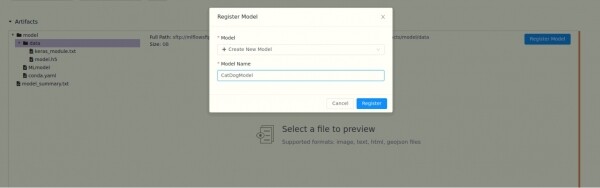
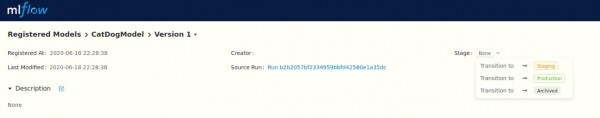
Efter att vi har gett vårt modell ett namn, får den en version. När en annan modell med samma namn sparas, höjs versionen automatiskt.
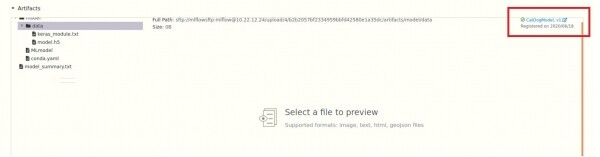
För varje modell kan vi lägga till en beskrivning och välja en av tre statusar (Staging, Production, Archived). Senare kan vi med hjälp av API:n referera till dessa statusar, vilket i kombination med versionering ger ytterligare flexibilitet.
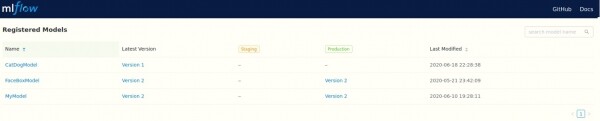
Vi har också bekväm tillgång till alla modeller
och deras versioner.
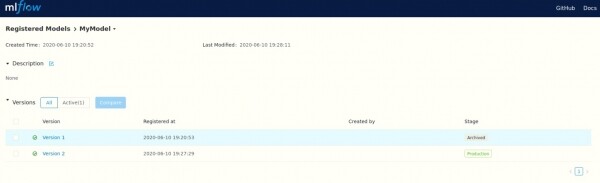
Som i föregående punkt kan alla operationer göras med hjälp av API.
7. Distribuera modellen
I det här skedet har vi redan en tränad (keras) modell. Ett exempel på hur man kan använda den:
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', '.\/')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image / 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Här är self.registry återigen ett litet lager ovanför mlflow.tracking.MlflowClient, för bekvämlighetens skull. Poängen är att jag ansluter till en remote server och letar efter en modell med det angivna namnet, specifikt den senaste produktionsversionen. Därefter laddar jag ner artefakten lokalt i mappen .\/model och bygger modellen från den här mappen mlflow.keras.load_model(local_path). Nu kan vi använda vår modell. CV (ML) utvecklare kan lugnt arbeta med att förbättra modellen och publicera nya versioner.
Avslutningsvis
Jag har presenterat ett system som möjliggör:
- centraliserad lagring av information om ML-modeller, träningsstatus och resultat;
- snabb distribution av utvecklingsmiljö;
- övervakning och analys av arbetet med modeller;
- smidig versionshantering och hantering av modellernas tillstånd;
- lätt att distribuera de framtagna modellerna.
Detta exempel är en demonstrationsvariant och agerar som en startpunkt för att bygga ditt eget system, vilket kanske kommer att inkludera automatisering av resultatutvärdering och registrering av modeller (punkt 5 och punkt 6 respektive) eller så kan du lägga till versionshantering av datamängder, eller kanske något annat? Jag försökte förmedla tanken att du behöver MLOps generellt, MLflow är bara ett verktyg för att uppnå ditt mål.
Skriv gärna vilka problem du har stött på som jag inte tog upp?
Vad skulle du lägga till i systemet för att möta dina behov?
Vilka verktyg och metoder använder du för att lösa alla eller delar av problemen?
P.S. Jag lämnar ett par länkar:
github-projekt —
MLflow —
Min arbetsmail för frågor — ikryakin@croc.ru
Vi anordnar regelbundet olika evenemang för IT-specialister. Till exempel kommer ett meetup om CV att hållas online den 8 juli kl. 19:00 Moskvatid. Om du är intresserad kan du delta, registrera dig. .
Källa: habr.com
