

Introduktion
För en tid sedan fick jag i uppdrag att utveckla en hög tillgänglighetskluster för , som fungerar i flera datacentra, kopplade med fiber inom samma stad, och som kan klara av att ett datacenter går nere (till exempel strömavbrott). Som programvara för hög tillgänglighet valde jag , eftersom detta är den officiella lösningen från RedHat för att skapa hög tillgängliga kluster. Det är bra eftersom RedHat ger stöd för det, och det är en universell (modulär) lösning. Med hjälp av detta kan hög tillgänglighet säkerställas för inte bara PostgreSQL, utan också andra tjänster, antingen genom att använda standardmoduler eller genom att skapa dem för specifika behov.
Det uppstod en rimlig fråga om detta lösning: hur hög tillgänglighet kommer det hög tillgänglighetsklustret att ha? För att undersöka detta utvecklade jag en testmiljö som imiterar olika fel på klusternoderna, väntar på återställande av funktionaliteten, återställer den misslyckade noden och fortsätter testningen i cykler. Ursprungligen kallades detta projekt hapgsql, men med tiden blev jag trött på namnet som bara hade en vokal. Därför började jag kalla hög tillgängliga databaser (och den flytande IP som pekar på dem) krogan (en karaktär från ett datorspel vars alla viktiga organ är duplicerade), och noder, kluster och själva projektet — tuchanka (planeten där krogans bor).
Nu har ledningen beslutat att . README kommer snart att översättas till engelska (eftersom det förväntas att huvudkonsumenterna kommer att vara utvecklare av Pacemaker och PostgreSQL), och den gamla ryska varianten av README har jag beslutat att utforma (delvis) i form av denna artikel.
Klustren sätts upp på virtuella maskiner . Totalt kommer 12 virtuella maskiner att sättas upp (totalt 36 GiB), som bildar 4 hög tillgänglighetskluster (olika varianter). De första två klustren består av två PostgreSQL-servrar, som är placerade i olika datacentra, och en gemensam server witness c quorum device (placerad på en billig virtuell maskin i det tredje datacentret), som löser osäkerheten 50%/50%, genom att ge sin röst till en av parterna. Det tredje klustret består av tre datacenter: en master och två slavservrar, utan quorum device. Den fjärde klustret består av fyra PostgreSQL-servrar, två per datacenter: en master och resten repliker, och använder också witness c quorum device. Fjärde klustret klarar av att förlora två servrar eller ett datacenter. Denna lösning kan, vid behov, skalas upp till fler repliker.
Tjänst för exakt tid har också konfigurerats för hög tillgänglighet, men där används metoden för ntpd (orphan mode). Den gemensamma servern witness har en central roll som NTP-server, som delar sin tid med alla kluster och på så sätt synkroniserar alla servrar med varandra. Om witness den går sönder eller blir isolerad, då börjar en av klusterservrarna (inom klustret) dela sin tid. En hjälpkassande HTTP-proxy är också upprättad, witnessmed hjälp av denna har de andra virtuella maskinerna tillgång till Yum-repositorier. I verkligheten kommer sådana tjänster som exakt tid och proxy förmodligen att hostas på dedikerade servrar, men i detta stand har de placerats på witness endast för att spara på antalet virtuella maskiner och utrymme.
Versioner
v0. Fungerar med CentOS 7 och PostgreSQL 11 på VirtualBox 6.1.
Konstruktur för kluster
Alla kluster är avsedda för distribution i flera datacenter, sammanlänkade i ett enda platt nätverk och ska klara av ett fel eller nätverksisolering av ett datacenter. Därför är omöjligt används för skydd mot split-brain standardteknologin Pacemaker, som kallas STONITH (Shoot The Other Node In The Head) eller fencing. Dess kärna: om noderna i klustret börjar misstänka att något är fel med en nod, den svarar inte eller beter sig felaktigt, så stänger de av den tvångsmässigt via "externa" enheter, till exempel en IPMI-kontrollkort eller UPS. Men detta fungerar bara i fall där vid enstaka serverfel fortsätter IPMI eller UPS att fungera. Här planeras skydd mot betydligt mer katastrofalt fel, när hela datacentret går ner (till exempel strömavbrott). Vid sådan avbrott kommer alla stonith-enheter (IPMI, UPS osv.) heller inte fungera.
Istället bygger systemet på idén om majoritet. Alla noder har en röst, och endast de som ser mer än hälften av alla noder kan arbeta. Detta antal "hälften+1" kallas kvorum. Om majoriteten inte uppnås anser noden att den är i nätverksisolering och att den måste stänga av sina resurser, dvs. det är så här skydd mot split-brain. Om mjukvaran som ansvarar för detta beteende inte fungerar, bör en watchdog aktiveras, till exempel baserat på IPMI.
Om antalet noder är jämnt (klustret finns i två datacenter) kan det uppstå så kallad osäkerhet 50%/50% (fifty-fifty), när nätverksisoleringen delar klustret i exakt två halvor. Därför läggs det till ett jämnt antal noder quorum device — en resurskrävande demon som kan köras på den billigaste virtuella maskinen i det tredje datacentret. Den ger sin röst till en av segmenten (som den ser) och därmed löser 50%/50% osäkerheten. Servern där quorum-enheten kommer att köras har jag kallat witness (terminologi från repmgr, jag gillade den).
Resurser kan flyttas runt, till exempel från trasiga servrar till fungerande, eller på begäran av systemadministratörer. För att kunder ska veta var deras nödvändiga resurser finns (var de ska ansluta?), används flytande IP (float IP). Det är IP-adresser som Pacemaker kan flytta mellan noder (allt finns i ett platt nätverk). Varje av dem symboliserar en resurs (tjänst) och kommer att befinna sig där man behöver ansluta för att få tillgång till denna tjänst (i vårt fall DB).
Tuchanka1 (schema med komprimering)
Struktur
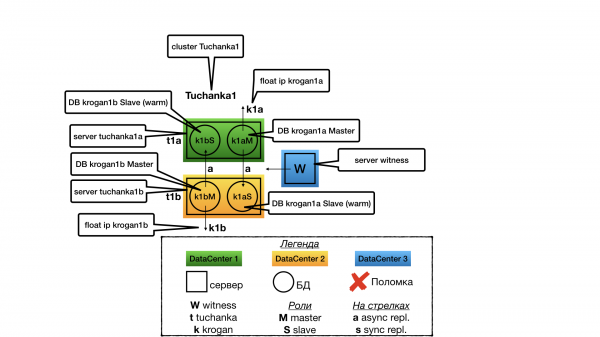
Idén var att vi har många små databaser med låg belastning, för vilka det inte är lönsamt att ha en dedikerad slavserver i hot standby-läge för read only-transaktioner (ingen anledning till sådan resursåtergång).
I varje datacenter finns en server. På varje server finns det två instanser av PostgreSQL (i PostgreSQL-termer kallas de kluster, men för att undvika förvirring kommer jag att kalla dem instanser (i analogi med andra databaser), och kluster kommer jag bara att kalla kluster för Pacemaker). En instans fungerar i masterläge, och endast den tillhandahåller tjänster (det är bara den som har float IP). Den andra instansen fungerar som en slav för det andra datacentret och kommer endast att erbjuda tjänster om dess master går ner. Eftersom det under större delen av tiden bara är en instans av de två (master) som tillhandahåller tjänster (bearbetar förfrågningar) optimeras alla serverresurser för master (minne avsätts för cache av shared_buffers etc.), men så att det också finns tillräckligt med resurser för den andra instansen (om än för en suboptimal drift via filsystemets cache) i händelse av att ett av datacentren slutar fungera. Slaven tillhandahåller inga tjänster (gör inga read-only-förfrågningar) under normal drift av klustret för att undvika resurskonflikter med mastern på samma maskin.
I fallet med två noder är felresiliens endast möjlig vid asynkron replikering, eftersom en synkroniserad fel på slaven skulle leda till att mastern stannar.
Fel witness
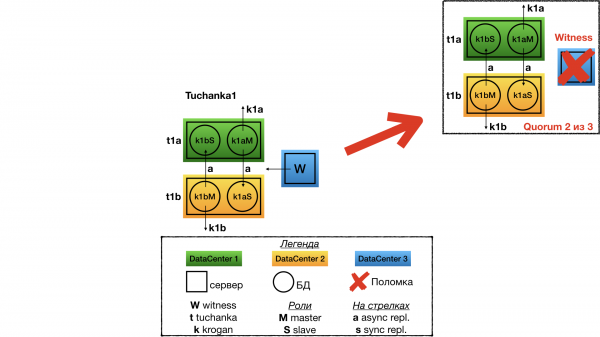
Fel witness (quorum device) jag kommer endast att överväga för klustret Tuchanka1, alla andra kommer att ha samma historia. Vid ett fel på witness i klustrets struktur förändras ingenting, allt kommer att fungera som tidigare. Men avgörande röster blir 2 av 3, och därför kommer varje följande fel att vara fatalt för klustret. Det måste fortfarande åtgärdas omedelbart.
Fel Tuchanka1
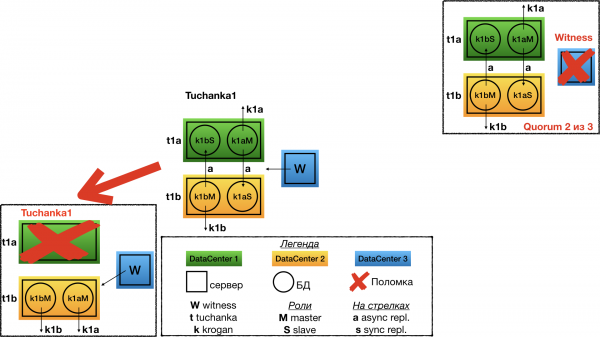
Fel på ett av datacentren för Tuchanka1. I detta fall witness ger sin röst till den andra noden i det andra datacentret. Där förvandlas den tidigare slaven till master, vilket resulterar i att båda mastern arbetar på en server och båda deras float IP pekar på dem.
Tuchanka2 (klassisk)
Struktur
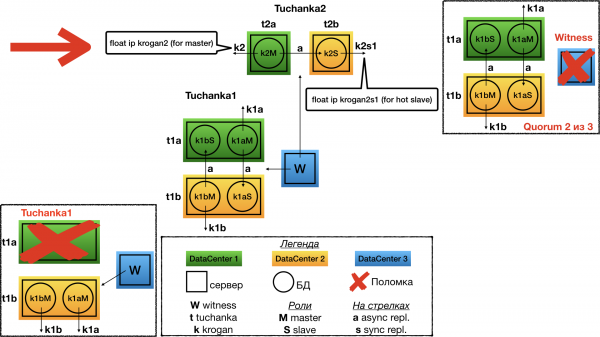
Klassiskt mönster med två noder. På en arbetar master, på den andra slav. Båda kan behandla förfrågningar (slaven bara read-only), så båda pekar på float IP: krogan2 - för mastern, krogan2s1 - för slaven. Felresiliens kommer att finnas både hos mastern och slaven.
I fallet med två noder är felresiliens endast möjlig vid asynkron replikering, eftersom en synkroniserad fel på slaven skulle leda till att mastern stannar.
Fel Tuchanka2
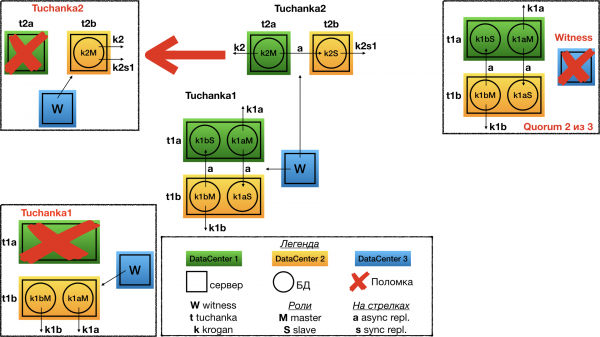
Vid ett fel på ett av datacentren witness röstar på den andra. På det enda fungerande datacentret kommer en master att sättas upp, och båda float IP:erna – master och slav – kommer att peka på den. Självklart måste instansen konfigureras så att den har tillräckligt med resurser (gränser för anslutningar etc.) för att samtidigt ta emot alla anslutningar och förfrågningar från både master- och slavens float IP. Det vill säga, under normal drift bör den ha ett tillräckligt överskott av kapacitet.
Tuchanka4 (många slavar)
Struktur
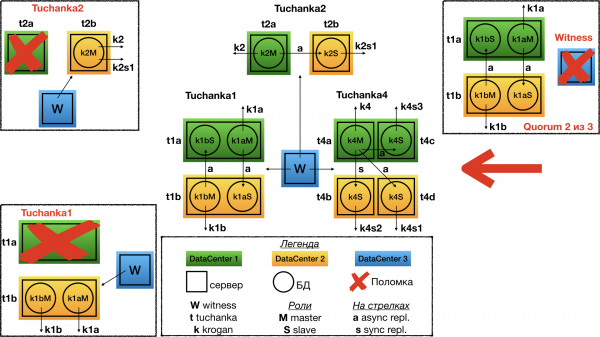
Det är redan en annan extrem. Det finns databaser som har mycket höga read-only förfrågningar (ett typiskt fall för en högbelastad webbplats). Tuchanka4 är en situation där det kan finnas tre eller fler slavar för att hantera sådana förfrågningar, men ändå inte för många. Vid ett mycket stort antal slavar behöver man uppfinna ett hierarkiskt replikationssystem. I det minimiella fallet (på bilden) finns det två servrar i varje datacenter, med en instans av PostgreSQL på varje server.
En annan funktion hos detta system är att man redan kan organisera en synkron replikation. Den är konfigurerad för att replikera, när det är möjligt, till ett annat datacenter, snarare än till en replika i samma datacenter som master. Både master och varje slav pekar på float IP. För att optimera detta bör man balansera förfrågningarna mellan slavar med hjälp av något. sql proxy, till exempel från klientens sida. Olika typer av klienter kan behöva olika typer sql proxy, och endast klientutvecklarna vet vem som behöver vad. Denna funktionalitet kan implementeras antingen som en extern demon eller som en klientbibliotek (connection pool), etc. Allt detta faller utanför ämnet för ett fel- och drift-säkert databaskluster (drift-säkerhet SQL proxy kan realiseras oberoende, tillsammans med klientens drift-säkerhet).
Fel i Tuchanka4
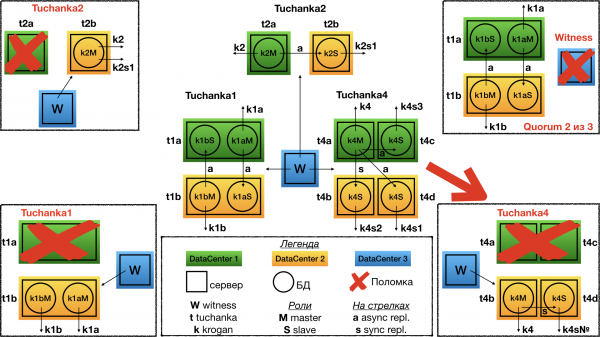
Vid fel i ett datacenter (dvs två servrar) röstar witness för den andra. Som en följd av detta fungerar två servrar i det andra datacentret: en server hanterar master och pekar på master float IP (för att ta emot read-write förfrågningar); och på den andra servern verkar en slav med synkron replikation, och på den pekar ett av slavarnas float IP (för read-only förfrågningar).
Det första att notera är att arbetsfloat IP för slavar inte kommer att vara alla, bara en. Och för att kunna arbeta korrekt med det krävs det att sql proxy alla begärningar omdirigerades till den enda kvarvarande float IP; om inte sql proxy kan man lista alla float IP för slavarna med kommatecken i URL:en för anslutning. I så fall kommer anslutningen att ske till den första fungerande IP:n, som implementerats i automatiseringstestningssystemet. Det kan hända att det fungerar annorlunda i andra bibliotek, som JDBC, och då krävs libpq att anslutningen kommer att ske till den första fungerande IP:n, vilket implementerats i automatiserat testningssystem. I andra bibliotek, som JDBC, kan det hända att detta inte fungerar och att det krävs sql proxy. Detta är för att float IP:n för slavarna har en restriktion för att samtidigt kunna köra på en server, så att de fördelas jämnt över slavservrarna om flera är igång.
För det andra: även om datacentret skulle falla kommer den synkrona replikeringen att bevaras. Om en sekundär felaktighet uppstår, det vill säga om en av två servrar i det kvarstående datacentret går ner, så kommer klustret, även om det slutar erbjuda tjänster, fortfarande att bevara information om alla kommitterade transaktioner som det har bekräftat med en commit (ingen förlust av information vid sekundär felaktighet).
Tuchanka3 (3 datacenter)
Struktur
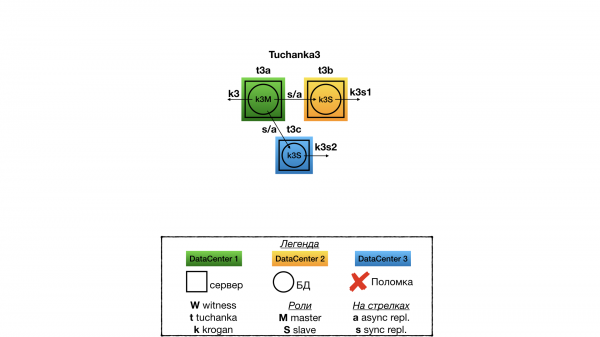
Detta är ett kluster för situationen när det finns tre fullt fungerande datacenter, där var och en har en fullt fungerande databasserver. I detta fall quorum device är inte nödvändig. I ett datacenter finns det en master, och i de två andra — slavar. Replikeringen är synkron, i stil med ANY (slave1, slave2), vilket innebär att klienten får en bekräftelse på commit när någon av slavarna först svarar att den har tagit emot commiten. Resurserna pekar på en float IP för master och två för slavarna. Till skillnad från Tuchanka4 är alla tre float IP:er är redundanta. För lastbalansering av read-only SQL-förfrågningar kan man använda sql proxy (med separat redundans), eller tilldela hälften av klienterna en slav float IP och den andra hälften den andra.
Fel på Tuchanka3
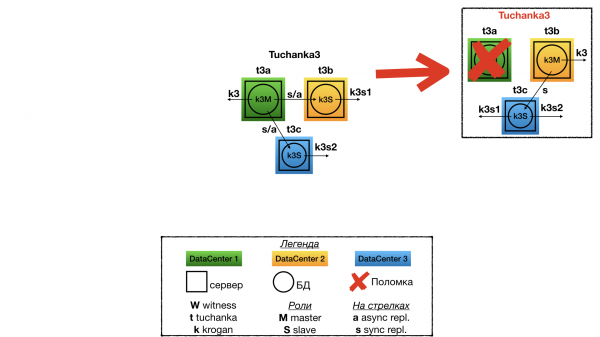
Vid ett fel i ett av datacentren finns det fortfarande två kvar. I ett finns master och float IP från master, medan det andra har en slav och båda slavarnas float IP (instansen bör ha dubbelt så mycket resurser för att ta emot alla anslutningar från båda slavarnas float IP). Mellan master och slav finns det synkron replikering. Klustret kommer också att bevara information om kommitterade och bekräftade transaktioner (ingen förlust av information) i händelse av att två datacenter förstörs (om de inte förstörs samtidigt).
Jag har valt att inte inkludera en detaljerad beskrivning av filstrukturen och distributionen. De som vill experimentera kan läsa allt detta i README. Jag ger bara en beskrivning av automatisk testning.
Automatisk testningssystem
För att kontrollera klusterens felbeständighet har ett system för automatisk testning skapats. Det körs med ett skript. test/failure. Skriptet kan ta som parametrar de nummer av kluster som du vill testa. Till exempel, det här kommandot:
test/failure 2 3kommer bara att testa det andra och tredje klustret. Om inga parametrar anges kommer alla kluster att testas. Alla kluster testas parallellt, och resultatet visas i tmux-panelen. Tmux använder en dedikerad tmux-server, så skriptet kan köras från default tmux, vilket ger en inbäddad tmux. Jag rekommenderar att använda en terminal i ett stort fönster med liten teckenstorlek. Innan testningen inleds återställs alla virtuella maskiner till en snapshot vid tidpunkten då skriptet avslutades. setup.
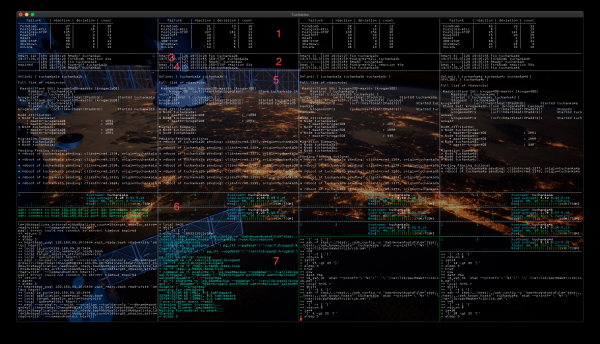
Terminals är uppdelad i kolumner enligt antal testade kluster, som standard (i skärmdumpen) fyra. Innehållet i kolumnerna kommer jag att beskriva med exemplet Tuchanka2. Panelerna på skärmdumpen är numrerade:
- Här visas statistiken för testerna. Kolumner:
- failure — namnet på testet (funktionen i skriptet) som emulerar ett fel.
- reaction — det aritmetiska medelvärdet i sekunder, som klustret tog för att återfå sin funktionalitet. Mäts från början av skriptets körning, som emulerar felet, fram till det ögonblick då klustret återfår sin funktionalitet och kan fortsätta leverera tjänster. Om tiden är mycket kort, till exempel sex sekunder (som ibland gäller kluster med flera arbetare (Tuchanka3 och Tuchanka4)), innebär det att felet inträffade på en asynkron arbetare och därför inte hade någon påverkan på funktionaliteten, inga tillståndsbyten i klustret skedde.
- deviation — visar spridningen (noggrannheten) av värdet reaction med metoden "standardavvikelse".
- count — hur många gånger detta test har utförts.
- En kort logg ger möjlighet att bedöma vad klustret gör för närvarande. Iterationsnummer (test), tidsstämpel och operationens namn visas. Om utförandet tar för lång tid (> 5 minuter) tyder det på ett problem.
- heart (hjärtat) — aktuell tid. För visuell bedömning av funktionalitet mästare i hans tabell skrivs den aktuella tiden kontinuerligt med hjälp av mästarens float IP. Vid framgång visas resultatet i denna panel.
- slag (puls) — "aktuell tid", som tidigare registrerades av skriptet heart i mästaren, läses nu från slaven genom hans float IP. Ger möjligheten att visuellt bedöma slaven och replikationens funktionalitet. I Tuchanka1 finns det inga slavar med float IP (inga slavar som erbjuder tjänster), men där finns två instanser (databaser), så här kommer det att visas inte slag, och heart den andra instansen.
- Övervakning av klustrets tillstånd med hjälp av verktyg
pcs mon. Visar strukturen, resursfördelningen på noderna och annan nyttig information. - Här visas systemövervakning från varje virtuell maskin i klustret. Det kan finnas flera sådana paneler — så många virtuella maskiner klustret har. Två diagram CPU-belastning (med två processorer i varje virtuell maskin), namn på den virtuella maskinen, Systembelastning (benämns Load Average, eftersom den är genomsnittlig över 5, 10 och 15 minuter), data om processer och minnesfördelning.
- Skriptslagning som utför tester. Vid fel — plötslig avbrott av arbetet eller oändlig vänteloop — kan orsaken till ett sådant beteende ses här.
Testningen genomförs i två steg. Först går skriptet igenom alla typer av tester, slumpmässigt väljer en virtuell maskin till vilken detta test ska tillämpas. Sedan utförs en oändlig testcykel, där virtuella maskiner och fel väljs slumpmässigt varje gång. Plötslig avslutning av testningsskriptet (nedre panel) eller oändlig vänteloop för något (> 5 minuter exekveringstid för en operation, vilket syns i spårningen) indikerar att något av testen i detta kluster har misslyckats.
Varje test består av följande operationer:
- Kör en funktion som emulerar ett fel.
- Redo? — väntar på att klustret ska återställas (när alla tjänster är tillgängliga).
- Visar tiden för att återställa klustret (reaction).
- Fix — klustret "repareras". Efter det ska det återgå till ett helt fungerande tillstånd och vara redo för nästa fel.
Här är en lista över tester med en beskrivning av vad de gör:
- ForkBomb: skapar "Out of memory" med hjälp av en fork-bomb.
- OutOfSpace: fyller disken. Men testet är snarare symboliskt, med den begränsade belastning som skapas vid testning, för vid diskfullhet uppstår vanligtvis inget avbrott i PostgreSQL.
- Postgres-KILL: dödar PostgreSQL med kommandot
killall -KILL postgres. - Postgres-STOP: hänger PostgreSQL med kommandot
killall -STOP postgres. - PowerOff: "stänger av" virtuella maskinen med kommandot
VBoxManage controlvm "virtuell maskin" poweroff. - Återställning: omstartar den virtuella maskinen med kommandot
VBoxManage controlvm "virtuell maskin" reset. - SBD-STOP: hänger SBD-demonen med kommandot
killall -STOP sbd. - ShutDown: skickar kommandot till den virtuella maskinen via SSH
systemctl poweroff, systemet avslutar arbetet korrekt. - UnLink: nätverksisolering, kommando
VBoxManage controlvm "virtuell maskin" setlinkstate1 off.
Avslutande av testet antingen med standardkommandot tmux "kill-window" Ctrl-b &, eller med kommandot "detach-client" Ctrl-b d: därmed avslutas testet, tmux stängs av, de virtuella maskinerna stängs ner.
Identifierade problem vid testning
För tillfället watchdog-demonen sbd hanterar stopp av observerade demoner, men inte deras hängande. Och som en följd av detta, hanteras felaktigheter felaktigt, vilket leder till hängningar bara Corosync och Pacemaker, men som inte hänger sbd. För att kontrollera Corosync så med hjälp av denna samling certifikat kan en kedja byggas och webbplatsen autentiseras. , accepterad i grenen master. Lovade (i PR#83) att det kommer att finnas något liknande för Pacemaker, jag hoppas att det kommer till RedHat 8 . Men sådana "fel" är hypotetiska, lätt duplicerbara artificiellt med exempelvis
killall -STOP corosync, men förekommer aldrig i verkliga livet.Hos Pacemaker i versionen för CentOS 7 är sync_timeout felaktigt ställt , vilket resulterar i för quorum deviceatt vid ett node-fel startade även den andra noden med viss sannolikhet omstart vid distribution (i skriptet , vilket resulterar i för quorum device setup/setup1
). Denna ändring accepterades inte av utvecklarna, istället lovade de att omarbeta infrastrukturen på så sätt (i någon obestämd framtid), att denna timeout skulle beräknas automatiskt. PacemakerOm det under konfigurationen av databasen anges attLC_MESSAGES
(textmeddelanden) kan använda Unicode, till exempelru_RU.UTF-8, så vid starti en miljö där locale inte är UTF-8, låt säga i en tom miljö (här postgres pacemaker pgsqlms+(paf) startari loggen istället för tecken i UTF-8 kommer det att finnas frågetecken postgres), så LC_MESSAGES=en_US.UTF-8LC_MESSAGES=en_US.UTF-8vid konfiguration (skapande) av en databasinstans.Om wal_receiver_timeout är inställt (standard är 60s), då vid test av PostgreSQL-STOP på master i klustren tuchanka3 och tuchanka4 . Replikeringen är synkron, så både arbetaren och den nya mastern stannar. Detta kan kringgås genom att sätta wal_receiver_timeout=0 när du konfigurerar PostgreSQL.
Jag har sällan sett att replikeringen hänger sig i PostgreSQL under ForkBomb-testet (minnesöverflöd). . Jag har bara sett detta i klustren tuchanka3 och tuchanka4, där master hängde sig på grund av att replikeringen var synkron. Problemet löste sig själv efter en längre tid (ungefär två timmar). Ytterligare forskning krävs för att åtgärda detta. Symptomen liknar en tidigare bugg som orsakas av en annan anledning, men med samma konsekvenser.
Krogan-bilden är hämtad från med författarens tillstånd:
Källa: habr.com
