

Vi började tänka på att skapa ett övervakningssystem under utvecklingen av produktteam. Det blev tydligt att vår verksamhet – drift – inte helt släpps in i dessa team. Varför är det så?
Det beror på att alla våra team är organiserade runt separata informationssystem, mikrotjänster och gränssnitt, vilket gör att de inte ser det allmänna hälsotillståndet för hela systemet. Till exempel kanske de inte vet hur en liten del i en djup backend påverkar frontend-delen. Deras intresseområde är begränsat till de system som deras system är integrerat med. Om ett team och dess tjänst A i princip inte är kopplade till tjänst B, blir tjänst B nästan osynlig för teamet.
Vårt team, å sin sida, arbetar med system som är väldigt djupt integrerade med varandra: det finns många kopplingar mellan dem, och det är en ganska stor infrastruktur. Och funktionen för vår webbshop beror på alla dessa system (vilket för övrigt är ett stort antal).
Det visar sig att vår avdelning inte tillhör något team utan står lite vid sidan av. I denna historia är vår uppgift att förstå helheten av hur informationssystem fungerar, deras funktionalitet, integrationer, programvara, nätverk, hårdvara och hur allt hänger samman.
Plattformen som våra webbshopar fungerar på ser ut så här:
- frontend
- middle-office
- back-office
Hur mycket vi än skulle vilja, finns det inget som heter att alla system fungerar smidigt och felfritt. Återigen beror det på antalet system och integrationer — med vårt upplägg är vissa incidenter oundvikliga, oavsett testkvaliteten. Detta gäller både inom ett enskilt system och i fråga om deras integration. Och det är nödvändigt att övervaka tillståndet för hela plattformen som en helhet, inte bara i förhållande till någon enskild del.
Idealiskt sett behöver övervakningen av hela plattformens hälsotillstånd automatiseras. Vi har kommit fram till att övervakning är en oundviklig del av denna process. Till en början byggdes det endast för frontend-delen, samtidigt som nätverksadministratörer, programvaru- och hårdvaruadministratörer hade sina egna övervakningssystem i lager. Alla dessa individer övervakade endast på sin nivå och ingen hade en helhetsförståelse.
Till exempel, om en virtuell maskin kraschar, vet oftast endast den administratör som ansvarar för hårdvaran och den virtuella maskinen om detta. Frontteamet ser bara själva händelsen av att applikationen har kraschat, men har ingen information om den virtuella maskinens nedgång. Administratören kan veta vem kunden är och få en ungefärlig uppfattning om vad som körs på den virtuella maskinen, förutsatt att det handlar om ett stort projekt. För små projekt känner han troligtvis inte till dem. Oavsett behövs det att administratören går till ägaren för att fråga vad som fanns på den här maskinen som behövde återskapas och vad som skulle ändras. Om något verkligen allvarligt gick sönder, började en cirkus av aktiviteter — eftersom ingen hade en helhetsbild av systemet.
I slutändan påverkar sådana fragmenterade berättelser hela fronten, användarna och vår huvudaffärsfunktion — internetförsäljning. Eftersom vi inte är en del av teamen utan arbetar med drift av alla e-handelsapplikationer inom webbutiken, tog vi på oss uppgiften att skapa ett omfattande övervakningssystem för e-handelsplattformen.
Systemets struktur och teknikstack
Vi började med att skilja ut flera lager av övervakning för våra system, inom vilka vi behöver samla in metrik. Allt detta behövde också integreras, vilket vi gjorde i det första steget. Just nu arbetar vi med att samla in så högkvalitativ metrik som möjligt över alla våra lager, för att bygga korrelation och förstå hur systemen påverkar varandra.
Frånvaron av ett komplext övervakningssystem under de inledande faserna av applikationslanseringar (eftersom vi började bygga det när en stor del av systemen redan var i drift) ledde till en betydande teknisk skuld när det gäller att installera övervakning för hela plattformen. Vi kunde inte fokusera på att installera övervakning för ett enskilt informationssystem och arbeta detaljerat med övervakningen för det, eftersom de andra systemen skulle vara utan övervakning under en tid. För att lösa detta problem definierade vi en lista över de mest nödvändiga metrikerna för att bedöma tillståndet för informationssystemet per lager och började implementera den.
Därför beslöt vi att ta oss an problemet bit för bit.
Vårt system består av:
- hårdvara;
- operativsystem;
- programvara;
- UI-delar i övervakningsapplikationen;
- affärsmått;
- integrationsapplikationer;
- informationssäkerhet;
- nätverk;
- lastbalanserare.
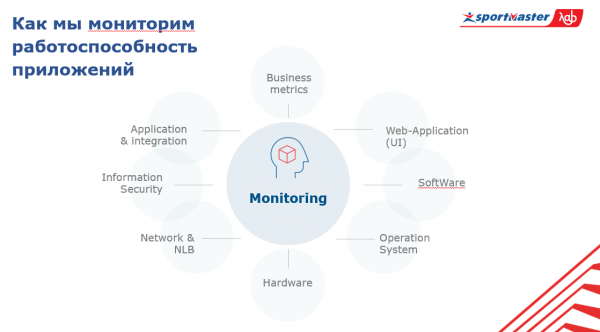
Kärnan i detta system är själva övervakningen. För att förstå tillståndet för hela systemet, måste man veta vad som händer med applikationerna på alla dessa lager och över hela mängden av applikationer.
Så, om stacken.
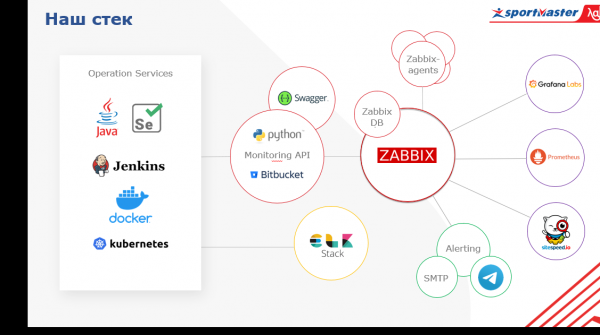
Vi använder öppen källkod. I centrum har vi Zabbix, som vi först och främst använder som ett varningssystem. Det är allmänt känt att det är perfekt för att övervaka infrastrukturen. Vad menar vi med det? Just de lågnivåmått som varje företag har som äger sitt egna datacenter (och Sportmaster har sina datacenter) — serverns temperatur, minnesstatus, RAID-status, mått på nätverksenheter.
Vi har integrerat Zabbix med meddelandetjänsterna Telegram och Microsoft Teams, som används aktivt i teamen. Zabbix täcker lagret av faktisk nätverks-, hårdvaru- och delvis mjukvaruövervakning, men det är ingen universallösning. Vi berikar dessa data från andra tjänster. Till exempel, när det gäller hårdvarunivå, kopplar vi direkt via API i vårt virtualiseringssystem och hämtar data.
Vad mer. Förutom Zabbix använder vi Prometheus, som tillåter övervakning av mått i applikationer i dynamiska miljöer. Det vill säga, vi kan hämta applikationsmått via HTTP-endpoint och behöver inte oroa oss för vilka mått vi ska ladda in i den eller inte. Baserat på dessa data kan analytiska frågor bearbetas.
Datakällorna för de övriga lagren, till exempel affärsmått, delas upp i tre beståndsdelar.
För det första är det externa affärssystem, Google Analytics, som samlar in mått från loggar. Från dem får vi data om aktiva användare, konverteringar och allt annat som är relaterat till affären. För det andra är det UI-övervakningssystemet. Det bör beskrivas mer ingående.
En gång började vi med manuell testning som växte till automatiserade tester av funktionalitet och integrationer. Det var ur det vi skapade övervakningen, kvarlämnande endast av den grundläggande funktionaliteten, och knöt oss till de markörer som är så stabila som möjligt och inte ofta ändras över tid.
Den nya teamstrukturen innebär att all verksamhet relaterad till applikationerna är kopplad till produktteam, så vi har slutat med ren testning. Istället har vi utvecklat UI-övervakning, skriven i Java, Selenium och Jenkins (som används som körsystem och för rapportgenerering).
Vi hade många tester, men vi bestämde oss för att fokusera på huvudvägen, den övergripande metriken. Och om vi har många specifika tester blir det svårt att hålla datan aktuell. Varje efterföljande release kommer att bryta hela systemet, och vi kommer bara att syssla med att laga det. Därför har vi knutit oss till helt grundläggande saker som sällan ändras och övervakar enbart dem.
För det tredje är källan till datan ett centraliserat loggsystem. För loggar använder vi Elastic Stack, och vi kan sedan dra in dessa data i vårt system för övervakning av affärsmetrics. Dessutom fungerar vår egna Monitoring API-tjänst, skriven i Python, som frågar tjänster via API och hämtar data från dem till Zabbix.
En annan oumbärlig del av övervakningen är visualisering. Vår visualisering bygger på Grafana. Bland andra visualiseringssystem utmärker den sig genom att man kan visualisera metrik från olika datakällor på dashboarden. Vi kan samla övergripande metrics för e-handelsbutiken, till exempel antalet beställningar som har genomförts under den senaste timmen från databasen, operativsystemets prestanda där denna e-handelsbutik körs från Zabbix, samt instanser av denna applikation från Prometheus. Och allt detta kommer att visas på en och samma dashboard. Tydligt och tillgängligt.
Jag vill nämna säkerhet – vi finslipar just nu systemet, som vi senare kommer att integrera med det globala övervakningssystemet. Enligt min mening är de huvudsakliga problemen som e-handel står inför när det gäller informationssäkerhet relaterade till bots, parsers och brute force-attacker. Detta behöver övervakas, eftersom de kan ha en kritisk inverkan både på våra applikationers funktion och på vårt rykte ur ett affärsperspektiv. Med den valda stacken lyckas vi täcka dessa uppgifter framgångsrikt.
En annan viktig punkt är att applikationsnivåerna samlas av Prometheus. Den är också integrerad med Zabbix. Dessutom har vi sitespeed, en tjänst som gör att vi kan övervaka parametrar som laddningstiden för vår sida, flaskhalsar, rendering av sidan, uppladdning av skript och så vidare, den är också integrerad via API. Så våra metrik samlas i Zabbix, därmed får vi även larm därifrån. Alla larm går för närvarande via de vanliga sätten att skicka (för nuvarande är det email och telegram, vi har nyligen även kopplat in MS Teams). Planerna är att förbättra larmningen så att smarta botar fungerar som en tjänst och tillhandahåller information om övervakningen till intresserade produktteam.
För oss är metrik inte bara viktiga för enskilda informationssystem utan även övergripande metrik för hela infrastrukturen som applikationerna använder: kluster fysiska servrar, där virtuella maskiner körs, trafikbalanserare, Network Load Balancers, själva nätverket, utnyttjande av kommunikationskanaler. Plus metrik för våra egna datacenter (vi har flera och infrastrukturen är ganska stor).
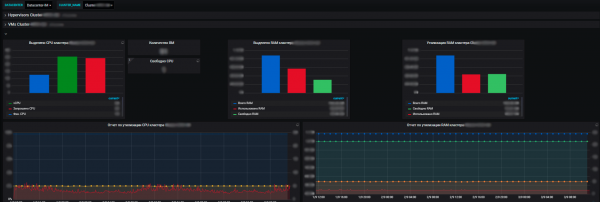
Fördelarna med vårt övervakningssystem är att vi med dess hjälp ser tillståndet för alla system, kan bedöma deras påverkan på varandra och på gemensamma resurser. Och i slutändan tillåter det oss att planera resurser, vilket också ingår i vårt ansvarsområde. Vi hanterar serverresurser — en pool inom e-handel, vi sätter in och tar ur drift ny utrustning, köper mer, gör en revision av resursutnyttjande och så vidare. Varje år planerar teamen nya projekt, utvecklar sina system, och det är viktigt för oss att tillhandahålla dem med resurser.
Och med hjälp av metrik ser vi trenden för resursanvändning av våra informationssystem. Och redan utifrån detta kan vi planera något. På virtualiseringsnivå samlar vi in data och ser information om tillgången på resurser i olika datacenter. Inom datacentret kan vi se både utnyttjande och faktisk fördelning, resursförbrukning. Både för standalone-servrar och virtuella maskiner samt kluster av fysiska servrar där alla dessa virtuella maskiner körs smidigt.
Framtidsutsikter
Just nu är vårt systemkärna i stort sett klar, men det finns fortfarande flera punkter kvar att arbeta med. Åtminstone handlar det om lagret för informationssäkerhet, men det är också viktigt att nå nätverket, utveckla alertsystemet och lösa korrelationsfrågan. Vi har många lager och system, och på varje lager finns det många mätvärden. Det blir som en matryoshka med en matryoshka i en matryoshka.
Vårt mål är i slutändan att skapa korrekta alerts. Till exempel, om det uppstår ett problem med hårdvaran, återigen med den virtuella maskinen, där det fanns en viktig applikation, och tjänsten inte var reserverad på något sätt. Vi får veta att den virtuella maskinen har kraschat. Sedan kommer det att finnas alert på affärsmått: användare har försvunnit någonstans, det finns inga konverteringar, UI i gränssnittet är otillgänglig, och mjukvaran och tjänsterna har också kraschat.
Med en sådan uppsättning kommer vi att få spam från alerts, vilket inte passar in i formatet för ett korrekt övervakningssystem. Frågan om korrelation uppstår. Därför bör vårt övervakningssystem i idealfallet säga: "Hej, ni har en fysisk maskin som har kraschat, och tillsammans med den den här applikationen och sådana mätvärden", med hjälp av en alert istället för att överösa oss med hundratals alerts. Det ska informera om det viktiga — orsaken, vilket bidrar till snabbare problemlösning genom att lokalisera det.
Vårt alerteringssystem och hanteringen av alerts är byggt kring en dygnet-runt tjänst. Alla alerts som vi anser är ett måste och som ingår i checklistan skickas dit. Varje alert måste ha en beskrivning: vad som hände, vad det faktiskt betyder, och vilken påverkan det har. Dessutom en länk till instrumentpanelen och instruktioner för vad som behöver göras i detta fall.
Det är allt som gäller krav för att bygga alertsystem. Situationen kan sedan utvecklas i två riktningar — antingen finns det ett problem som behöver lösas, eller så har det inträffat ett fel i övervakningssystemet. Men i alla fall måste man gå och utreda.
I genomsnitt får vi nu omkring hundra alerts per dag, och detta med tanke på att korrelation av alerts ännu inte har ställts in på rätt sätt. Och om vi behöver utföra tekniska arbeten och vi stänger av något manuellt, ökar antalet explosionsartat.
Förutom övervakning av de system vi använder och insamling av metrik som vi anser viktiga, gör övervakningssystemet det möjligt att samla in data för produktteam. De kan påverka sammansättningen av metrik inom informationssystemen som övervakas av oss.
Vår kollega kan komma och be oss att lägga till en mätning som visar sig vara användbar både för oss och för teamet. Eller så kan teamet tycka att de grundläggande mätningarna vi har inte räcker till, och de behöver övervaka något specifikt. I Grafana skapar vi ett utrymme för varje team och ger dem adminbehörighet. Om teamet behöver dashboards och inte kan/inte vet hur man gör det, så hjälper vi dem.
Eftersom vi är utanför flödet av teamets värdeskapande, släpp och planering, närmar vi oss gradvis en punkt där alla systemsläpp är sömlösa, och de kan lanseras dagligen utan att samordnas med oss. För oss är det viktigt att övervaka dessa släpp, eftersom de potentiellt kan påverka applikationens funktion och orsaka problem, vilket är kritiskt. För att hantera släpp använder vi Bamboo, där vi via API får data och kan se vilka släpp som har lanserats i vilka informationssystem och deras status. Och det viktigaste — vilken tid.
På så sätt kan vi se korrelationen mellan nya släpp och uppkommande problem. Huvudidén är att förstå hur systemet fungerar på alla nivåer, snabbt lokalisera problem och lika snabbt åtgärda dem. För ofta tar det mer tid att leta reda på orsaken än att lösa problemet.
Och på detta område vill vi i framtiden fokusera på proaktivitet. Helst skulle vi vilja veta om en kommande problematik i förväg, snarare än efteråt, så att vi kan förebygga det istället för att lösa det. Ibland inträffar det falska larm i övervakningssystemet, både på grund av mänskliga misstag och förändringar i applikationen. Och vi arbetar med detta, finjusterar och försöker informera användarna, som använder systemet ihop med oss, innan vi gör några manipulationer med övervakningssystemet, eller genomföra dessa åtgärder under underhållstiden.
Så, systemet har varit igång och fungerar framgångsrikt sedan början av våren… och visar en ganska verklig vinst. Självklart är detta inte den slutliga versionen, vi kommer att införa många fler användbara funktioner. Men just nu, med så många integrationer och applikationer, kan vi faktiskt inte klara oss utan automatiserad övervakning.
Om ni också övervakar stora projekt med ett stort antal integrationer – skriv i kommentarerna vilken silverkula ni har funnit för detta.
Källa: habr.com
